信息学奥赛-提高级 题库
聪明的质监员
【问题描述】
小 T 是一名质量监督员,最近负责检验一批矿产的质量。这批矿产共有 n 个矿石,从 1到 n 逐一编号,每个矿石都有自己的重量 wi 以及价值 vi。检验矿产的流程是:
1、给定 m 个区间[Li,Ri];
2、选出一个参数 W;
3、对于一个区间[Li,Ri],计算矿石在这个区间上的检验值 Yi :
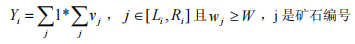
这批矿产的检验结果 Y 为各个区间的检验值之和。即:
若这批矿产的检验结果与所给标准值 S 相差太多,就需要再去检验另一批矿产。小 T不想费时间去检验另一批矿产,所以他想通过调整参数 W 的值,让检验结果尽可能的靠近标准值 S,即使得 S-Y 的绝对值最小。请你帮忙求出这个最小值。
【输入】
输入文件 qc.in。
第一行包含三个整数 n,m,S,分别表示矿石的个数、区间的个数和标准值。
接下来的 n 行,每行 2 个整数,中间用空格隔开,第 i+1 行表示 i 号矿石的重量 wi 和价值 vi 。
接下来的 m 行,表示区间,每行 2 个整数,中间用空格隔开,第 i+n+1 行表示区间[Li, Ri]的两个端点 Li 和 Ri。注意:不同区间可能重合或相互重叠。
【输出】
输出文件名为 qc.out。
输出只有一行,包含一个整数,表示所求的最小值。
【输入输出样例】
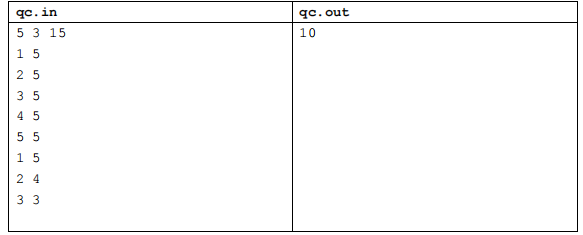
【输入输出样例说明】
当 W 选 4 的时候,三个区间上检验值分别为 20、5、0,这批矿产的检验结果为 25,此时与标准值 S 相差最小为 10。
【数据范围】
对于 10%的数据,有 1≤n,m≤10;
对于 30%的数据,有 1≤n,m≤500;
对于 50%的数据,有 1≤n,m≤5,000;
对于 70%的数据,有 1≤n,m≤10,000;
对于 100%的数据,有 1≤n,m≤200,000,0 < wi, vi≤10^6,0 < S≤10^12,1≤Li≤Ri≤n。
#include <bits/stdc++.h>
#define int long long
using namespace std;
const int Max=200005;
int n,m,s,l,r,mid,maxx,ans=1e18,v;
int w[Max],c[Max],sum1[Max],sum2[Max],L[Max],R[Max];
inline int get_int()
{
int x=0,f=1;
char c;
for(c=getchar();(!isdigit(c))&&(c!='-');c=getchar());
if(c=='-') f=-1,c=getchar();
for(;isdigit(c);c=getchar()) x=(x<<3)+(x<<1)+c-'0';
return x*f;
}
inline int check(int W)
{
int ans=0;
for(int i=1;i<=n;i++)
{
sum1[i]=sum1[i-1],sum2[i]=sum2[i-1];
if(w[i]>=W) sum1[i]+=c[i],sum2[i]++;
}
for(int i=1;i<=m;i++) ans+=(sum2[R[i]]-sum2[L[i]-1])*(sum1[R[i]]-sum1[L[i]-1]);
return ans;
}
signed main()
{
n=get_int(),m=get_int(),s=get_int();
for(int i=1;i<=n;i++) w[i]=get_int(),c[i]=get_int(),maxx=max(maxx,w[i]);
for(int i=1;i<=m;i++) L[i]=get_int(),R[i]=get_int();
l=1,r=maxx;
while(l<r)
{
mid=(l+r)>>1,v=check(mid);
if(v<=s) ans=min(s-v,ans),r=mid;
else l=mid+1;
}
l=1,r=maxx;
while(l<r)
{
mid=(l+r+1)>>1,v=check(mid);
if(v>=s) ans=min(ans,v-s),l=mid;
else r=mid-1;
}
cout<<ans;
return 0;
}
观光公交
【问题描述】
风景迷人的小城 Y 市,拥有 n 个美丽的景点。由于慕名而来的游客越来越多,Y 市特意安排了一辆观光公交车,为游客提供更便捷的交通服务。观光公交车在第 0 分钟出现在 1号景点,随后依次前往 2、3、4……n 号景点。从第 i 号景点开到第 i+1 号景点需要 Di 分钟。任意时刻,公交车只能往前开,或在景点处等待。
设共有 m 个游客,每位游客需要乘车 1 次从一个景点到达另一个景点,第 i 位游客在Ti 分钟来到景点 Ai,希望乘车前往景点 Bi(Ai<Bi)。为了使所有乘客都能顺利到达目的地,公交车在每站都必须等待需要从该景点出发的所有乘客都上车后才能出发开往下一景点。假设乘客上下车不需要时间。
一个乘客的旅行时间,等于他到达目的地的时刻减去他来到出发地的时刻。因为只有一辆观光车,有时候还要停下来等其他乘客,乘客们纷纷抱怨旅行时间太长了。于是聪明的司机 ZZ 给公交车安装了 k 个氮气加速器,每使用一个加速器,可以使其中一个 Di 减 1。对于同一个 Di 可以重复使用加速器,但是必须保证使用后 Di 大于等于 0。
那么 ZZ 该如何安排使用加速器,才能使所有乘客的旅行时间总和最小?
【输入】
输入文件名为 bus.in。
第 1 行是 3 个整数 n, m, k,每两个整数之间用一个空格隔开。分别表示景点数、乘客数和氮气加速器个数。
第 2 行是 n-1 个整数,每两个整数之间用一个空格隔开,第 i 个数表示从第 i 个景点开往第 i+1 个景点所需要的时间,即 Di。
第 3 行至 m+2 行每行 3 个整数 Ti, Ai, Bi,每两个整数之间用一个空格隔开。第 i+2 行表示第 i 位乘客来到出发景点的时刻,出发的景点编号和到达的景点编号。
【输出】
输出文件名为 bus.out。共一行,包含一个整数,表示最小的总旅行时间。
【输入输出样例】
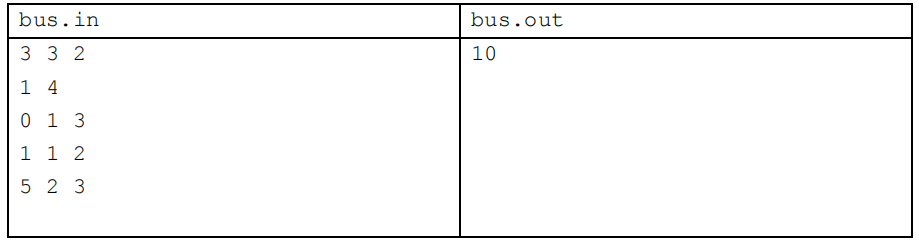
【输入输出样例说明】
对 D2 使用 2 个加速器,从 2 号景点到 3 号景点时间变为 2 分钟。
公交车在第 1 分钟从 1 号景点出发,第 2 分钟到达 2 号景点,第 5 分钟从 2 号景点出发,
第 7 分钟到达 3 号景点。
第 1 个旅客旅行时间 7-0 = 7 分钟。
第 2 个旅客旅行时间 2-1 = 1 分钟。
第 3 个旅客旅行时间 7-5 = 2 分钟。
总时间 7+1+2 = 10 分钟。
【数据范围】
对于 10%的数据,k=0;
对于 20%的数据,k=1;
对于 40%的数据,2 ≤ n ≤ 50,1 ≤ m ≤ 1,000,0 ≤ k ≤ 20,0 ≤ Di ≤ 10,0 ≤ Ti ≤ 500;
对于 60%的数据,1 ≤ n ≤ 100,1 ≤ m ≤ 1,000,0 ≤ k ≤ 100,0 ≤ Di ≤ 100,0 ≤ Ti ≤ 10,000;
对于 100%的数据,1 ≤ n ≤ 1,000,1 ≤ m ≤ 10,000,0 ≤ k ≤ 100,000,0 ≤ Di ≤ 100,0 ≤ Ti ≤ 100,000。
#include <iostream>
#include <cstdio>
#include <cstring>
using namespace std;
const int maxn=1010;
const int maxm=10010;
int d[maxn];//en[maxn];
int dis[maxn];
int a[maxm],b[maxm],t[maxm];
int tim[maxn];
int c[maxn];
int g[maxn];
int main(){
freopen("bus.in","r",stdin);
freopen("bus.out","w",stdout);
int n,m,k;
scanf("%d %d %d",&n,&m,&k);
for(int i=1;i<n;i++)
scanf("%d",&d[i]);
for(int i=1;i<=m;i++){
scanf("%d %d %d",&t[i],&a[i],&b[i]);
//en[b[i]]++;
tim[a[i]]=max(tim[a[i]],t[i]);
c[b[i]]++;
}
for(int i=1;i<n;i++)
dis[i+1]=max(tim[i],dis[i])+d[i];
int ans=0;
for(int i=1;i<=m;i++)
ans+=dis[b[i]]-t[i];
for(int i=2;i<=n;i++)
c[i]=c[i-1]+c[i];
while(k--){
g[n]=n;
g[n-1]=n;
for(int i=n-2;i;i--){
if(dis[i+1]>tim[i+1])
g[i]=g[i+1];
else g[i]=i+1;
}
int maxx=0,u;
for(int i=1;i<=n;i++)
if(c[g[i]]-c[i]>maxx&&d[i]>0){
maxx=c[g[i]]-c[i];
u=i;
}
if(!maxx)
break;
d[u]--;
ans-=maxx;
dis[1]=0;
for(int i=1;i<n;i++)
dis[i+1]=max(tim[i],dis[i])+d[i];
}
printf("%d\n",ans);
return 0;
}
机器翻译
【问题描述】
小晨的电脑上安装了一个机器翻译软件,他经常用这个软件来翻译英语文章。
这个翻译软件的原理很简单,它只是从头到尾,依次将每个英文单词用对应的中文含义来替换。对于每个英文单词,软件会先在内存中查找这个单词的中文含义,如果内存中有,软件就会用它进行翻译;如果内存中没有,软件就会在外存中的词典内查找,查出单词的中文含义然后翻译,并将这个单词和译义放入内存,以备后续的查找和翻译。
假设内存中有 M 个单元,每单元能存放一个单词和译义。每当软件将一个新单词存入内存前,如果当前内存中已存入的单词数不超过 M−1,软件会将新单词存入一个未使用的内存单元;若内存中已存入 M 个单词,软件会清空最早进入内存的那个单词,腾出单元来,存放新单词。
假设一篇英语文章的长度为 N 个单词。给定这篇待译文章,翻译软件需要去外存查找多少次词典?假设在翻译开始前,内存中没有任何单词。
【输入】
输入文件名为 translate.in,输入文件共 2 行。每行中两个数之间用一个空格隔开。
第一行为两个正整数 M 和 N,代表内存容量和文章的长度。
第二行为 N 个非负整数,按照文章的顺序,每个数(大小不超过 1000)代表一个英文单词。文章中两个单词是同一个单词,当且仅当它们对应的非负整数相同。
【输出】
输出文件 translate.out 共 1 行,包含一个整数,为软件需要查词典的次数。
【输入输出样例 1】
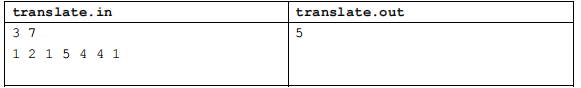
【输入输出样例 1 说明】
整个查字典过程如下:每行表示一个单词的翻译,冒号前为本次翻译后的内存状况:
空:内存初始状态为空。
1. 1:查找单词 1 并调入内存。
2. 1 2:查找单词 2 并调入内存。
3. 1 2:在内存中找到单词 1。
4. 1 2 5:查找单词 5 并调入内存。
5. 2 5 4:查找单词 4 并调入内存替代单词 1。
6. 2 5 4:在内存中找到单词 4。
7. 5 4 1:查找单词 1 并调入内存替代单词 2。
共计查了 5 次词典。
【输入输出样例 2】
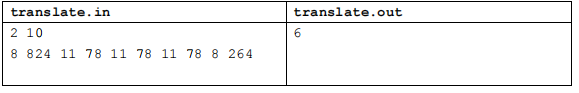
【数据范围】
对于 10%的数据有 M=1,N ≤ 5。
对于 100%的数据有 0<M ≤ 100,0<N ≤ 1000。
#include<bits/stdc++.h>
using namespace std;
int main()
{
int a,b;
cin>>a>>b;
int c[a],d[b];
int ans=0;
for (int i=0;i<a;i++)//将内存赋值为-1(因为为非负整数)
c[i]=-1;
for (int i=0;i<b;i++)
cin>>d[i];
if (a==0)//恒为0的时候直接输出
cout<<b;
for (int i=0;i<b;i++)
{
int k=0;
for (int j=0;j<a;j++)
{
if (d[i]!=c[j])
continue;
else k=1;//进行标记
}
if (k==0)
{
int s=ans%a;//取余能够删除元素
c[s]=d[i];
ans++;
}
}
cout<<ans<<endl;
}
乌龟棋
【问题描述】
小明过生日的时候,爸爸送给他一副乌龟棋当作礼物。
乌龟棋的棋盘是一行 N 个格子,每个格子上一个分数(非负整数)。棋盘第 1 格是唯一的起点,第 N 格是终点,游戏要求玩家控制一个乌龟棋子从起点出发走到终点。
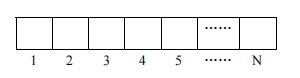
乌龟棋中 M 张爬行卡片,分成 4 种不同的类型(M 张卡片中不一定包含所有 4 种类型的卡片,见样例),每种类型的卡片上分别标有 1、2、3、4 四个数字之一,表示使用这种卡片后,乌龟棋子将向前爬行相应的格子数。游戏中,玩家每次需要从所有的爬行卡片中选择一张之前没有使用过的爬行卡片,控制乌龟棋子前进相应的格子数,每张卡片只能使用一次。游戏中,乌龟棋子自动获得起点格子的分数,并且在后续的爬行中每到达一个格子,就得到该格子相应的分数。玩家最终游戏得分就是乌龟棋子从起点到终点过程中到过的所有格子的分数总和。
很明显,用不同的爬行卡片使用顺序会使得最终游戏的得分不同,小明想要找到一种卡片使用顺序使得最终游戏得分最多。
现在,告诉你棋盘上每个格子的分数和所有的爬行卡片,你能告诉小明,他最多能得到多少分吗?
【输入】
输入文件名 tortoise.in。输入文件的每行中两个数之间用一个空格隔开。
第 1 行 2 个正整数 N 和 M,分别表示棋盘格子数和爬行卡片数。
第 2 行 N 个非负整数,a1, a2, ……, aN,其中 ai 表示棋盘第 i 个格子上的分数。
第 3 行 M 个整数,b1,b2, ……, bM,表示 M 张爬行卡片上的数字。
输入数据保证到达终点时刚好用光 M 张爬行卡片,即
【输出】
输出文件名 tortoise.out。
输出只有 1 行,1 个整数,表示小明最多能得到的分数。
【输入输出样例 1】
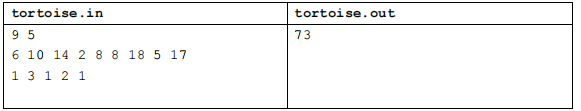
【输入输出样例 1 说明】
小明使用爬行卡片顺序为 1,1,3,1,2,得到的分数为 6+10+14+8+18+17=73。注意,
由于起点是 1,所以自动获得第 1 格的分数 6。
【输入输出样例 2】
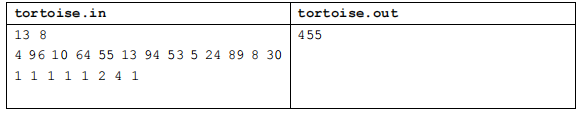
【数据范围】
对于 30%的数据有 1 ≤ N ≤ 30,1 ≤ M ≤ 12。
对于 50%的数据有 1 ≤ N ≤ 120,1 ≤ M ≤ 50,且 4 种爬行卡片,每种卡片的张数不会超
过 20。
对于 100%的数据有 1 ≤ N ≤ 350,1 ≤ M ≤ 120,且 4 种爬行卡片,每种卡片的张数不会
超过 40;0 ≤ ai ≤ 100,1 ≤ i ≤ N;1 ≤ bi ≤ 4,1 ≤ i ≤ M。输入数据保证
#include <bits/stdc++.h>
#define LL long long
using namespace std;
const int maxs=41;
int f[maxs][maxs][maxs][maxs],a[5],q[352];
int main(){
int n,m,x;
scanf("%d %d",&n,&m);
for(int i=0;i<n;i++)scanf("%d",q+i);
for(int i=0;i<m;i++){
scanf("%d",&x);
a[x]++;
}
f[0][0][0][0]=q[0];
for(int i=0;i<=a[1];i++){
for(int j=0;j<=a[2];j++){
for(int k=0;k<=a[3];k++){
for(int l=0;l<=a[4];l++){
x=i+j*2+k*3+l*4;
if(i!=0)f[i][j][k][l]=max(f[i][j][k][l],f[i-1][j][k][l]+q[x]);
if(j!=0)f[i][j][k][l]=max(f[i][j][k][l],f[i][j-1][k][l]+q[x]);
if(k!=0)f[i][j][k][l]=max(f[i][j][k][l],f[i][j][k-1][l]+q[x]);
if(l!=0)f[i][j][k][l]=max(f[i][j][k][l],f[i][j][k][l-1]+q[x]);
}
}
}
}
cout<<f[a[1]][a[2]][a[3]][a[4]];
return 0;
}
关押罪犯
【问题描述】
S 城现有两座监狱,一共关押着 N 名罪犯,编号分别为 1~N。他们之间的关系自然也极不和谐。很多罪犯之间甚至积怨已久,如果客观条件具备则随时可能爆发冲突。我们用“怨气值”(一个正整数值)来表示某两名罪犯之间的仇恨程度,怨气值越大,则这两名罪犯之间的积怨越多。如果两名怨气值为 c 的罪犯被关押在同一监狱,他们俩之间会发生摩擦,并造成影响力为 c 的冲突事件。
每年年末,警察局会将本年内监狱中的所有冲突事件按影响力从大到小排成一个列表,然后上报到 S 城 Z 市长那里。公务繁忙的 Z 市长只会去看列表中的第一个事件的影响力,如果影响很坏,他就会考虑撤换警察局长。
在详细考察了 N 名罪犯间的矛盾关系后,警察局长觉得压力巨大。他准备将罪犯们在两座监狱内重新分配,以求产生的冲突事件影响力都较小,从而保住自己的乌纱帽。假设只要处于同一监狱内的某两个罪犯间有仇恨,那么他们一定会在每年的某个时候发生摩擦。那么,应如何分配罪犯,才能使 Z 市长看到的那个冲突事件的影响力最小?这个最小值是多少?
【输入】
输入文件名为 prison.in。输入文件的每行中两个数之间用一个空格隔开。
第一行为两个正整数 N 和 M,分别表示罪犯的数目以及存在仇恨的罪犯对数。
接下来的 M 行每行为三个正整数 aj,bj,cj,表示 aj号和 bj号罪犯之间存在仇恨,其怨气值为 cj。数据保证1 ≤ a j < bj ≤ N ,0 < c j ≤ 1,000,000,000 ,且每对罪犯组合只出现一次。
【输出】
输出文件 prison.out 共 1 行,为 Z 市长看到的那个冲突事件的影响力。如果本年内监狱中未发生任何冲突事件,请输出 0。
【输入输出样例】
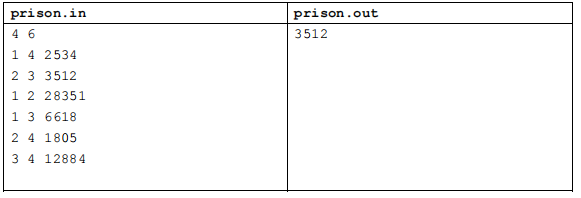
【输入输出样例说明】
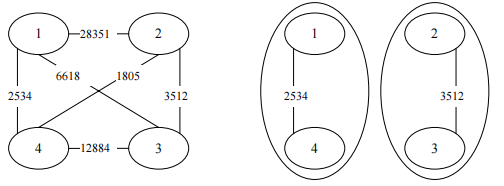
罪犯之间的怨气值如下面左图所示,右图所示为罪犯的分配方法,市长看到的冲突事件影响力是 3512(由 2 号和 3 号罪犯引发)。其他任何分法都不会比这个分法更优。
【数据范围】
对于 30%的数据有 N ≤ 15。
对于 70%的数据有 N ≤ 2000,M ≤ 50000。
对于 100%的数据有 N ≤ 20000,M ≤ 100000。
#include<cstdio>
#include<algorithm>
using namespace std;
const int N = 100100;
int n,m;
int par[N];
struct Node{
int a,b,c;
bool operator < (const Node &B) const{
return c > B.c;
}
} nodes[N];
int Find(int x){
if(x == par[x]) return x;
return par[x] = Find(par[x]);
}
void Merge(int x,int y){
par[Find(x)] = Find(y);
}
int main(){
scanf("%d%d",&n,&m);
for(int i = 1;i <= m;i++){
scanf("%d%d%d",&nodes[i].a,&nodes[i].b,&nodes[i].c);
par[i] = i;
}
sort(nodes+1,nodes+1+m);
for(int i = 1;i <= m;i++){
int x = nodes[i].a,y = nodes[i].b,d = nodes[i].c;
int x_en = x+n, y_en = y+n;
if(Find(x) == Find(y)){
printf("%d\n",d);
return 0;
}
Merge(x,y_en);Merge(x_en,y);
}
printf("0");
return 0;
}
引水入城
【问题描述】
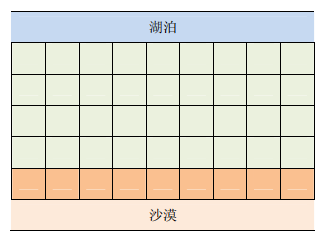
在一个遥远的国度,一侧是风景秀美的湖泊,另一侧则是漫无边际的沙漠。该国的行政区划十分特殊,刚好构成一个 N 行 M 列的矩形,如上图所示,其中每个格子都代表一座城市,每座城市都有一个海拔高度。
为了使居民们都尽可能饮用到清澈的湖水,现在要在某些城市建造水利设施。水利设施有两种,分别为蓄水厂和输水站。蓄水厂的功能是利用水泵将湖泊中的水抽取到所在城市的蓄水池中。因此,只有与湖泊毗邻的第 1 行的城市可以建造蓄水厂。而输水站的功能则是通过输水管线利用高度落差,将湖水从高处向低处输送。故一座城市能建造输水站的前提,是存在比它海拔更高且拥有公共边的相邻城市,已经建有水利设施。
由于第 N 行的城市靠近沙漠,是该国的干旱区,所以要求其中的每座城市都建有水利设施。那么,这个要求能否满足呢?如果能,请计算最少建造几个蓄水厂;如果不能,求干旱区中不可能建有水利设施的城市数目。
【输入】
输入文件名为 flow.in。输入文件的每行中两个数之间用一个空格隔开。
输入的第一行是两个正整数 N 和 M,表示矩形的规模。
接下来 N 行,每行 M 个正整数,依次代表每座城市的海拔高度。
【输出】
输出文件名为 flow.out。
输出有两行。如果能满足要求,输出的第一行是整数 1,第二行是一个整数,代表最少建造几个蓄水厂;如果不能满足要求,输出的第一行是整数 0,第二行是一个整数,代表有几座干旱区中的城市不可能建有水利设施。
【输入输出样例 1】
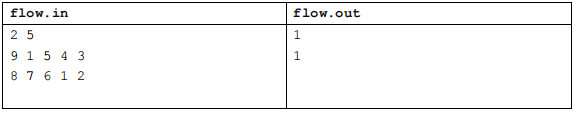
【样例 1 说明】
只需要在海拔为 9 的那座城市中建造蓄水厂,即可满足要求。
【输入输出样例 2】
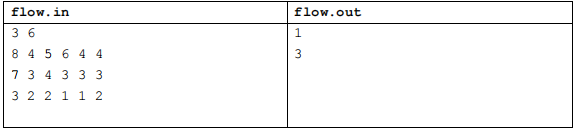
【样例 2 说明】
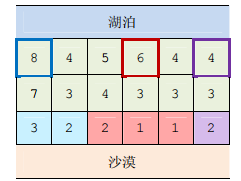
上图中,在 3 个粗线框出的城市中建造蓄水厂,可以满足要求。以这 3 个蓄水厂为源头
在干旱区中建造的输水站分别用 3 种颜色标出。当然,建造方法可能不唯一。
【数据范围】
本题共有 10 个测试数据,每个数据的范围如下表所示:
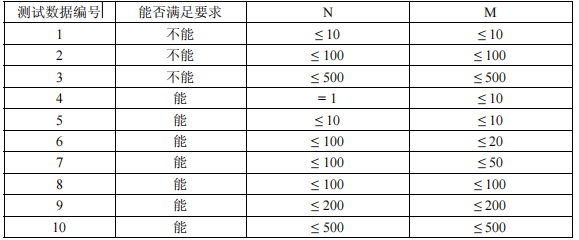
对于所有的 10 个数据,每座城市的海拔高度都不超过
#include<bits/stdc++.h>
#define il inline
#define ll long long
#define For(i,a,b) for(int (i)=(a);(i)<=(b);(i)++)
#define Bor(i,a,b) for(int (i)=(b);(i)>=(a);(i)--)
#define Max(a,b) ((a)>(b)?(a):(b))
#define Min(a,b) ((a)>(b)?(b):(a))
using namespace std;
const int N=505,dx[4]={1,-1,0,0},dy[4]={0,0,1,-1};
int mp[N][N],l[N][N],r[N][N],n,m,tot;
bool vis[N][N],f;
il int gi(){
int a=0;char x=getchar();bool f=0;
while((x<'0'||x>'9')&&x!='-')x=getchar();
if(x=='-')x=getchar(),f=1;
while(x>='0'&&x<='9')a=(a<<3)+(a<<1)+x-48,x=getchar();
return f?-a:a;
}
il void dfs(int x,int y){
vis[x][y]=1;
For(i,0,3){
int xx=x+dx[i],yy=y+dy[i];
if(xx<1||yy<1||xx>n||yy>m)continue;
if(mp[xx][yy]<mp[x][y]){
if(!vis[xx][yy])dfs(xx,yy);
l[x][y]=min(l[x][y],l[xx][yy]);
r[x][y]=max(r[x][y],r[xx][yy]);
}
}
}
int main(){
ios::sync_with_stdio(0);
n=gi(),m=gi();
memset(l,0x3f,sizeof(l));
For(i,1,m) l[n][i]=r[n][i]=i;
For(i,1,n) For(j,1,m) mp[i][j]=gi();
For(i,1,m) if(!vis[1][i]) dfs(1,i);
For(i,1,m) if(!vis[n][i]) tot++,f=1;
if(f)cout<<0<<endl<<tot;
else {
int pos=1,lp=1;
while(pos<=m){
For(i,1,m)
if(l[1][i]<=lp) pos=max(pos,r[1][i]);
pos++;tot++;lp=pos;
}
cout<<1<<endl<<tot;
}
return 0;
}
潜伏者
【问题描述】
R 国和 S 国正陷入战火之中,双方都互派间谍,潜入对方内部,伺机行动。
历尽艰险后,潜伏于 S 国的 R 国间谍小 C 终于摸清了 S 国军用密码的编码规则:
1. S 国军方内部欲发送的原信息经过加密后在网络上发送,原信息的内容与加密后所得的内容均由大写字母‘A’-‘Z’构成(无空格等其他字符)。
2. S 国对于每个字母规定了对应的“密字”。加密的过程就是将原信息中的所有字母替换为其对应的“密字”。
3. 每个字母只对应一个唯一的“密字”,不同的字母对应不同的“密字”。“密字”可以和原字母相同。
例如,若规定‘A’的密字为‘A’,‘B’的密字为‘C’(其他字母及密字略),则原信息“ABA”被加密为“ACA”。
现在,小 C 通过内线掌握了 S 国网络上发送的一条加密信息及其对应的原信息。小 C希望能通过这条信息,破译 S 国的军用密码。小 C 的破译过程是这样的:扫描原信息,对于原信息中的字母 x(代表任一大写字母),找到其在加密信息中的对应大写字母 y,并认为在密码里 y 是 x 的密字。如此进行下去直到停止于如下的某个状态:
1. 所有信息扫描完毕,‘A’-‘Z’ 所有 26 个字母在原信息中均出现过并获得了相应的“密字”。
2. 所有信息扫描完毕,但发现存在某个(或某些)字母在原信息中没有出现。
3. 扫描中发现掌握的信息里有明显的自相矛盾或错误(违反 S 国密码的编码规则)。
例如某条信息“XYZ”被翻译为“ABA”就违反了“不同字母对应不同密字”的规则。
在小 C 忙得头昏脑涨之际,R 国司令部又发来电报,要求他翻译另外一条从 S 国刚刚截取到的加密信息。现在请你帮助小 C:通过内线掌握的信息,尝试破译密码。然后利用破译的密码,翻译电报中的加密信息。
【输入】
输入文件名为 spy.in,共 3 行,每行为一个长度在 1 到 100 之间的字符串。
第 1 行为小 C 掌握的一条加密信息。
第 2 行为第 1 行的加密信息所对应的原信息。
第 3 行为 R 国司令部要求小 C 翻译的加密信息。
输入数据保证所有字符串仅由大写字母‘A’-‘Z’构成,且第 1 行长度与第 2 行相等。
【输出】
输出文件 spy.out 共 1 行。
若破译密码停止时出现 2,3 两种情况,请你输出“Failed”(不含引号,注意首字母大写,其它小写)。
否则请输出利用密码翻译电报中加密信息后得到的原信息。
【输入输出样例 1】
【输入输出样例 1 说明】
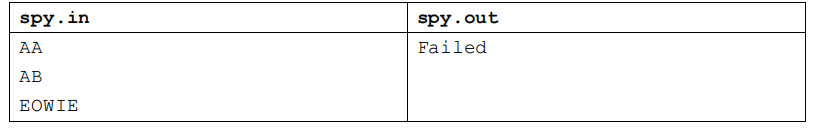
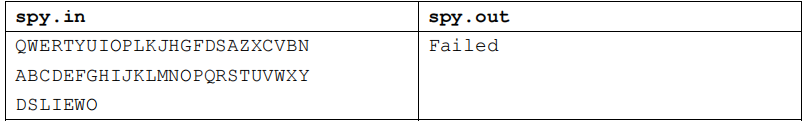
原信息中的字母‘A’和‘B’对应相同的密字,输出“Failed”。
【输入输出样例 2】
【输入输出样例 2 说明】
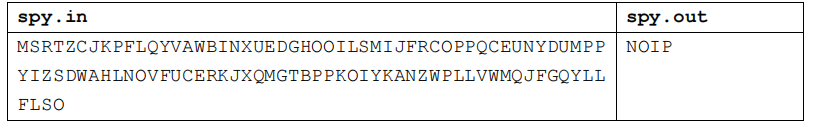
字母‘Z’在原信息中没有出现,输出“Failed”。
【输入输出样例 3】
#include<iostream>
#include<cstdio>
#include<cstring>
using namespace std;
string s1,s2,s;
int t[27];
int main()
{
cin>>s1>>s2>>s;
int l=s1.size(),l2=s.size();
for(int i=0;i<1;i++)
t[s1[i]-64]++;
for(int i=1;i<26;i++)
if(t[i]==0)
{
printf("Failed");
return 0;
}
for(int i=0;i<1;i++)
for(int j=i+1;j<1;j++)
if(s1[j]==s1[i]&&s2[j]!=s2[i])
{
printf("Failed");
return 0;
}
for(int i=0;i<1;i++)
for(int j=i+i;j<1;j++)
{
printf("Failed");
return 0;
}
for(int i=0;i<12;++i)
cout<<s2[s1.find(s[i])];
return 0;
}
Hankson 的趣味题
【问题描述】
Hanks 博士是 BT (Bio-Tech,生物技术) 领域的知名专家,他的儿子名叫 Hankson。现在,刚刚放学回家的 Hankson 正在思考一个有趣的问题。
今天在课堂上,老师讲解了如何求两个正整数 c1 和 c2 的最大公约数和最小公倍数。现在 Hankson 认为自己已经熟练地掌握了这些知识,他开始思考一个“求公约数”和“求公倍数”之类问题的“逆问题”,这个问题是这样的:已知正整数 a0,a1,b0,b1,设某未知正整数 x 满足:
1. x 和 a0 的最大公约数是 a1;
2. x 和 b0 的最小公倍数是 b1。
Hankson 的“逆问题”就是求出满足条件的正整数 x。但稍加思索之后,他发现这样的x 并不唯一,甚至可能不存在。因此他转而开始考虑如何求解满足条件的 x 的个数。请你帮助他编程求解这个问题。
【输入】
输入文件名为 son.in。第一行为一个正整数 n,表示有 n 组输入数据。接下来的 n 行每行一组输入数据,为四个正整数 a0,a1,b0,b1,每两个整数之间用一个空格隔开。输入数据保证 a0 能被 a1 整除,b1 能被 b0 整除。
【输出】
输出文件 son.out 共 n 行。每组输入数据的输出结果占一行,为一个整数。
对于每组数据:若不存在这样的 x,请输出 0;
若存在这样的 x,请输出满足条件的 x 的个数
【输入输出样例】
【说明】
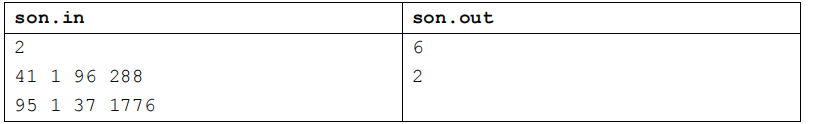
第一组输入数据,x 可以是 9、18、36、72、144、288,共有 6 个。
第二组输入数据,x 可以是 48、1776,共有 2 个。
【数据范围】
对于 50%的数据,保证有 1≤a0,a1,b0,b1≤10000 且 n≤100。
对于 100%的数据,保证有 1≤a0,a1,b0,b1≤2,000,000,000 且 n≤2000。
#include<iostream>
#include<cstdio>
#define LL long long
using namespace std;
LL n,a0,a1,b0,b1,a,b,ans,c,d,t;
LL gcd(LL a,LL b)
{
if(b==0)return a;
return gcd(b,a%b);
}
int main()
{
//freopen("son.in","r",stdin);
//freopen("son.out","w",stdout);
scanf("%d",&n);
while(n--)
{
ans=0;
scanf("%d%d%d%d",&a0,&a1,&b0,&b1);
for(int i=1;i*i<=b1;i++)
{
if(b1%i!=0)continue;
t=b1/i;
a=gcd(i,a0);
b=b0*i/gcd(i,b0);
if(a1==a&&b1==b)ans++;
c=gcd(t,a0);
d=b0*t/gcd(t,b0);
if(a1==c&&b1==d&&t!=i)ans++;
}
cout<<ans<<endl;
}
return 0;
}
最优贸易
【问题描述】
C 国有 n 个大城市和 m 条道路,每条道路连接这 n 个城市中的某两个城市。任意两个城市之间最多只有一条道路直接相连。这 m 条道路中有一部分为单向通行的道路,一部分为双向通行的道路,双向通行的道路在统计条数时也计为 1 条。
C 国幅员辽阔,各地的资源分布情况各不相同,这就导致了同一种商品在不同城市的价格不一定相同。但是,同一种商品在同一个城市的买入价和卖出价始终是相同的。
商人阿龙来到 C 国旅游。当他得知同一种商品在不同城市的价格可能会不同这一信息之后,便决定在旅游的同时,利用商品在不同城市中的差价赚回一点旅费。设 C 国 n 个城市的标号从 1~ n,阿龙决定从 1 号城市出发,并最终在 n 号城市结束自己的旅行。在旅游的过程中,任何城市可以重复经过多次,但不要求经过所有 n 个城市。阿龙通过这样的贸易方式赚取旅费:他会选择一个经过的城市买入他最喜欢的商品——水晶球,并在之后经过的另一个城市卖出这个水晶球,用赚取的差价当做旅费。由于阿龙主要是来 C 国旅游,他决定这个贸易只进行最多一次,当然,在赚不到差价的情况下他就无需进行贸易。
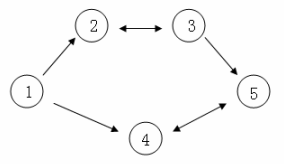
假设 C 国有 5 个大城市,城市的编号和道路连接情况如下图,单向箭头表示这条道路为单向通行,双向箭头表示这条道路为双向通行。
假设 1~n 号城市的水晶球价格分别为 4,3,5,6,1。
阿龙可以选择如下一条线路:1->2->3->5,并在 2 号城市以 3 的价格买入水晶球,在 3号城市以 5 的价格卖出水晶球,赚取的旅费数为 2。
阿龙也可以选择如下一条线路 1->4->5->4->5,并在第 1 次到达 5 号城市时以 1 的价格买入水晶球,在第 2 次到达 4 号城市时以 6 的价格卖出水晶球,赚取的旅费数为 5。
现在给出 n 个城市的水晶球价格,m 条道路的信息(每条道路所连接的两个城市的编号以及该条道路的通行情况)。请你告诉阿龙,他最多能赚取多少旅费。
【输入】
输入文件名为 trade.in。
第一行包含 2 个正整数 n 和 m,中间用一个空格隔开,分别表示城市的数目和道路的数目。
第二行 n 个正整数,每两个整数之间用一个空格隔开,按标号顺序分别表示这 n 个城市的商品价格。
接下来 m 行,每行有 3 个正整数,x,y,z,每两个整数之间用一个空格隔开。如果 z=1,表示这条道路是城市 x 到城市 y 之间的单向道路;如果 z=2,表示这条道路为城市 x 和城市
y 之间的双向道路。
【输出】
输出文件 trade.out 共 1 行,包含 1 个整数,表示最多能赚取的旅费。如果没有进行贸易,则输出 0。
【输入输出样例】
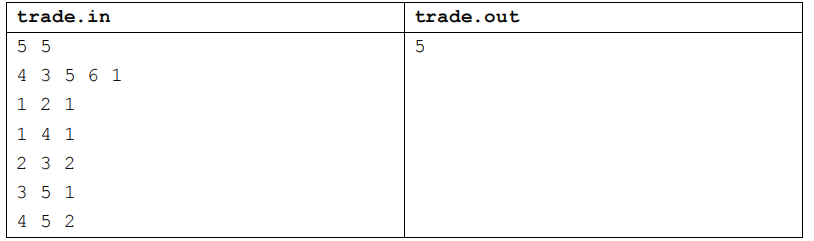
【数据范围】
输入数据保证 1 号城市可以到达 n 号城市。
对于 10%的数据,1≤n≤6。
对于 30%的数据,1≤n≤100。
对于 50%的数据,不存在一条旅游路线,可以从一个城市出发,再回到这个城市。
对于 100%的数据,1≤n≤100000,1≤m≤500000,1≤x,y≤n,1≤z≤2,1≤各城市水晶球价格≤100。
#include<iostream>
#include<cstring>
#include<queue>
using namespace std;
const int maxn=1000001;
struct node
{
int to;
int from;
int next1;
int next2;
}e[maxn];
queue<int> q;
int n,m,ans,cnt,v[maxn],head1[maxn],head2[maxn];
int maxx[maxn],minx[maxn];
bool flag[maxn];
void edd_edge(int u,int v)
{
cnt++;
e[cnt].to=v;e[cnt].from=u;
e[cnt].next1=head1[u];
e[cnt].next2=head2[v];
head1[u]=head2[v]=cnt;
}
void spfa1()
{
memset(minx,1,sizeof(minx));
q.push(1);
flag[1]=1;
minx[1]=v[1];
while(!q.empty())
{
int t=q.front();
q.pop();
for(int i=head1[t];i;i=e[i].next1)
{
int u=e[i].to;
minx[u]=min(minx[t],min(minx[u],v[u]));
if(!flag[u])
{
q.push(u);
flag[u]=1;
}
}
}
}
void spfa2()
{
memset(maxx,0,sizeof(maxx));
memset(flag,0,sizeof(flag));
q.push(n);
flag[n]=1;
maxx[n]=v[n];
while(!q.empty())
{
int t=q.front();
q.pop();
for(int i=head2[t];i;i=e[i].next2)
{
int u=e[i].from;
maxx[u]=max(maxx[t],max(maxx[u],v[u]));
if(!flag[u])
{
q.push(u);
flag[u]=1;
}
}
}
}
int main()
{
cin>>n>>m;
for(int i=1;i<=n;i++)
cin>>v[i];
int x,y,z;
for(int i=1;i<=m;i++)
{
cin>>x>>y>>z;
edd_edge(x,y);
if(z==2)
edd_edge(y,x);
}
spfa1();
spfa2();
for(int i=1;i<=n;i++)
ans=max(ans,maxx[i]-minx[i]);
cout<<ans;
return 0;
}
靶形数独
【问题描述】
小城和小华都是热爱数学的好学生,最近,他们不约而同地迷上了数独游戏,好胜的他们想用数独来一比高低。但普通的数独对他们来说都过于简单了,于是他们向 Z 博士请教,Z 博士拿出了他最近发明的“靶形数独”,作为这两个孩子比试的题目。
靶形数独的方格同普通数独一样,在 9 格宽×9 格高的大九宫格中有 9 个 3 格宽×3 格高的小九宫格(用粗黑色线隔开的)。在这个大九宫格中,有一些数字是已知的,根据这些数字,利用逻辑推理,在其他的空格上填入 1 到 9 的数字。每个数字在每个小九宫格内不能重复出现,每个数字在每行、每列也不能重复出现。但靶形数独有一点和普通数独不同,即每一个方格都有一个分值,而且如同一个靶子一样,离中心越近则分值越高。(如图)
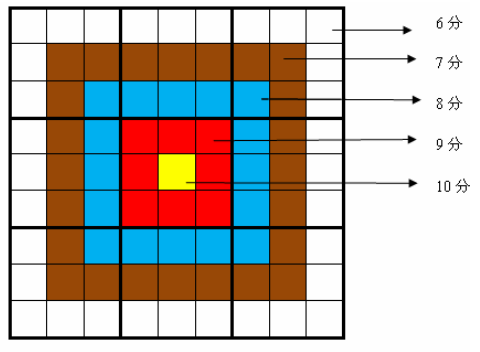
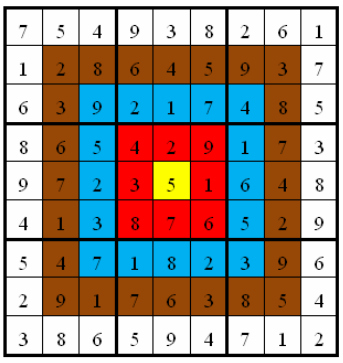
上图具体的分值分布是:最里面一格(黄色区域)为 10 分,黄色区域外面的一圈(红色区域)每个格子为 9 分,再外面一圈(蓝色区域)每个格子为 8 分,蓝色区域外面一圈(棕色区域)每个格子为 7 分,最外面一圈(白色区域)每个格子为 6 分,如上图所示。比赛的要求是:每个人必须完成一个给定的数独(每个给定数独可能有不同的填法),而且要争取更高的总分数。而这个总分数即每个方格上的分值和完成这个数独时填在相应格上的数字的乘积的总和。如图,在以下的这个已经填完数字的靶形数独游戏中,总分数为 2829。游戏规定,将以总分数的高低决出胜负。
由于求胜心切,小城找到了善于编程的你,让你帮他求出,对于给定的靶形数独,能够得到的最高分数。
【输入】
输入文件名为 sudoku.in。
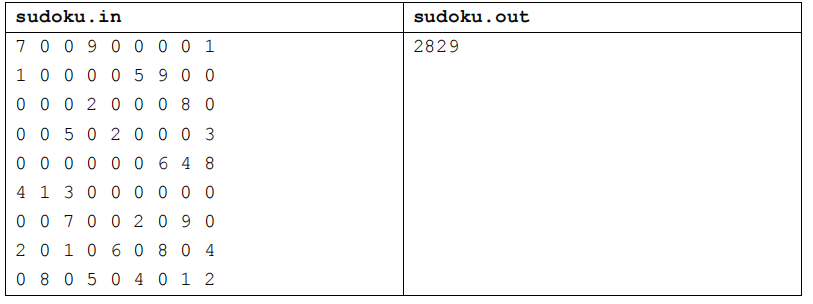
一共 9 行。每行 9 个整数(每个数都在 0—9 的范围内),表示一个尚未填满的数独方格,未填的空格用“0”表示。每两个数字之间用一个空格隔开。
【输出】
输出文件 sudoku.out 共 1 行。
输出可以得到的靶形数独的最高分数。如果这个数独无解,则输出整数-1。
【输入输出样例 1】
【输入输出样例 2】
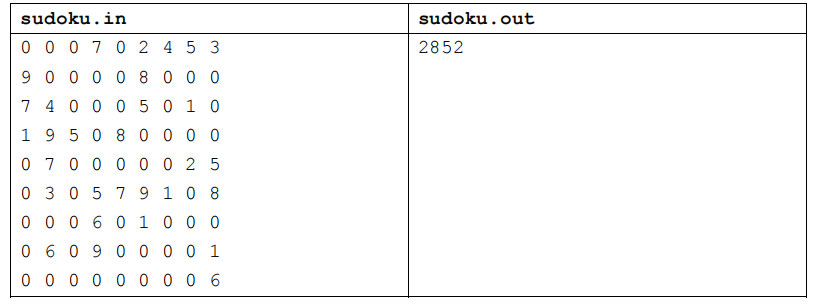
【数据范围】
40%的数据,数独中非 0 数的个数不少于 30。
80%的数据,数独中非 0 数的个数不少于 26。
100%的数据,数独中非 0 数的个数不少于 24。
#include<bits/stdc++.h>
using namespace std;
int a[20][20],b[20][20],hang[20][20],lie[20][20];
int check(int x,int k,int j)
{
if(b[(x-1)/3*3+(k-1)/3][j]==0&&hang[x][j]==0&&lie[k][j]==0)
{
return 1;
}
return 0;
}
struct nomd
{
int i,sum;
}p[20];
int cmp(nomd a,nomd b)
{
return a.sum<b.sum;
}
int ans=0,maxn=0;
int e[9][9]={//*权值
6,6,6,6,6,6,6,6,6,
6,7,7,7,7,7,7,7,6,
6,7,8,8,8,8,8,7,6,
6,7,8,9,9,9,8,7,6,
6,7,8,9,10,9,8,7,6,
6,7,8,9,9,9,8,7,6,
6,7,8,8,8,8,8,7,6,
6,7,7,7,7,7,7,7,6,
6,6,6,6,6,6,6,6,6
};
void dfs(int w,int k)
{
if(w==9&&k==10)
{
for(int i=1;i<=9;i++)
{
for(int j=1;j<=9;j++)
{
ans+=a[i][j]*e[i-1][j-1];
}
}
if(ans>maxn)
maxn=ans;
ans=0;
return;
}
if(k==10)
{
dfs(w+1,1);
return;
}
if(a[p[w].i][k]==0)
{
for(int j=9;j>=1;j--)
{
if(check(p[w].i,k,j))
{
a[p[w].i][k]=j;
b[(p[w].i-1)/3*3+(k-1)/3][j]=1;
hang[p[w].i][j]=1;
lie[k][j]=1;
dfs(w,k+1);
a[p[w].i][k]=0;
b[(p[w].i-1)/3*3+(k-1)/3][j]=0;
hang[p[w].i][j]=0;
lie[k][j]=0;
}
}
return;
}
else
{
dfs(w,k+1);
}
return;
}
int main()
{
for(int i=1;i<=9;i++)
{
p[i].i=i;
for(int j=1;j<=9;j++)
{
scanf("%d",&a[i][j]);
if(a[i][j]==0)
{
p[i].sum++;
}
b[(i-1)/3*3+(j-1)/3][a[i][j]]=1;
hang[i][a[i][j]]=1;
lie[j][a[i][j]]=1;
}
}
sort(p+1,p+9,cmp);
dfs(1,1);
if(maxn==0)
printf("-1\n");
else
printf("%d\n",maxn);
return 0;
}
笨小猴
【问题描述】
笨小猴的词汇量很小,所以每次做英语选择题的时候都很头疼。但是他找到了一种方法,经试验证明,用这种方法去选择选项的时候选对的几率非常大!
这种方法的具体描述如下:假设 maxn 是单词中出现次数最多的字母的出现次数,minn是单词中出现次数最少的字母的出现次数,如果 maxn-minn 是一个质数,那么笨小猴就认为这是个 Lucky Word,这样的单词很可能就是正确的答案。
【输入】
输入文件 word.in 只有一行,是一个单词,其中只可能出现小写字母,并且长度小于 100。
【输出】
输出文件 word.out 共两行,第一行是一个字符串,假设输入的的单词是 Lucky Word,那么输出“Lucky Word”,否则输出“No Answer”;
第二行是一个整数,如果输入单词是 Lucky Word,输出 maxn-minn 的值,否则输出 0。
【输入输出样例 1】
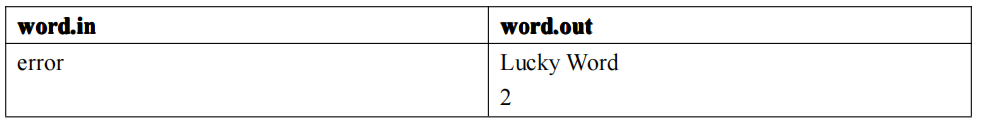
【输入输出样例 1 解释】
单词 error 中出现最多的字母 r 出现了 3 次,出现次数最少的字母出现了 1 次,3-1=2,2 是质数。
【输入输出样例 2】
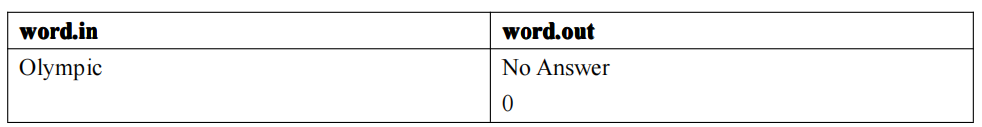
【输入输出样例 2 解释】
单词 olympic 中出现最多的字母 i 出现了 2 次,出现次数最少的字母出现了 1 次,2-1=1,1不是质数。
#include<bits/stdc++.h> //万能头文件
using namespace std;
int primenum(int m); //质数的判断
int main()
{
char ch[1000];
int array[100]={0};
int m,n,i,j,k;
int maxn=-500,minn=9999;
scanf("%s",ch);
for(int m=0;m<strlen(ch);m++){
array[ch[m]-'a']++;
}
for(int m=0;m<26;m++){
if(array[m]>maxn&&array[m]!=0) maxn=array[m];
if(array[m]<minn&&array[m]!=0) minn=array[m];
}
if(primenum(maxn-minn)){
printf("Lucky Word\n%d",maxn-minn);
}else{
printf("No Answer\n0");
}
}
int primenum(int m)
{
int i;
if(m==2||m==3) return 1;
if(m==1||m==0) return 0;
if(m%6!=1&&m%6!=5) return 0; //优化质数的判断方法
for(i=5;i<=sqrt(m);i+=5){
if(m%i==0||m%(i+2)==0){
return 0;
}
火柴棒等式
【问题描述】
给你 n 根火柴棍,你可以拼出多少个形如“A+B=C”的等式?等式中的 A、B、C 是用火柴棍拼出的整数(若该数非零,则最高位不能是 0)。用火柴棍拼数字 0-9 的拼法如图所示:
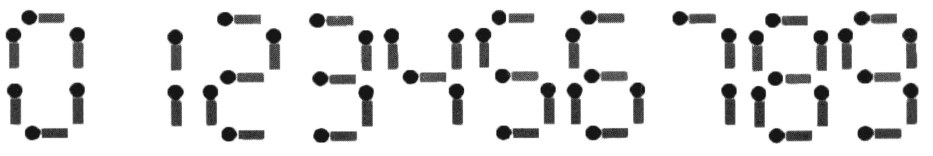
注意:
1. 加号与等号各自需要两根火柴棍
2. 如果 A≠B,则 A+B=C 与 B+A=C 视为不同的等式(A、B、C>=0)
3. n 根火柴棍必须全部用上
【输入】
输入文件 matches.in 共一行,又一个整数 n(n<=24)。
【输出】
输出文件 matches.out 共一行,表示能拼成的不同等式的数目。
【输入输出样例 1】

【输入输出样例 1 解释】
2 个等式为 0+1=1 和 1+0=1。
【输入输出样例 2】

【输入输出样例 2 解释】
9 个等式为:
0+4=4
0+11=11
1+10=11
2+2=4
2+7=9
4+0=4
7+2=9
10+1=11
11+0=11
#include<bits/stdc++.h>
using namespace std;
int a[10]={6,2,5,5,4,5,6,3,7,6};
int s[2010]={6};
int main(){
int n;
scanf("%d",&n);
int sum=0;
for(int i=0;i<=2000;i++){
int t=i;
while(t){
s[i]+=a[t%10];
t/=10;
}
}
for(int i=0;i<=1000;i++){
for(int j=0;j<=1000;j++){
if(s[i]+s[j]+s[i+j]+4==n) sum++;
}
}
printf("%d\n",sum);
return 0;
}
传纸条
【问题描述】
小渊和小轩是好朋友也是同班同学,他们在一起总有谈不完的话题。一次素质拓展活动中,班上同学安排做成一个 m 行 n 列的矩阵,而小渊和小轩被安排在矩阵对角线的两端,因此,他们就无法直接交谈了。幸运的是,他们可以通过传纸条来进行交流。纸条要经由许多同学传到对方手里,小渊坐在矩阵的左上角,坐标(1,1),小轩坐在矩阵的右下角,坐标(m,n)。从小渊传到小轩的纸条只可以向下或者向右传递,从小轩传给小渊的纸条只可以向上或者向左传递。
在活动进行中,小渊希望给小轩传递一张纸条,同时希望小轩给他回复。班里每个同学都可以帮他们传递,但只会帮他们一次,也就是说如果此人在小渊递给小轩纸条的时候帮忙,那么在小轩递给小渊的时候就不会再帮忙。反之亦然。
还有一件事情需要注意,全班每个同学愿意帮忙的好感度有高有低(注意:小渊和小轩的好心程度没有定义,输入时用 0 表示),可以用一个 0-100 的自然数来表示,数越大表示越好心。小渊和小轩希望尽可能找好心程度高的同学来帮忙传纸条,即找到来回两条传递路径,使得这两条路径上同学的好心程度只和最大。现在,请你帮助小渊和小轩找到这样的两条路径。
【输入】
输入文件 message.in 的第一行有 2 个用空格隔开的整数 m 和 n,表示班里有 m 行 n 列(1<=m,n<=50)。
接下来的 m 行是一个 m*n 的矩阵,矩阵中第 i 行 j 列的整数表示坐在第 i 行 j 列的学生的好心程度。每行的 n 个整数之间用空格隔开。
【输出】
输出文件 message.out 共一行,包含一个整数,表示来回两条路上参与传递纸条的学生的好心程度之和的最大值。
【输入输出样例】
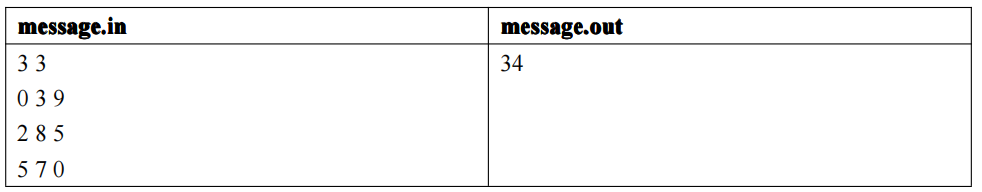
【限制】
30%的数据满足:1<=m,n<=10
100%的数据满足:1<=m,n<=50
#include <bits/stdc++.h>
int n,m,s[101][101],dp[101][101][101];
int main(){
freopen("message.in","r",stdin);
freopen("message.ans","w",stdout);
std::cin>>n>>m;
for(int i=1;i<=n;i++)
for(int j=1;j<=m;j++)
std::cin>>s[i][j];
for(int i=3;i<=m+n;i++)
for(int j=1;j<=std::min(i-1,n);j++)
for(int k=1;k<=std::min(i-1,n);k++){
if(i<m+n&&j==k)continue;
dp[i][j][k]=std::max(dp[i-1][j][k],dp[i-1][j-1][k-1]);
if(j-1!=k)dp[i][j][k]=std::max(dp[i][j][k],dp[i-1][j-1][k]);
if(k-1!=j)dp[i][j][k]=std::max(dp[i][j][k],dp[i-1][j][k-1]);
dp[i][j][k]+=s[j][i-j]+s[k][i-k];
}
std::cout<<dp[m+n][n][n]<<std::endl;
return 0;
}
双栈排序
【问题描述】
Tom 最近在研究一个有趣的排序问题。如图所示,通过 2 个栈 S1 和 S2,Tom 希望借助以下 4 种操作实现将输入序列升序排序。
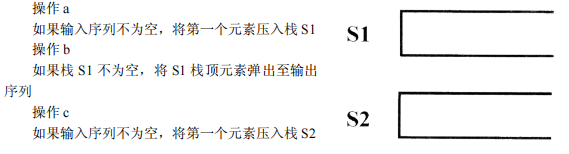
操作 d
如果栈 S2 不为空,将 S2 栈顶元素弹出至输出序列
如果一个 1~n 的排列 P 可以通过一系列操作使得输出序列为 1,2,…,(n-1),n,Tom就称 P 是一个“可双栈排序排列”。例如(1,3,2,4)就是一个“可双栈排序序列”,而(2,3,4,1)不是。下图描述了一个将(1,3,2,4)排序的操作序列:<a,c,c,b,a,d,d,b>
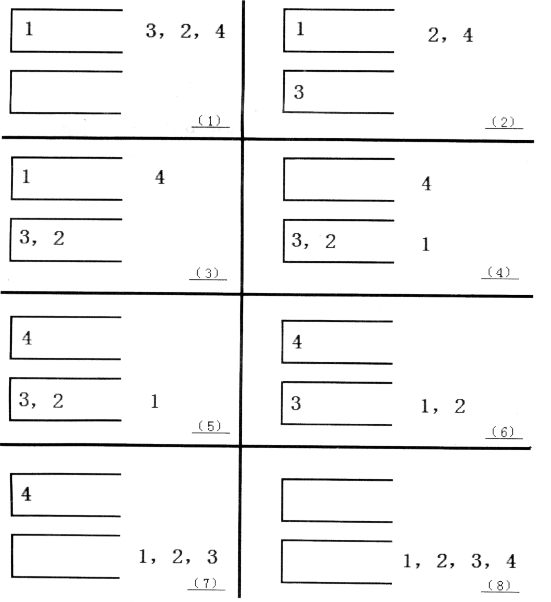
当然,这样的操作序列有可能有几个,对于上例(1,3,2,4),<a,c,c,b,a,d,d,b>是另外一个可行的操作序列。Tom 希望知道其中字典序最小的操作序列是什么。
【输入】
输入文件 twostack.in 的第一行是一个整数 n。
第二行有 n 个用空格隔开的正整数,构成一个 1~n 的排列。
【输出】
输出文件 twostack.out 共一行,如果输入的排列不是“可双栈排序排列”,输出数字 0;
否则输出字典序最小的操作序列,每两个操作之间用空格隔开,行尾没有空格。
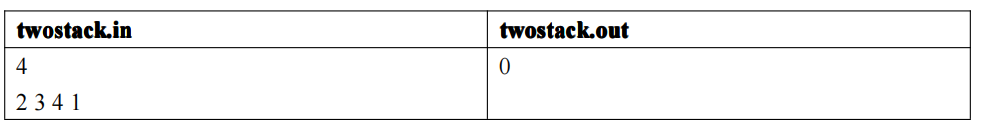
【输入输出样例 1】
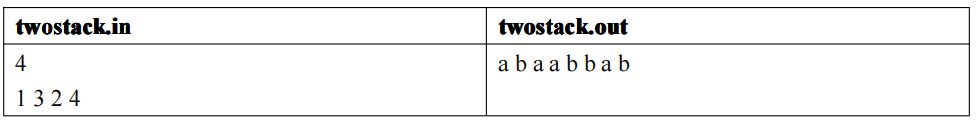
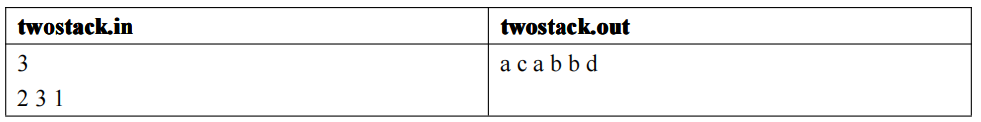
【输入输出样例 2】
【输入输出样例 3】
【限制】
30%的数据满足: n<=10
50%的数据满足: n<=50
100%的数据满足: n<=1000
#include <bits/stdc++.h>
using namespace std;
const int Max=1010;
int n,m=1,size,tot1,tot2,p1[Max],p2[Max];
int first[Max],f[Max],num[Max],vis[Max];
struct shu{int to,next,len;}edge[Max*Max];
inline int get_int()
{
int x=0,f=1;
char c;
for(c=getchar();(!isdigit(c))&&(c!='-');c=getchar());
if(c=='-') f=-1,c=getchar();
for(;isdigit(c);c=getchar()) x=(x<<3)+(x<<1)+c-'0';
return x*f;
}
inline void build(int x,int y)
{
edge[++size].next=first[x],first[x]=size,edge[size].to=y;
edge[++size].next=first[y],first[y]=size,edge[size].to=x;
}
inline void pre()
{
f[n]=num[n];
for(int i=n-1;i>=1;i--) f[i]=min(f[i+1],num[i]);
for(int i=1;i<=n;i++)
for(int j=i+1;j<=n;j++)
if(f[j]<num[i]&&num[i]<num[j]) build(i,j);
}
inline bool dfs(int p,int color)
{
vis[p]=color;
for(int u=first[p];u;u=edge[u].next)
{
int to=edge[u].to;
if(!vis[to]) dfs(to,3-color);
else if(color==vis[to]) return 0;
}
return 1;
}
int main()
{
n=get_int();
for(int i=1;i<=n;i++) num[i]=get_int();
pre();
for(int i=1;i<=n;i++) if(!vis[i]&&!dfs(i,1)) {puts("0");return 0;}
for(int i=1;i<=n;i++)
{
if(vis[i]==1)p1[++tot1]=num[i],printf("a ");
else p2[++tot2]=num[i],printf("c ");
while(m==p1[tot1]||m==p2[tot2])
{
if(m==p1[tot1]) tot1--,printf("b ");
else tot2--,printf("d ");
m++;
}
}
return 0;
}
统计数字
【问题描述】
某次科研调查时得到了 n 个自然数,每个数均不超过 1500000000(1.5*109)。已知不相同的数
不超过 10000 个,现在需要统计这些自然数各自出现的次数,并按照自然数从小到大的顺序输出统
计结果。
【输入】
输入文件 count.in 包含 n+1 行:
第 1 行是整数 n,表示自然数的个数。
第 2~n+1 行每行一个自然数。
【输出】
输出文件 count.out 包含 m 行(m 为 n 个自然数中不相同数的个数),按照自然数从小到大
的顺序输出。每行输出两个整数,分别是自然数和该数出现的次数,其间用一个空格隔开。
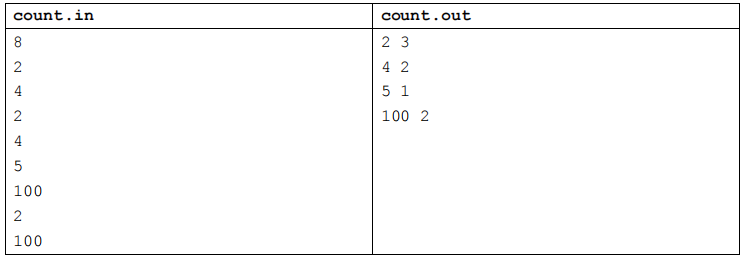
【输入输出样例】
【限制】
40%的数据满足:1<=n<=1000
80%的数据满足:1<=n<=50000
100%的数据满足:1<=n<=200000,每个数均不超过 1 500 000 000(1.5*10^9)
#include<bits/stdc++.h>
using namespace std;
const int N=1e5;
long long a[N];
struct s
{
long long num;
long long sum;
}s[100001];
bool cmp(struct s a,struct s b)
{
return a.num<b.num;
}
long long n,m,i;
int main()
{
map<long long,int>mp;
cin>>n;
for(i=1;i<=n;i++)
{
cin>>a[i];
mp[a[i]]++;
}
sort(a+1,a+n+1);
n=unique(a+1,a+1+ n)-(a+1);
for(i=1;i<=n;i++)
{
s[i].num=a[i];
s[i].sum=mp[a[i]];
}
sort(s+1,s+1+n,cmp);
for(i=1;i<=n;i++)
{
cout<<s[i].num<<" "<<s[i].sum<<endl;
}
return 0;
}
字符串的展开
【问题描述】
在初赛普及组的“阅读程序写结果”的问题中,我们曾给出一个字符串展开的例子:如果在输入的字符串中,含有类似于“d-h”或“4-8”的子串,我们就把它当作一种简写,输出时,用连续递增的字母或数字串替代其中的减号,即,将上面两个子串分别输出为“defgh”和“45678”。在本题中,我们通过增加一些参数的设置,使字符串的展开更为灵活。具体约定如下:
(1)遇到下面的情况需要做字符串的展开:在输入的字符串中,出现了减号“-”,减号两侧同为小写字母或同为数字,且按照 ASCII 码的顺序,减号右边的字符严格大于左边的字符。
(2)参数 p1:展开方式。p1=1 时,对于字母子串,填充小写字母;p1=2 时,对于字母子串,填充大写字母。这两种情况下数字子串的填充方式相同。p1=3 时,不论是字母子串还是数字子串,都用与要填充的字母个数相同的星号“*”来填充。
(3)参数 p2:填充字符的重复个数。p2=k 表示同一个字符要连续填充 k 个。例如,当 p2=3时,子串“d-h”应扩展为“deeefffgggh”。减号两侧的字符不变。
(4)参数 p3:是否改为逆序:p3=1 表示维持原有顺序,p3=2 表示采用逆序输出,注意这时仍然不包括减号两端的字符。例如当 p1=1、p2=2、p3=2 时,子串“d-h”应扩展为“dggffeeh”。
(5)如果减号右边的字符恰好是左边字符的后继,只删除中间的减号,例如:“d-e”应输出为“de”,“3-4”应输出为“34”。如果减号右边的字符按照 ASCII 码的顺序小于或等于左边字符,输出时,要保留中间的减号,例如:“d-d”应输出为“d-d”,“3-1”应输出为“3-1”。
【输入】
输入文件 expand.in 包括两行:
第 1 行为用空格隔开的 3 个正整数,依次表示参数 p1,p2,p3。
第 2 行为一行字符串,仅由数字、小写字母和减号“-”组成。行首和行末均无空格。
【输出】
输出文件 expand.out 只有一行,为展开后的字符串。
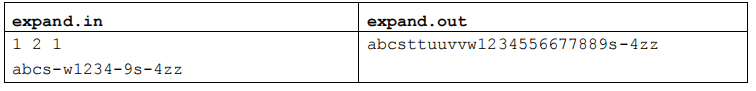
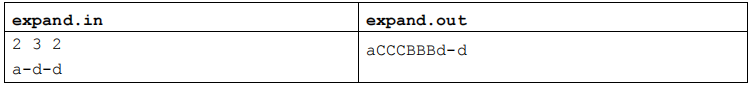
【输入输出样例 1】
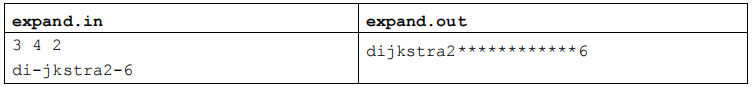
【输入输出样例 2】
【输入输出样例 3】
【限制】
40%的数据满足:字符串长度不超过 5
100%的数据满足:1<=p1<=3, 1<=p2<=8, 1<=p3<=2。字符串长度不超过 100
#include<bits/stdc++.h>
using namespace std;
const int maxn=1e6+7;
int main()
{
int p1,p2,p3,n;
char a[maxn],b[maxn];
cin>>p1>>p2>>p3>>a;
n=strlen(a);
for(int i=0;i<n;i++)
{
if(a[i]=='-'&&i&&i<=n-2)
{
if(a[i-1]=='-'||a[i+1]=='-')cout<<'-';//这些是只能打印-号的情况
else if(a[i-1]+1==a[i+1])continue;//这些是只能打印-号的情况,或者不能打印
else if(a[i-1]>=a[i+1]||(a[i-1]<='9'&&a[i+1]>='A'))cout<<'-';//这些是只能打印-号的情况
else
{ int l=0;
if(p1==1)
{
for(int j=a[i-1]+1;j<a[i+1];j++)
{
for(int i=0;i<p2;i++)
b[l++]=tolower((char)j);
}
}
else if(p1==2)
{
for(int j=a[i-1]+1;j<a[i+1];j++)
{
for(int i=0;i<p2;i++)
b[l++]=toupper((char)j);
}
}
else
{
for(int j=a[i-1]+1;j<a[i+1];j++)
{
for(int i=0;i<p2;i++)
b[l++]='*';
}
}
if(p3==2)
{
reverse(b,b+l);
}
for(int i=0;i<l;i++)
{
cout<<b[i];
}
}
}
else
cout<<a[i];
}
}
矩阵取数游戏
【问题描述】
帅帅经常跟同学玩一个矩阵取数游戏:对于一个给定的 n*m 的矩阵,矩阵中的每个元素 aij均为非负整数。游戏规则如下:
1. 每次取数时须从每行各取走一个元素,共 n 个。m 次后取完矩阵所有元素;
2. 每次取走的各个元素只能是该元素所在行的行首或行尾;
3. 每次取数都有一个得分值,为每行取数的得分之和,每行取数的得分 = 被取走的元素值*2i,其中 i 表示第 i 次取数(从 1 开始编号);
4. 游戏结束总得分为 m 次取数得分之和。
帅帅想请你帮忙写一个程序,对于任意矩阵,可以求出取数后的最大得分。
【输入】
输入文件 game.in 包括 n+1 行:
第 1 行为两个用空格隔开的整数 n 和 m。
第 2~n+1 行为 n*m 矩阵,其中每行有 m 个用单个空格隔开的非负整数。
【输出】
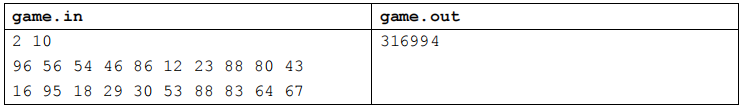
输出文件 game.out 仅包含 1 行,为一个整数,即输入矩阵取数后的最大得分。
【输入输出样例 1】
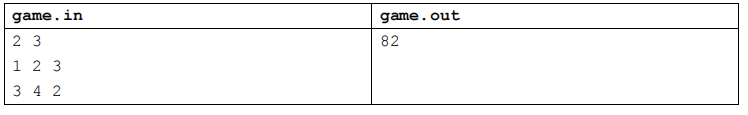
【输入输出样例 1 解释】
第 1 次:第 1 行取行首元素,第 2 行取行尾元素,本次得分为 1*21+2*21=6
第 2 次:两行均取行首元素,本次得分为 2*22+3*22=20
第 3 次:得分为 3*23+4*23=56。总得分为 6+20+56=82
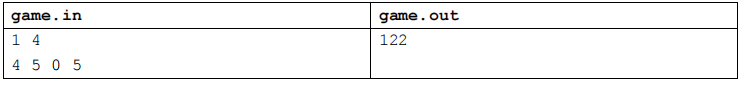
【输入输出样例 2】
【输入输出样例 3】
【限制】
60%的数据满足:1<=n, m<=30, 答案不超过 10^16
100%的数据满足:1<=n, m<=80, 0<=aij<=1000
#include <cstdio>
#include <cstring>
#include <algorithm>
#include <iostream>
#include <iomanip>
using namespace std;
const int maxnum = 35;
const int M = 100000000;
typedef unsigned long long ll;
int n, m, map[81][81];
struct highNum
{
ll num[maxnum];
highNum(int length = 1)
{
memset(num, 0, sizeof(num));
num[0] = length;
}
highNum operator = (highNum b)
{
memcpy(num, b.num, sizeof(b.num));
return *this;
}
highNum operator = (int b)
{
*this = highNum();
num[num[0]] = b;
return *this;
}
bool operator < (const highNum& b) const
{
if(num[0] < b.num[0]) return true;
if(num[0] == b.num[0])
{
for(int i = num[0]; i >= 1; --i)
{
if(num[i] > b.num[i]) return false;
if(num[i] < b.num[i]) return true;
}
}
return false;
}
highNum operator + (const highNum& b) const
{
highNum c = highNum(max(num[0], b.num[0]));
for(int i = 1; i <= c.num[0]; ++i)
{
c.num[i] += num[i] + b.num[i];
c.num[i + 1] += c.num[i] / M;
c.num[i] %= M;
}
while(c.num[c.num[0] + 1] > 0)
{
++c.num[0];
c.num[c.num[0] + 1] += c.num[c.num[0]] / M;
c.num[c.num[0]] %= M;
}
return c;
}
highNum operator * (const int b) const
{
highNum c = highNum(num[0]);
for(int i = 1; i <= c.num[0]; ++i)
{
c.num[i] += num[i] * b;
c.num[i + 1] += c.num[i] / M;
c.num[i] %= M;
}
while(c.num[c.num[0] + 1] > 0)
{
++c.num[0];
c.num[c.num[0] + 1] += c.num[c.num[0]] / M;
c.num[c.num[0]] %= M;
}
while(c.num[c.num[0]] == 0 && c.num[0] > 1) --c.num[0];
return c;
}
highNum operator * (const highNum& b) const
{
highNum c = highNum(num[0] + b.num[0]);
for(int i = 1; i <= num[0]; ++i) for(int j = 1; j <= b.num[0]; ++j)
{
c.num[i + j - 1] += num[i] * b.num[j];
c.num[i + j] += c.num[i + j - 1] / M;
c.num[i + j - 1] %= M;
}
while(c.num[c.num[0] + 1] > 0)
{
++c.num[0];
c.num[c.num[0] + 1] += c.num[c.num[0]] / M;
c.num[c.num[0]] %= M;
}
while(c.num[c.num[0]] == 0 && c.num[0] > 1) --c.num[0];
return c;
}
};
ostream& operator << (ostream& o, highNum& b)
{
o << b.num[b.num[0]];
o.setf(ios::fixed);
o.width(8);
o.fill('0');
for(int i = b.num[0] - 1; i >= 1; --i) o << b.num[i];
return o;
}
highNum ans, f[81][81], pw[81];
void init()
{
cin >> n >> m;
for(int i = 1; i <= n; ++i) for(int j = 1; j <= m; ++j)
cin >> map[i][j];
pw[1] = 2;
for(int i = 2; i <= m; ++i) pw[i] = pw[i - 1] * 2;
}
void work(int row)
{
for(int i = 1; i <= m; ++i) for(int j = 1; j <= m; ++j)
f[i][j] = highNum();
for(int i = 1; i <= m; ++i) f[i][i] = pw[m] * map[row][i];
for(int p = 1; p < m; ++p) for(int i = 1; i <= m - p; ++i)
{
int j = i + p;
f[i][j] = max(f[i + 1][j] + pw[m - p] * map[row][i], f[i][j - 1] + pw[m - p] * map[row][j]);
}
ans = ans + f[1][m];
}
int main()
{
init();
for(int i = 1; i <= n; ++i) work(i);
cout << ans;
return 0;
}
树网的核
【问题描述】
设 T=(V, E, W) 是一个无圈且连通的无向图(也称为无根树),每条边带有正整数的权,我们称 T 为树网(treenetwork),其中 V, E 分别表示结点与边的集合,W 表示各边长度的集合,并设 T 有 n 个结点。
路径:树网中任何两结点 a,b 都存在唯一的一条简单路径,用 d(a,b)表示以 a,b 为端点的路径的长度,它是该路径上各边长度之和。我们称 d(a,b)为 a,b 两结点间的距离。一点 v 到一条路径 P 的距离为该点与 P 上的最近的结点的距离:
d(v,P)=min{d(v,u),u 为路径 P 上的结点}。
树网的直径:树网中最长的路径称为树网的直径。对于给定的树网 T,直径不一定是唯一的,但可以证明:各直径的中点(不一定恰好是某个结点,可能在某条边的内部)是唯一的,我们称该
点为树网的中心。
偏心距 ECC(F):树网 T 中距路径 F 最远的结点到路径 F 的距离,即
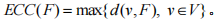
任务:对于给定的树网 T=(V, E,W)和非负整数 s,求一个路径 F,它是某直径上的一段路径(该路径两端均为树网中的结点),其长度不超过 s(可以等于 s),使偏心距 ECC(F)最小。我们称这个路径为树网 T=(V,E,W)的核(Core)。必要时,F 可以退化为某个结点。一般来说,在上述定义下,核不一定只有一个,但最小偏心距是唯一的。
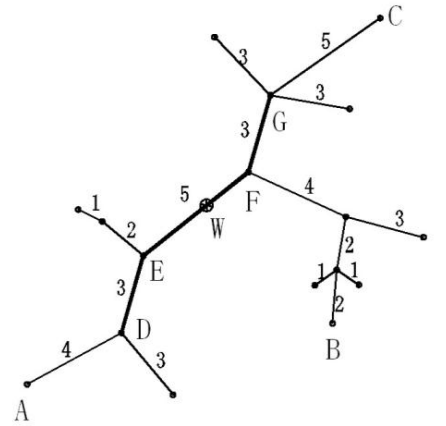
下面的图给出了树网的一个实例。图中,A-B 与 A-C 是两条直径,长度均为 20。点 W 是树网的中心,EF 边的长度为 5。如果指定 s=11,则树网的核为路径 DEFG(也可以取为路径 DEF),偏心距为 8。如果指定 s=0(或 s=1、s=2),则树网的核为结点 F,偏心距为 12。
【输入】
输入文件 core.in 包含 n 行:
第 1 行,两个正整数 n 和 s,中间用一个空格隔开。其中 n 为树网结点的个数,s 为树网的核的长度的上界。设结点编号依次为 1, 2, ..., n。
从第 2 行到第 n 行,每行给出 3 个用空格隔开的正整数,依次表示每一条边的两个端点编号和长度。例如,“2 4 7”表示连接结点 2 与 4 的边的长度为 7。
所给的数据都是正确的,不必检验。
【输出】
输出文件 core.out 只有一个非负整数,为指定意义下的最小偏心距。
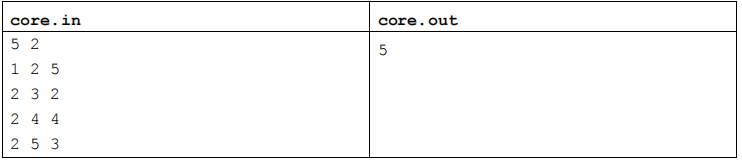
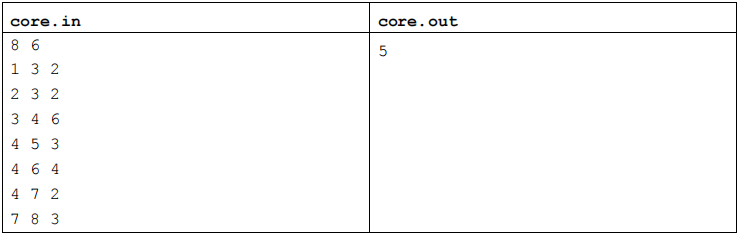
【输入输出样例 1】
【输入输出样例 2】
【限制】
40%的数据满足:5<=n<=15
70%的数据满足:5<=n<=80
100%的数据满足:5<=n<=300, 0<=s<=1000。边长度为不超过 1000 的正整数
#include<cstdio>
#include<algorithm>
#include<cstring>
const int inf=0x3f3f3f3f;
using namespace std;
int n,s,a,b,c,maxx=0,mxi,mxj;
int dis[305][305];
int read(){
int ans=0,f=1;char c=getchar();
while(c<'0'||c>'9'){
if(c=='-')f=-1;
c=getchar();
}
while(c>='0'&&c<='9'){
ans=ans*10+c-48;
c=getchar();
}
return ans*f;
}
int main(){
n=read();s=read();
for(int i=1;i<=n;i++)
for(int j=1;j<=n;j++)
if(i!=j)dis[i][j]=inf;
for(int i=1;i<=n-1;i++){
a=read();b=read();c=read();dis[a][b]=dis[b][a]=c;
}
for(int k=1;k<=n;k++)
for(int i=1;i<=n;i++)
for(int j=1;j<=n;j++){
if(dis[i][k]>=inf||dis[k][j]>=inf)continue;
dis[i][j]=min(dis[i][j],dis[i][k]+dis[k][j]);
if(dis[i][j]>maxx){
maxx=dis[i][j];
mxi=i;mxj=j;
}
}
int ans=inf;
for(int i=1;i<=n;i++){
if(dis[mxi][i]+dis[i][mxj]!=dis[mxi][mxj])continue;
for(int j=1;j<=n;j++){
if(dis[mxi][j]+dis[j][mxj]!=dis[mxi][mxj]||dis[i][j]>s)continue;
int ecc=0;
ecc=max(min(dis[mxi][i],dis[mxi][j]),min(dis[mxj][i],dis[mxj][j]));
ans=min(ans,ecc);
}
}
printf("%d",ans);
return 0;
}
能量项链
【问题描述】
在 Mars 星球上,每个 Mars 人都随身佩带着一串能量项链。在项链上有 N 颗能量珠。能量珠是一颗有头标记与尾标记的珠子,这些标记对应着某个正整数。并且,对于相邻的两颗珠子,前一颗珠子的尾标记一定等于后一颗珠子的头标记。因为只有这样,通过吸盘(吸盘是 Mars 人吸收能量的一种器官)的作用,这两颗珠子才能聚合成一颗珠子,同时释放出可以被吸盘吸收的能量。如果前一颗能量珠的头标记为 m,尾标记为 r,后一颗能量珠的头标记为 r,尾标记为 n,则聚合后释放的能量为 (Mars 单位),新产生的珠子的头标记为 m,尾标记为 n。
需要时,Mars 人就用吸盘夹住相邻的两颗珠子,通过聚合得到能量,直到项链上只剩下一颗珠子为止。显然,不同的聚合顺序得到的总能量是不同的,请你设计一个聚合顺序,使一串项链释
放出的总能量最大。
例如:设 N=4,4 颗珠子的头标记与尾标记依次为(2,3) (3,5) (5,10) (10,2)。我们用记号⊕表示两颗珠子的聚合操作,(j⊕k)表示第 j,k 两颗珠子聚合后所释放的能量。则第 4、1 两颗珠子聚合后释放的能量为:
(4⊕1)=10*2*3=60。
这一串项链可以得到最优值的一个聚合顺序所释放的总能量为
((4⊕1)⊕2)⊕3)=10*2*3+10*3*5+10*5*10=710。
【输入文件】
输入文件 energy.in 的第一行是一个正整数 N(4≤N≤100),表示项链上珠子的个数。第二行是 N 个用空格隔开的正整数,所有的数均不超过 1000。第 i 个数为第 i 颗珠子的头标记(1≤i≤N),当 i<N 时,第 i 颗珠子的尾标记应该等于第 i+1 颗珠子的头标记。第 N 颗珠子的尾标记应该等于第 1 颗珠子的头标记。
至于珠子的顺序,你可以这样确定:将项链放到桌面上,不要出现交叉,随意指定第一颗珠子,然后按顺时针方向确定其他珠子的顺序。
【输出文件】
输出文件 energy.out 只有一行,是一个正整数 E(E≤2.1* ),为一个最优聚合顺序所释放的总能量。
【输入样例】
4
2 3 5 10
【输出样例】
710
#include<stdio.h>
#include<string.h>
#include<algorithm>
using namespace std;
long long head[220],tail[220];
long long f[220][220];
int main()
{
int n;
scanf("%d",&n);
for(int i=1; i<=n; i++) //环转为链 变为2倍长度
{
scanf("%lld",&head[i]);
head[i+n]=head[i];
}
for(int i=1; i<=2*n-1; i++) //计算出每个珠子的尾标记
tail[i]=head[i+1];
tail[2*n]=head[1];
for(int i=1; i<=2*n-1; i++) //初始化
f[i][i]=0;
int j;
for(int t=1; t<=n-1; t++)//阶段 合并次数
{
for(int i=1; i<=2*n-t; i++)//状态 起始位置
{
j=i+t;//计算结束位置
for(int k=i; k<=j-1; k++)
f[i][j]=max(f[i][j],f[i][k]+f[k+1][j]+head[i]*tail[k]*tail[j]);
}
}
long long maxx=0;
for(int i=1; i<=n; i++)
maxx=max(maxx,f[i][i+n-1]);
printf("%lld\n",maxx);
return 0;
}
金明的预算方案
【问题描述】
金明今天很开心,家里购置的新房就要领钥匙了,新房里有一间金明自己专用的很宽敞的房间。更让他高兴的是,妈妈昨天对他说:“你的房间需要购买哪些物品,怎么布置,你说了算,只要不超过 N 元钱就行”。今天一早,金明就开始做预算了,他把想买的物品分为两类:主件与附件,附件是从属于某个主件的,下表就是一些主件与附件的例子:
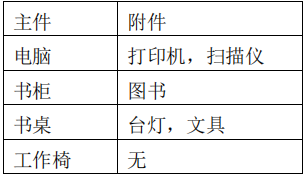
如果要买归类为附件的物品,必须先买该附件所属的主件。每个主件可以有 0 个、1 个或 2个附件。附件不再有从属于自己的附件。金明想买的东西很多,肯定会超过妈妈限定的 N 元。于是,他把每件物品规定了一个重要度,分为 5 等:用整数 1~5 表示,第 5 等最重要。他还从因特网上查到了每件物品的价格(都是 10 元的整数倍)。他希望在不超过 N 元(可以等于 N 元)的前提下,使每件物品的价格与重要度的乘积的总和最大。
设第 j 件物品的价格为 v[j],重要度为 w[j],共选中了 k 件物品,编号依次为 j1,j2,„„,jk,则所求的总和为:
v[j1]*w[j1]+v[j2]*w[j2]+ „+v[jk]*w[jk]。(其中*为乘号)
请你帮助金明设计一个满足要求的购物单。
【输入文件】
输入文件 budget.in 的第 1 行,为两个正整数,用一个空格隔开:
N m
(其中 N(<32000)表示总钱数,m(<60)为希望购买物品的个数。)
从第 2 行到第 m+1 行,第 j 行给出了编号为 j-1 的物品的基本数据,每行有 3 个非负整数v p q
(其中 v 表示该物品的价格(v<10000),p 表示该物品的重要度(1~5),q 表示该物品是主件还是附件。如果 q=0,表示该物品为主件,如果 q>0,表示该物品为附件,q 是所属主件的编号)
【输出文件】
输出文件 budget.out 只有一个正整数,为不超过总钱数的物品的价格与重要度乘积的总和的最大值(<200000)。
【输入样例】
1000 5
800 2 0
400 5 1
300 5 1
400 3 0
500 2 0
【输出样例】
2200
#include<iostream>
#include<algorithm>
using namespace std;
int n,m,f[30010];
struct node
{
int v,p;
}a[30];
bool cmp(node x,node y)
{
if(x.p!=y.p)
return x.p>y.p;
}
int main()
{
cin>>n>>m;
for(int i=1;i<=m;i++)
{
cin>>a[i].v>>a[i].p;
}
sort(a+1,a+m+1,cmp);
for(int i=1;i<=m;i++)
{
for(int j=n;j>=a[i].v;j--)
{
f[j]=max(f[j],f[j-a[i].v]+a[i].v*a[i].p);
}
}
cout<<f[n];
return 0;
}