信息学奥赛-提高级 题库
#include <cstdio>
int main() {
int x;
scanf("%d", &x);
int res = 0;
for (int i = 0; i < x; ++i) {
if (i * i % x == 1) {
++res;
}
}
printf("%d", res);
return 0;
}
输入:15
输出:_________。
输出:4
#include <cstdio>
int n, d[100];
bool v[100];
int main() {
scanf("%d", &n);
for (int i = 0; i < n; ++i) {
scanf("%d", d + i);
v[i] = false;
}
int cnt = 0;
for (int i = 0; i < n; ++i) {
if (!v[i]) {
for (int j = i; !v[j]; j = d[j]) {
v[j] = true;
}
++cnt;
}
}
printf("%d\n", cnt);
return 0;
}
输入:10 7 1 4 3 2 5 9 8 0 6
输出:_________
输出:6
#include <iostream>
using namespace std;
string s;
long long magic(int l, int r) {
long long ans = 0;
for (int i = l; i <= r; ++i) {
ans = ans * 4 + s[i] - 'a' + 1;
}
return ans;
}
int main() {
cin >> s;
int len = s.length();
int ans = 0;
for (int l1 = 0; l1 < len; ++l1) {
for (int r1 = l1; r1 < len; ++r1) {
bool bo = true;
for (int l2 = 0; l2 < len; ++l2) {
for (int r2 = l2; r2 < len; ++r2) {
if (magic(l1, r1) == magic(l2, r2) && (l1 !=
l2 || r1 != r2)) {
bo = false;
}
}
}
if (bo) {
ans += 1;
}
}
}
cout << ans << endl;
return 0;
}
输入:abacaba
输出:_________
输出:16
#include <cstdio>
using namespace std;
const int N = 110;
bool isUse[N];
int n, t;
int a[N], b[N];
bool isSmall() {
for (int i = 1; i <= n; ++i)
if (a[i] != b[i]) return a[i] < b[i];
return false;
}
bool getPermutation(int pos) {
if (pos > n) {
return isSmall();
}
for (int i = 1; i <= n; ++i) {
if (!isUse[i]) {
b[pos] = i; isUse[i] = true;
if (getPermutation(pos + 1)) {
return true;
}
isUse[i] = false;
}
}
return false;
}
void getNext() {
for (int i = 1; i <= n; ++i) {
isUse[i] = false;
}
getPermutation(1);
for (int i = 1; i <= n; ++i) {
a[i] = b[i];
}
}
int main() {
scanf("%d%d", &n, &t);
for (int i = 1; i <= n; ++i) {
scanf("%d", &a[i]);
}
for (int i = 1; i <= t; ++i) {
getNext();
}
for (int i = 1; i <= n; ++i) {
printf("%d", a[i]);
if (i == n) putchar('\n'); else putchar(' ');
}
return 0;
}
输入 1:6 10 1 6 4 5 3 2
输出 1:_________(3 分)
输入 2:6 200 1 5 3 4 2 6
输出 2:_________(5 分)
输出 1:2 1 3 5 6 4 (3 分)
输出 2:3 2 5 6 1 4 (5 分)
对于一个1到n的排列p(即1到n中每一个数在p中出现了恰好一次),令qi为第i个位置之后第一个比pi值更大的位置,如果不存在这样的位置,则qi = n +1。举例来说,如果n = 5且p为1 5 4 2 3,则q为2 6 6 5 6。
下列程序读入了排列p,使用双向链表求解了答案。试补全程序。(第二空2 分,其余 3 分)
数据范围 1 ≤ n ≤ 105。
#include <iostream>
using namespace std;
const int N = 100010;
int n;
int L[N], R[N], a[N];
int main() {
cin >> n;
for (int i = 1; i <= n; ++i) {
int x;
cin >> x;
(1) ;
}
for (int i = 1; i <= n; ++i) {
R[i] = (2) ;
L[i] = i - 1;
}
for (int i = 1; i <= n; ++i) {
L[ (3) ] = L[a[i]];
R[L[a[i]]] = R[ (4) ];
}
for (int i = 1; i <= n; ++i) {
cout << (5) << " ";
}
cout << endl;
return 0;
}
(1)a[x] = i
(2)i+1
(3)R[a[i]]
(4)a[i]
(5)R[i]
一只小猪要买 N 件物品(N 不超过 1000)。
它要买的所有物品在两家商店里都有卖。第 i 件物品在第一家商店的价格是a[i],在第二家商店的价格是 b[i],两个价格都不小于 0 且不超过 10000。如果在第一家商店买的物品的总额不少于 50000,那么在第一家店买的物品都可以打 95 折(价格变为原来的 0.95 倍)。
求小猪买齐所有物品所需最少的总额。
输入:第一行一个数 N。接下来 N 行,每行两个数。第 i 行的两个数分别代表 a[i],b[i]。
输出:输出一行一个数,表示最少需要的总额,保留两位小数。
试补全程序。(第一空 2 分,其余 3 分)
#include <cstdio>
#include <algorithm>
using namespace std;
const int Inf = 1000000000;
const int threshold = 50000;
const int maxn = 1000;
int n, a[maxn], b[maxn];
bool put_a[maxn];
int total_a, total_b;
double ans;
int f[threshold];
int main() {
scanf("%d", &n);
total_a = total_b = 0;
for (int i = 0; i < n; ++i) {
scanf("%d%d", a + i, b + i);
if (a[i] <= b[i]) total_a += a[i];
else total_b += b[i];
}
ans = total_a + total_b;
total_a = total_b = 0;
for (int i = 0; i < n; ++i) {
if ( (1) ) {
put_a[i] = true;
total_a += a[i];
} else {
put_a[i] = false;
total_b += b[i];
}
}
if ( (2) ) {
printf("%.2f", total_a * 0.95 + total_b);
return 0;
}
f[0] = 0;
for (int i = 1; i < threshold; ++i)
f[i] = Inf;
int total_b_prefix = 0;
for (int i = 0; i < n; ++i)
if (!put_a[i]) {
total_b_prefix += b[i];
for (int j = threshold - 1; j >= 0; --j) {
if ( (3) >= threshold && f[j] != Inf)
ans = min(ans, (total_a + j + a[i]) * 0.95
+ (4) );
f[j] = min(f[j] + b[i], j >= a[i] ? (5) : Inf);
}
}
printf("%.2f", ans);
return 0;
}
(1)a[i] * 0.95 <= b[i]或 b[i] >= a[i] * 0.95
(2)total_a >= threshold或 threshold <= total_a 或 total_a >= 50000 或 50000 <= total_a
(3)total_a + j + a[i]
(4)f[j] + total_b - total_b_prefix
(5)f[j - a[i]]
奶酪
【问题描述】
现有一块大奶酪,它的高度为 h,它的长度和宽度我们可以认为是无限大的,奶酪中间有许多半径相同的球形空洞。我们可以在这块奶酪中建立空间坐标系,在坐标系中,奶酪的下表面为z = 0,奶酪的上表面为z = h。
现在,奶酪的下表面有一只小老鼠 Jerry,它知道奶酪中所有空洞的球心所在的坐标。如果两个空洞相切或是相交,则 Jerry 可以从其中一个空洞跑到另一个空洞,特别地,如果一个空洞与下表面相切或是相交,Jerry 则可以从奶酪下表面跑进空洞;如果一个空洞与上表面相切或是相交,Jerry 则可以从空洞跑到奶酪上表面。
位于奶酪下表面的 Jerry 想知道,在不破坏奶酪的情况下,能否利用已有的空洞跑到奶酪的上表面去?
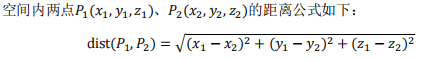
【输入格式】
输入文件名为 cheese.in。
每个输入文件包含多组数据。
输入文件的第一行,包含一个正整数 T,代表该输入文件中所含的数据组数。
接下来是 T 组数据,每组数据的格式如下:
第一行包含三个正整数 n,h 和 r,两个数之间以一个空格分开,分别代表奶酪中空洞的数量,奶酪的高度和空洞的半径。
接下来的 n 行,每行包含三个整数 x、y、z,两个数之间以一个空格分开,表示空洞球心坐标为(x, y, z)。
【输出格式】
输出文件名为 cheese.out。
输出文件包含 T 行,分别对应 T 组数据的答案,如果在第 i 组数据中,Jerry 能从下
表面跑到上表面,则输出“Yes”,如果不能,则输出“No”(均不包含引号)。
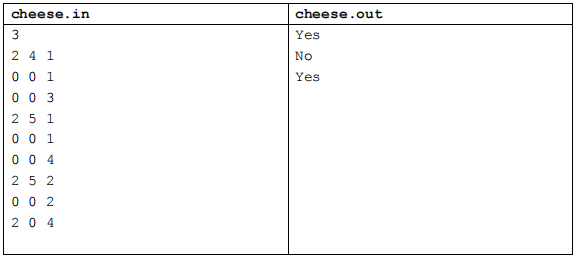
【输入输出样例 1】
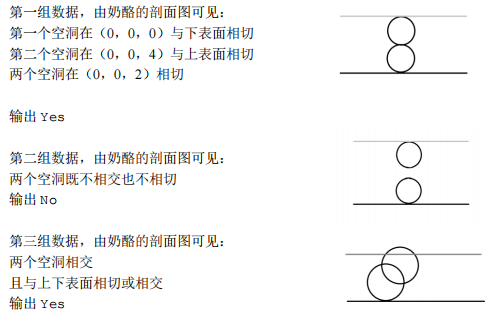
【输入输出样例 1 说明】
【数据规模与约定】
对于 20%的数据,n = 1,1 ≤ h , r ≤ 10,000,坐标的绝对值不超过 10,000。
对于 40%的数据,1 ≤ n ≤ 8, 1 ≤ h , r ≤ 10,000,坐标的绝对值不超过 10,000。
对于 80%的数据,1 ≤ n ≤ 1,000,1 ≤ h , r ≤ 10,000,坐标的绝对值不超过 10,000。
对于 100%的数据,1 ≤ n ≤ 1,000,1 ≤ h , r ≤ 1,000,000,000,T ≤ 20,坐标的绝对值不超过 1,000,000,000。
#include<bits/stdc++.h>
#define rg register int
using namespace std;
long long T, n, h, r, x[1005], y[1005], z[1005], f[1005][1005], bz[1005], ans;
int dist(int i, int j) {
double s = sqrt((x[i] - x[j]) * 1.0 * (x[i] -x [j])*1.0 + (y[i] - y[j]) * 1.0 * (y[i] - y[j])*1.0 + (z[i] - z[j]) * 1.0 * (z[i] -z [j]) * 1.0) * 1.0;
if (s > (int)s) s++;
return s;
}
void dfs(int x) {
if (x == n + 1) {
ans = 1;
return;
}
bz[x] = 1;
for (rg i = 1; i <= n + 1; i++)
if (f[x][i] && (!bz[i])) {
dfs(i);
if (ans == 1)
return;
}
}
int main() {
scanf("%lld", &T);
while (T--) {
scanf("%lld%lld%lld", &n, &h, &r), ans = 0;
for (rg i = 1; i <= n; i++)
scanf("%lld%lld%lld", &x[i], &y[i], &z[i]);
for (rg i = 0; i <= n; i++)
for(rg j = i + 1; j <= n+1; j++)
f[i][j] = f[j][i] = 0;
for (rg i = 1; i <= n; i++)
for (rg j = i + 1; j <= n; j++)
if (dist(i,j) <= r * 2) f[i][j] = f[j][i] = 1;
for (rg i = 1; i <= n; i++) {
bz[i] = 0;
if (h - z[i] <= r) f[i][n + 1] = f[n + 1][i] = 1;
if (z[i] <= r) f[i][0] = f[0][i] = 1;
}
dfs(0);
if (ans) printf("Yes\n");
else printf("No\n");
}
return 0;
}
宝藏
【问题描述】
参与考古挖掘的小明得到了一份藏宝图,藏宝图上标出了 n 个深埋在地下的宝藏屋,也给出了这 n 个宝藏屋之间可供开发的 m 条道路和它们的长度。
小明决心亲自前往挖掘所有宝藏屋中的宝藏。但是,每个宝藏屋距离地面都很远,也就是说,从地面打通一条到某个宝藏屋的道路是很困难的,而开发宝藏屋之间的道路则相对容易很多。
小明的决心感动了考古挖掘的赞助商,赞助商决定免费赞助他打通一条从地面到某个宝藏屋的通道,通往哪个宝藏屋则由小明来决定。
在此基础上,小明还需要考虑如何开凿宝藏屋之间的道路。已经开凿出的道路可以任意通行不消耗代价。每开凿出一条新道路,小明就会与考古队一起挖掘出由该条道路所能到达的宝藏屋的宝藏。另外,小明不想开发无用道路,即两个已经被挖掘过的宝藏屋之间的道路无需再开发。
新开发一条道路的代价是:
这条道路的长度 × 从赞助商帮你打通的宝藏屋到这条道路起点的宝藏屋所经过的宝藏屋的数量(包括赞助商帮你打通的宝藏屋和这条道路起点的宝藏屋)。
请你编写程序为小明选定由赞助商打通的宝藏屋和之后开凿的道路,使得工程总代价最小,并输出这个最小值。
【输入格式】
输入文件名为 treasure.in。
第一行两个用空格分离的正整数 n 和 m,代表宝藏屋的个数和道路数。
接下来 m 行,每行三个用空格分离的正整数,分别是由一条道路连接的两个宝藏屋的编号(编号为 1~n),和这条道路的长度 v。
【输出格式】
输出文件名为 treasure.out。
输出共一行,一个正整数,表示最小的总代价。
【输入输出样例 1】
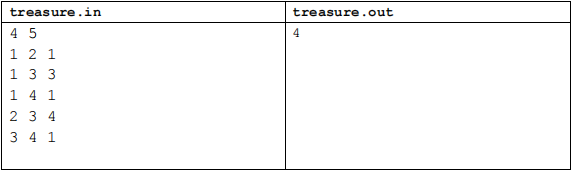
【输入输出样例 1 说明】
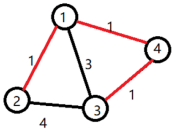
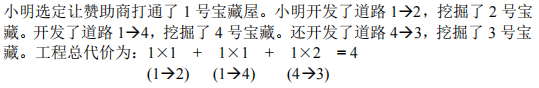
【样例输入输出 2】
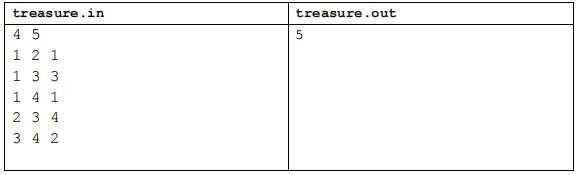
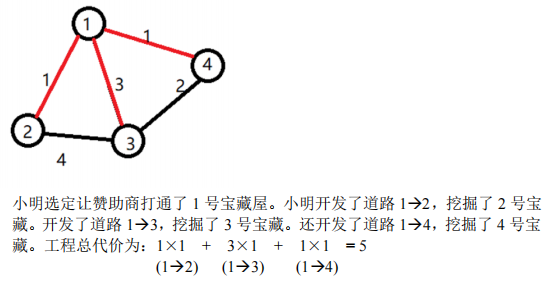
【输入输出样例 2 说明】
【数据规模与约定】
对于 20%的数据:
保证输入是一棵树,1≤n≤8,v≤5000 且所有的 v 都相等。
对于 40%的数据:
1≤n≤8,0≤m≤1000,v≤5000 且所有的 v 都相等。
对于 70%的数据:
1≤n≤8,0≤m≤1000,v≤ 5000
对于 100%的数据:
1≤n≤12,0≤m≤1000,v≤ 500000
#include<bits/stdc++.h>
using namespace std;
typedef long long ll;
int n,m,tot,ans;
int mapp[110][110],dis[110][110],Log[4100];
int f[15][4100],g[4100],ref[4100],v[15],p[15];
int main(){
//freopen("treasure.in","r",stdin);
//freopen("treasure.out","w",stdout);
scanf("%d%d",&n,&m);
register int i,j,a,b,c,x;
for(i=0;i<n;i++) for(j=0;j<n;j++) mapp[i][j]=60000000;
for(i=1;i<=m;i++){
scanf("%d%d%d",&a,&b,&c),a--,b--;
mapp[a][b]=mapp[b][a]=min(mapp[a][b],c);
}//建图
for(i=0;i<n;i++) Log[1<<i]=i;
memset(f,0x3f,sizeof(f));
for(i=0;i<n;i++) f[0][1<<i]=0;
for(i=0;i<n;i++) //开始DP
for(x=0;x<(1<<n);x++){
tot=0;
for(a=0;a<n;a++)
if(!(x&(1<<a))){
v[tot]=60000000,p[tot]=1<<a;
for(j=x;j;j-=j&-j){
b=Log[j&-j];
v[tot]=min(v[tot],mapp[a][b]*(i+1));//计算代价
}
tot++;
}
for(j=1;j<(1<<tot);j++){
g[j]=g[j-(j&-j)]+v[Log[j&-j]];//每个点与x中的某个点连通所需要的最小代价。
ref[j]=ref[j-(j&-j)]|p[Log[j&-j]];//枚举子集
f[i+1][x|ref[j]]=min(f[i+1][x|ref[j]],f[i][x]+g[j]);
}
}
ans=1<<30;
for(i=0;i<=n;i++) ans=min(ans,f[i][(1<<n)-1]);//最优状态从走到每一个点但最深深度不同的状态中取
printf("%d",ans);
return 0;
}
列队
【问题描述】
Sylvia 是一个热爱学习的女孩子。
前段时间,Sylvia 参加了学校的军训。众所周知,军训的时候需要站方阵。Sylvia所在的方阵中有n × m名学生,方阵的行数为 n,列数为 m。
为了便于管理,教官在训练开始时,按照从前到后,从左到右的顺序给方阵中的学生从 1 到 n × m 编上了号码(参见后面的样例)。
即:初始时,第 i 行第 j 列的学生的编号是(i − 1) × m + j。
然而在练习方阵的时候,经常会有学生因为各种各样的事情需要离队。在一天中,一共发生了 q 件这样的离队事件。每一次离队事件可以用数对(x, y) (1≤x≤n, 1≤y≤m)描述,表示第 x 行第 y 列的学生离队。
在有学生离队后,队伍中出现了一个空位。为了队伍的整齐,教官会依次下达这样的两条指令:
1. 向左看齐。这时第一列保持不动,所有学生向左填补空缺。不难发现在这条指令之后,空位在第 x 行第 m 列。
2. 向前看齐。这时第一行保持不动,所有学生向前填补空缺。不难发现在这条指令之后,空位在第 n 行第 m 列。
教官规定不能有两个或更多学生同时离队。即在前一个离队的学生归队之后,下一个学生才能离队。因此在每一个离队的学生要归队时,队伍中有且仅有第 n 行第 m 列一个空位,这时这个学生会自然地填补到这个位置。
因为站方阵真的很无聊,所以 Sylvia 想要计算每一次离队事件中,离队的同学的编号是多少。
注意:每一个同学的编号不会随着离队事件的发生而改变,在发生离队事件后方阵中同学的编号可能是乱序的。
【输入格式】
输入文件名为 phalanx.in。
输入共 q+1 行。
第 1 行包含 3 个用空格分隔的正整数 n, m, q,表示方阵大小是 n 行 m 列,一共发生了 q 次事件。
接下来 q 行按照事件发生顺序描述了 q 件事件。每一行是两个整数 x, y,用一个空格分隔,表示这个离队事件中离队的学生当时排在第 x 行第 y 列。
【输出格式】
输出文件名为 phalanx.out。
按照事件输入的顺序,每一个事件输出一行一个整数,表示这个离队事件中离队学生的编号。
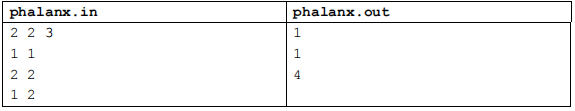
【输入输出样例 1】
【输入输出样例 1 说明】
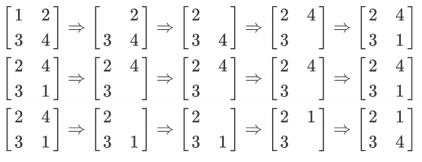
列队的过程如上图所示,每一行描述了一个事件。
在第一个事件中,编号为 1 的同学离队,这时空位在第一行第一列。接着所有同学向左标齐,这时编号为 2 的同学向左移动一步,空位移动到第一行第二列。然后所有同学向上标齐,这时编号为 4 的同学向上一步,这时空位移动到第二行第二列。最后编号为 1 的同学返回填补到空位中。
【数据规模与约定】
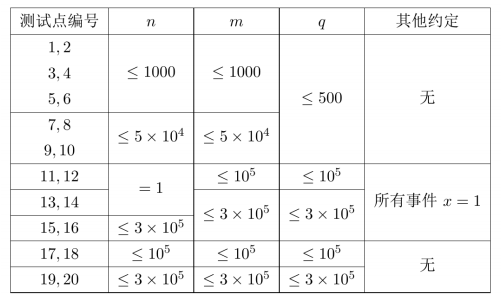
数据保证每一个事件满足 1≤x≤n,1≤y≤m。
#pragma GCC optimize(3)
#include <bits/stdc++.h>
#define ll long long
using namespace std;
const int Max=300005;
int n,m,q,sum,tot;
int tree[Max*20],lc[Max*20],rc[Max*20],rt[Max];
vector<ll>num[Max];
inline int get_int()
{
int x=0;char c;
for(c=getchar();!isdigit(c);c=getchar());
for(;isdigit(c);c=getchar()) x=(x<<3)+(x<<1)+(c^48);
return x;
}
inline void print(ll x)
{
if(x>9) print(x/10);
putchar('0'+x%10);
}
inline void add(int &now,int l,int r,int pos)
{
if(!now) now=++tot;tree[now]++;
if(l==r) return;
int mid=(l+r)>>1;
if(pos<=mid) add(lc[now],l,mid,pos);
else add(rc[now],mid+1,r,pos);
}
inline int Q(int root,int l,int r,int k)
{
if(l==r) return l;
int mid=(l+r)>>1,sum=(mid-l+1)-tree[lc[root]];
if(sum>=k) Q(lc[root],l,mid,k);
else Q(rc[root],mid+1,r,k-sum);
}
inline ll Qr(int x,ll v)
{
int pos=Q(rt[n+1],1,sum,x);add(rt[n+1],1,sum,pos);
ll ans=pos<=n?(ll)m*pos:num[n+1][pos-n-1];
return num[n+1].push_back(v?v:ans),ans;
}
inline ll Ql(int x,int y)
{
int pos=Q(rt[x],1,sum,y);add(rt[x],1,sum,pos);
ll ans=pos<m?(ll)(x-1)*m+pos:num[x][pos-m];
return num[x].push_back(Qr(x,ans)),ans;
}
int main()
{
n=get_int(),m=get_int(),q=get_int(),sum=max(n,m)+q;
while(q--)
{
int x=get_int(),y=get_int();
if(y==m) print(Qr(x,0)),putchar('\n');
else print(Ql(x,y)),putchar('\n');
}
return 0;
}
小凯的疑惑
【问题描述】
小凯手中有两种面值的金币,两种面值均为正整数且彼此互素。每种金币小凯都有无数个。在不找零的情况下,仅凭这两种金币,有些物品他是无法准确支付的。现在小凯想知道在无法准确支付的物品中,最贵的价值是多少金币?注意:输入数据保证存在小凯无法准确支付的商品。
【输入格式】
输入文件名为 math.in。
输入数据仅一行,包含两个正整数 a 和 b,它们之间用一个空格隔开,表示小凯手中金币的面值。
【输出格式】
输出文件名为 math.out。
输出文件仅一行,一个正整数 N,表示不找零的情况下,小凯用手中的金币不能准确支付的最贵的物品的价值。
【输入输出样例 1】
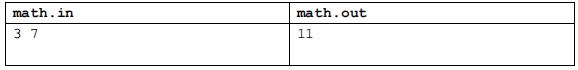
【输入输出样例 1 说明】
小凯手中有面值为3和 7的金币无数个,在不找零的前提下无法准确支付价值为 1、2、4、5、8、11 的物品,其中最贵的物品价值为 11,比 11 贵的物品都能买到,比如:
12 = 3 * 4 + 7 * 0
13 = 3 * 2 + 7 * 1
14 = 3 * 0 + 7 * 2
15 = 3 * 5 + 7 * 0
……
【数据规模与约定】
对于 30%的数据: 1 ≤ a,b ≤ 50。
对于 60%的数据: 1 ≤ a,b ≤ 10,000。
对于 100%的数据:1 ≤ a,b ≤ 1,000,000,000。
//#include<bits/stdc++.h>
#include<iostream>
#include<cstdio>
using namespace std;
int main(){
long long a,b;
scanf("%lld %lld",&a,&b);
printf("%lld",a*b-a-b);
return 0;
}
时间复杂度
【问题描述】
小明正在学习一种新的编程语言 A++,刚学会循环语句的他激动地写了好多程序并给出了他自己算出的时间复杂度,可他的编程老师实在不想一个一个检查小明的程序,于是你的机会来啦!下面请你编写程序来判断小明对他的每个程序给出的时间复杂度是否正确。
A++语言的循环结构如下:
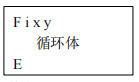
其中“F i x y”表示新建变量 (i 变量 i 不可与未被销毁的变量重名)并初始化为 x,然后判断 i 和 y 的大小关系,若 i 小于等于 y 则进入循环,否则不进入。每次循环结束后 i 都会被修改成 i +1,一旦 i 大于 y 终止循环。
x 和 y 可以是正整数(x 和 y 的大小关系不定)或变量 n。n 是一个表示数据规模的变量,在时间复杂度计算中需保留该变量而不能将其视为常数,该数远大于 100。
“E”表示循环体结束。循环体结束时,这个循环体新建的变量也被销毁。
注:本题中为了书写方便,在描述复杂度时,使用大写英文字母“O”表示通常意义下“Θ”的概念。
【输入格式】
输入文件名为 complexity.in。
输入文件第一行一个正整数 t,表示有 t(t ≤ 10)个程序需要计算时间复杂度。
每个程序我们只需抽取其中 “F i x y”和“E”即可计算时间复杂度。注意:循环结构允许嵌套。
接下来每个程序的第一行包含一个正整数 L 和一个字符串,L 代表程序行数,字符串表示这个程序的复杂度,“O(1)”表示常数复杂度,“O(n^w)”表示复杂度为n^w,其中w是一个小于100的正整数(输入中不包含引号),输入保证复杂度只有O(1)和O(n^w)两种类型。
接下来 L 行代表程序中循环结构中的“F i x y”或者 “E”。
程序行若以“F”开头,表示进入一个循环,之后有空格分离的三个字符(串)i x y,其中 i 是一个小写字母(保证不为“n”),表示新建的变量名,x 和 y 可能是正整数或n ,已知若为正整数则一定小于 100。
程序行若以“E”开头,则表示循环体结束。
【输出格式】
输出文件名为 complexity.out。
输出文件共 t 行,对应输入的 t 个程序,每行输出“Yes”或“No”或者“ERR”(输出中不包含引号),若程序实际复杂度与输入给出的复杂度一致则输出“Yes”,不一致则输出“No”,若程序有语法错误(其中语法错误只有: ① F 和 E 不匹配 ②新建的变量与已经存在但未被销毁的变量重复两种情况),则输出“ERR”。
注意:即使在程序不会执行的循环体中出现了语法错误也会编译错误,要输出“ERR”。
【输入输出样例 1】
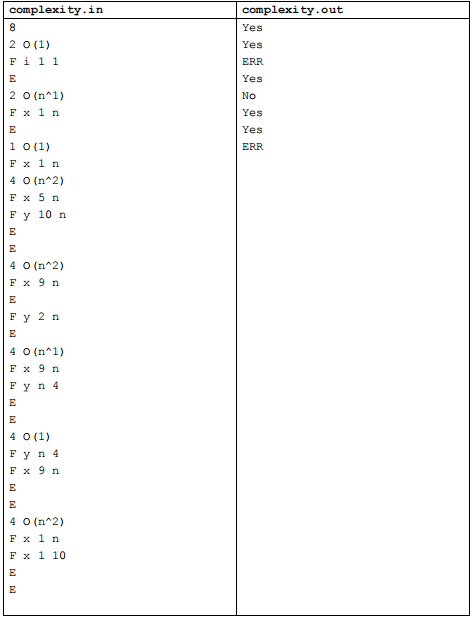
【输入输出样例 1 说明】
第一个程序 i 从 1 到 1 是常数复杂度。
第二个程序 x 从 1 到 n 是 n 的一次方的复杂度。
第三个程序有一个 F 开启循环却没有 E 结束,语法错误。
第四个程序二重循环,n 的平方的复杂度。
第五个程序两个一重循环,n 的一次方的复杂度。
第六个程序第一重循环正常,但第二重循环开始即终止(因为n远大于100,100大于4)。
第七个程序第一重循环无法进入,故为常数复杂度。
第八个程序第二重循环中的变量 x 与第一重循环中的变量重复,出现语法错误②,输出ERR。
【数据规模与约定】
对于 30%的数据:不存在语法错误,数据保证小明给出的每个程序的前 L/2 行一定为以 F 开头的语句,第 L/2+1 行至第 L 行一定为以 E 开头的语句,L<=10,若 x、y 均为整数,x 一定小于 y,且只有 y 有可能为 n。
对于 50%的数据:不存在语法错误,L<=100,且若 x、y 均为整数,x 一定小于 y,且只有 y 有可能为 n。
对于 70%的数据:不存在语法错误,L<=100。
对于 100%的数据:L<=100。
#include<bits/stdc++.h>
#define gc getchar()
using namespace std;
int T,n,k,o,bz[6000],aa[6000],maxn,p,l,t[6000],tt,pp[6000],ttt,tttt;
//o表示层数,t表示是否进入此循环,p表示是n的几次方
char a;
int main()
{
scanf("%d",&T);
while(T--)
{
p=tt=ttt=tttt=l=k=o=maxn=a=0;
memset(bz,0,sizeof(bz)),memset(t,0,sizeof(t));
memset(aa,0,sizeof(aa)),memset(pp,0,sizeof(pp));
scanf("%d",&n);
while(a!='(') a=gc;
a=gc;
if(a=='1') k=0;
else
{
a=gc;
scanf("%d",&k);
}
for(int i=1;i<=n;i++)
{
if(tt==0&&o<100) maxn=max(p,maxn);
while(a!='F'&&a!='E') a=gc;
if(a=='F')
{
o++;
while(a>'z'||a<'a') a=gc;
if(bz[a-'a']) o=999;
if(o<100)
bz[a-'a']=1,aa[o]=a;
gc,a=gc;
if(a=='n')
{
a=gc,a=gc;
if(a!='n')
{
l=0;
while(a<='9'&&a>='0') l=l*10+a-'0',a=gc;
if(l<=100) maxn=max(p,maxn),tt++,t[o]=1;
}
}
else
{
ttt=tttt=0;
while(a!=' ') ttt=ttt*10+a-'0',a=gc;
a=gc;
if(a=='n')
{
p++,pp[o]=1;
if(tt==0) maxn=max(p,maxn);
}
else
{
while(a<='9'&&a>='0') tttt=tttt*10+a-'0',a=gc;
if(ttt>tttt) tt++,t[o]=1;
}
}
a=gc;
}
else
{
if(o<=0)
{
o=999;
}
if(o<100)
{
bz[aa[o]-'a']=0,tt-=t[o],t[o]=0;
p-=pp[o],pp[o]=0,o--;
}
a=gc;
}
}
if(o==0)
{
if(maxn==k) printf("Yes\n");
else printf("No\n");
}
else printf("ERR\n");
}
return 0;
}
逛公园
【问题描述】
策策同学特别喜欢逛公园。公园可以看成一张N个点M条边构成的有向图,且没有自环和重边。其中1号点是公园的入口,N号点是公园的出口,每条边有一个非负权值,代表策策经过这条边所要花的时间。
策策每天都会去逛公园,他总是从1号点进去,从N号点出来。
策策喜欢新鲜的事物,他不希望有两天逛公园的路线完全一样,同时策策还是一个特别热爱学习的好孩子,他不希望每天在逛公园这件事上花费太多的时间。如果1号点到N号点的最短路长为d,那么策策只会喜欢长度不超过d+ K的路线。
策策同学想知道总共有多少条满足条件的路线,你能帮帮他吗?
为避免输出过大,答案对P取模。
如果有无穷多条合法的路线,请输出−1。
【输入格式】
输入文件名为 park.in。
第一行包含一个整数 T, 代表数据组数。
接下来M行,每行三个整数ai, bi, ci,代表编号为ai, bi的点之间有一条权值为 ci的有向边,每两个整数之间用一个空格隔开。
【输出格式】
输出文件名为 park.out。
输出文件包含 T行,每行一个整数代表答案。
【输入输出样例 1】
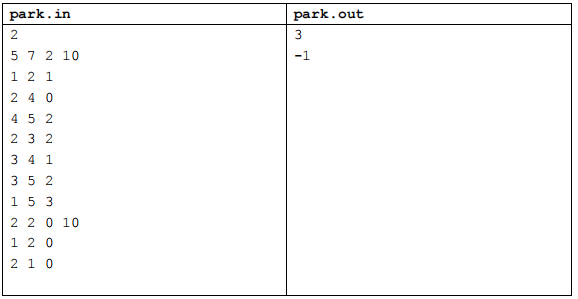
对于第一组数据,最短路为 3。
1 – 5, 1 – 2 – 4 – 5, 1 – 2 – 3 – 5 为 3 条合法路径。
【数据规模与约定】
对于不同的测试点,我们约定各种参数的规模不会超过如下
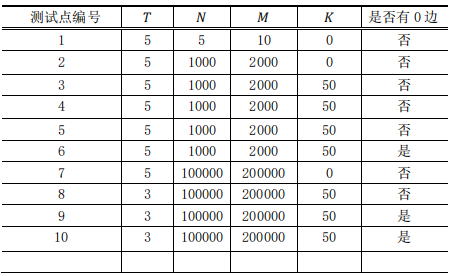
对于 100%的数据, 1 ≤ p ≤ 10^9,1 ≤ ai, bi ≤ N , 0 ≤ ci ≤ 1000。
数据保证:至少存在一条合法的路线。
#include <bits/stdc++.h>
using namespace std;
const int Maxn=100010;
const int Maxm=200010;
int t,n,m,size,k,mod,ans,minn,flag;
int dis[Maxn],First[Maxn],first[Maxn],f[Maxn][55],vis[Maxn][55];
struct shu{int to,next,len;};
shu Edge[Maxm],edge[Maxm];
priority_queue<pair<int,int> >q;
inline int get_int()
{
int x=0,f=1;
char c;
for(c=getchar();(!isdigit(c))&&(c!='-');c=getchar());
if(c=='-') {f=-1;c=getchar();}
for(;isdigit(c);c=getchar()) x=(x<<3)+(x<<1)+c-'0';
return x*f;
}
inline void clean()
{
size=ans=flag=0;
memset(dis,0x3f3f3f,sizeof(dis));
memset(First,0,sizeof(First));
memset(first,0,sizeof(first));
memset(f,-1,sizeof(f));
memset(vis,0,sizeof(vis));
}
inline void build(int x,int y,int z)
{
Edge[++size].next=First[x];
First[x]=size;
Edge[size].to=y,Edge[size].len=z;
edge[size].next=first[y];
first[y]=size;
edge[size].to=x,edge[size].len=z;
}
inline void dijkstra()
{
q.push(make_pair(0,1)),dis[1]=0;
while(!q.empty())
{
int point=q.top().second;
q.pop();
for(int u=First[point];u;u=Edge[u].next)
{
int to=Edge[u].to;
if(dis[to] > dis[point] + Edge[u].len)
{
dis[to]=dis[point] + Edge[u].len;
q.push(make_pair(-dis[to],to));
}
}
}
}
inline int dfs(int point,int k)
{
if(~f[point][k]) return f[point][k];
f[point][k]=0,vis[point][k]=1;
for(register int u=first[point];u;u=edge[u].next)
{
int to=edge[u].to,num=dis[point]-dis[to]+k-edge[u].len;
if(num<0) continue;
if(vis[to][num]) flag=1;
f[point][k]=(f[point][k]+dfs(to,num))%mod;
}
vis[point][k]=0;
return f[point][k];
}
int main()
{
t=get_int();
while(t--)
{
clean();
n=get_int(),m=get_int(),k=get_int(),mod=get_int();
for(int i=1;i<=m;i++)
{
int x=get_int(),y=get_int(),z=get_int();
build(x,y,z);
}
dijkstra();
if(!dis[n]) {cout<<"-1\n";continue;}
f[1][0]=1;
for(int i=0;i<=k;i++) ans=(ans+dfs(n,i))%mod;
if(!flag) cout<<ans<<"\n";
else cout<<"-1\n";
}
return 0;
}
神奇的幻方
【问题描述】
幻方是一种很神奇的 N * N 矩阵:它由数字 1,2,3, … … , N * N 构成,且每行、每列及两条对角线上的数字之和都相同。
当 N 为奇数时,我们可以通过以下方法构建一个幻方:
首先将 1 写在第一行的中间。
之后,按如下方式从小到大依次填写每个数 K(K = 2,3, … , N * N) :
1. 若 (K − 1) 在第一行但不在最后一列,则将 K 填在最后一行, (K − 1) 所在列的右一列;
2. 若 (K − 1) 在最后一列但不在第一行,则将 K 填在第一列,(K − 1) 所在行的上一行;
3. 若 (K − 1) 在第一行最后一列,则将 K 填在 (K − 1) 的正下方;
4. 若 (K − 1) 既不在第一行,也不在最后一列,如果 (K − 1) 的右上方还未填数,
则将 K 填在(K − 1)的右上方,否则将 K 填在 (K − 1) 的正下方。现给定 N,请按上述方法构造 N * N 的幻方。
【输入格式】
输入文件名为 magic.in。
输入文件只有一行,包含一个整数 N,即幻方的大小。
【输出格式】
输出文件名为 magic.out。
输出文件包含 N 行,每行 N 个整数,即按上述方法构造出的 N * N 的幻方。相邻两个整数之间用单个空格隔开。
【输入输出样例 1】
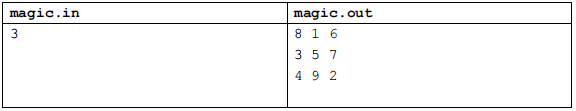
【数据规模与约定】
对于 100% 的数据,1 ≤ N ≤ 39 且 N 为奇数。
#include <iostream>
using namespace std;
const int N = 40;
int n;
int a[N][N];
int main() {
cin >> n;
int x = 1, y = n / 2 + 1;
for (int i = 1; i <= n * n; i++) {
a[x][y] = i;
if (x == 1 && y == n) x++;
else if (x == 1) x = n, y++;
else if (y == n) x--, y = 1;
else if (a[x - 1][y + 1]) x++;
else x--, y++;
}
for (int i = 1; i <= n; i++) {
for (int j = 1; j <= n; j++)printf("%d", a[i][j]);
puts("");
}
return 0;
}
信息传递
【问题描述】
有 n 个同学(编号为 1 到 n)正在玩一个信息传递的游戏。在游戏里每人都有一个固定的信息传递对象,其中,编号为 i 的同学的信息传递对象是编号为Ti的同学。
游戏开始时,每人都只知道自己的生日。之后每一轮中,所有人会同时将自己当前所知的生日信息告诉各自的信息传递对象(注意:可能有人可以从若干人那里获取信息,但是每人只会把信息告诉一个人,即自己的信息传递对象)。当有人从别人口中得知自己的生日时,游戏结束。请问该游戏一共可以进行几轮?
【输入格式】
输入文件名为 message.in。
输入共 2 行。
第 1 行包含 1 个正整数 n,表示 n 个人。
第 2 行包含 n 个用空格隔开的正整数 T1, T2, … … , Tn,其中第i 个整数Ti表示编号为 i
的同学的信息传递对象是编号为 Ti 的同学, Ti ≤ n 且 Ti ≠ i。
数据保证游戏一定会结束。
【输出格式】
输出文件名为 message.out。
输出共 1 行,包含 1 个整数,表示游戏一共可以进行多少轮。
【输入输出样例 1】
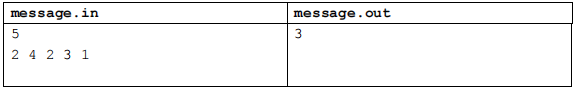
【输入输出样例 1 说明】
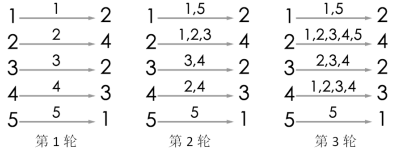
游戏的流程如图所示。当进行完第 3 轮游戏后,4 号玩家会听到 2 号玩家告诉他自己的生日,所以答案为 3。当然,第 3 轮游戏后,2 号玩家、3 号玩家都能从自己的消息来源得知自己的生日,同样符合游戏结束的条件。
【数据规模与约定】
对于 30%的数据,n ≤ 200;
对于 60%的数据,n ≤ 2500;
对于 100%的数据,n ≤ 200000。
#include <bits/stdc++.h>
using namespace std;
const int maxn=200010;
int n, fa[maxn],ans=0x3f3f3f3f;
int get(int x, int &cnt){
cnt++;
if(fa[x]==x)return x;
else return get(fa[x], cnt);
}
int main () {
cin>>n;
for(int i=1;i<=n;i++)
fa[i]=i;
for(int i=1;i<=n;i++) {
int cnt=0,f;
cin>>f;
if(get(f,cnt)==i){
ans=min(ans,cnt);
}else{
fa[i]=f;
}
}
cout<<ans;
return 0;
}
斗地主
【问题描述】
牛牛最近迷上了一种叫斗地主的扑克游戏。斗地主是一种使用黑桃、红心、梅花、方片的 A 到 K 加上大小王的共 54 张牌来进行的扑克牌游戏。在斗地主中,牌的大小关系根据牌的数码表示如下:3<4<5<6<7<8<9<10<J<Q<K<A<2<小王<大王,而花色并不对牌的大小产生影响。每一局游戏中,一副手牌由 n 张牌组成。游戏者每次可以根据规定的牌型进行出牌,首先打光自己的手牌一方取得游戏的胜利。
现在,牛牛只想知道,对于自己的若干组手牌,分别最少需要多少次出牌可以将它们打光。请你帮他解决这个问题。
需要注意的是,本题中游戏者每次可以出手的牌型与一般的斗地主相似而略有不同。
具体规则如下:
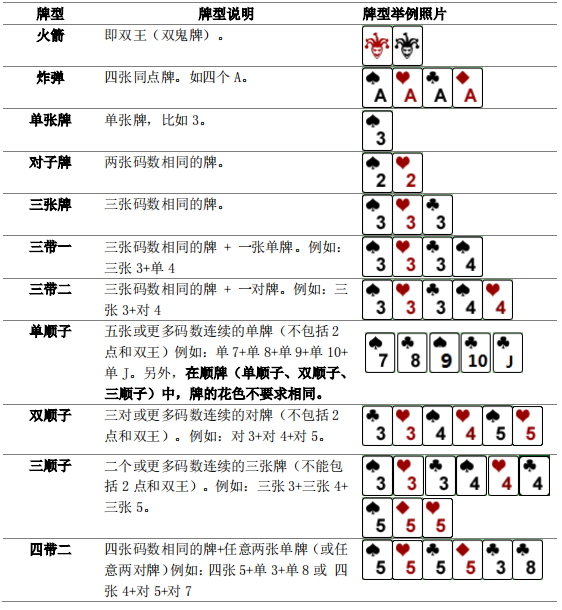
【输入格式】
输入文件名为 landlords.in。
第一行包含用空格隔开的 2 个正整数 T, n ,表示手牌的组数以及每组手牌的张数。
接下来 T 组数据,每组数据 n 行,每行一个非负整数对 ai, bi,表示一张牌,其中 ai表示牌的数码,bi 表示牌的花色,中间用空格隔开。特别的,我们用 1 来表示数码 A,11 表示数码 J,12 表示数码 Q,13 表示数码 K;黑桃、红心、梅花、方片分别用 1-4 来表示;小王的表示方法为 0 1,大王的表示方法为 0 2。
【输出格式】
输出文件名为 landlords.out。
共 T 行,每行一个整数,表示打光第i组手牌的最少次数。
【输入输出样例 1】
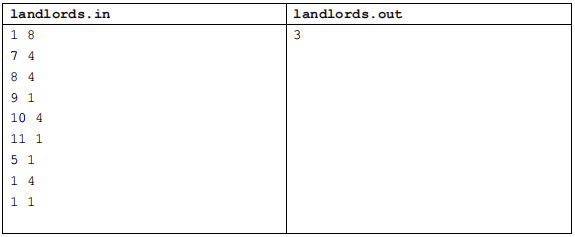
【输入输出样例 1 说明】
共有 1 组手牌,包含 8 张牌:方片 7,方片 8,黑桃 9,方片 10,黑桃 J,黑桃 5,方片 A 以及黑桃 A。可以通过打单顺子(方片 7,方片 8,黑桃 9,方片 10,黑桃 J),单张牌(黑桃 5)以及对子牌(黑桃 A 以及方片 A)在 3 次内打光。
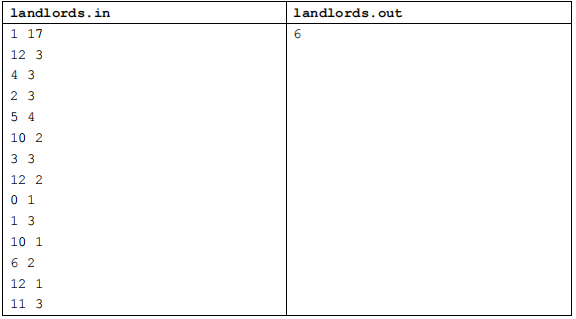
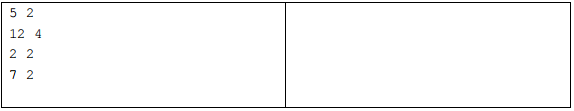
【输入输出样例 2】
【数据规模与约定】
对于不同的测试点,我们约定手牌组数 T 与张数 n 的规模如下:
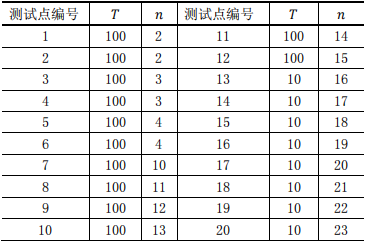
数据保证:所有的手牌都是随机生成的。
#include<iostream>
#include<cstdio>
#include<cstring>
using namespace std;
int T, n, ans, s[15];
void dfs(int shunzi) {
if (shunzi > ans) return ;//最优化剪枝
int i, j, s1 = 0, s2 = 0, s3 = 0, s4 = 0;
//非顺子
for (i = 1; i <= 14; i++)//单牌需出的次数
if (s[i] == 1) s1++;
for (i = 1; i <= 14; i++)//对牌需出的次数
if (s[i] == 2) s2++;
for (i = 1; i <= 14; i++) {//三带
if (s[i] == 3) {
s3++;
if (s1 >= 1) s1--;
else if (s2 >= 1) s2--;
}
}
for (i = 1; i <= 14; i++) {//四带
if (s[i] == 4) {
s4++;
if (s1 >= 2) s1 -= 2;
else {
if (s2 >= 2) s2 -= 2;
else if (s2 >= 1) s2--;
}
}
}
//取当前最优解
ans = min(ans, shunzi+s1+s2+s3+s4);
for (i = 1; i <= 8; i++) {//单顺
for (j = i; j <= 12; j++) {
s[j]--;
if (s[j]<0) break;
if (j-i >= 4) dfs(shunzi+1);
}
if (j == 13) j--;
while (j>=i) {
s[j]++;
j--;
}
}
for (i = 1; i <= 10; i++) {//双顺
for (j = i; j <= 12; j++) {
s[j] -= 2;
if (s[j]<0) break;
if (j-i >= 2) dfs(shunzi+1);
}
if (j == 13) j--;
while (j>=i) {
s[j] += 2;
j--;
}
}
for (i = 1; i <= 11; i++) {//三顺
for (j = i; j <= 12; j++) {
s[j] -= 3;
if (s[j]<0) break;
if (j-i >= 1) dfs(shunzi+1);
}
if (j == 13) j--;
while (j>=i) {
s[j] += 3;
j--;
}
}
return ;
}
int main() {
scanf("%d%d", &T, &n);
while (T--) {
memset(s, 0, sizeof(s));
int i, a, b;
ans = 54;
for (i = 1; i <= n; i++) {
scanf("%d%d", &a, &b);
if (a == 0) s[14]++;
if (a == 1) s[12]++;
if (a == 2) s[13]++;
if (a>=3) s[a-2]++;
}
dfs(0);
printf("%d\n", ans);
}
return 0;
}
跳石头
【问题描述】
一年一度的“跳石头”比赛又要开始了!这项比赛将在一条笔直的河道中进行,河道中分布着一些巨大岩石。组委会已经选择好了两块岩石作为比赛起点和终点。在起点和终点之间,有 N 块岩石(不含起点和终点的岩石)。在比赛过程中,选手们将从起点出发,每一步跳向相邻的岩石,直至到达终点。
为了提高比赛难度,组委会计划移走一些岩石,使得选手们在比赛过程中的最短跳跃距离尽可能长。由于预算限制,组委会至多从起点和终点之间移走 M 块岩石(不能移走起点和终点的岩石)。
【输入格式】
输入文件名为 stone.in。
输入文件第一行包含三个整数 L,N,M,分别表示起点到终点的距离,起点和终点之间的岩石数,以及组委会至多移走的岩石数。
接下来 N 行,每行一个整数,第 i 行的整数 Di(0 < Di < L)表示第 i 块岩石与起点的距离。这些岩石按与起点距离从小到大的顺序给出,且不会有两个岩石出现在同一个位置。
【输出格式】
输出文件名为 stone.out。
输出文件只包含一个整数,即最短跳跃距离的最大值。
【输入输出样例 1】
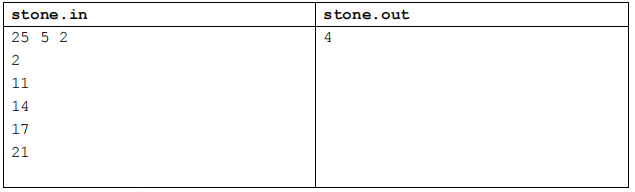
【输入输出样例 1 说明】
将与起点距离为 2 和 14 的两个岩石移走后,最短的跳跃距离为 4(从与起点距离17 的岩石跳到距离 21 的岩石,或者从距离 21 的岩石跳到终点)。
【数据规模与约定】
对于 20%的数据,0 ≤ M ≤ N ≤ 10。
对于 50%的数据,0 ≤ M ≤ N ≤ 100。
对于 100%的数据,0 ≤ M ≤ N ≤ 50,000,1 ≤ L ≤ 1,000,000,000。
#include<bits/stdc++.h>
using namespace std; //本题数据量大,采用二分法来减少复杂度,避免超时。先把所有的石头点存入数组a
int l,n,m; //包括起始点0和终点l。这题使用二分答案的思想,顾名思义就是采用二分法查找答案(最短跳跃距离最大值)
int a[100000]; //我们知道,最短跳跃距离必在0-l之间,0和l一开始作为上下界,对于a[mid]用judge进行判断
bool judge(int k){ //如果要达到mid对应最短跳跃距离需要移开石头数count>原有的m,说明实际的答案会比mid小
int count=0,now=0; //就把有边界左移,反之,说明可以达到这个最短跳跃距离,是暂时的最优答案,先保存
for(int i=1;i<n+2;i++){ //然后把左边界右移,试试有没有更优的解,直到上下边界互相跨越
if(a[i]-a[now]<k){
count++;
}else{
now=i; //now是现在脚底下的石头,如果不移石头直接过去要更新
}
}
if(count>m){
return false;
}else{
return true;
}
}
int main(){
cin>>l>>n>>m;
a[0]=0;
a[n+1]=l;
for(int i=1;i<n+1;i++){
cin>>a[i];
}
int left=0,right=l,mid,ans;
while(left<=right){ //二分法
mid=(left+right)/2;
if(judge(mid)){
left=mid+1;
ans=mid;
}else{
right=mid-1;
}
}
cout<<ans;
//system("pause");
return 0;
}
子串
【问题描述】
有两个仅包含小写英文字母的字符串 A 和 B。现在要从字符串 A 中取出 k 个互不重叠的非空子串,然后把这 k 个子串按照其在字符串 A 中出现的顺序依次连接起来得到一个新的字符串,请问有多少种方案可以使得这个新串与字符串 B 相等?注意:子串取出的位置不同也认为是不同的方案。
【输入格式】
输入文件名为 substring.in。
第一行是三个正整数 n,m,k,分别表示字符串 A 的长度,字符串 B 的长度,以及问题描述中所提到的 k,每两个整数之间用一个空格隔开。
第二行包含一个长度为 n 的字符串,表示字符串 A。
第三行包含一个长度为 m 的字符串,表示字符串 B。
【输出格式】
输出文件名为 substring.out。
输出共一行,包含一个整数,表示所求方案数。由于答案可能很大,所以这里要求输出答案对 1,000,000,007 取模的结果。
【输入输出样例 1】
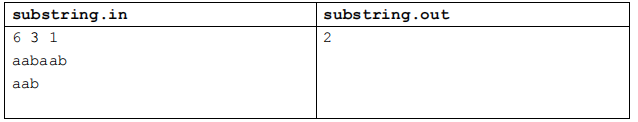
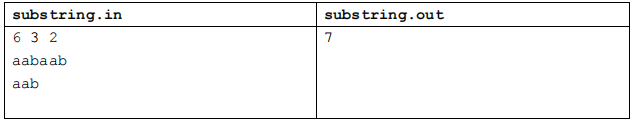
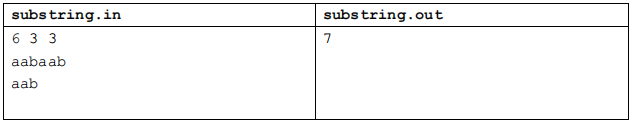
【输入输出样例 2】
【输入输出样例 3】
【输入输出样例说明】
所有合法方案如下:(加下划线的部分表示取出的子串)
样例 1:aab aab / aab aab
样例 2:a ab aab / a aba ab / a a ba ab / aab a abaa b aab / aa baa b / aab aa b
样例 3:a a b aab / a a baa b / a ab a a b / a aba a ba a b a a b / a a ba a b / aab a a b
【数据规模与约定】
对于第 1 组数据:1≤n≤500,1≤m≤50,k=1;
对于第 2 组至第 3 组数据:1≤n≤500,1≤m≤50,k=2;
对于第 4 组至第 5 组数据:1≤n≤500,1≤m≤50,k=m;
对于第 1 组至第 7 组数据:1≤n≤500,1≤m≤50,1≤k≤m;
对于第 1 组至第 9 组数据:1≤n≤1000,1≤m≤100,1≤k≤m;
对于所有 10 组数据:1≤n≤1000,1≤m≤200,1≤k≤m。
#include<iostream>
#include<cstring>
#define N 1003
#define M 203
#define mod 1000000007
using namespace std;
int dp[3][N][M]={0};
char A[N],B[M];
int n=0,m=0,K=0;
int main(){
ios::sync_with_stdio(false);
cin>>n>>m>>K;
cin>>(A+1);cin>>(B+1);
for(int i=0;i<=n;i++) dp[0][i][0]=1;
for(int k=1;k<=K;k++){
memset(dp[k&1],0,sizeof(dp[k&1]));
for(int i=1;i<=n;i++){
for(int j=1;j<=m;j++){
if(j>i) break;
dp[k&1][i][j]+=dp[k&1][i-1][j];
dp[k&1][i][j]%=mod;
if(A[i]==B[j]){
dp[k&1][i][j]+=(dp[(k-1)&1][i-1][j-1]+dp[k&1][i-1][j-1])%mod;
dp[k&1][i][j]%=mod;
if(i>1) dp[k&1][i][j]-=dp[k&1][i-2][j-1];
dp[k&1][i][j]%=mod;
dp[k&1][i][j]+=mod;
dp[k&1][i][j]%=mod;
}
dp[k&1][i][j]%=mod;
}
}
}
cout<<dp[K&1][n][m]<<endl;
return 0;
}
运输计划
【问题描述】
公元 2044 年,人类进入了宇宙纪元。
L 国有 n 个星球,还有 n-1 条双向航道,每条航道建立在两个星球之间,这 n-1 条航道连通了 L 国的所有星球。小 P 掌管一家物流公司,该公司有很多个运输计划,每个运输计划形如:有一艘物流飞船需要从 ui号星球沿最快的宇航路径飞行到 vi号星球去。显然,飞船驶过一条航道是需要时间的,对于航道 j,任意飞船驶过它所花费的时间为 tj,并且任意两艘飞船之间不会产生任何干扰。
为了鼓励科技创新,L 国国王同意小 P 的物流公司参与 L 国的航道建设,即允许小P 把某一条航道改造成虫洞,飞船驶过虫洞不消耗时间。
在虫洞的建设完成前小 P 的物流公司就预接了 m 个运输计划。在虫洞建设完成后,这 m 个运输计划会同时开始,所有飞船一起出发。当这 m 个运输计划都完成时,小 P 的物流公司的阶段性工作就完成了。
如果小 P 可以自由选择将哪一条航道改造成虫洞,试求出小 P 的物流公司完成阶段性工作所需要的最短时间是多少?
【输入格式】
输入文件名为 transport.in。
第一行包括两个正整数 n、m,表示 L 国中星球的数量及小 P 公司预接的运输计划的数量,星球从 1 到 n 编号。
接下来 n-1 行描述航道的建设情况,其中第 i 行包含三个整数 ai, bi和 ti,表示第i 条双向航道修建在 ai与 bi两个星球之间,任意飞船驶过它所花费的时间为 ti。
接下来 m 行描述运输计划的情况,其中第 j 行包含两个正整数 uj和 vj,表示第 j 个运输计划是从 uj号星球飞往 vj号星球。
【输出格式】
输出文件名为 transport.out。
共 1 行,包含 1 个整数,表示小 P 的物流公司完成阶段性工作所需要的最短时间。
【输入输出样例 1】
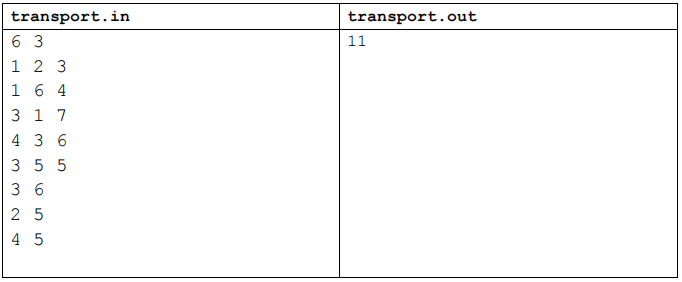
【输入输出样例 1 说明】
将第 1 条航道改造成虫洞:则三个计划耗时分别为:11、12、11,故需要花费的时间为 12。
将第 2 条航道改造成虫洞:则三个计划耗时分别为:7、15、11,故需要花费的时间为 15。
将第 3 条航道改造成虫洞:则三个计划耗时分别为:4、8、11,故需要花费的时间为 11。
将第 4 条航道改造成虫洞:则三个计划耗时分别为:11、15、5,故需要花费的时间为 15。
将第 5 条航道改造成虫洞:则三个计划耗时分别为:11、10、6,故需要花费的时间为 11。
故将第 3 条或第 5 条航道改造成虫洞均可使得完成阶段性工作的耗时最短,需要花费的时间为 11。
【数据规模与约定】
所有测试数据的范围和特点如下表所示
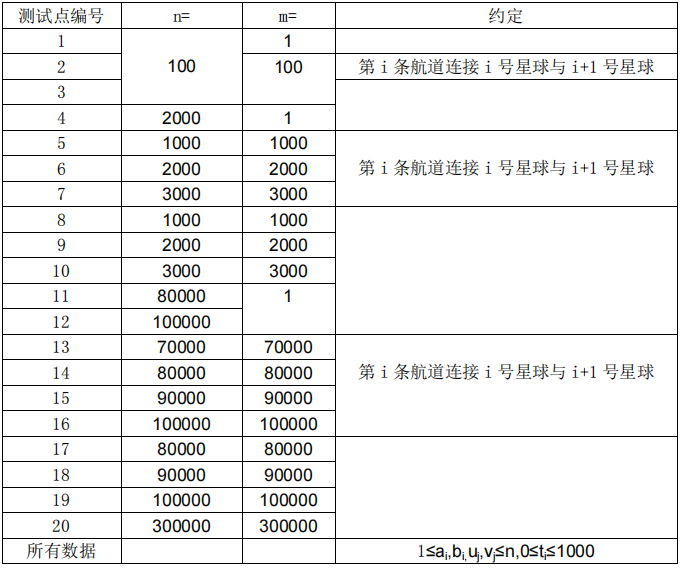
请注意常数因子带来的程序效率上的影响。
#include <bits/stdc++.h>
using namespace std;
const int Max=300005;
int n,m,s,ans,tot,l,r,mid;
int first[Max],son[Max],pos[Max],top[Max],depth[Max],father[Max],size[Max],dis[Max],num[Max],len[Max],val[Max],v[Max];
struct shu{int to,next,len;}edge[Max<<1];
struct bian{int x,y,len;}d[Max];
inline int get_int()
{
int x=0,f=1;
char c;
for(c=getchar();(!isdigit(c))&&(c!='-');c=getchar());
if(c=='-') f=-1,c=getchar();
for(;isdigit(c);c=getchar()) x=(x<<3)+(x<<1)+c-'0';
return x*f;
}
inline void build(int x,int y,int z){edge[++s].next=first[x],first[x]=s,edge[s].to=y,edge[s].len=z;}
inline void dfs1(int point,int fa)
{
size[point]=1,father[point]=fa,depth[point]=depth[fa]+1;
for(int u=first[point];u;u=edge[u].next)
{
int to=edge[u].to;
if(to==fa) continue;
val[to]=edge[u].len,dis[to]=dis[point]+edge[u].len;
dfs1(to,point);
size[point]+=size[to];
if(size[to] > size[son[point]]) son[point]=to;
}
}
inline void dfs2(int point,int fa)
{
if(son[point])
{
pos[son[point]]=++tot,len[tot]=val[son[point]],top[son[point]]=top[point];
dfs2(son[point],point);
}
for(int u=first[point];u;u=edge[u].next)
{
int to=edge[u].to;
if(top[to]) continue;
pos[to]=++tot,top[to]=to;
dfs2(to,point);
}
}
inline int LCA(int x,int y)
{
while(top[x]!=top[y])
{
if(depth[top[x]] < depth[top[y]]) x^=y,y^=x,x^=y;
x=father[top[x]];
}
if(depth[x] > depth[y]) swap(x,y);
return x;
}
inline bool comp(const bian &a,const bian &b){return a.len>b.len;}
inline void solve(int x,int y)
{
while(top[x]!=top[y])
{
if(depth[top[x]] < depth[top[y]]) x^=y,y^=x,x^=y;
num[pos[top[x]]+1]++,num[pos[x]+1]--;
x=father[top[x]];
}
if(x==y) return;
if(depth[x] > depth[y]) x^=y,y^=x,x^=y;
num[pos[x]+1]++,num[pos[y]+1]--;
}
inline int mx(int x,int y){return x < y ? y : x;}
inline int check(int mid)
{
int k=0,x=0,sum=0;
while(d[k+1].len>mid) k++;
if(v[k]) return v[k];
memset(num,0,sizeof(num));
for(int i=1;i<=k;i++) solve(d[i].x,d[i].y);
for(int i=1;i<=n;i++){sum+=num[i];if(sum == k) x=mx(x,len[i]);}
v[k]=x;
return x;
}
inline void print(int x){if(x>9) print(x/10);putchar('0'+x%10);}
int main()
{
n=get_int(),m=get_int();
for(int i=1;i<=n-1;i++)
{
int x=get_int(),y=get_int(),z=get_int();
build(x,y,z),build(y,x,z);
}
top[1]=tot=pos[1]=1;
dfs1(1,0),dfs2(1,0);
for(int i=1;i<=m;i++)
{
d[i].x=get_int(),d[i].y=get_int();
d[i].len=dis[d[i].x]+dis[d[i].y]-2*dis[LCA(d[i].x,d[i].y)];
}
sort(d+1,d+m+1,comp);
l=0,r=d[1].len;
while(l<r)
{
mid=(l+r)>>1;
(d[1].len - check(mid) <= mid) ? r=mid : l=mid+1;
}
print(r);
return 0;
}
生活大爆炸版石头剪刀布
【问题描述】
石头剪刀布是常见的猜拳游戏:石头胜剪刀,剪刀胜布,布胜石头。如果两个人出拳一样,则不分胜负。在《生活大爆炸》第二季第 8 集中出现了一种石头剪刀布的升级版游戏。升级版游戏在传统的石头剪刀布游戏的基础上,增加了两个新手势:
斯波克:《星际迷航》主角之一。
蜥蜴人:《星际迷航》中的反面角色。
这五种手势的胜负关系如表一所示,表中列出的是甲对乙的游戏结果。
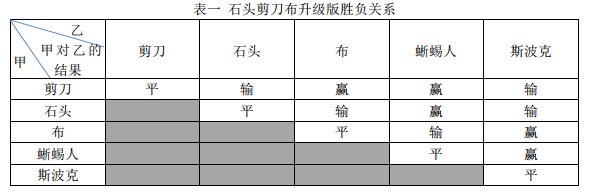
现在,小 A 和小 B 尝试玩这种升级版的猜拳游戏。已知他们的出拳都是有周期性规律的,但周期长度不一定相等。例如:如果小 A 以“石头-布-石头-剪刀-蜥蜴人-斯波克”长度为 6 的周期出拳,那么他的出拳序列就是“石头-布-石头-剪刀-蜥蜴人-斯波克-石头-布-石头-剪刀-蜥蜴人-斯波克-……”,而如果小 B 以“剪刀-石头-布-斯波克-蜥蜴人”长度为 5 的周期出拳,那么他出拳的序列就是“剪刀-石头-布-斯波克-蜥蜴人-剪刀-石头-布-斯波克-蜥蜴人-……”
已知小 A 和小 B 一共进行 N 次猜拳。每一次赢的人得 1 分,输的得 0 分;平局两人都得 0 分。现请你统计 N 次猜拳结束之后两人的得分。
【输入】
输入文件名为 rps.in。
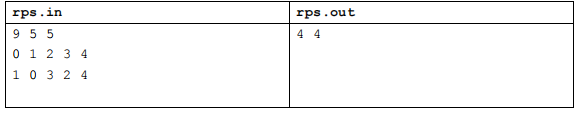
第一行包含三个整数:N,NA,NB,分别表示共进行 N 次猜拳、小 A 出拳的周期长度,小 B 出拳的周期长度。数与数之间以一个空格分隔。
第二行包含 NA 个整数,表示小 A 出拳的规律,第三行包含 NB 个整数,表示小 B 出拳的规律。其中,0 表示“剪刀”,1 表示“石头”,2 表示“布”,3 表示“蜥蜴人”, 4 表示“斯波克”。数与数之间以一个空格分隔。
【输出】
输出文件名为 rps.out。
输出一行, 包含两个整数,以一个空格分隔,分别表示小 A、小 B 的得分。
【输入输出样例 1】
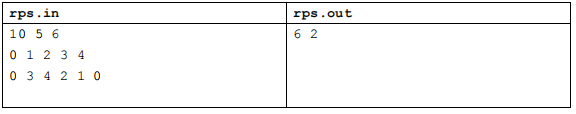
【输入输出样例 2】
【数据说明】
对于 100%的数据,0 < N ≤ 200,0 < NA ≤ 200, 0 < NB ≤ 200。
#include<bits/stdc++.h>
using namespace std;
int n , a , b , arr[205] , brr[205] , x , y;
int main(){
scanf("%d %d %d" , &n , &a , &b);
for(int i = 0 ; i < a ; i++) cin >> arr[i];
for(int i = 0 ; i < b ; i++) cin >> brr[i];
for(int i = 0 ; i < n ; i++){
if(arr[i % a] == 0 && brr[i % b] == 2 ||
arr[i % a] == 0 && brr[i % b] == 3 ||
arr[i % a] == 1 && brr[i % b] == 0 ||
arr[i % a] == 1 && brr[i % b] == 3 ||
arr[i % a] == 2 && brr[i % b] == 1 ||
arr[i % a] == 2 && brr[i % b] == 4 ||
arr[i % a] == 3 && brr[i % b] == 2 ||
arr[i % a] == 3 && brr[i % b] == 4 ||
arr[i % a] == 4 && brr[i % b] == 0 ||
arr[i % a] == 4 && brr[i % b] == 1)
x++;
else if(arr[i % a] == brr[i % b]) continue;
else y++;
}
cout << x << " " << y;
return 0;
}
联合权值
【问题描述】
无向连通图 G 有 n 个点,n-1 条边。点从 1 到 n 依次编号,编号为 i 的点的权值为 Wi ,每条边的长度均为 1。图上两点(u, v)的距离定义为 u 点到 v 点的最短距离。对于图 G 上的点对(u, v),若它们的距离为 2,则它们之间会产生 的联合权值。
请问图 G 上所有可产生联合权值的有序点对中,联合权值最大的是多少?所有联合权值之和是多少?
【输入】
输入文件名为 link.in。
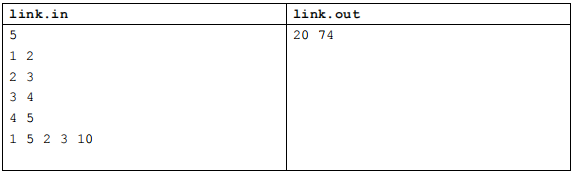
第一行包含 1 个整数 n。
接下来 n-1 行,每行包含 2 个用空格隔开的正整数 u、v,表示编号为 u 和编号为 v 的点之间有边相连。
最后 1 行,包含 n 个正整数,每两个正整数之间用一个空格隔开,其中第 i 个整数表示图 G 上编号为 i 的点的权值为 Wi。
【输出】
输出文件名为 link.out。
输出共 1 行,包含 2 个整数,之间用一个空格隔开,依次为图 G 上联合权值的最大值和所有联合权值之和。由于所有联合权值之和可能很大,输出它时要对 10007 取余。
【输入输出样例】
【样例说明】
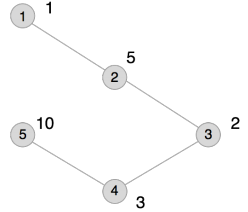
本例输入的图如上所示,距离为 2 的有序点对有(1,3)、(2,4)、(3,1)、(3,5)、(4,2)、(5,3)。
其联合权值分别为 2、15、2、20、15、20。其中最大的是 20,总和为 74。
【数据说明】
#include<iostream>
#include<cstring>
#include<cstdio>
using namespace std;
long long n,x,y,v[500001],head[500001],nxt[500001],cnt,w[200001];
long long sum,maxx;
void add(int a,int b)//链式前向星存边,效率高,在图论中有很重要的作用
{
v[++cnt]=b;//v[cnt]表示编号为cnt的边的终点
nxt[cnt]=head[a];//nxt[cnt]表示第cnt条边下一条边是head[a]
head[a]=cnt;//插入链表头部
}
int main()
{
scanf("%lld",&n);
for(int i=1;i<n;i++)
{
scanf("%lld%lld",&x,&y);
add(x,y);//无向边存两次
add(y,x);
}
for(int i=1;i<=n;i++)scanf("%lld",&w[i]);
for(int i=1;i<=n;i++)
{
long long fix=0,maxn=0;
for(int j=head[i];j;j=nxt[j])
{
sum+=(fix*w[v[j]])%10007;//和之前的数每个相乘再相加,只需加他们的和就好了。
fix+=w[v[j]];//根据乘法分配律,打前缀和
maxx=max(maxx,maxn*w[v[j]]);//打擂台取最大值
maxn=max(maxn,w[v[j]]);
}
}
cout<<maxx<<" "<<sum*2%10007;
return 0;
}