信息学奥赛-提高级 题库
Emiya家今天的饭
【题目描述】
Emiya 是个擅长做菜的高中生,他共掌握 n 种烹饪方法,且会使用 m 种主要食材做菜。为了方便叙述,我们对烹饪方法从 1~n 编号,对主要食材从 1 ~m 编号。
Emiya 做的每道菜都将使用恰好一种烹饪方法与恰好一种主要食材。更具体地,Emiya 会做 ai,j 道不同的使用烹饪方法 i 和主要食材 j 的菜(1 ≤i≤n,1≤j≤m),这也意味着 Emiya 总共会做
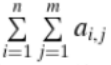 道不同的菜。
Emiya 今天要准备一桌饭招待 Yazid 和 Rin 这对好朋友,然而三个人对菜的搭配有不同的要求,更具体地,对于一种包含 k 道菜的搭配方案而言:
(1)Emiya 不会让大家饿肚子,所以将做至少一道菜,即 k≥1
(2)Rin 希望品尝不同烹饪方法做出的菜,因此她要求每道菜的烹饪方法互不相同
(3)Yazid 不希望品尝太多同一食材做出的菜,因此他要求每种主要食材至多在一半的菜(即 道菜)中被使用
这里的⌊x⌋ 为下取整函数,表示不超过 x 的最大整数。
这些要求难不倒 Emiya,但他想知道共有多少种不同的符合要求的搭配方案。两种方案不同,当且仅当存在至少一道菜在一种方案中出现,而不在另一种方案中出现。
Emiya 找到了你,请你帮他计算,你只需要告诉他符合所有要求的搭配方案数对质数998,244,353 取模的结果。
【输入格式】
从文件meal.in中读入数据。
第 1 行两个用单个空格隔开的整数 n,m。
第 2 行至第 n+1 行,每行 m 个用单个空格隔开的整数,其中第 i + 1行的 m 个数依次为 ai,1,ai,2,⋯,ai,m。
【输出格式】
输出到文件meal.out中。
仅一行一个整数,表示所求方案数对 998,244,353 取模的结果。
【样例 1 输入】
2 3
1 0 1
0 1 1
【样例 1 输出】
3
【样例1解释】
由于在这个样例中,对于每组i,j,Emiya都最多只会做一道菜,因此我们直接通 过给出烹饪方法、主要食材的编号来描述一道菜。
符合要求的方案包括:
•做一道用烹饪方法1、主要食材1的菜和一道用烹饪方法2、主要食材2的菜
•做一道用烹饪方法1、主要食材1的菜和一道用烹饪方法2、主要食材3的菜
•做一道用烹饪方法1、主要食材3的菜和一道用烹饪方法2、主要食材2的菜
因此输出结果为3 mod 998,244,353 = 3。
需要注意的是,所有只包含一道菜的方案都是不符合要求的,因为唯一的主要食材 在超过一半的菜中出现,这不满足Yazid的要求。
【样例2输入】
3 3
1 2 3
4 5 0
6 0 0
【样例2输出】
190
【样例2解释】
Emiya必须至少做2道菜。
做2道菜的符合要求的方案数为100。
做3道菜的符合要求的方案数为90。
因此符合要求的方案数为100 + 90 = 190。
【样例3输入】
5 5
1 0 0 1 1
0 1 0 1 0
1 1 1 1 0
1 0 1 0 1
0 1 1 0 1
【样例3输出】
742
【数据范围】
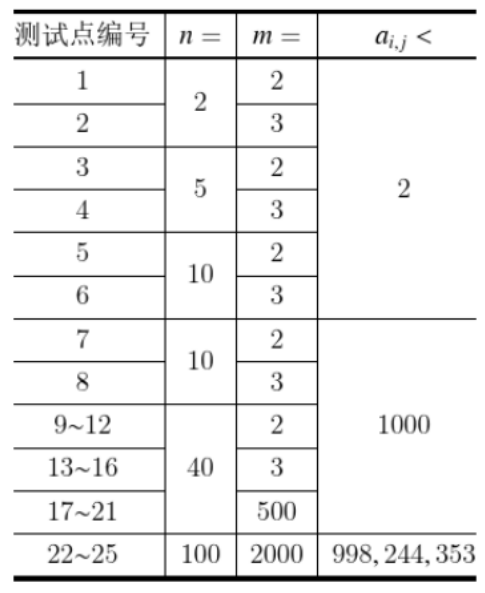
对于所有测试点,保证 1 ≤n≤ 100, 1 ≤ m ≤ 2000, 0≤ai,j< 998,244,353。
#include <iostream>
#include <cstdlib>
#include <cstring>
#include <cstdio>
#define mod 998244353
using namespace std;
typedef long long ll;
const int MAXN = 105, MAXM = 2005;
int n,m,a[MAXN][MAXM],sum[MAXN][MAXM];
ll f[MAXN][MAXN*2],g[MAXN][MAXN];
int main()
{
cin >> n >> m;
for(int i = 1; i<=n; i++)
for(int j = 1; j<=m; j++)
{
scanf("%d",&a[i][j]);
sum[i][0] = (sum[i][0]+a[i][j])%mod;
}
for(int i = 1; i<=n; i++)
for(int j = 1; j<=m; j++)
sum[i][j] = (sum[i][0]-a[i][j]+mod)%mod;
ll ans = 0;
for(int col = 1; col<=m; col++)
{
memset(f,0,sizeof(f));
f[0][n] = 1;
for(int i = 1; i<=n; i++)
for(int j = n-i; j<=n+i; j++)
f[i][j] = (f[i-1][j]+f[i-1][j-1]*a[i][col]%mod+f[i-1][j+1]*sum[i][col]%mod)%mod;
for(int j = 1; j<=n; j++)
ans = (ans+f[n][n+j])%mod;
}
g[0][0] = 1;
for(int i = 1; i<=n; i++)
for(int j = 0; j<=n; j++)
g[i][j] = (g[i-1][j]+(j>0?g[i-1][j-1]*sum[i][0]%mod:0))%mod;
for(int j = 1; j<=n; j++)
ans = (ans-g[n][j]+mod)%mod;
cout << ans*(mod-1)%mod << endl;
return 0;
}
笨小猴
【问题描述】
笨小猴的词汇量很小,所以每次做英语选择题的时候都很头疼。但是他找到了一种方法,经试验证明,用这种方法去选择选项的时候选对的几率非常大!
这种方法的具体描述如下:假设 maxn 是单词中出现次数最多的字母的出现次数,minn是单词中出现次数最少的字母的出现次数,如果 maxn-minn 是一个质数,那么笨小猴就认为这是个 Lucky Word,这样的单词很可能就是正确的答案。
【输入】
输入文件 word.in 只有一行,是一个单词,其中只可能出现小写字母,并且长度小于 100。
【输出】
输出文件 word.out 共两行,第一行是一个字符串,假设输入的的单词是 Lucky Word,那么输出“Lucky Word”,否则输出“No Answer”;
第二行是一个整数,如果输入单词是 Lucky Word,输出 maxn-minn 的值,否则输出 0。
【输入输出样例 1】
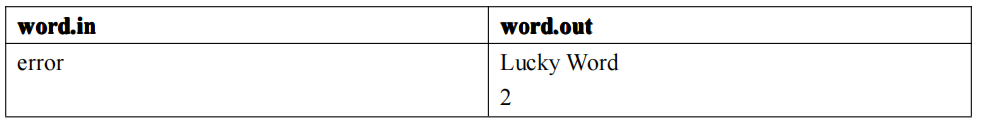
【输入输出样例 1 解释】
单词 error 中出现最多的字母 r 出现了 3 次,出现次数最少的字母出现了 1 次,3-1=2,2 是质数。
【输入输出样例 2】
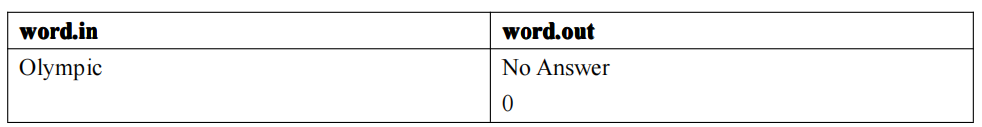
【输入输出样例 2 解释】
单词 olympic 中出现最多的字母 i 出现了 2 次,出现次数最少的字母出现了 1 次,2-1=1,1不是质数。
#include<bits/stdc++.h> //万能头文件
using namespace std;
int primenum(int m); //质数的判断
int main()
{
char ch[1000];
int array[100]={0};
int m,n,i,j,k;
int maxn=-500,minn=9999;
scanf("%s",ch);
for(int m=0;m<strlen(ch);m++){
array[ch[m]-'a']++;
}
for(int m=0;m<26;m++){
if(array[m]>maxn&&array[m]!=0) maxn=array[m];
if(array[m]<minn&&array[m]!=0) minn=array[m];
}
if(primenum(maxn-minn)){
printf("Lucky Word\n%d",maxn-minn);
}else{
printf("No Answer\n0");
}
}
int primenum(int m)
{
int i;
if(m==2||m==3) return 1;
if(m==1||m==0) return 0;
if(m%6!=1&&m%6!=5) return 0; //优化质数的判断方法
for(i=5;i<=sqrt(m);i+=5){
if(m%i==0||m%(i+2)==0){
return 0;
}