信息学奥赛-提高级 题库
考虑一个自然数n以及一个模数m,你需要计算n的逆元(即n在模m意义下的乘法逆元)。下列哪种算法最为合适?( )
如果一个线性同余方程ax≡1(modb),则x称为a mod b的逆元,记作a-1。扩展欧几里德算法找到两个整数x和y满足ax+by=gcd(a, b)。当a和b互质时,即gcd(a,b)=1,这个方程变为ax+by=1。在模b意义下,ax与1在模b时同余,因此x就是a的模b的逆元。快速幂法使用了费马小定理,要求b是一个素数;而扩展欧几里得法只要求gcd(a,b)=1
计算机系统用小端(Little Endian)和大端(Big Endian)来描述多字节数据的存储地址顺序模式,其中小端表示将低位字节数据存储在低地址的模式、大端表示将高位字节数据存储在低地址的模式。在小端模式的系统和大端模式的系统分别编译和运行以下 C++代码段表示的程序,将分别输出什么结果?( )
unsigned x = 0xDEADBEEF;
unsigned char *p = (unsigned char *)&x;
printf("%X", *p);
T(n)表示某个算法输入规模为 n 时的运算次数。如果 T(1)为常数,且有递归式T(n)=2*T(n/2)+2n,那么 T(n)=( )。
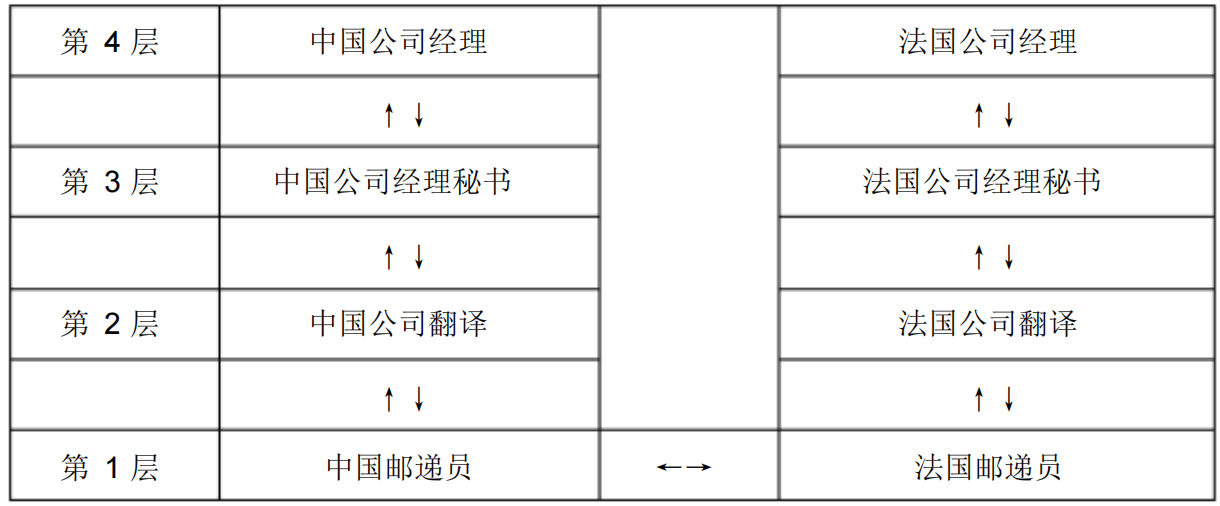
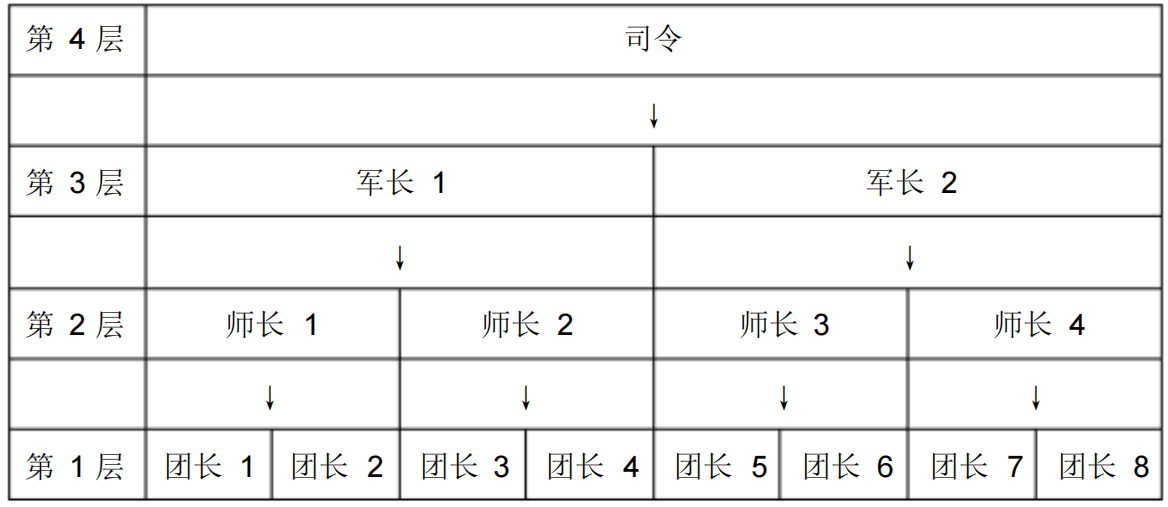
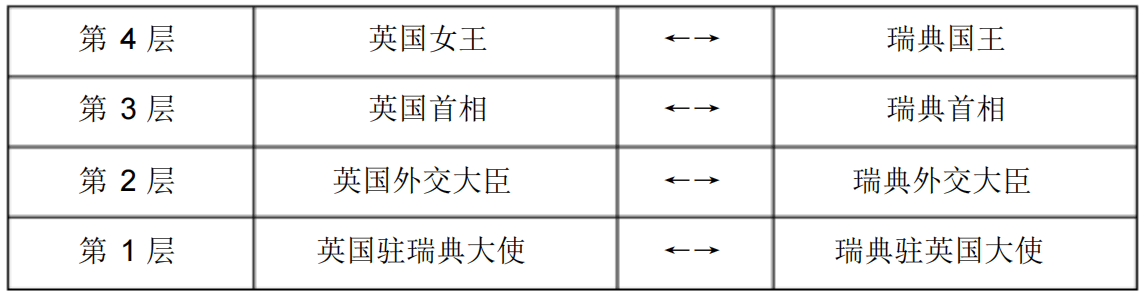
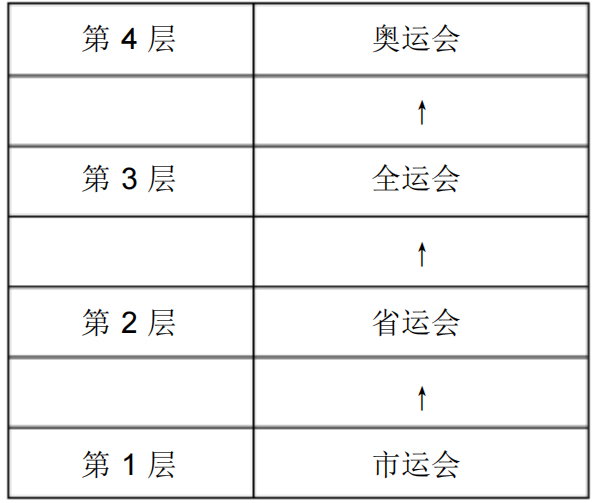
无论是TCP/IP模型还是OSI模型,都可以视为网络的分层模型,每个网络协议都会被归入某一层中。如果用现实生活中的例子来比喻这些“层”,以下最恰当的是( )。
计算机系统用小端(Little Endian)和大端(Big Endian)来描述多字节数据的存储地址顺序模式,其中小端表示将低位字节数据存储在低地址的模式、大端表示将高位字节数据存储在低地址的模式。在小端模式的系统和大端模式的系统分别编译和运行以下 C++代码段表示的程序,将分别输出什么结果?( )
unsigned x = 0xDEADBEEF;
unsigned char *p = (unsigned char *)&x;
printf("%X", *p);
结构体(struct)
【题目背景】
在C++等高级语言中,除了int和float等基本类型外,通常还可以自定义结构体类型。在本题当中,你需要模拟一种类似C++的高级语言的结构体定义方式,并计算出相应的内存占用等信息。
【题目描述】
在这种语言中,基本类型共有4种:byte,short,int,long,分别占据1,2,4,8字节的空间。
定义一个结构体类型时,需要给出类型名和成员,其中每个成员需要按顺序给出类.型和名称。类型可以为基本类型,也可以为先.定义过的结构体类型。注意,定义结构体类型时不会定义具体元素,即不占用内存。
定义一个元素时,需要给出元素的类型和名称。元素将按照以下规则占据内存:
• 元素内的所有成员将按照定义时给出的顺序在内存中排布,对于类型为结构体的成员同理。
• 为了保证内存访问的效率,元素的地址占用需要满足对齐规则,即任何类型的大小和该类型元素在内存中的起始地址均应对齐到该类型对齐要求的整数倍。具体而言:
–对于基本类型:对齐要求等于其占据空间大小,如int类型需要对齐到4字节,其余同理。
–对于结构体类型:对齐要求等于其成员的对齐要求的最大值,如一个含有int和short的结构体类型需要对齐到4字节。
以下是一个例子(以C++语言的格式书写):
该代码定义了结构体类型d与元素e。元素e包含三个成员e.a,e.b,e.c,分别占据第0∼1,4∼7,8∼9字节的地址。由于类型d需要对齐到4字节,因此e占据了第0∼11字节的地址,大小为12字节。
你需要处理n次操作,每次操作为以下四种之一:
1.定义一个结构体类型。具体而言,给定正整数k与字符串s,t1,n1,...,tk,nk,其中k表示该类型的成员数量,s表示该类型的类型名,t1,t2,...,tk按顺序分别表示每个成员的类型,n1,n2,...,nk按顺序分别表示每个成员的名称。你需要输出该结构体类型的大小和对齐要求,用一个空格分隔。
2.定义一个元素,具体而言,给定字符串t,n分别表示该元素的类型与名称。所有被定义的元素将按顺序,从内存地址为0开始依次排开,并需要满足地址对齐规则。你需要输出新定义的元素的起始地址。
3.访问某个元素。具体而言,给定字符串s,表示所访问的元素。与C++等语言相同,采用.来访问结构体类型的成员。如a.b.c,表示a是一个已定义的元素,它是一个结构体类型,有一个名称为b的成员,它也是一个结构体类型,有一个名称为c的成员。你需要输出如上被访问的最内层元素的起始地址。
4.访问某个内存地址。具体而言,给定非负整数addr,表示所访问的地址,你需要判断是否存在一个基本类型的元素占据了该地址。若是,则按操作3中的访问元素格式输出该元素;否则输出ERR。
【输入格式】
从文件struct.in中读入数据。
第1行:一个正整数n,表示操作的数量。
接下来若干行,依次描述每个操作,每行第一个正整数op表示操作类型:
•若op=1,首先输入一个字符串s与一个正整数k,表示类型名与成员数量,接下来k行每行输入两个字符串ti,ni,依次表示每个成员的类型与名称。
•若op=2,输入两个字符串t,n,表示该元素的类型与名称。
•若op=3,输入一个字符串s,表示所访问的元素。
•若op=4,输入一个非负整数addr,表示所访问的地址。
【输出格式】
输出到文件struct.out中。
输出n行,依次表示每个操作的输出结果,输出要求如题目描述中所述。
【样例1输入】
【样例1输出】
【样例1解释】
结构体类型a中,int类型的成员aa占据第0∼3字节地址,short类型的成员ab占据第4∼5字节地址。又由于其对齐要求为4字节,可得其大小为8字节。由此可同理计算出结构体类型b的大小为16字节,对齐要求为8字节。
【样例2】
见选手目录下的struct/struct2.in与struct/struct2.ans。
【样例2解释】
第二个操作4中,访问的内存地址恰好在为了地址对齐而留下的“洞”里,因此没有基本类型元素占据它。
【样例3】
见选手目录下的struct/struct3.in与struct/struct3.ans。
【数据范围】
对于全部数据,满足1≤n≤100,1≤k≤100,0≤addr≤1018。
所有定义的结构体类型名、成员名称和定义的元素名称均由不超过10个字符的小
写字母组成,且都不是byte,short,int,long(即不与基本类型重名)。
所有定义的结构体类型名和元素名称互不相同,同一结构体内成员名称互不相同。
但不同的结构体可能有相同的成员名称,某结构体内的成员名称也可能与定义的结构体或元素名称相同。
保证所有操作均符合题目所述的规范和要求,即结构体的定义不会包含不存在的类型、不会访问不存在的元素或成员等。
保证任意结构体大小及定义的元素占据的最高内存地址均不超过1018。
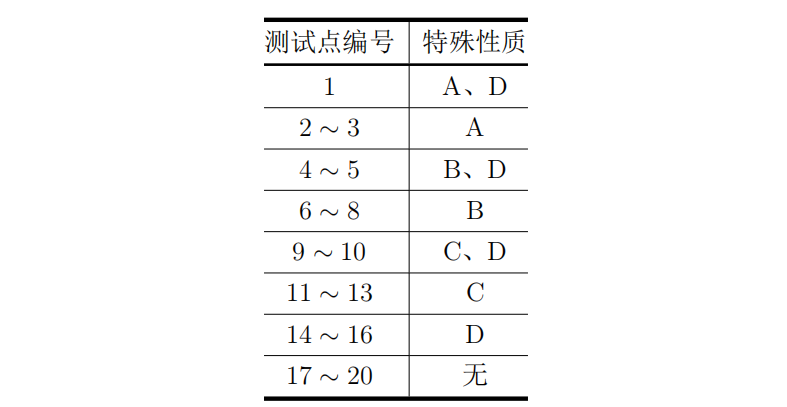
特殊性质A:没有操作1;
特殊性质B:只有一个操作1;
特殊性质C:所有操作1中给出的成员类型均为基本类型;
特殊性质D:基本类型只有long。
【提示】
对于结构体类型的对齐要求和大小,形式化的定义方式如下:
•设该结构体内有k个成员,其大小分别为s1,...,sk,对齐要求分别为a1,...,ak;
•则该结构体的对齐要求为a=max{a1,...,ak};
•再设这些成员排布时的地址偏移量分别为o1,...,ok,则:
–o1=0;
–对于i=2,...,k,oi为满足oi−1+si−1≤oi且ai整除oi的最小值;
–则该结构体的大小s为满足ok+sk≤s且a整除s的最小值;
对于定义元素时的内存排布,形式化的定义方式如下:
•设第i个被定义的元素大小为si,对齐要求为ai,起始地址为bi;
•则b1=0,对于2≤i,bi为满足bi−1+si−1≤bi且ai整除bi的最小值。
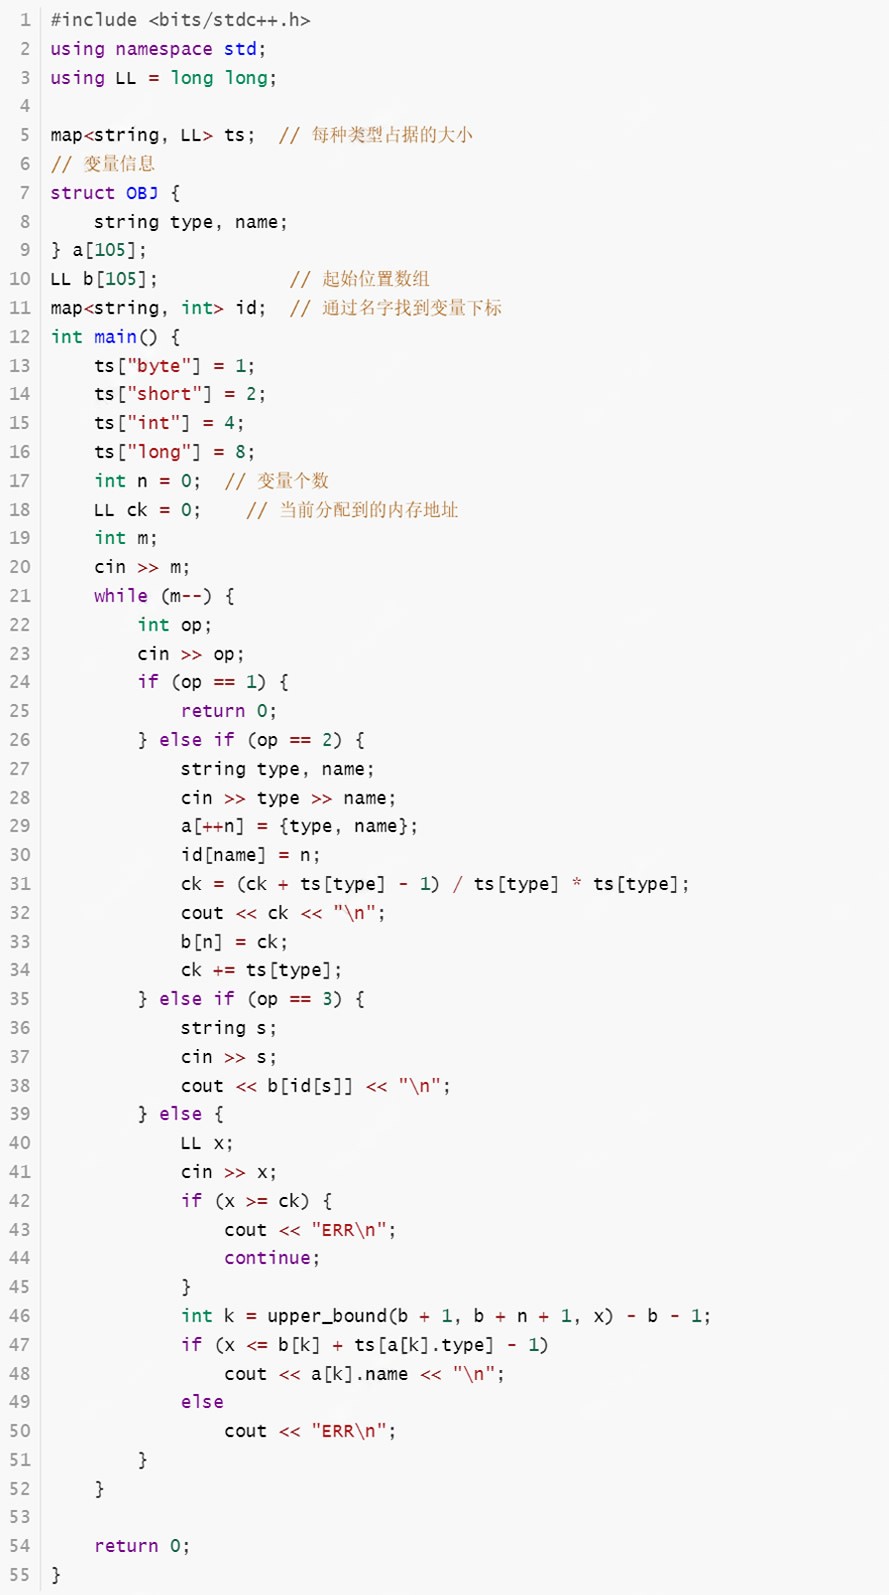
题解1:
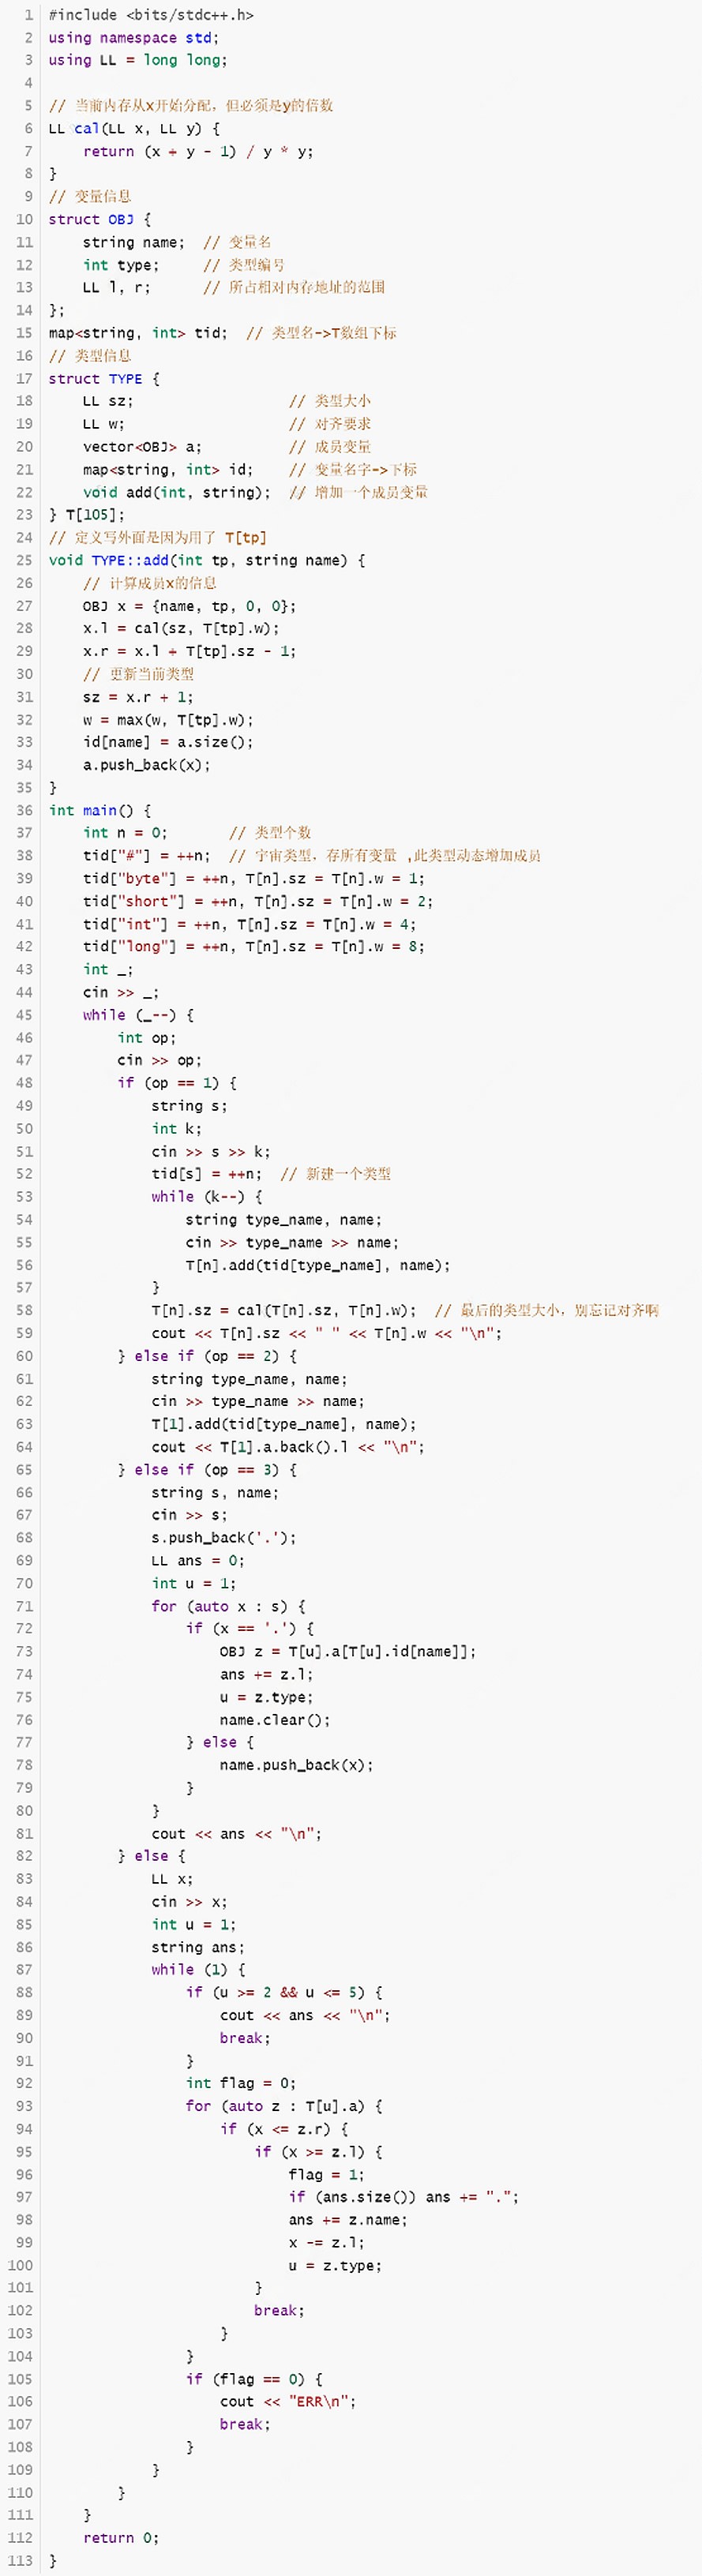
题解2:
划分
【题目描述】
2048年,第三十届CSP认证的考场上,作为选手的小明打开了第一题。这个题的 样例有n组数据,数据从1~n编号,i号数据的规模为ai。
小明对该题设计出了一个暴力程序,对于一组规模为u的数据,该程序的运行时 间为u^2。然而这个程序运行完一组规模为u的数据之后,它将在任何一组规模小于u 的数据上运行错误。样例中的ai,不一定递增,但小明又想在不修改程序的情况下正确 运行样例,于是小明决定使用一种非常原始的解决方案:将所有数据划分成若干个数据 段,段内数据编号连续,接着将同一段内的数据合并成新数据,其规模等于段内原数据 的规模之和.小明将让新数据的规模能够递增。
也就是说,小明需要找到一些分界点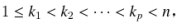 使得
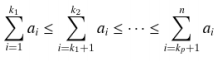
注意P可以为0且此时k0 = 0,也就是小明可以将所有数据合并在一起运行。
小明希望他的程序在正确运行样例情况下,运行时间也能尽量小,也就是最小化
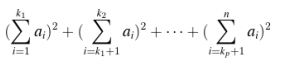
小明觉得这个问题非常有趣,并向你请教:给定n和ai,请你求出最优划分方案 下,小明的程序的最小运行时间。
【输入格式】
从文件partition.in中读入数据。
由于本题的数据范围较大,部分测试点的ai将在程序内生成。
第一行两个整数n.type. n的意义见题目描述,type表示输入方式。
1.若type = 0.则该测试点的ai直接给出。输入文件接下来:第二行n个以空格 分隔的整数ai,表示每组数据的规模。
2.若type = 1则该测试点的ai将特殊生成,生成方式见后文。输入文件接下来: 第二行六个以空格分隔的整数x,y,z,b1,b2,m。 接下来m行中,第i 行包含三个以空格分隔的正整数pi,li,ri。
对于type = 1的23 ~ 25号测试点,ai的生成方式如下:
给定整数x,y,z,b1,b2,m,以及m个三元组(pi,li,ri)。
保证 n 2。 若 n > 2,则
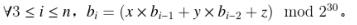
保证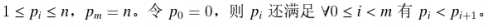
对于所有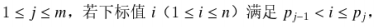 则有ai=(bi mod(rj-lj+1))+lj
上述数据生成方式仅是为了减少输入量大小,标准算法不依赖于该生成方式。
【输出格式】
输出到文件partition.out中。
输出一行一个整数,表示答案。
【样例1输入】
5 0
5 17 9 9
【样例1输出】
247
【样例1解释】
最优的划分方案为{5,1},{7},{9},{9}。由5 + 1<=7<=9<=9知该方案合法。
答案为(5 + 1)^2 + 7^2 + 9^2 + 9^2 = 247。
虽然划分方案{5},{1},{7},{9},{9}对应的运行时间比247小,但它不是一组合法 方案,因为5>1。
虽然划分方案{5},{1,7},{9},{9}合法,但该方案对应的运行时间为251,比247大。
【样例2输入】
10 0
5677462 13 19 9
【样例2输出】
1256
【样例2解释】
最优的划分方案为{5},{6},{7},{7},{4,6,2},{13},{19,9}。
【数据范围】
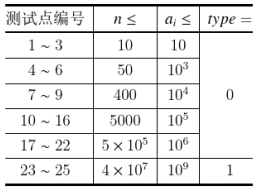
所有测试点满足:type € {0,1} , 2 < =n <= 4 x 10^7 , 1 < =ai,<= 10^9 , 1 <=m < =10^5 , 1 < =li <= ri <= 10^9 , 0 < x,y,z,b1,b2 < 2^30。
#include<bits/stdc++.h>
using namespace std ;
const int N = 4e7 + 10 ;
const int M = 1e5 + 10 ;
const int mod = (1 << 30) ;
int n , type , x , y , z , m ;
int a[N] , b[N] , p[M] , l[M] , r[M] , q[N] , pre[N] ;
long long sum[N] ;
inline long long d(int x) { return sum[x] - sum[pre[x]] ; }
signed main() {
ios :: sync_with_stdio(false) ; cin.tie(nullptr) ; cout.tie(nullptr) ;
cin >> n >> type ;
if(type) {
cin >> x >> y >> z >> b[1] >> b[2] >> m ;
for(register int i = 1 ; i <= m ; i ++) { cin >> p[i] >> l[i] >> r[i] ; }
for(register int i = 3 ; i <= n ; i ++) { b[i] = (0ll + 1ll * b[i - 1] * x + 1ll * b[i - 2] * y + z) % mod ; }
for(register int i = 1 ; i <= m ; i ++)
for(register int j = p[i - 1] + 1 ; j <= p[i] ; j ++) { a[j] = (b[j] % (r[i] - l[i] + 1)) + l[i] ; sum[j] = sum[j - 1] + a[j] ; }
}
else {
for(register int i = 1 ; i <= n ; i ++) { cin >> a[i] ; sum[i] = sum[i - 1] + a[i] ; }
} int h , t ; q[h = t = 0] = 0 ;
for(register int i = 1 ; i <= n ; i ++) {
while(h < t && d(q[h + 1]) + sum[q[h + 1]] <= sum[i]) ++ h ;
pre[i] = q[h] ;
while(h < t && d(q[t]) + sum[q[t]] >= d(i) + sum[i]) -- t ;
q[++ t] = i ;
} int now = n ; __int128 ans = 0 , tmp = 1 ;
while(now) { tmp = d(now) ; tmp *= d(now) ; ans += tmp ; now = pre[now] ; }
int st[50] , tp = 0 ;
while(ans) { st[++ tp] = ans % 10 ; ans /= 10 ; }
while(tp) { cout << st[tp --] ; }
return 0 ;
}
小凯的疑惑
【问题描述】
小凯手中有两种面值的金币,两种面值均为正整数且彼此互素。每种金币小凯都有无数个。在不找零的情况下,仅凭这两种金币,有些物品他是无法准确支付的。现在小凯想知道在无法准确支付的物品中,最贵的价值是多少金币?注意:输入数据保证存在小凯无法准确支付的商品。
【输入格式】
输入文件名为 math.in。
输入数据仅一行,包含两个正整数 a 和 b,它们之间用一个空格隔开,表示小凯手中金币的面值。
【输出格式】
输出文件名为 math.out。
输出文件仅一行,一个正整数 N,表示不找零的情况下,小凯用手中的金币不能准确支付的最贵的物品的价值。
【输入输出样例 1】
【输入输出样例 1 说明】
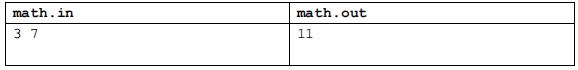
小凯手中有面值为3和 7的金币无数个,在不找零的前提下无法准确支付价值为 1、2、4、5、8、11 的物品,其中最贵的物品价值为 11,比 11 贵的物品都能买到,比如:
12 = 3 * 4 + 7 * 0
13 = 3 * 2 + 7 * 1
14 = 3 * 0 + 7 * 2
15 = 3 * 5 + 7 * 0
……
【数据规模与约定】
对于 30%的数据: 1 ≤ a,b ≤ 50。
对于 60%的数据: 1 ≤ a,b ≤ 10,000。
对于 100%的数据:1 ≤ a,b ≤ 1,000,000,000。
//#include<bits/stdc++.h>
#include<iostream>
#include<cstdio>
using namespace std;
int main(){
long long a,b;
scanf("%lld %lld",&a,&b);
printf("%lld",a*b-a-b);
return 0;
}
神奇的幻方
【问题描述】
幻方是一种很神奇的 N * N 矩阵:它由数字 1,2,3, … … , N * N 构成,且每行、每列及两条对角线上的数字之和都相同。
当 N 为奇数时,我们可以通过以下方法构建一个幻方:
首先将 1 写在第一行的中间。
之后,按如下方式从小到大依次填写每个数 K(K = 2,3, … , N * N) :
1. 若 (K − 1) 在第一行但不在最后一列,则将 K 填在最后一行, (K − 1) 所在列的右一列;
2. 若 (K − 1) 在最后一列但不在第一行,则将 K 填在第一列,(K − 1) 所在行的上一行;
3. 若 (K − 1) 在第一行最后一列,则将 K 填在 (K − 1) 的正下方;
4. 若 (K − 1) 既不在第一行,也不在最后一列,如果 (K − 1) 的右上方还未填数,
则将 K 填在(K − 1)的右上方,否则将 K 填在 (K − 1) 的正下方。现给定 N,请按上述方法构造 N * N 的幻方。
【输入格式】
输入文件名为 magic.in。
输入文件只有一行,包含一个整数 N,即幻方的大小。
【输出格式】
输出文件名为 magic.out。
输出文件包含 N 行,每行 N 个整数,即按上述方法构造出的 N * N 的幻方。相邻两个整数之间用单个空格隔开。
【输入输出样例 1】
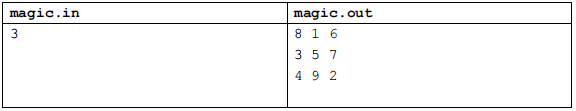
【数据规模与约定】
对于 100% 的数据,1 ≤ N ≤ 39 且 N 为奇数。
#include <iostream>
using namespace std;
const int N = 40;
int n;
int a[N][N];
int main() {
cin >> n;
int x = 1, y = n / 2 + 1;
for (int i = 1; i <= n * n; i++) {
a[x][y] = i;
if (x == 1 && y == n) x++;
else if (x == 1) x = n, y++;
else if (y == n) x--, y = 1;
else if (a[x - 1][y + 1]) x++;
else x--, y++;
}
for (int i = 1; i <= n; i++) {
for (int j = 1; j <= n; j++)printf("%d", a[i][j]);
puts("");
}
return 0;
}
斗地主
【问题描述】
牛牛最近迷上了一种叫斗地主的扑克游戏。斗地主是一种使用黑桃、红心、梅花、方片的 A 到 K 加上大小王的共 54 张牌来进行的扑克牌游戏。在斗地主中,牌的大小关系根据牌的数码表示如下:3<4<5<6<7<8<9<10<J<Q<K<A<2<小王<大王,而花色并不对牌的大小产生影响。每一局游戏中,一副手牌由 n 张牌组成。游戏者每次可以根据规定的牌型进行出牌,首先打光自己的手牌一方取得游戏的胜利。
现在,牛牛只想知道,对于自己的若干组手牌,分别最少需要多少次出牌可以将它们打光。请你帮他解决这个问题。
需要注意的是,本题中游戏者每次可以出手的牌型与一般的斗地主相似而略有不同。
具体规则如下:
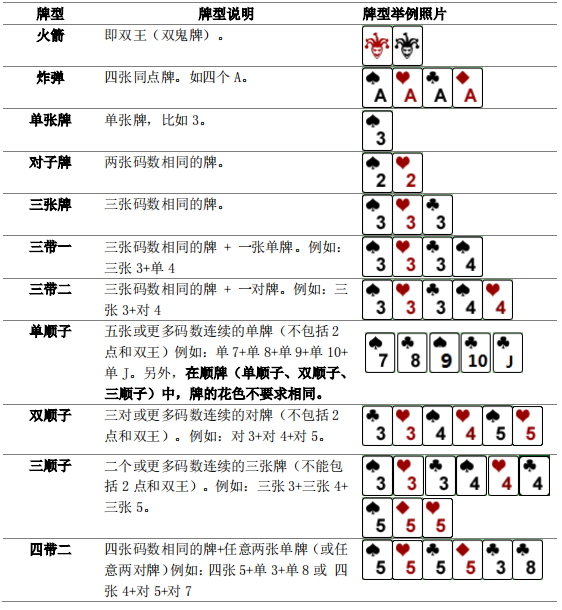
【输入格式】
输入文件名为 landlords.in。
第一行包含用空格隔开的 2 个正整数 T, n ,表示手牌的组数以及每组手牌的张数。
接下来 T 组数据,每组数据 n 行,每行一个非负整数对 ai, bi,表示一张牌,其中 ai表示牌的数码,bi 表示牌的花色,中间用空格隔开。特别的,我们用 1 来表示数码 A,11 表示数码 J,12 表示数码 Q,13 表示数码 K;黑桃、红心、梅花、方片分别用 1-4 来表示;小王的表示方法为 0 1,大王的表示方法为 0 2。
【输出格式】
输出文件名为 landlords.out。
共 T 行,每行一个整数,表示打光第i组手牌的最少次数。
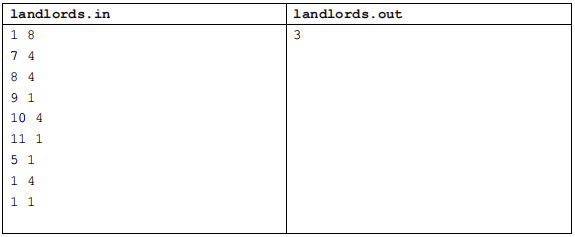
【输入输出样例 1】
【输入输出样例 1 说明】
共有 1 组手牌,包含 8 张牌:方片 7,方片 8,黑桃 9,方片 10,黑桃 J,黑桃 5,方片 A 以及黑桃 A。可以通过打单顺子(方片 7,方片 8,黑桃 9,方片 10,黑桃 J),单张牌(黑桃 5)以及对子牌(黑桃 A 以及方片 A)在 3 次内打光。
【输入输出样例 2】
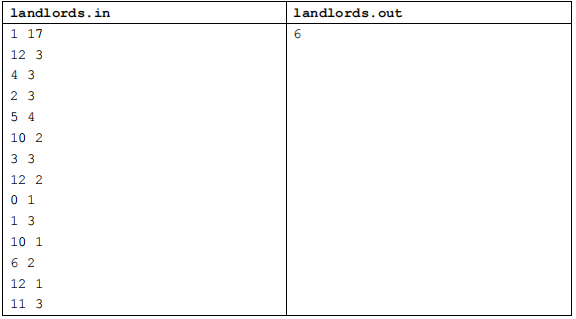
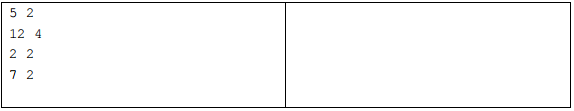
【数据规模与约定】
对于不同的测试点,我们约定手牌组数 T 与张数 n 的规模如下:
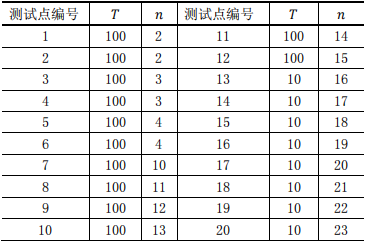
数据保证:所有的手牌都是随机生成的。
#include<iostream>
#include<cstdio>
#include<cstring>
using namespace std;
int T, n, ans, s[15];
void dfs(int shunzi) {
if (shunzi > ans) return ;//最优化剪枝
int i, j, s1 = 0, s2 = 0, s3 = 0, s4 = 0;
//非顺子
for (i = 1; i <= 14; i++)//单牌需出的次数
if (s[i] == 1) s1++;
for (i = 1; i <= 14; i++)//对牌需出的次数
if (s[i] == 2) s2++;
for (i = 1; i <= 14; i++) {//三带
if (s[i] == 3) {
s3++;
if (s1 >= 1) s1--;
else if (s2 >= 1) s2--;
}
}
for (i = 1; i <= 14; i++) {//四带
if (s[i] == 4) {
s4++;
if (s1 >= 2) s1 -= 2;
else {
if (s2 >= 2) s2 -= 2;
else if (s2 >= 1) s2--;
}
}
}
//取当前最优解
ans = min(ans, shunzi+s1+s2+s3+s4);
for (i = 1; i <= 8; i++) {//单顺
for (j = i; j <= 12; j++) {
s[j]--;
if (s[j]<0) break;
if (j-i >= 4) dfs(shunzi+1);
}
if (j == 13) j--;
while (j>=i) {
s[j]++;
j--;
}
}
for (i = 1; i <= 10; i++) {//双顺
for (j = i; j <= 12; j++) {
s[j] -= 2;
if (s[j]<0) break;
if (j-i >= 2) dfs(shunzi+1);
}
if (j == 13) j--;
while (j>=i) {
s[j] += 2;
j--;
}
}
for (i = 1; i <= 11; i++) {//三顺
for (j = i; j <= 12; j++) {
s[j] -= 3;
if (s[j]<0) break;
if (j-i >= 1) dfs(shunzi+1);
}
if (j == 13) j--;
while (j>=i) {
s[j] += 3;
j--;
}
}
return ;
}
int main() {
scanf("%d%d", &T, &n);
while (T--) {
memset(s, 0, sizeof(s));
int i, a, b;
ans = 54;
for (i = 1; i <= n; i++) {
scanf("%d%d", &a, &b);
if (a == 0) s[14]++;
if (a == 1) s[12]++;
if (a == 2) s[13]++;
if (a>=3) s[a-2]++;
}
dfs(0);
printf("%d\n", ans);
}
return 0;
}
同余方程
【问题描述】
求关于 x 的同余方程 ax ≡ 1 (mod b)的最小正整数解。
【输入】
输入文件为 mod.in。
输入只有一行,包含两个正整数 a, b,用一个空格隔开。
【输出】
输出文件为 mod.out。
输出只有一行,包含一个正整数 x0,即最小正整数解。输入数据保证一定有解。
【输入输出样例】
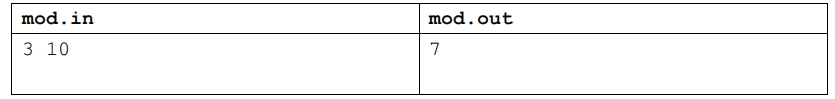
【数据范围】
对于 40%的数据,2 ≤b≤ 1,000;
对于 60%的数据,2 ≤b≤ 50,000,000;
对于 100%的数据,2 ≤a, b≤ 2,000,000,000。
#include <stdio.h>
long long a,b,x,y,k;
void exgcd(long long a,long long b)
{
if(b==0)
{
x=1;
y=0;
return;
}
exgcd(b,a%b);
long long int temp_x = x;
x=y;
y = temp_x - a/b *y;
return;
}
int main()
{
scanf("%lld %lld\n",&a,&b);
exgcd(a,b);
x = (x%b + b)%b;
printf("%lld\n",x);
return 0;
}
计算系数
【问题描述】
给定一个多项式 请求出多项式展开后
 项的系数。
【输入】
输入文件名为 factor.in。
共一行,包含 5 个整数,分别为 a,b,k,n,m,每两个整数之间用一个空格隔开。
【输出】
输出文件名为 factor.out。
输出共 1 行,包含一个整数,表示所求的系数,这个系数可能很大,输出对 10007 取模后的结果。
【输入输出样例】
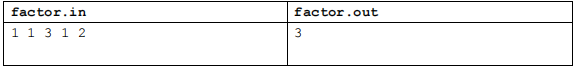
【数据范围】
对于 30%的数据,有 0≤k≤10;
对于 50%的数据,有 a = 1,b = 1;
对于 100%的数据,有 0≤k≤1,000,0≤n, m≤k,且 n + m = k,0≤a,b≤1,000,000。
#include<iostream>
using namespace std;
long long mod=10007;
long long Mood(long long a,long long b){
long long sum=1;
a%=mod;
while(b){
if(b&1)
sum=sum*a%mod;
a=a*a%mod;
b=b>>1;
}
return sum;
}
int a,b,k,n,m;
long long ans=0;
int main(){
cin>>a>>b>>k>>n>>m;
ans=Mood(a,n)*Mood(b,m)%mod;
for(int i=1,j=k;i<=n;i++,j--){//逆元
ans=ans*j%mod;
ans=ans*Mood(i,mod-2)%mod;
}
cout<<ans<<endl;
return 0;
}