信息学奥赛-提高级 题库
贪吃蛇(snakes)
【题目描述】
草原上有 n 条蛇,编号分别为 1,2, ⋯ , n。初始时每条蛇有一个体力值ai,我们称编号为 x 的蛇实力比编号为 y 的蛇强当且仅当它们当前的体力值满足 ax > ay,或者 ax = ay 且 x > y。
接下来这些蛇将进行决斗,决斗将持续若干轮,每一轮实力最强的蛇拥有选择权,可以选择吃或者不吃掉实力最弱的蛇:
1. 如果选择吃,那么实力最强的蛇的体力值将减去实力最弱的蛇的体力值,实力最弱的蛇被吃掉,退出接下来的决斗。之后开始下一轮决斗。
2. 如果选择不吃,决斗立刻结束。
每条蛇希望在自己不被吃的前提下在决斗中尽可能多吃别的蛇(显然,蛇不会选择吃自己)。
现在假设每条蛇都足够聪明,请你求出决斗结束后会剩几条蛇。
本题有多组数据,对于第一组数据,每条蛇体力会全部由输入给出,之后的每一组数据,会相对于上一组的数据,修改一部分蛇的体力作为新的输入。
【输入格式】
输入文件名为 snakes.in。
第一行一个正整数 T,表示数据组数。
接下来有 T 组数据,对于第 1 组数据,第一行一个正整数 n,第二行 n个非负整数表示 ai。
对于第 2 组到第 T 组数据,每组数据:
第一行第一个非负整数 k 表示体力修改的蛇的个数。
第二行 2k 个整数,每两个整数组成一个二元组 (x, y),表示依次将 ax的值改为 y。一个位置可能被修改多次,以最后一次修改为准。
【输出格式】
输入文件名为 snakes.out。
输出 T 行,每行一个整数表示最终存活的蛇的条数。
【样例 1 输入】
2
3
11 14 14
3
1 5 2 6 3 25
【样例 1 输出】
3
1
【样例 1 解释】
第一组数据,第一轮中 3 号蛇最强,1 号蛇最弱。若 3 号蛇选择吃,那么它将在第二轮被 2 号蛇吃掉。因此 3 号蛇第一轮选择不吃,3 条蛇都将存活。
对于第二组数据,3 条蛇体力变为 5,6,25。第一轮中 3 号蛇最强,1 号蛇最弱,若它选择吃,那么 3 号蛇体力值变为 20,在第二轮中依然是最强蛇并能吃掉 2 号蛇,因此 3 号蛇会选择两轮都吃,最终只有 1 条蛇存活。
【样例 2 输入】
2
5
13 31 33 39 42
5
1 7 2 10 3 24 4 48 5 50
【样例 2 输出】
5
3
【数据范围与提示】
对于 20%的数据:n = 3。
对于 40%的数据:n ≤ 10。
对于 55%的数据:n ≤ 2000。
对于 70%的数据:n ≤ 5 × 10^4。
对于 100%的数据:3 ≤ n ≤ 10^6,1 ≤ T ≤ 10,0 ≤ k ≤ 10^5,0 ≤ ai, y ≤10^9。
保证每组数据(包括所有修改完成后的)的 ai 以不降顺序排列。
#include<iostream>
#include<cstdio>
#include<queue>
using namespace std;
const int N=1e6+100,INF=1e9;
struct Node
{
int val,num;
#define val(i) a[i].val
#define num(i) a[i].num
bool operator < (const Node y)
{
return val==y.val?num<y.num:val<y.val;
}
bool operator == (const Node y)
{
return val==y.val && num==y.num;
}
}a[N];
int T,n,k,ph,pb;
queue<Node> q;
Node blank={0,0},black={INF,INF};
Node Max(Node x,Node y)
{
return (x<y)?y:x;
}
Node Min(Node x,Node y)
{
return (x<y)?x:y;
}
bool query(Node la)
{
int cnt=0;
Node bk=Min(pb<ph?a[pb+1]:black,q.size()?q.back():black);
while(1)
{
Node hd=Max(pb<ph?a[ph]:blank,q.size()?q.front():blank);
if(a[ph]==hd)
ph--;
else
if(q.size())
q.pop();
if(hd==bk)
break;
hd.val-=la.val;
if(bk<hd)
break;
la=hd;cnt++;
}
return cnt&1;
}
int main()
{
scanf("%d",&T);
for(int i=1;i<=T;i++)
{
if(i==1)
{
scanf("%d",&n);
for(int j=1;j<=n;j++)
scanf("%d",&val(j)),num(j)=j;
}
else
{
scanf("%d",&k);
for(int j=1,x,y;j<=k;j++)
{
scanf("%d%d",&x,&y);
val(x)=y;
}
}
ph=n,pb=1;
while(q.size())
q.pop();
while(pb<=ph)
{
Node x=Max((ph>pb)?a[ph]:blank,q.size()?q.front():blank);
if(a[ph]==x)
ph--;
else
q.pop();
x.val-=val(pb);
if(x<a[pb+1] && n-pb>1)
{
if(query(x))
pb++;
break;
}
q.push(x);pb++;
}
printf("%d\n",n-pb+1);
}
return 0;
}
格雷码
【题目描述】
通常,人们习惯将所有n位二进制串按照字典序排列,例如所有2位二进制串按 字典序从小到大排列为:00, 01, 10, 11
格雷码(Gray Code)是一种特殊的n位二进制串排列法,它要求相邻的两个二进 制串间恰好有一位不同.特别地,第一个串与最后一个串也算作相邻。
所有2位二进制串按格雷码排列的一个例子为:00, 01, 11, 10。
n位格雷码不止一种,下面给出其中一种格雷码的生成算法:
1.1位格雷码由两个1位二进制串组成,顺序为:0, 1。
2.n + 1位格雷码的前2^n个二进制串,可以由依此算法生成的n位格雷码(总共 2^n个n位二进制串)按顺序排列,再在每个串前加一个前缀0构成。
3.n + 1位格雷码的后2^n个二进制串,可以由依此算法生成的n位格雷码(总共 2^n个n位二进制串)按逆序排列,再在每个串前加一个前缀1构成。
综上,n + 1位格雷码,由n位格雷码的2^n个二进制串按顺序排列再加前缀0,和 按逆序排列再加前缀1构成,共2^n+1个二进制串。另外,对于n位格雷码中的2^n个 二进制串,我们按上述算法得到的排列顺序将它们从0~2^n - 1编号。
按该算法,2位格雷码可以这样推出:
1.己知1位格雷码为0, 1
2.前两个格雷码为00, 01.后两个格雷码为11, 10。合并得到00, 01, 11, 10, 编号依次为0〜3。
同理,3位格雷码可以这样推出:
1.己知2位格雷码为:00, 01, 11 10。
2.前四个格雷码为:000, 001, 011.010。后四个格雷码为:110, 111, 101, 100。合并得到:000, 001. 011, 010, 110, 111. 101, 100,编号依次为 0 ~7。
现在给出n,k请你求出按上述算法生成的n位格雷码中的k号二进制串。
【输入格式】
从文件code.in中读入数据。
仅一行两个整数n,k意义见题目描述。
【输出格式】
输出到文件code.out中。
仅一行一个n位二进制串表示答案。
【样例1输入】
23
【样例1输出】
10
【样例1解释】
2位格雷码为:00, 01, 11. 10,编号从0〜3,因此3号串是10。
【样例2输入】
35
【样例2输出】
111
【样例2解释】
3 位格雷码为:000, 001. 011, 010, 110, 111. 101, 100,编号从 0 〜7,因此 5 号串是111。
【数据范围】
对于50%的数据:n≤ 10
对于80%的数据:k≤5x10^6
对于95%的数据:k≤ 2^63 - 1
对于 100% 的数据:1 ≤ n ≤ 64,0 ≤ k≤2^n
#include<bits/stdc++.h>
using namespace std;
int main()
{
int n;
unsigned long long k;
cin>>n>>k;
unsigned long long s;
for(int i=n;i>=1;i--)
{
s=pow(2,i);
if(k>=(s/2))
{
k=s-k-1;
printf("1");
}
else
printf("0");
}
return 0;
}
括号树
【题目背景】
本题中合法括号串的定义如下:
1.0是合法括号串。
2.如果A是合法括号串,则(A)是合法括号串。
3.如果A, B是合法括号串,则AB是合法括号串。
本题中子串与不同的子串的定义如下:
1.字符串S的子串是S中连续的任意个字符组成的字符串。S的子串可用起始位置l与终止位置r来表示,记为S(l,r)(1≤l≤r≤|S|,|S|表示S的长度)。
2.S的两个子串视作不同当且仅当它们在S中的位置不同,即l不同或r不同。
【题目描述】
一个大小为n的树包含n个结点和n-1条边,每条边连接两个结点,且任意两个 结点间有且仅有一条简单路径互相可达。
小Q是一个充满好奇心的小朋友,有一天他在上学的路上碰见了一个大小为n的 树,树上结点从1~n编号,1号结点为树的根。除1号结点外,每个结点有一个父亲 结点,u (2≤ u≤n)号结点的父亲为fu (1 ≤ fu < u)号结点。
小Q发现这个树的每个结点上恰有一个括号,可能是'('或')'。小Q定义si为:将 根结点到i号结点的简单路径上的括号,按结点经过顺序依次排列组成的字符串。
显然si是个括号串,但不一定是合法括号串,因此现在小Q想对所有的i(1≤i≤n) 求岀,si中有多少个互不相同的子串是合法括号串。
这个问题难倒了小Q,他只好向你求助。设si共有ki个不同子串是合法括号串, 你只需要告诉小Q所有ixki的异或和,即:
(1 x k1) xor (2 x k2) xor (3 x k3)xor .…xor (n x kn)其中xor是位异或运算。
【输入格式】
从文件brackets.in中读入数据。
第一行一个整数n,表示树的大小。
第二行一个长为n的由'('与')'组成的括号串,第i个括号表示i号结点上的括号。
第三行包含n-1个整数,第i(1≤i<n)个整数表示i+1号结点的父亲编号fi+1。
【输出格式】
输出到文件brackets.out中。
仅一行一个整数表示答案。
【样例1输入】
5
(()()
1 1 2 2
【样例1输出】
6
【样例1解释】
树的形态如下图:
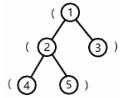
将根到1号结点的简单路径上的括号,按经过顺序排列所组成的字符串为(,子串 是合法括号串的个数为0。
将根到2号结点的简单路径上的括号,按经过顺序排列所组成的字符串为((,子 串是合法括号串的个数为0。
将根到3号结点的简单路径上的括号,按经过顺序排列所组成的字符串为(),子 串是合法括号串的个数为1。
将根到4号结点的简单路径上的括号,按经过顺序排列所组成的字符串为(((,子 串是合法括号串的个数为0。
将根到5号结点的简单路径上的括号,按经过顺序排列所组成的字符串为((),子 串是合法括号串的个数为1。
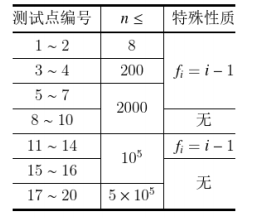
【数据范围】
#include <iostream>
#include <cstdio>
#include <vector>
#include <stack>
typedef long long ll;
const int maxn = 500005;
std :: vector <int> G[maxn];
std :: stack <int> bra;
char str[maxn];
int fa[maxn];
ll con[maxn], k[maxn];
void dfs(int u) {
int num = 0;
if (str[u] == '(')
bra.push(u);
else if (!bra.empty()){
num = bra.top();
bra.pop();
con[u] = con[fa[num]] + 1;
}
k[u] = k[fa[u]] + con[u];
for (int i = 0; i < G[u].size(); ++i)
dfs(G[u][i]);
if (num != 0)
bra.push(num);
else if (!bra.empty())
bra.pop();
return ;
}
int main() {
int n;
std :: scanf("%d", &n);
std :: scanf("%s", str + 1);
for (int i = 2; i <= n; ++i) {
std :: scanf("%d", &fa[i]);
G[fa[i]].push_back(i);
}
ll ans = 0;
dfs(1);
for (int i = 1; i <= n; ++i)
ans ^= k[i] * (ll)i;
std :: printf("%lld\n", ans);
return 0;
}
树上的数
【题目描述】
给定一个大小为n的树,它共有n个结点与n-1条边,结点从1~n编号。初始 时每个结点上都有一个1~n的数字,且每个1~n的数字都只在恰好一个结点上出现。
接下来你需要进行恰好n-1次删边操作,每次操作你需要选一条未被删去的边, 此时这条边所连接的两个结点上的数字将会交换.然后这条边将被删去。
n-1次操作过后,所有的边都将被删去。此时,按数字从小到大的顺序,将数字 1~n所在的结点编号依次排列,就得到一个结点编号的排列Pi。现在请你求出,在最 优操作方案下能得到的字典序最小的Pi。
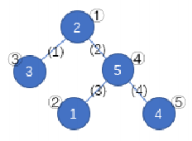
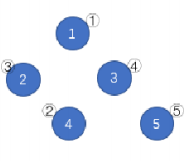
如上图,蓝圈中的数字1〜5 一开始分别在结点②、①、③、⑤、④。按照⑴⑷(3)⑵ 的顺序删去所有边,树变为下图。按数字顺序得到的结点编号排列为 ①③④②⑤,该 排列是所有可能的结果中字典序最小的。
【输入格式】
从文件tree.in中读入数据。
本题输入包含多组测试数据。
第一行一个正整数T,表示数据组数。
对于每组测试数据:
第一行一个整数n,表示树的大小。
第二行n个整数,第i (1≤i≤ n)个整数表示数字i初始时所在的结点编号。 接下来n-1行每行两个整数x,y,表示一条连接x号结点与y号结点的边。
【输出格式】
输出到文件tree.out中。
对于每组测试数据,输出一行共n个用空格隔开的整数,表示最优操作方案下所 能得到的字典序最小的Pi。
【样例1输入】
4
5
2 1 3 5 4
1 3
1 4
2 4
4 5
5
3 4 2 1 5
1 2
2 3
3 4
4 5
5
1 2 5 3 4
1 2
1 3
1 4
1 5
10
1 2 3 4 5 7 8 9 10 6
1 2
1 3
1 4
1 5
5 6
6 7
7 8
8 9
9 10
【样例1输出】
1 3 4 2 5
1 3 5 2 4
2 3 1 4 5
2 3 4 5 6 1 7 8 9 10
【数据范围】
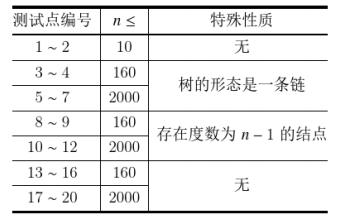
对于所有测试点:1 ≤ T ≤ 10,保证给出的是一个树。
#include<cstdio>
#include<vector>
using namespace std;
#define rep(i,__l,__r) for(int i=__l,i##_end_=__r;i<=i##_end_;++i)
#define fep(i,__l,__r) for(int i=__l,i##_end_=__r;i>=i##_end_;--i)
#define writc(a,b) fwrit(a),putchar(b)
#define mp(a,b) make_pair(a,b)
#define ft first
#define sd second
#define LL long long
#define ull unsigned long long
#define pii pair<int,int>
// #define FILEOI
#define cg (c=getchar())
template<class T>inline void qread(T& x){
char c;bool f=0;
while(cg<'0'||'9'<c)if(c=='-')f=1;
for(x=(c^48);'0'<=cg&&c<='9';x=(x<<1)+(x<<3)+(c^48));
if(f)x=-x;
}
inline int qread(){
int x=0;char c;bool f=0;
while(cg<'0'||'9'<c)if(c=='-')f=-1;
for(x=(c^48);'0'<=cg&&c<='9';x=(x<<1)+(x<<3)+(c^48));
return f?-x:x;
}
#undef cg
template<class T,class... Args>inline void qread(T& x,Args&... args){qread(x),qread(args...);}
template<class T>inline T Max(const T x,const T y){return x>y?x:y;}
template<class T>inline T Min(const T x,const T y){return x<y?x:y;}
template<class T>inline T fab(const T x){return x>0?x:-x;}
inline void getInv(int inv[],const int lim,const int MOD){
inv[0]=inv[1]=1;for(int i=2;i<=lim;++i)inv[i]=1ll*inv[MOD%i]*(MOD-MOD/i)%MOD;
}
template<class T>void fwrit(const T x){
if(x<0)return (void)(putchar('-'),fwrit(-x));
if(x>9)fwrit(x/10);putchar(x%10^48);
}
const int MAXN=2000;
struct edge{
int to,nxt;
edge(){}
edge(const int T,const int N):to(T),nxt(N){}
}e[(MAXN<<1)+5];
int tail[MAXN+5],ecnt,siz[MAXN+5];
inline void add_edge(const int u,const int v){
++siz[u],++siz[v];
e[++ecnt]=edge(v,tail[u]);tail[u]=ecnt;
e[++ecnt]=edge(u,tail[v]);tail[v]=ecnt;
}
int N,minp;
int pt[MAXN+5];
int pre[MAXN+5][MAXN+5],nxt[MAXN+5][MAXN+5];
//这条边的 前驱,后继
int rt[MAXN+5][MAXN+5][2];
//点 u 的某一条边的 前根节点、后根节点
int len[MAXN+5][MAXN+5];
//这条边 所在链 的链表长度
inline void init(){
qread(N);
ecnt=0;
rep(i,1,N)qread(pt[i]),tail[i]=siz[i]=0;
rep(i,1,N+1)rep(j,1,N+1)len[i][j]=pre[i][j]=nxt[i][j]=rt[i][j][0]=rt[i][j][1]=0;
int u,v;
rep(i,1,N-1){
qread(u,v);
add_edge(u,v);
pre[u][v]=pre[v][u]=nxt[u][v]=nxt[v][u]=0;
rt[u][v][0]=rt[u][v][1]=v;
rt[v][u][0]=rt[v][u][1]=u;
len[u][v]=len[v][u]=1;
}
}
void findPath(const int u,const int p){//当前节点、前一个节点
int a=rt[u][p][0],b=rt[u][p][1],ta,tb;
//a:来的边的前根 ; b:来的边的后根
if(p==N+1){//这是起点
for(int i=tail[u],v;i;i=e[i].nxt){//从哪条边起飞
v=e[i].to;
ta=rt[u][v][0],tb=rt[u][v][1];
if(ta!=v || (pre[u][p]==tb && len[u][ta]<siz[u]))
//条件一:如果这条边已经有一个起点且不是自己
//条件二:如果后面的那条边已经连接尾端, 且这条链的长度无法满足将所有边连起来
continue;//那么就不能把 边{u,p} 与 边{u,v} 连在一起
findPath(v,u);//否则可行
}
}
else{
if(p==b){//如果 边{u,p} 的后面还暂时没有指定必须删哪一条边, 那么就可以考虑枚举一条边接在后面
if(pre[u][N+1]==0 && (nxt[u][N+1]!=a || len[u][a]==siz[u]))//则可以考虑在点 u 进行降落, 满足以下条件:
//如果这个点的末删边还没有被指定(必须满足)
//并且:
//1.如果这条链接上开头,那么如果必须满足所有的边都在这条链上
//2.如果没有接上开头,那么长度随意
minp=Min(minp,u);//如果满足, 则 u 可以作为一个降落点
for(int i=tail[u],v;i;i=e[i].nxt){//假定 u 为一个中转点, 则再枚举一条边作为 边{u,p} 的出边,与其尾相连
v=e[i].to;
ta=rt[u][v][0],tb=rt[u][v][1];
if(a==ta || ta!=v || nxt[u][N+1]==v)//第一种大情况
//如果这两条边已经在同一条链上
//或者这个边不是一个起始边, 即枚举边的前面还有东西
//或者枚举边是一条起飞边, 即保证它是所有对于 u 的边必须最先删除的边
continue;//那么 当前 边{u,p} 都不能接在这条枚举边之上
if(nxt[u][N+1]==a && pre[u][N+1]==tb && len[u][a]+len[u][ta]<siz[u])
//如果这两条边分别属于这个点 最先删除、最后删除 的链表上的 尾、头
//那么它们组合起来必须等于所有边的数量之和
//否则, 这就是 提前自闭 的情况
continue;
findPath(v,u);//如果以上都不满足, 那么这条边是合法的
}
}
else findPath(nxt[u][p],u);//否则我们只能按照之前的规定访问这条边
}
}
inline void merge(const int u,const int a,const int b){
//函数条件:以 a 所在的链表为前链表
//并且满足 a 是前链表尾, b 是后链表头
int ta=rt[u][a][0],tb=rt[u][b][1];
nxt[u][a]=b;
pre[u][b]=a;
for(int i=ta;i && i!=N+1;i=nxt[u][i]){
//访问链表的基本操作
//更新每个点的前根、后根
rt[u][i][0]=ta;
rt[u][i][1]=tb;
}
len[u][ta]+=len[u][b];
}
bool getMark(const int u,const int p){//还原路径, 并且给路径打上标记
//如果这条路径找到终点, 返回 1, 否则返回 0
if(u==minp){//如果找到了终点
pre[u][N+1]=p;//把这条边设为最后删除的边
nxt[u][p]=N+1;//并且把这条边的下一条边标记为 N+1, 表示这条边是最后删除的
return 1;
}
int a=rt[u][p][0],b=rt[u][p][1],ta,tb;
if(p==N+1){//这是起飞点
for(int i=tail[u],v;i;i=e[i].nxt){
v=e[i].to;
ta=rt[u][v][0],tb=rt[u][v][1];
if(ta!=v || (pre[u][N+1]==tb && len[u][ta]<siz[u]))
//如果枚举边前面有东西, 那么这肯定不能接在起始边的后面, 因为它前面已经有个什么 逼 了
//或者是枚举边连接到末尾, 但是这条单链长度不够将所有的边包含到链里面
continue;//那么这条边肯定不在路径上面, 可直接跳过
if(getMark(v,u)){//如果这就是正确的路径
nxt[u][N+1]=v;//因为 u 点是起飞点, 所以把这条边记录为 u 的起飞边
pre[u][v]=N+1;//同时标记这条边的前驱, 与前面的 if 相互呼应(这不是语文...)
return 1;
}
}
}
else{//如果点 u 是中转点, 那么考虑枚举中转边
if(p==b){//如果这条边在链上后面没有其他边的时候
for(int i=tail[u],v;i;i=e[i].nxt){
v=e[i].to;
ta=rt[u][v][0],tb=rt[u][v][1];
if(a==ta || ta!=v || nxt[u][N+1]==v)//参考 findPath() 中相同位置的注释
continue;
if(nxt[u][N+1]==a && pre[u][N+1]==tb && len[u][a]+len[u][ta]<siz[u])//同样参考 findPath() 中同样位置
continue;
if(getMark(v,u)){
merge(u,p,v);//把链表合并为一个
return 1;
}
}
}
else getMark(nxt[u][p],u);
}
return 0;
}
signed main(){
#ifdef FILEOI
freopen("rdata.out","r",stdin);
freopen("file.out","w",stdout);
#endif
int T=qread();
while(T--){
init();
if(N==1){
writc(1,'\n');
continue;
}
rep(i,1,N){
minp=N+1;
findPath(pt[i],N+1);
// printf("%d\n",minp);
getMark(pt[i],N+1);
writc(minp,' ');
}
putchar('\n');
}
return 0;
}
Emiya家今天的饭
【题目描述】
Emiya 是个擅长做菜的高中生,他共掌握 n 种烹饪方法,且会使用 m 种主要食材做菜。为了方便叙述,我们对烹饪方法从 1~n 编号,对主要食材从 1 ~m 编号。
Emiya 做的每道菜都将使用恰好一种烹饪方法与恰好一种主要食材。更具体地,Emiya 会做 ai,j 道不同的使用烹饪方法 i 和主要食材 j 的菜(1 ≤i≤n,1≤j≤m),这也意味着 Emiya 总共会做
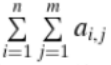 道不同的菜。
Emiya 今天要准备一桌饭招待 Yazid 和 Rin 这对好朋友,然而三个人对菜的搭配有不同的要求,更具体地,对于一种包含 k 道菜的搭配方案而言:
(1)Emiya 不会让大家饿肚子,所以将做至少一道菜,即 k≥1
(2)Rin 希望品尝不同烹饪方法做出的菜,因此她要求每道菜的烹饪方法互不相同
(3)Yazid 不希望品尝太多同一食材做出的菜,因此他要求每种主要食材至多在一半的菜(即 道菜)中被使用
这里的⌊x⌋ 为下取整函数,表示不超过 x 的最大整数。
这些要求难不倒 Emiya,但他想知道共有多少种不同的符合要求的搭配方案。两种方案不同,当且仅当存在至少一道菜在一种方案中出现,而不在另一种方案中出现。
Emiya 找到了你,请你帮他计算,你只需要告诉他符合所有要求的搭配方案数对质数998,244,353 取模的结果。
【输入格式】
从文件meal.in中读入数据。
第 1 行两个用单个空格隔开的整数 n,m。
第 2 行至第 n+1 行,每行 m 个用单个空格隔开的整数,其中第 i + 1行的 m 个数依次为 ai,1,ai,2,⋯,ai,m。
【输出格式】
输出到文件meal.out中。
仅一行一个整数,表示所求方案数对 998,244,353 取模的结果。
【样例 1 输入】
2 3
1 0 1
0 1 1
【样例 1 输出】
3
【样例1解释】
由于在这个样例中,对于每组i,j,Emiya都最多只会做一道菜,因此我们直接通 过给出烹饪方法、主要食材的编号来描述一道菜。
符合要求的方案包括:
•做一道用烹饪方法1、主要食材1的菜和一道用烹饪方法2、主要食材2的菜
•做一道用烹饪方法1、主要食材1的菜和一道用烹饪方法2、主要食材3的菜
•做一道用烹饪方法1、主要食材3的菜和一道用烹饪方法2、主要食材2的菜
因此输出结果为3 mod 998,244,353 = 3。
需要注意的是,所有只包含一道菜的方案都是不符合要求的,因为唯一的主要食材 在超过一半的菜中出现,这不满足Yazid的要求。
【样例2输入】
3 3
1 2 3
4 5 0
6 0 0
【样例2输出】
190
【样例2解释】
Emiya必须至少做2道菜。
做2道菜的符合要求的方案数为100。
做3道菜的符合要求的方案数为90。
因此符合要求的方案数为100 + 90 = 190。
【样例3输入】
5 5
1 0 0 1 1
0 1 0 1 0
1 1 1 1 0
1 0 1 0 1
0 1 1 0 1
【样例3输出】
742
【数据范围】
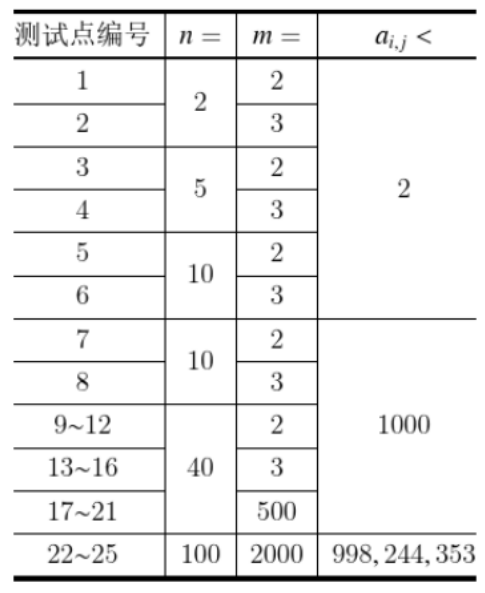
对于所有测试点,保证 1 ≤n≤ 100, 1 ≤ m ≤ 2000, 0≤ai,j< 998,244,353。
#include <iostream>
#include <cstdlib>
#include <cstring>
#include <cstdio>
#define mod 998244353
using namespace std;
typedef long long ll;
const int MAXN = 105, MAXM = 2005;
int n,m,a[MAXN][MAXM],sum[MAXN][MAXM];
ll f[MAXN][MAXN*2],g[MAXN][MAXN];
int main()
{
cin >> n >> m;
for(int i = 1; i<=n; i++)
for(int j = 1; j<=m; j++)
{
scanf("%d",&a[i][j]);
sum[i][0] = (sum[i][0]+a[i][j])%mod;
}
for(int i = 1; i<=n; i++)
for(int j = 1; j<=m; j++)
sum[i][j] = (sum[i][0]-a[i][j]+mod)%mod;
ll ans = 0;
for(int col = 1; col<=m; col++)
{
memset(f,0,sizeof(f));
f[0][n] = 1;
for(int i = 1; i<=n; i++)
for(int j = n-i; j<=n+i; j++)
f[i][j] = (f[i-1][j]+f[i-1][j-1]*a[i][col]%mod+f[i-1][j+1]*sum[i][col]%mod)%mod;
for(int j = 1; j<=n; j++)
ans = (ans+f[n][n+j])%mod;
}
g[0][0] = 1;
for(int i = 1; i<=n; i++)
for(int j = 0; j<=n; j++)
g[i][j] = (g[i-1][j]+(j>0?g[i-1][j-1]*sum[i][0]%mod:0))%mod;
for(int j = 1; j<=n; j++)
ans = (ans-g[n][j]+mod)%mod;
cout << ans*(mod-1)%mod << endl;
return 0;
}
划分
【题目描述】
2048年,第三十届CSP认证的考场上,作为选手的小明打开了第一题。这个题的 样例有n组数据,数据从1~n编号,i号数据的规模为ai。
小明对该题设计出了一个暴力程序,对于一组规模为u的数据,该程序的运行时 间为u^2。然而这个程序运行完一组规模为u的数据之后,它将在任何一组规模小于u 的数据上运行错误。样例中的ai,不一定递增,但小明又想在不修改程序的情况下正确 运行样例,于是小明决定使用一种非常原始的解决方案:将所有数据划分成若干个数据 段,段内数据编号连续,接着将同一段内的数据合并成新数据,其规模等于段内原数据 的规模之和.小明将让新数据的规模能够递增。
也就是说,小明需要找到一些分界点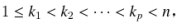 使得
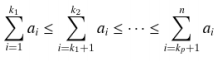
注意P可以为0且此时k0 = 0,也就是小明可以将所有数据合并在一起运行。
小明希望他的程序在正确运行样例情况下,运行时间也能尽量小,也就是最小化
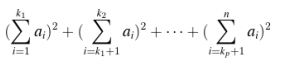
小明觉得这个问题非常有趣,并向你请教:给定n和ai,请你求出最优划分方案 下,小明的程序的最小运行时间。
【输入格式】
从文件partition.in中读入数据。
由于本题的数据范围较大,部分测试点的ai将在程序内生成。
第一行两个整数n.type. n的意义见题目描述,type表示输入方式。
1.若type = 0.则该测试点的ai直接给出。输入文件接下来:第二行n个以空格 分隔的整数ai,表示每组数据的规模。
2.若type = 1则该测试点的ai将特殊生成,生成方式见后文。输入文件接下来: 第二行六个以空格分隔的整数x,y,z,b1,b2,m。 接下来m行中,第i 行包含三个以空格分隔的正整数pi,li,ri。
对于type = 1的23 ~ 25号测试点,ai的生成方式如下:
给定整数x,y,z,b1,b2,m,以及m个三元组(pi,li,ri)。
保证 n 2。 若 n > 2,则
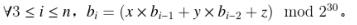
保证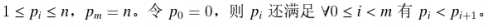
对于所有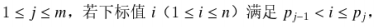 则有ai=(bi mod(rj-lj+1))+lj
上述数据生成方式仅是为了减少输入量大小,标准算法不依赖于该生成方式。
【输出格式】
输出到文件partition.out中。
输出一行一个整数,表示答案。
【样例1输入】
5 0
5 17 9 9
【样例1输出】
247
【样例1解释】
最优的划分方案为{5,1},{7},{9},{9}。由5 + 1<=7<=9<=9知该方案合法。
答案为(5 + 1)^2 + 7^2 + 9^2 + 9^2 = 247。
虽然划分方案{5},{1},{7},{9},{9}对应的运行时间比247小,但它不是一组合法 方案,因为5>1。
虽然划分方案{5},{1,7},{9},{9}合法,但该方案对应的运行时间为251,比247大。
【样例2输入】
10 0
5677462 13 19 9
【样例2输出】
1256
【样例2解释】
最优的划分方案为{5},{6},{7},{7},{4,6,2},{13},{19,9}。
【数据范围】
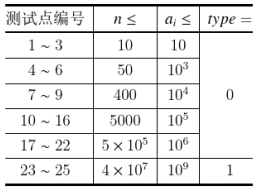
所有测试点满足:type € {0,1} , 2 < =n <= 4 x 10^7 , 1 < =ai,<= 10^9 , 1 <=m < =10^5 , 1 < =li <= ri <= 10^9 , 0 < x,y,z,b1,b2 < 2^30。
#include<bits/stdc++.h>
using namespace std ;
const int N = 4e7 + 10 ;
const int M = 1e5 + 10 ;
const int mod = (1 << 30) ;
int n , type , x , y , z , m ;
int a[N] , b[N] , p[M] , l[M] , r[M] , q[N] , pre[N] ;
long long sum[N] ;
inline long long d(int x) { return sum[x] - sum[pre[x]] ; }
signed main() {
ios :: sync_with_stdio(false) ; cin.tie(nullptr) ; cout.tie(nullptr) ;
cin >> n >> type ;
if(type) {
cin >> x >> y >> z >> b[1] >> b[2] >> m ;
for(register int i = 1 ; i <= m ; i ++) { cin >> p[i] >> l[i] >> r[i] ; }
for(register int i = 3 ; i <= n ; i ++) { b[i] = (0ll + 1ll * b[i - 1] * x + 1ll * b[i - 2] * y + z) % mod ; }
for(register int i = 1 ; i <= m ; i ++)
for(register int j = p[i - 1] + 1 ; j <= p[i] ; j ++) { a[j] = (b[j] % (r[i] - l[i] + 1)) + l[i] ; sum[j] = sum[j - 1] + a[j] ; }
}
else {
for(register int i = 1 ; i <= n ; i ++) { cin >> a[i] ; sum[i] = sum[i - 1] + a[i] ; }
} int h , t ; q[h = t = 0] = 0 ;
for(register int i = 1 ; i <= n ; i ++) {
while(h < t && d(q[h + 1]) + sum[q[h + 1]] <= sum[i]) ++ h ;
pre[i] = q[h] ;
while(h < t && d(q[t]) + sum[q[t]] >= d(i) + sum[i]) -- t ;
q[++ t] = i ;
} int now = n ; __int128 ans = 0 , tmp = 1 ;
while(now) { tmp = d(now) ; tmp *= d(now) ; ans += tmp ; now = pre[now] ; }
int st[50] , tp = 0 ;
while(ans) { st[++ tp] = ans % 10 ; ans /= 10 ; }
while(tp) { cout << st[tp --] ; }
return 0 ;
}
树的重心
小简单正在学习离散数学,今天的内容是图论基础,在课上他做了如下两条笔记:
1.一个大小为n的树由n个结点与n-1条无向边构成,且满足任意两个结点间有 且仅有一条简单路径。在树中删去一个结点及与它关联的边,树将分裂为若干个 子树;而在树中删去一条边(保留关联结点,下同),树将分裂为恰好两个子树。
2.对于一个大小为n的树与任意一个树中结点c,称c是该树的重心当且仅当在树 中删去c及与它关联的边后,分裂出的所有子树的大小均不超过 (其中Lx」 是下取整函数)。对于包含至少一个结点的树.它的重心只可能有1或2个。
课后老师给出了一个大小为n的树S,树中结点从1~n编号。小简单的课后作业 是求出S单独删去每条边后,分裂出的两个子树的重心编号和之和。即:
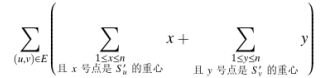
上式中,E表示树S的边集,(u,n)表示一条连接u号点和V号点的边。S'u与S'v 分别表示树S删去边(u,v)后,u号点与V号点所在的被分裂出的子树。
小简单觉得作业并不简单,只好向你求助,请你教教他。
【输入格式】
从文件centroid.in中读入数据。
本题输入包含多组测试数据。
第一行一个整数T表示数据组数。
接下来依次给岀每组输入数据,对于每组数据:
第一行一个整数n表示树S的大小。
接下来n -1行,每行两个以空格分隔的整数 ui,vi,表示树中的一条边(ui,vi)。
【输出格式】
输出到文件centroid.out中。
共T行,每行一个整数.第i行的整数表示:第i组数据给岀的树单独删去每条边 后,分裂出的两个子树的重心编号和之和。
【样例1输入】
2
5
12
23
24
35
7
1 2
1 3
1 4
3 5
3 6
6 7
【样例1输出】
32
56
【样例1解释】
对于第一组数据:
删去边(1,2), 1号点所在子树重心编号为{1}, 2号点所在子树重心编号为{2,3}。 删去边(2,3), 2号点所在子树重心编号为⑵,3号点所在子树重心编号为{3,5}。
删去边(2,4), 2号点所在子树重心编号为{2,3}, 4号点所在子树重心编号为{4}。 删去边(3,5), 3号点所在子树重心编号为{2}, 5号点所在子树重心编号为{5}。
因此答案为 1 + 2 + 3 + 2 + 3 + 5 + 2 + 3 + 4 + 2 + 5 = 32。
【数据范围】
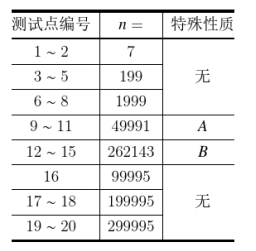
表中特殊性质一栏,两个变量的含义为存在一个1~n的排列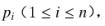 使得:
A:树的形态是一条链。即 存在一条边(pi,pi+1)。
B:树的形态是一个完美二叉树。即 存在两条边(Pi,P2i)与(Pi,P2i+1)。 对于所有测试点:
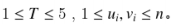 保证给岀的图是一个树。
#include <cstdio>
#include <algorithm>
using namespace std;
const int Maxn = 300000;
const int Maxlog = 19;
typedef long long ll;
#ifdef LOACL
bool ___;
#endif
struct Edge {
int to;
Edge *nxt;
};
Edge pool[Maxn * 2 + 5];
Edge *G[Maxn + 5], *ecnt;
inline void addedge(int u, int v) {
Edge *p = ++ecnt;
p->to = v, p->nxt = G[u];
G[u] = p;
}
int N;
int siz[Maxn + 5];
int mxson[Maxn + 5], mx2son[Maxn + 5];
ll ans;
int s[Maxn + 1][Maxlog + 2];
int f[Maxn + 5];
inline void clear() {
for(int i = 1; i <= N; i++)
mxson[i] = mx2son[i] = 0;
for(int i = 1; i <= N; i++)
for(int j = 0; j <= Maxlog; j++)
s[i][j] = 0;
for(int i = 1; i <= N; i++)
G[i] = NULL;
ecnt = &pool[0];
ans = 0;
}
inline void modify(int u) {
for(int i = 1; i <= Maxlog; i++)
s[u][i] = s[s[u][i - 1]][i - 1];
}
void PreDFS(int u, int fa) {
siz[u] = 1, f[u] = fa;
for(Edge *p = G[u]; p != NULL; p = p->nxt) {
int v = p->to;
if(v == fa) continue;
PreDFS(v, u);
siz[u] += siz[v];
if(siz[v] > siz[mxson[u]]) {
mx2son[u] = mxson[u];
mxson[u] = v;
} else if(siz[v] > siz[mx2son[u]])
mx2son[u] = v;
}
s[u][0] = mxson[u];
modify(u);
}
inline void calc(int u) {
int tot = siz[u], rt = u;
for(int i = Maxlog; i >= 0; i--)
if(tot - siz[s[u][i]] <= tot / 2)
u = s[u][i];
if(siz[s[u][0]] <= tot / 2) ans += u;
if(u != rt && siz[u] <= tot / 2) ans += f[u];
}
void DFS(int u, int fa) {
if(fa != 0) calc(fa), calc(u);
int flag = 0, t1;
if(N - siz[u] > siz[mxson[u]]) {
t1 = mx2son[u], flag = 1;
mx2son[u] = mxson[u], mxson[u] = fa;
} else if(N - siz[u] > siz[mx2son[u]]){
t1 = mx2son[u], flag = 2;
mx2son[u] = fa;
}
for(Edge *p = G[u]; p != NULL; p = p->nxt) {
int v = p->to;
if(v == fa) continue;
siz[u] += siz[fa] - siz[v], f[u] = v;
if(v == mxson[u]) s[u][0] = mx2son[u];
else s[u][0] = mxson[u];
modify(u);
DFS(v, u);
siz[u] -= siz[fa] - siz[v], f[u] = fa;
}
if(flag == 1) {
mxson[u] = mx2son[u], mx2son[u] = t1;
} else if(flag == 2) mx2son[u] = t1;
s[u][0] = mxson[u];
modify(u);
}
#ifdef LOACL
bool ____;
#endif
int main() {
#ifdef LOACL
freopen("in.txt", "r", stdin);
freopen("out.txt", "w", stdout);
#endif
int _;
scanf("%d", &_);
while(_--) {
scanf("%d", &N);
clear();
for(int i = 1; i < N; i++) {
int u, v;
scanf("%d %d", &u, &v);
addedge(u, v), addedge(v, u);
}
PreDFS(1, 0);
DFS(1, 0);
printf("%lld\n", ans);
}
#ifdef LOACL
printf("%.2f\n", (&____ - &___) / 1048576.0);
#endif
return 0;
}
铺设道路
【问题描述】
春春是一名道路工程师,负责铺设一条长度为 n 的道路。
铺设道路的主要工作是填平下陷的地表。整段道路可以看作是 n 块首尾相连的区域,一开始,第 i 块区域下陷的深度为 di 。
春春每天可以选择一段连续区间 [L, R] ,填充这段区间中的每块区域,让其下陷深度减少 1。在选择区间时,需要保证,区间内的每块区域在填充前下陷深度均不为 0 。
春春希望你能帮他设计一种方案,可以在最短的时间内将整段道路的下陷深度都变为 0 。
【输入格式】
输入文件名为 road.in。
输入文件包含两行,第一行包含一个整数 n,表示道路的长度。
第二行包含 n 个整数,相邻两数间用一个空格隔开,第 i 个整数为 di 。
【输出格式】
输出文件名为 road.out。
输出文件仅包含一个整数,即最少需要多少天才能完成任务。
【输入输出样例 1】
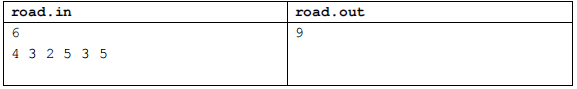
【样例解释】
一种可行的最佳方案是,依次选择:
[1,6]、[1,6]、[1,2]、[1,1]、[4,6]、[4,4]、[4,4]、[6,6]、[6,6]。
【数据规模与约定】
对于 30% 的数据,1 ≤ n ≤ 10 ;
对于 70% 的数据,1 ≤ n ≤ 1000 ;
对于 100% 的数据,1 ≤ n ≤ 100000 ,0 ≤ di ≤ 10000 。
#include <bits/stdc++.h>
#define inf 0x3f3f3f3f
using namespace std;
int ans,d[100001],N;
int partition1(int left, int right) //分治(实现这一片区域的操作)
{ int sum1=0;
if(left>=right) //当不能再分时返回
{
if(left==right) //如果区域是单个数
{ int t=d[left];
d[left]=0; //清0
return t; //直接返回里面的值(它里面的值代表这个单个区域需要的天数)
}
else
return 0;
}
int min1=inf,l=left;
for (int i=left; i<=right;i++) //求出这片区域的最小值
min1=min(d[i],min1);
sum1+=min1;//先把最小值加上
for(int i=left; i<=right; i++)
{ d[i]-=min1; //每个都减去最小值
if(d[i]==0&&d[i-1]!=0) //如果遇到0分界线
{
sum1+=partition1(l,i-1);//把之前的区域分治
}
if(d[i]!=0&&d[i-1]==0) l=i;//如果在0之后遇到新的左端点,更新
}
if(d[right]!=0)//不要忘掉最后一块区域
sum1+=partition1(l,right);
return sum1;
}
int main()
{
//freopen("in.txt","r",stdin);
cin>>N;
for(int i=1;i<=N;i++)
cin>>d[i];
ans=partition1(1,N);
cout<<ans;
return 0;
}
货币系统
【问题描述】
在网友的国度中共有 n 种不同面额的货币,第 i 种货币的面额为 a[i],你可以假设每一种货币都有无穷多张。为了方便,我们把货币种数为 n、面额数组为 a[1..n]的货币系统记作 (n,a)。
在一个完善的货币系统中,每一个非负整数的金额 x 都应该可以被表示出,即对每一个非负整数 x,都存在 n 个非负整数 t[i] 满足 a[i]× t[i] 的和为 x。然而,在网友的国度中,货币系统可能是不完善的,即可能存在金额 x 不能被该货币系统表示出。例如在货币系统 n=3, a=[2,5,9] 中,金额 1,3 就无法被表示出来。
两个货币系统 (n,a) 和 (m,b) 是等价的,当且仅当对于任意非负整数 x,它要么均可以被两个货币系统表出,要么不能被其中任何一个表出。
现在网友们打算简化一下货币系统。他们希望找到一个货币系统 (m,b),满足(m,b) 与原来的货币系统 (n,a) 等价,且 m 尽可能的小。他们希望你来协助完成这个艰巨的任务:找到最小的 m。
【输入格式】
输入文件名为 money.in。
输入文件的第一行包含一个整数 T,表示数据的组数。接下来按照如下格式分别给出 T 组数据。
每组数据的第一行包含一个正整数 n。接下来一行包含 n 个由空格隔开的正整数a[i]。
【输出格式】
输出文件名为 money.out。
输出文件共有 T 行,对于每组数据,输出一行一个正整数,表示所有与 (n,a) 等价的货币系统 (m,b) 中,最小的 m。
【输入输出样例 1】
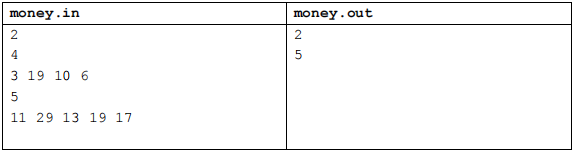
【输入输出样例 1 说明】
在第一组数据中,货币系统 (2, [3,10]) 和给出的货币系统 (n, a) 等价,并可以验证不存在 m < 2 的等价的货币系统,因此答案为 2。
在第二组数据中,可以验证不存在 m < n 的等价的货币系统,因此答案为 5。
【数据规模与约定】
对于 100% 的数据,满足 1 ≤ T ≤ 20, n,a[i] ≥ 1。
#include<iostream>
#include<algorithm>
#include<cstring>
#define N 25005
using namespace std;
bool dp[N]={0};
int a[103]={0};
int T=0,n=0;
int ret=0;
int main()
{
cin>>T;
while(T--)
{
cin>>n;
ret=0;
memset(dp,0,sizeof(dp));
dp[0]=1;
for(int i=1;i<=n;i++)
cin>>a[i];
sort(a+1,a+1+n);
for(int i=1;i<=n;i++)
{
if(dp[a[i]])
continue;
ret++;
for(int j=a[i];j<=a[n];j++)
{
dp[j]|=dp[j-a[i]];
}
}
cout<<ret<<endl;
}
return 0;
}
赛道修建
【问题描述】
C 城将要举办一系列的赛车比赛。在比赛前,需要在城内修建m 条赛道。
C 城一共有 n 个路口,这些路口编号为 1,2, … , n,有 n − 1 条适合于修建赛道的双向通行的道路,每条道路连接着两个路口。其中,第 i 条道路连接的两个路口编号为 ai和 bi,该道路的长度为 li。借助这 n − 1 条道路,从任何一个路口出发都能到达其他所有的路口。
一条赛道是一组互不相同的道路 e1, e2, … , ek,满足可以从某个路口出发,依次经过道路 e1, e2, … , ek(每条道路经过一次,不允许调头)到达另一个路口。一条赛道的长度等于经过的各道路的长度之和。为保证安全,要求每条道路至多被一条赛道经过。
目前赛道修建的方案尚未确定。你的任务是设计一种赛道修建的方案,使得修建的m条赛道中长度最小的赛道长度最大(即m条赛道中最短赛道的长度尽可能大)。
【输入格式】
输入文件名为 track.in。
输入文件第一行包含两个由空格分隔的正整数 n, m,分别表示路口数及需要修建的赛道数。
接下来 n − 1 行,第 i 行包含三个正整数 ai, bi, li,表示第 i 条适合于修建赛道的道路连接的两个路口编号及道路长度。保证任意两个路口均可通过这 n − 1 条道路相互到达。每行中相邻两数之间均由一个空格分隔。
【输出格式】
输出文件名为 track.out。
输出共一行,包含一个整数,表示长度最小的赛道长度的最大值。
【输入输出样例 1】
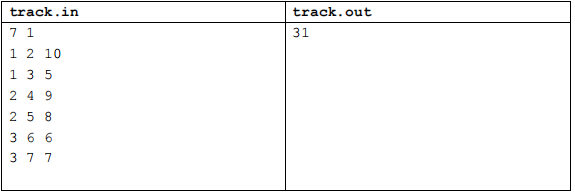
【输入输出样例 1 说明】
所有路口及适合于修建赛道的道路如下图所示:
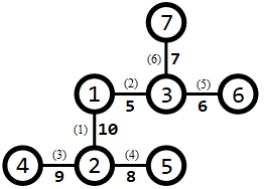
道路旁括号内的数字表示道路的编号,非括号内的数字表示道路长度。
需要修建 1 条赛道。可以修建经过第 3,1,2,6 条道路的赛道(从路口 4 到路口 7),则该赛道的长度为 9 + 10 + 5 + 7 = 31,为所有方案中的最大值。
【输入输出样例 2】
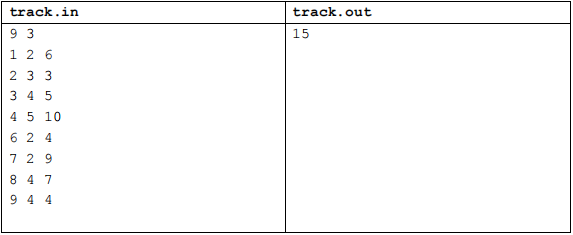
【输入输出样例 2 说明】
所有路口及适合于修建赛道的道路如下图所示:
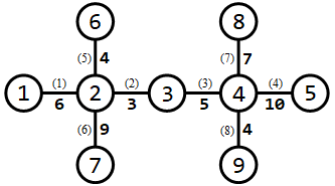
需要修建 3 条赛道。可以修建如下 3 条赛道:
1. 经过第 1,6 条道路的赛道(从路口 1 到路口 7),长度为 6 + 9 = 15;
2. 经过第 5,2,3,8 条道路的赛道(从路口 6 到路口 9),长度为 4 + 3 + 5 + 4 = 16;
3. 经过第 7,4 条道路的赛道(从路口 8 到路口 5),长度为 7 + 10 = 17。
长度最小的赛道长度为 15,为所有方案中的最大值。
【数据规模与约定】
所有测试数据的范围和特点如下表所示
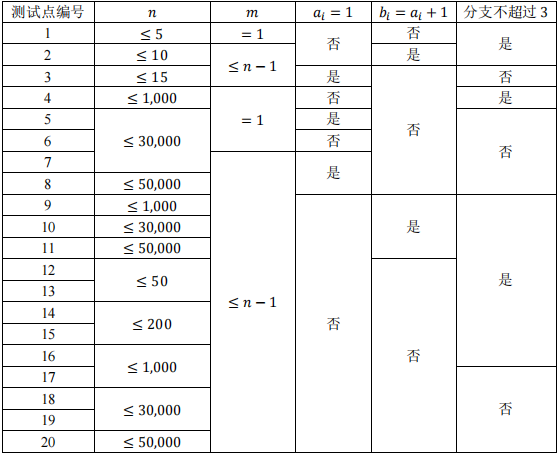
其中,“分支不超过 3”的含义为:每个路口至多有 3 条道路与其相连。对于所有的数据,2 ≤ n≤ 50,000,1 ≤ m ≤ n − 1,1 ≤ ai, bi ≤ n,1 ≤ li ≤ 10,000。
#include <iostream>
#include <algorithm>
#include <cstdio>
#include <cstring>
#include <cmath>
#include <set>
#include <vector>
using namespace std;
int head[50100],to[100100],nex[100100],val[100100];
int n,waysnumber,m,edges;
multiset <int> :: iterator it;
int dfs(int now,int father,int x){
multiset <int> son;
for (int v = head[now]; v ; v = nex[v])
if (to[v] != father){
int tmpways = dfs(to[v],now,x) + val[v];
if (tmpways >= x) ++waysnumber;
else son.insert(tmpways);
}
//对当前点now的所有子路径进行组合,用刚好能满足≥x的最小的边组合
//并返回所有儿子中最长的无法被组合成满足条件路的点
int maxwaylen = 0;
while (son.size() > 1){
it = son.lower_bound(x - *son.begin());
if (it == son.begin()) it++; //若最短的边≥x的时候,则用最短的两条边组合
if (it == son.end()){ //当前最短的边没办法找到够长的边组合出满足条件的路
//挑一条最长的子边返回
maxwaylen = max(maxwaylen,*son.begin());
son.erase(son.begin());
}
else{
//成功组合出了满足条件的边
++waysnumber;
son.erase(it);
son.erase(son.begin());
}
}
if (son.size() == 1) maxwaylen = max(maxwaylen,*son.begin());
return maxwaylen;
}
bool check(int x){
waysnumber = 0;
dfs(1,0,x);
if (waysnumber >= m) return true;
else return false;
}
void addedge(int u,int v,int c){
nex[++edges] = head[u], head[u] = edges, to[edges] = v, val[edges] = c;
}
int main()
{
edges = 0;
scanf("%d%d",&n,&m);
long long all = 0;
for (int i = 1 ; i < n ; ++i){
int a,b,c;scanf("%d%d%d",&a,&b,&c);
addedge(a,b,c);
addedge(b,a,c);
all += c;
}
int l = 0 , r = all / m,mid,ans; //这里存在一个坑,对于ai = 1的图,如果这里的 r 使用极大值500000000,就会超时
while (l <= r){
mid = (l + r) >> 1;
if (check(mid)) ans = mid,l = mid + 1;
else r = mid - 1;
}
printf("%d\n",ans);
return 0;
}
旅行
【问题描述】
小 Y 是一个爱好旅行的 OIer。她来到 X 国,打算将各个城市都玩一遍。
小 Y 了解到,X 国的n 个城市之间有 m 条双向道路。每条双向道路连接两个城市。不存在两条连接同一对城市的道路,也不存在一条连接一个城市和它本身的道路。并且,从任意一个城市出发,通过这些道路都可以到达任意一个其他城市。小 Y 只能通过这些道路从一个城市前往另一个城市。
小 Y 的旅行方案是这样的:任意选定一个城市作为起点,然后从起点开始,每次可以选择一条与当前城市相连的道路,走向一个没有去过的城市,或者沿着第一次访问该城市时经过的道路后退到上一个城市。当小 Y 回到起点时,她可以选择结束这次旅行或继续旅行。需要注意的是,小 Y 要求在旅行方案中,每个城市都被访问到。
为了让自己的旅行更有意义,小 Y 决定在每到达一个新的城市(包括起点)时,将它的编号记录下来。她知道这样会形成一个长度为n 的序列。她希望这个序列的字典序最小,你能帮帮她吗?
对于两个长度均为 n 的序列 A 和 B,当且仅当存在一个正整数 x,满足以下条件时,我们说序列 A 的字典序小于 B。
⚫ 对于任意正整数 1 ≤ i < x,序列 A 的第 i 个元素 Ai 和序列 B 的第 i 个元素Bi 相同。
⚫ 序列 A 的第 x 个元素的值小于序列 B 的第 x 个元素的值。
【输入格式】
输入文件名为 travel.in。
输入文件共 m + 1 行。第一行包含两个整数 n, m(m ≤ n) ,中间用一个空格分隔。
接下来 m 行,每行包含两个整数 u, v (1 ≤ u, v ≤ n) ,表示编号为 u 和 v 的城市之间有一条道路,两个整数之间用一个空格分隔。
【输出格式】
输出文件名为 travel.out。
输出文件包含一行,n 个整数,表示字典序最小的序列。相邻两个整数之间用一个空格分隔。
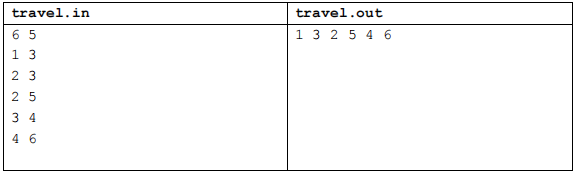
【输入输出样例 1】
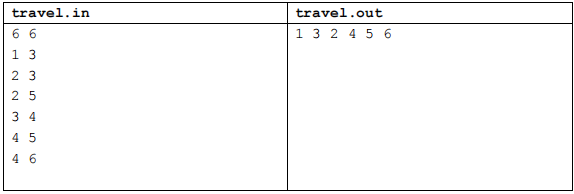
【输入输出样例 2】
【数据规模与约定】
对于 100% 的数据和所有样例,1 ≤ n ≤ 5000 且 m = n − 1 或 m = n 。
对于不同的测试点,我们约定数据的规模如下:
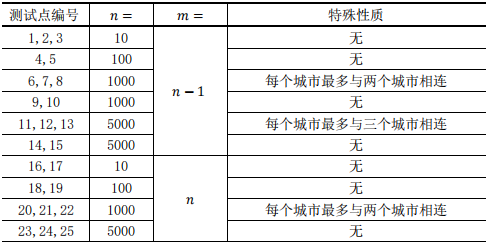
#include<bits/stdc++.h>
#define maxn 50500
using namespace std;
inline int read() {
int x=0;char c=getchar();
while(!isdigit(c)) c=getchar();
while(isdigit(c)) x=(x<<3)+(x<<1)+c-48,c=getchar();return x;
}
int n,m,cnt,del;
int ans[maxn],start[maxn],to[maxn],cur[maxn];
vector<int> v[maxn];
inline bool check() {
if(cnt != n) return false;
for(int i=1;i<=n;i++) if(cur[i]!=ans[i]) return ans[i]>cur[i];
}
void dfs(int u,int f) {
if(cnt>n) return ;
cur[++cnt]=u;
for(int i=0;i<v[u].size();i++) {
if(v[u][i]==f || (u==start[del]&&v[u][i]==to[del]) || (v[u][i]==start[del]&&u==to[del])) continue;
dfs(v[u][i],u);
}
}
int main() {
//freopen("test.in","r",stdin);
//freopen("test.out","w",stdout);
memset(ans,64,sizeof(ans));
n=read(),m=read();
for(int i=1;i<=m;i++) {
int x=read(),y=read();
v[x].push_back(y);
v[y].push_back(x);
start[i]=x;to[i]=y;
}
for(int i=1;i<=n;i++) sort(v[i].begin(),v[i].end());
if(m==n-1) {
del=0;cnt=0;
dfs(1,0);
memcpy(ans,cur,sizeof(cur));
} else {
for(int i=1;i<=m;i++) {
memset(cur,0,sizeof(cur));
del=i;cnt=0;
dfs(1,0);
if(check() ) {
memcpy(ans,cur,sizeof(cur));
}
}
}
for(int i=1;i<=n;i++) printf("%d ",ans[i]);
return 0;
}
填数游戏
【问题描述】
小 D 特别喜欢玩游戏。这一天,他在玩一款填数游戏。
这个填数游戏的棋盘是一个n × m的矩形表格。玩家需要在表格的每个格子中填入一个数字(数字 0 或者数字 1),填数时需要满足一些限制。
下面我们来具体描述这些限制。
为了方便描述,我们先给出一些定义:
• 我们用每个格子的行列坐标来表示一个格子,即(行坐标,列坐标)。(注意:行列坐标均从 0 开始编号)
• 合法路径 P:一条路径是合法的当且仅当:
1. 这条路径从矩形表格的左上角的格子(0,0)出发,到矩形的右下角格子(n − 1, m − 1)结束;
2. 在这条路径中,每次只能从当前的格子移动到右边与它相邻的格子,或者从当前格子移动到下面与它相邻的格子。
例如:在下面这个矩形中,只有两条路径是合法的,它们分别是p1:(0,0) → (0,1) →(1,1)和p2:(0,0) → (1,0) → (1,1)。
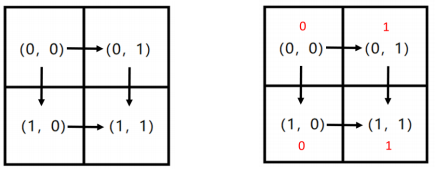
对于一条合法的路径 P,我们可以用一个字符串w(P)来表示,该字符串的长度为n +m − 2,其中只包含字符“R”或者字符“D”,第 i 个字符记录了路径 P 中第 i 步的移动方法,“R”表示移动到当前格子右边与它相邻的格子,“D”表示移动到当前格子下面与它相邻的格子。例如,上图中对于路径p1,有w(P1) = "RD";而对于另一条路径p2,有w(P2) = "DR"。
同时,将每条合法路径 P 经过的每个格子上填入的数字依次连接后,会得到一个长度为n + m − 1的 01 字符串,记为 s(P)。例如,如果我们在格子(0,0)和(1,0)上填入数字0,在格子(0,1)和(1,1)上填入数字 1(见上图红色数字)。那么对于路径p1,我们可以得到s(P1) = "011",对于路径p2,有s(P2) = "001"。
游戏要求小 D 找到一种填数字 0、1 的方法,使得对于两条路径p1,P2,如果w(P1) >w(P2),那么必须s(P1) ≤ s(P2)。我们说字符串 a 比字符串 b 小,当且仅当字符串 a 的字典序小于字符串 b 的字典序,字典序的定义详见第一题。但是仅仅是找一种方法无法满足小 D 的好奇心,小 D 更想知道这个游戏有多少种玩法,也就是说,有多少种填数字的方法满足游戏的要求?
小 D 能力有限,希望你帮助他解决这个问题,即有多少种填 0、1 的方法能满足题目要求。由于答案可能很大,你需要输出答案对109 + 7取模的结果。
【输入格式】
输入文件名为 game.in。
输入文件共一行,包含两个正整数 n、m,由一个空格分隔,表示矩形的大小。其中 n 表示矩形表格的行数,m 表示矩形表格的列数。
【输出格式】
输出文件名为 game.out。
输出共一行,包含一个正整数,表示有多少种填 0、1 的方法能满足游戏的要求。
注意:输出答案对 10^9+7 取模的结果。
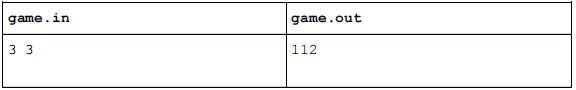
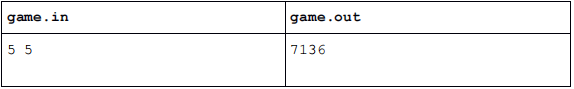
【输入输出样例 1】
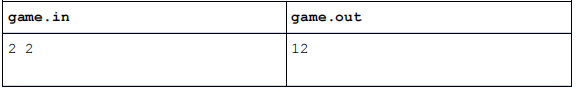
【样例解释】
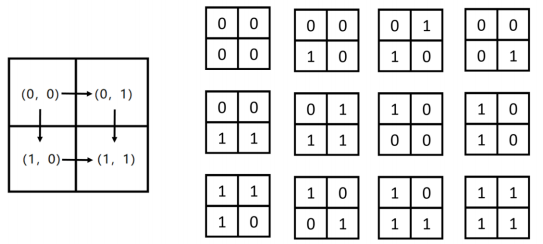
对于2 × 2棋盘,有上图所示的 12 种填数方法满足要求。
【输入输出样例 2】
【输入输出样例 3】
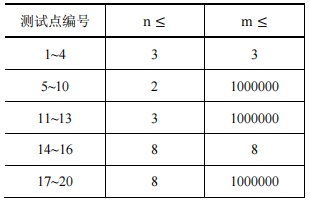
【数据规模与约定】
#include<cstdio>
#include<cstring>
#include<algorithm>
#define P 1000000007
using namespace std;
int n,m,inv128=570312504,inv384=190104168;
int add(int x,int y) {return x+y>=P?x+y-P:x+y;}
int dec(int x,int y) {return x-y< 0?x-y+P:x-y;}
int mul(int x,int y) {return 1ll*x*y%P;}
int power(int a,int b){
int ans=1;
for(;b;b>>=1,a=mul(a,a)) if(b&1) ans=mul(ans,a);
return ans;
}
int main(){
scanf("%d%d",&n,&m);
if(n>m) swap(n,m);
if(n==1) printf("%d\n",power(2,m));
else if(n==2) printf("%d\n",mul(4,power(3,m-1)));
else if(n==3) printf("%d\n",mul(112,power(3,m-3)));
else{
if(m==n) printf("%d\n",(83ll*power(8,n)%P+5ll*power(2,n+7)%P)*inv384%P);
else printf("%d\n",(83ll*power(8,n)%P+power(2,n+8))*power(3,m-n-1)%P*inv128%P);
}
return 0;
}
保卫王国
【问题描述】
Z 国有n座城市,n − 1条双向道路,每条双向道路连接两座城市,且任意两座城市都能通过若干条道路相互到达。
Z 国的国防部长小 Z 要在城市中驻扎军队。驻扎军队需要满足如下几个条件:
一座城市可以驻扎一支军队,也可以不驻扎军队。
由道路直接连接的两座城市中至少要有一座城市驻扎军队。
在城市里驻扎军队会产生花费,在编号为i的城市中驻扎军队的花费是pi。
小 Z 很快就规划出了一种驻扎军队的方案,使总花费最小。但是国王又给小 Z 提出了m个要求,每个要求规定了其中两座城市是否驻扎军队。小 Z 需要针对每个要求逐一给出回答。具体而言,如果国王提出的第j个要求能够满足上述驻扎条件(不需要考虑第 j 个要求之外的其它要求),则需要给出在此要求前提下驻扎军队的最小开销。如果国王提出的第j个要求无法满足,则需要输出-1 (1 ≤ j ≤ m)。现在请你来帮助小 Z。
【输入格式】
输入文件名为 defense.in。
第 1 行包含两个正整数n, m和一个字符串type,分别表示城市数、要求数和数据类型。type是一个由大写字母 A,B 或 C 和一个数字 1,2,3 组成的字符串。它可以帮助你获得部分分。你可能不需要用到这个参数。这个参数的含义在【数据规模与约定】中有具体的描述。
第2行n个整数pi,表示编号i的城市中驻扎军队的花费。
接下来n − 1行,每行两个正整数u, v,表示有一条u到v的双向道路。
接下来m行,第j行四个整数a, x, b, y(a ≠ b),表示第j个要求是在城市a驻扎x支军队,在城市b驻扎y支军队。其中,x 、 y 的取值只有 0 或 1:若 x 为 0,表示城市 a 不得驻扎军队,若 x 为 1,表示城市 a 必须驻扎军队;若 y 为 0,表示城市 b 不得驻扎军队,若 y 为 1,表示城市 b 必须驻扎军队。
输入文件中每一行相邻的两个数据之间均用一个空格分隔。
【输出格式】
输出文件名为 defense.out。
输出共m行,每行包含 1 个整数,第j行表示在满足国王第j个要求时的最小开销,如果无法满足国王的第j个要求,则该行输出-1。
【输入输出样例 1】
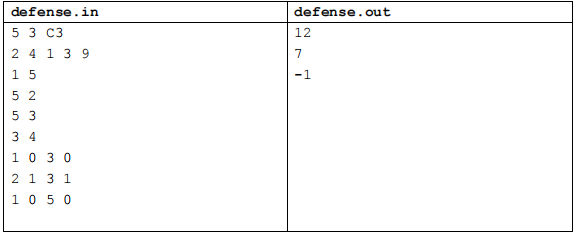
【样例解释】
对于第一个要求,在 4 号和 5 号城市驻扎军队时开销最小。
对于第二个要求,在 1 号、2 号、3 号城市驻扎军队时开销最小。
第三个要求是无法满足的,因为在 1 号、5 号城市都不驻扎军队就意味着由道路直接连
接的两座城市中都没有驻扎军队。
【数据规模与约定】
对于 100%的数据,n, m ≤ 300000,1 ≤ pi ≤ 100000。
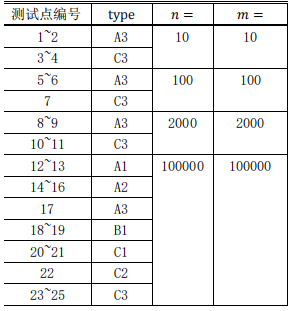
数据类型的含义:
A:城市i与城市i + 1直接相连。
B:任意城市与城市 1 的距离不超过 100(距离定义为最短路径上边的数量),即如果这棵树以 1 号城市为根,深度不超过 100。
C:在树的形态上无特殊约束。
1:询问时保证a = 1, x = 1,即要求在城市 1 驻军。对b, y没有限制。
2:询问时保证a, b是相邻的(由一条道路直接连通)
3:在询问上无特殊约束。
#pragma GCC optimize("O3")
#pragma G++ optimize("O3")
#include<stdio.h>
#include<string.h>
#include<algorithm>
#define MAXN 100005
#define MAXM MAXN*2
#define ll long long
#define reg register ll
#define INF 1000000000000000007ll
#define fo(i,a,b) for (reg i=a;i<=b;++i)
#define fd(i,a,b) for (reg i=a;i>=b;--i)
#define rep(i,a) for (reg i=last[a];i;i=next[i])
#define O3 __attribute__((optimize("-O3")))
ll last[MAXM],next[MAXM],tov[MAXM];
ll p[MAXN],depth[MAXN],fa[MAXN];
ll f[MAXN][2],g[MAXN][2];
ll anc[MAXN][21];
ll n,m,tot,ans;
char type[5];
struct node
{
ll a[2][2];
}dis[MAXN][21],A,B,C;
O3 inline ll read()
{
ll x=0,f=1;char ch=getchar();
while (ch<'0' || '9'<ch){if (ch=='-')f=-1;ch=getchar();}
while ('0'<=ch && ch<='9')x=x*10+ch-'0',ch=getchar();
return x*f;
}
O3 inline ll min(ll x,ll y)
{
return x<y?x:y;
}
O3 inline void swap(ll &x,ll &y)
{
x=x+y,y=x-y,x=x-y;
}
O3 inline void link(ll x,ll y)
{
next[++tot]=last[x],last[x]=tot,tov[tot]=y;
}
O3 inline void dfs1(ll x)
{
depth[x]=depth[fa[x]]+1,anc[x][0]=fa[x];
fo(i,1,20)anc[x][i]=anc[anc[x][i-1]][i-1];
f[x][0]=0,f[x][1]=p[x];
rep(i,x)if (tov[i]!=fa[x])
{
fa[tov[i]]=x,dfs1(tov[i]);
f[x][0]+=f[tov[i]][1];
f[x][1]+=min(f[tov[i]][0],f[tov[i]][1]);
}
}
O3 inline void dfs2(ll x)
{
if (x==1)g[x][0]=f[x][0],g[x][1]=f[x][1];
else
{
g[x][0]=f[x][0]+g[fa[x]][1]-min(f[x][0],f[x][1]);
g[x][1]=f[x][1]+min(g[fa[x]][0]-f[x][1],g[fa[x]][1]-min(f[x][0],f[x][1]));
}
rep(i,x)if (tov[i]!=fa[x])
{
dis[tov[i]][0].a[0][0]=INF;
dis[tov[i]][0].a[1][0]=f[x][0]-f[tov[i]][1];
dis[tov[i]][0].a[0][1]=f[x][1]-min(f[tov[i]][0],f[tov[i]][1]);
dis[tov[i]][0].a[1][1]=f[x][1]-min(f[tov[i]][0],f[tov[i]][1]);
dfs2(tov[i]);
}
}
O3 inline node merge(node A,node B)
{
memset(C.a,60,sizeof(C.a));
fo(i,0,1)fo(j,0,1)fo(k,0,1)
C.a[i][j]=min(C.a[i][j],A.a[i][k]+B.a[k][j]);
return C;
}
O3 int main()
{
freopen("defense.in","r",stdin);
freopen("defense.out","w",stdout);
//freopen("readin.txt","r",stdin);
n=read(),m=read(),scanf("%s",&type);
fo(i,1,n)p[i]=read();
fo(i,1,n-1)
{
ll x=read(),y=read();
link(x,y),link(y,x);
}
dfs1(1),dfs2(1);
fo(j,1,20)fo(i,1,n)dis[i][j]=merge(dis[i][j-1],dis[anc[i][j-1]][j-1]);
while (m--)
{
ll a=read(),x=read(),b=read(),y=read();
if (x+y==0 && ((fa[a]==b) || (fa[b]==a)))
{
printf("-1\n");
continue;
}
if (depth[a]<depth[b])swap(a,b),swap(x,y);
memset(A.a,60,sizeof(A.a));
memset(B.a,60,sizeof(B.a));
A.a[x][x]=f[a][x],B.a[y][y]=f[b][y];
fd(i,20,0)if (depth[anc[a][i]]>depth[b])
{
A=merge(A,dis[a][i]),a=anc[a][i];
}
if (fa[a]==b)
{
printf("%lld\n",y==0?g[b][0]-f[a][1]+A.a[x][1]:
g[b][1]-min(f[a][0],f[a][1])+min(A.a[x][0],A.a[x][1]));
continue;
}
if (depth[a]!=depth[b])A=merge(A,dis[a][0]),a=fa[a];
fd(i,20,0)if (anc[a][i]!=anc[b][i])
{
A=merge(A,dis[a][i]),B=merge(B,dis[b][i]);
a=anc[a][i],b=anc[b][i];
}
printf("%lld\n",min(g[fa[a]][0]-f[a][1]-f[b][1]+A.a[x][1]+B.a[y][1],
g[fa[a]][1]-min(f[a][0],f[a][1])-min(f[b][0],f[b][1])+min(A.a[x][0],A.a[x][1])+min(B.a[y][0],B.a[y][1])));
}
return 0;
}
2-3 树是一种特殊的树,它满足两个条件:
(1)每个内部结点有两个或三个子结点;
(2)所有的叶结点到根的路径长度相同。
如果一棵 2-3 树有 10 个叶结点,那么它可能有( )个非叶结点。
甲乙丙丁四人在考虑周末要不要外出郊游。
已知:①如果周末下雨,并且乙不去,则甲一定不去;②如果乙去,则丁一定去;③如果丙去,则丁一定不去;④如果丁不去,而且甲不去,则丙一定不去。如果周末丙去了,则甲________(去了/没去)(1 分),乙________(去了/没去)(1 分),丁________(去了/没去)(1 分),周末________(下雨/没下雨)(2 分)。
去了 没去 没去 没下雨 (第4 空 2 分,其余 1 分)
方程 a*b = (a or b) * (a and b),在 a,b 都取 [0, 31] 中的整数时,共有_____组解。(*表示乘法;or 表示按位或运算;and 表示按位与运算)
共有454组解