信息学奥赛-提高级 题库
前序遍历和中序遍历相同的二叉树为且仅为( )。
设根节点深度为 0,一棵深度为 h 的满 k(k>1)叉树,即除最后一层无任何子节点外,每一层上的所有结点都有 k 个子结点的树,共有( )个结点。
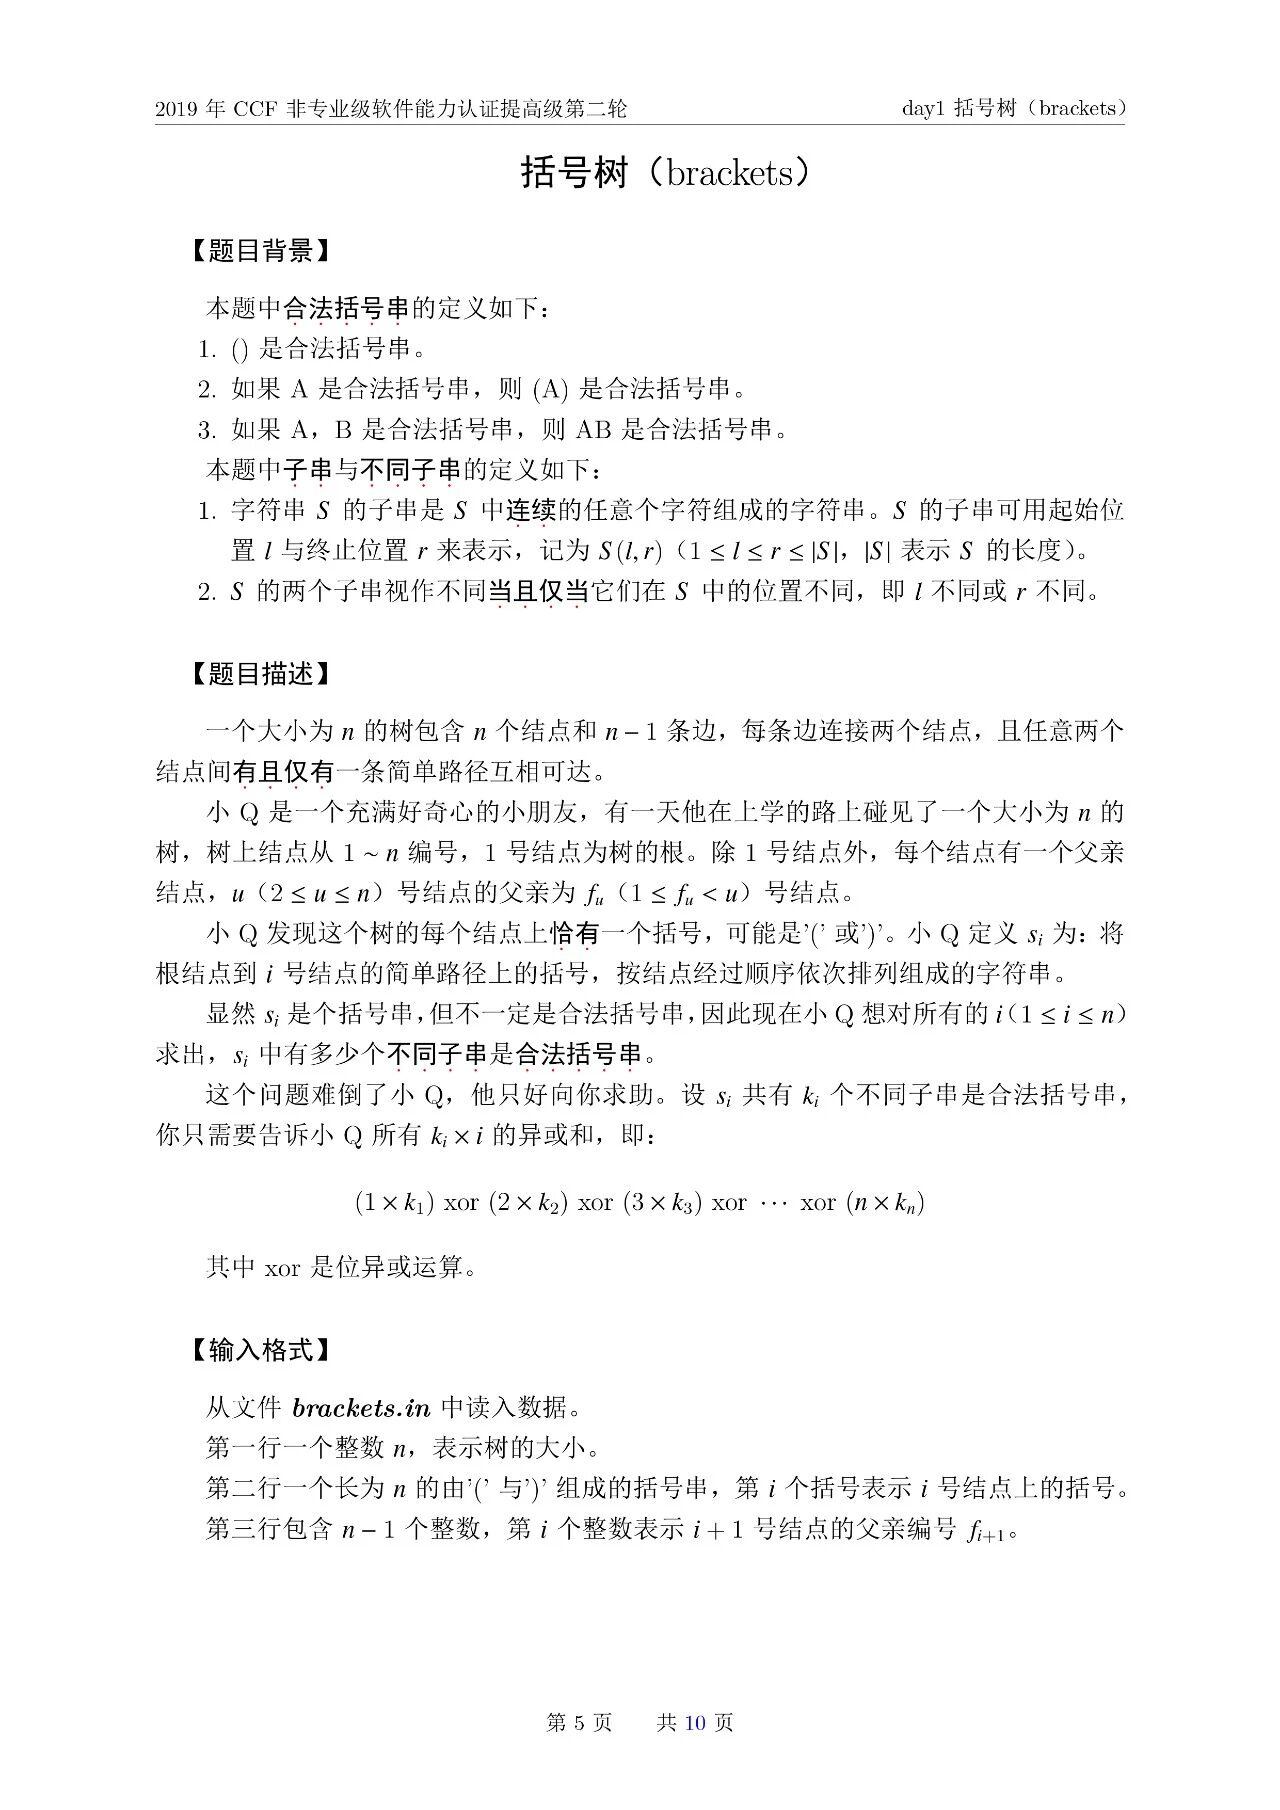
day1-2 括号树
#include <iostream>
#include <vector>
#include <string>
using namespace std;

int n;
string brackets;
vector<vector<int>> children;
long long ans = 0;

void dfs(int u, vector<int>& stack, vector<int>& dp, long long& cnt) {
    char c = brackets[u - 1];
    int prev_stack_size = stack.size();
    int prev_dp_size = dp.size();
    long long prev_cnt = cnt;
    int prev_left = -1; // 记录弹出的左括号位置,用于回溯

    if (c == '(') {
        stack.push_back(u);
        dp.push_back(0);
    } else {
        if (!stack.empty()) {
            prev_left = stack.back();
            stack.pop_back();
            int current_dp = (prev_left > 1 ? dp[prev_left - 2] : 0) + 1;
            dp.push_back(current_dp);
            cnt += current_dp;
        } else {
            dp.push_back(0);
        }
    }

    ans ^= (long long)u * cnt;

    for (int v : children[u]) {
        dfs(v, stack, dp, cnt);
    }

    // 回溯操作,恢复进入当前节点前的状态
    dp.pop_back();
    if (c == '(') {
        stack.pop_back();
    } else {
        if (prev_left != -1) {
            stack.push_back(prev_left);
        }
    }
    cnt = prev_cnt;
}

int main() {
    ios::sync_with_stdio(false);
    cin.tie(nullptr);

    cin >> n;
    cin >> brackets;
    children.resize(n + 1); // 节点编号从1到n
    for (int i = 2; i <= n; ++i) {
        int f;
        cin >> f;
        children[f].push_back(i);
    }

    vector<int> stack;
    vector<int> dp;
    long long cnt = 0;

    dfs(1, stack, dp, cnt);

    cout << ans << endl;

    return 0;
}
方法思路
1、合法括号子串判断:使用栈来匹配括号,维护一个动态规划数组dp,其中dp[i]表示以第i个字符结尾的合法括号子串数量。
2、树的遍历:通过 DFS 遍历树的每个节点,处理每个节点的括号时,维护栈和dp数组,并在回溯时恢复状态,以避免重复计算。
3、状态回溯:进入子节点前记录当前栈、dp数组和合法子串总数的状态,处理完子节点后恢复这些状态,确保每个节点的处理独立。
代码解释
1、输入处理:读取节点数n、括号字符串和父节点信息,构建子节点列表。
2、DFS 遍历:从根节点(节点 1)开始遍历,处理每个节点的括号:
3、左括号:压入栈,dp数组添加 0(以左括号结尾无合法子串)。
4、右括号:若栈非空,弹出栈顶左括号,计算以当前右括号结尾的合法子串数,更新dp和合法子串总数cnt。
5、状态回溯:处理完子节点后,恢复栈、dp数组和cnt到进入当前节点前的状态,确保后续节点处理正确。
6、异或和计算:每个节点处理时,计算i * k_i并累加到异或和ans中。
这种方法确保了每个节点的处理时间为 O (1)(均摊),整体时间复杂度为 O (n),空间复杂度为 O (n),适用于大规模数据。
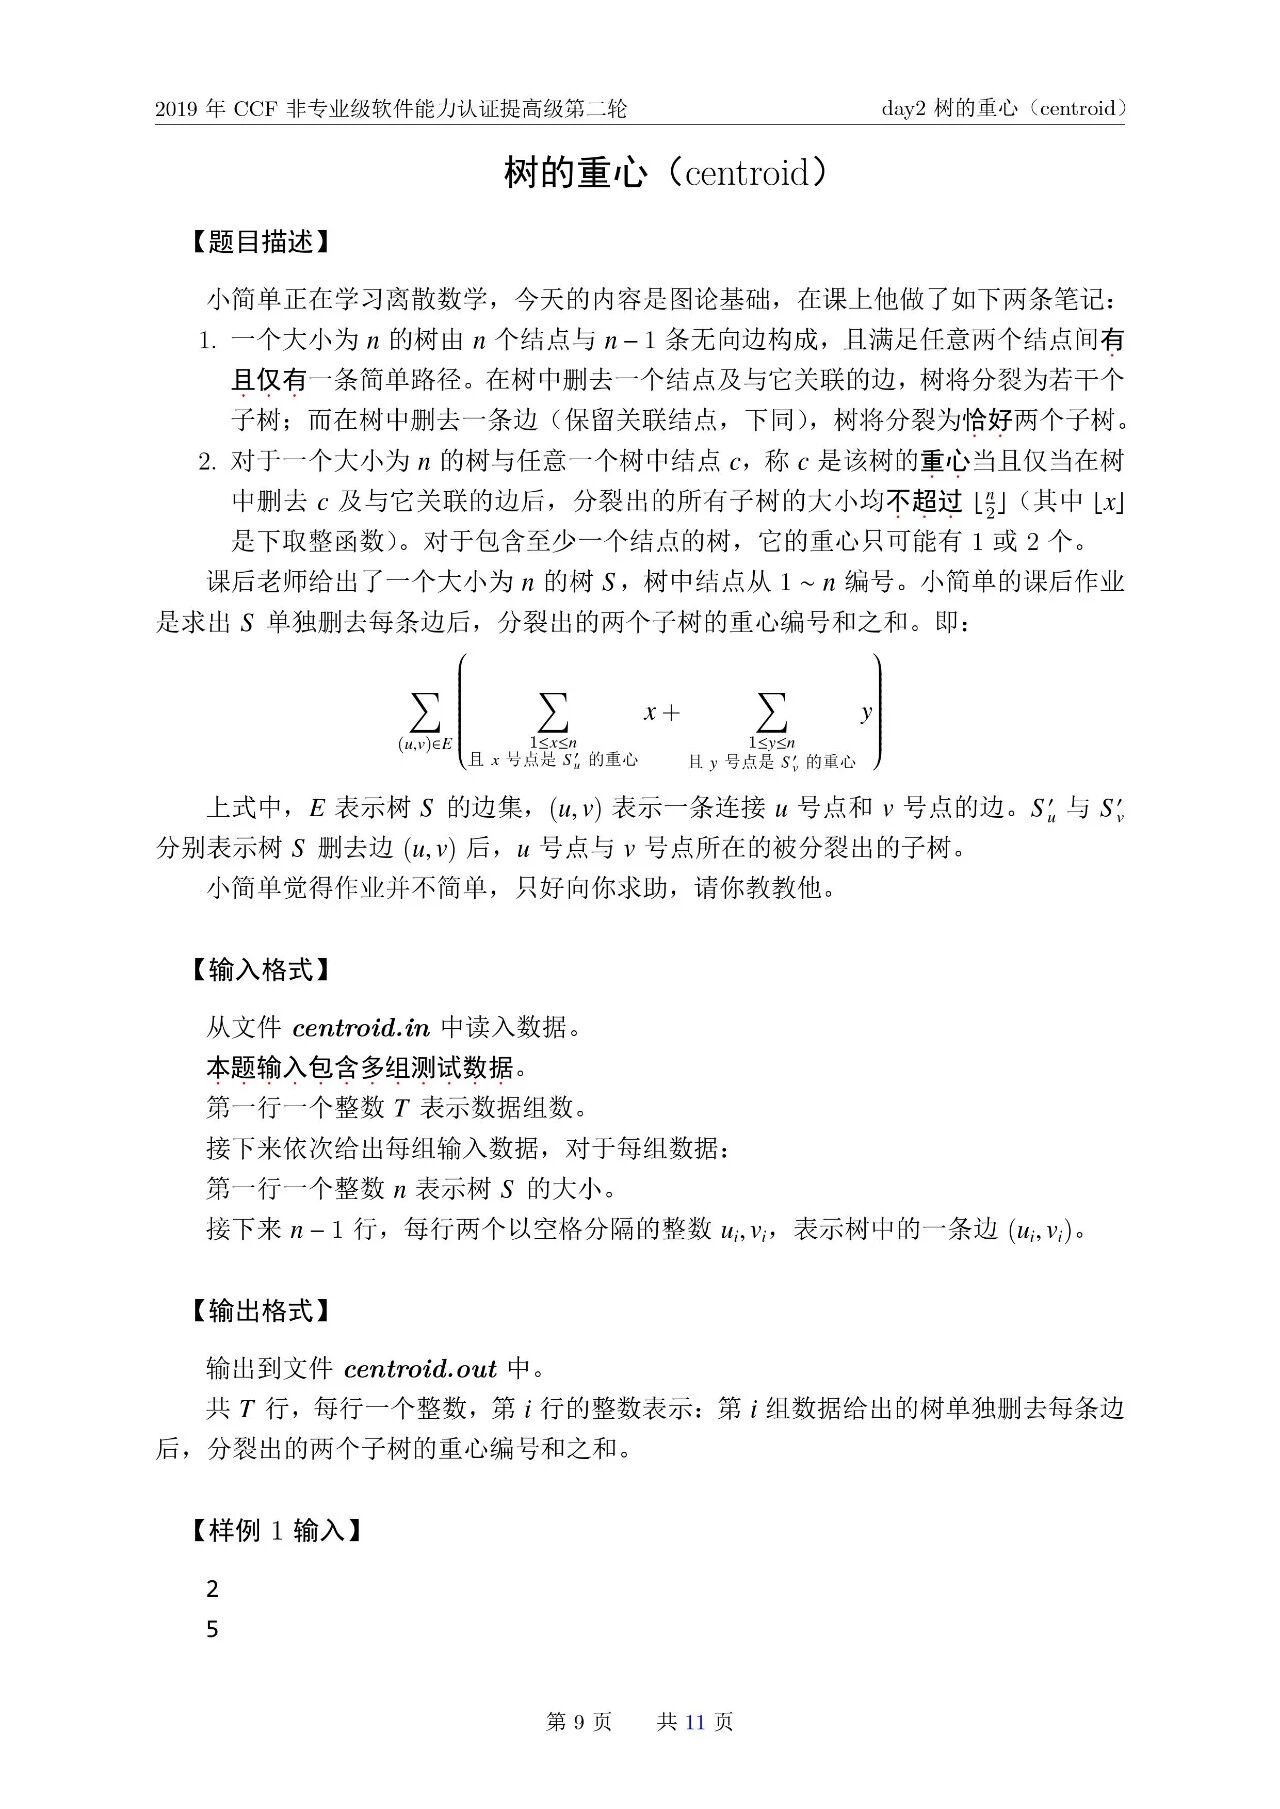
day2-3 树的重心
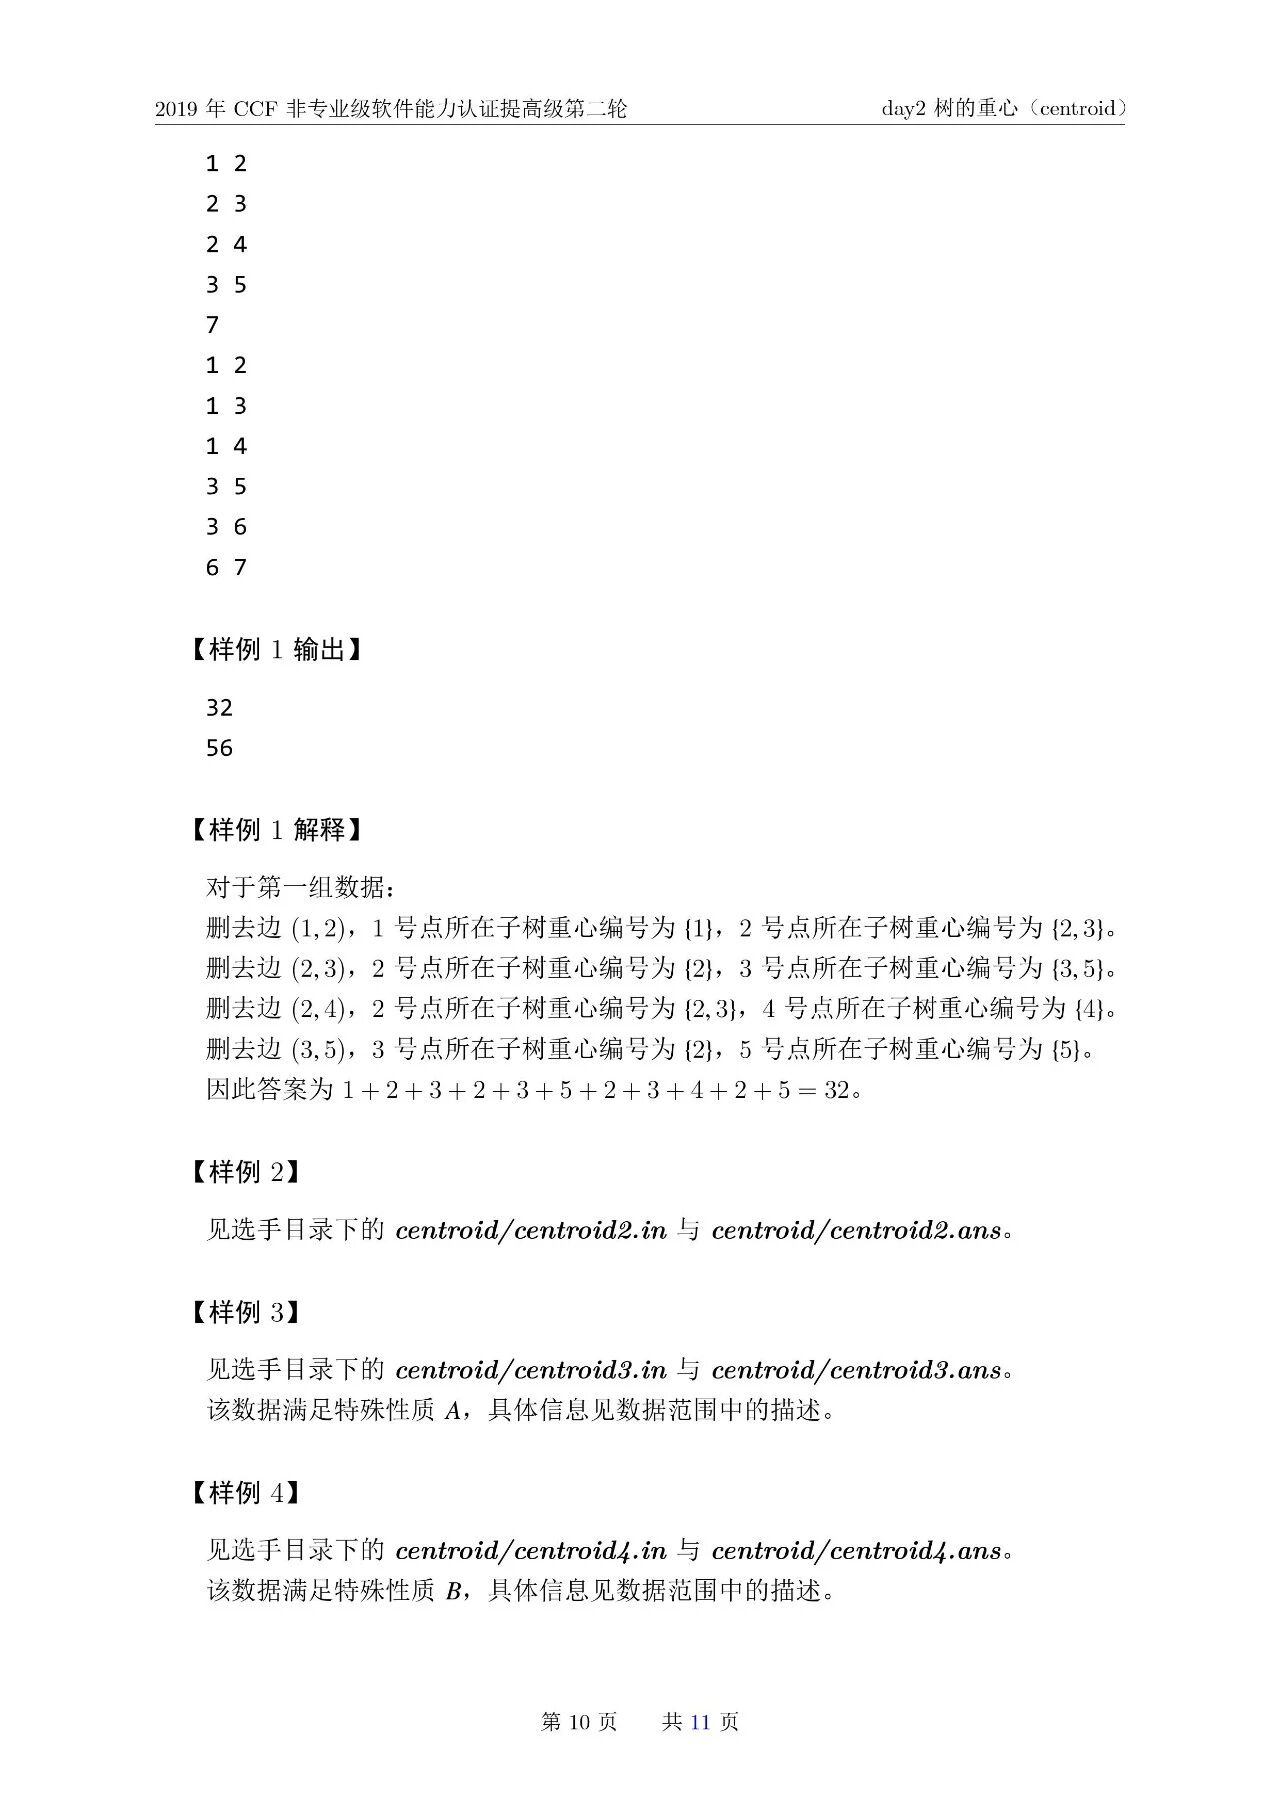
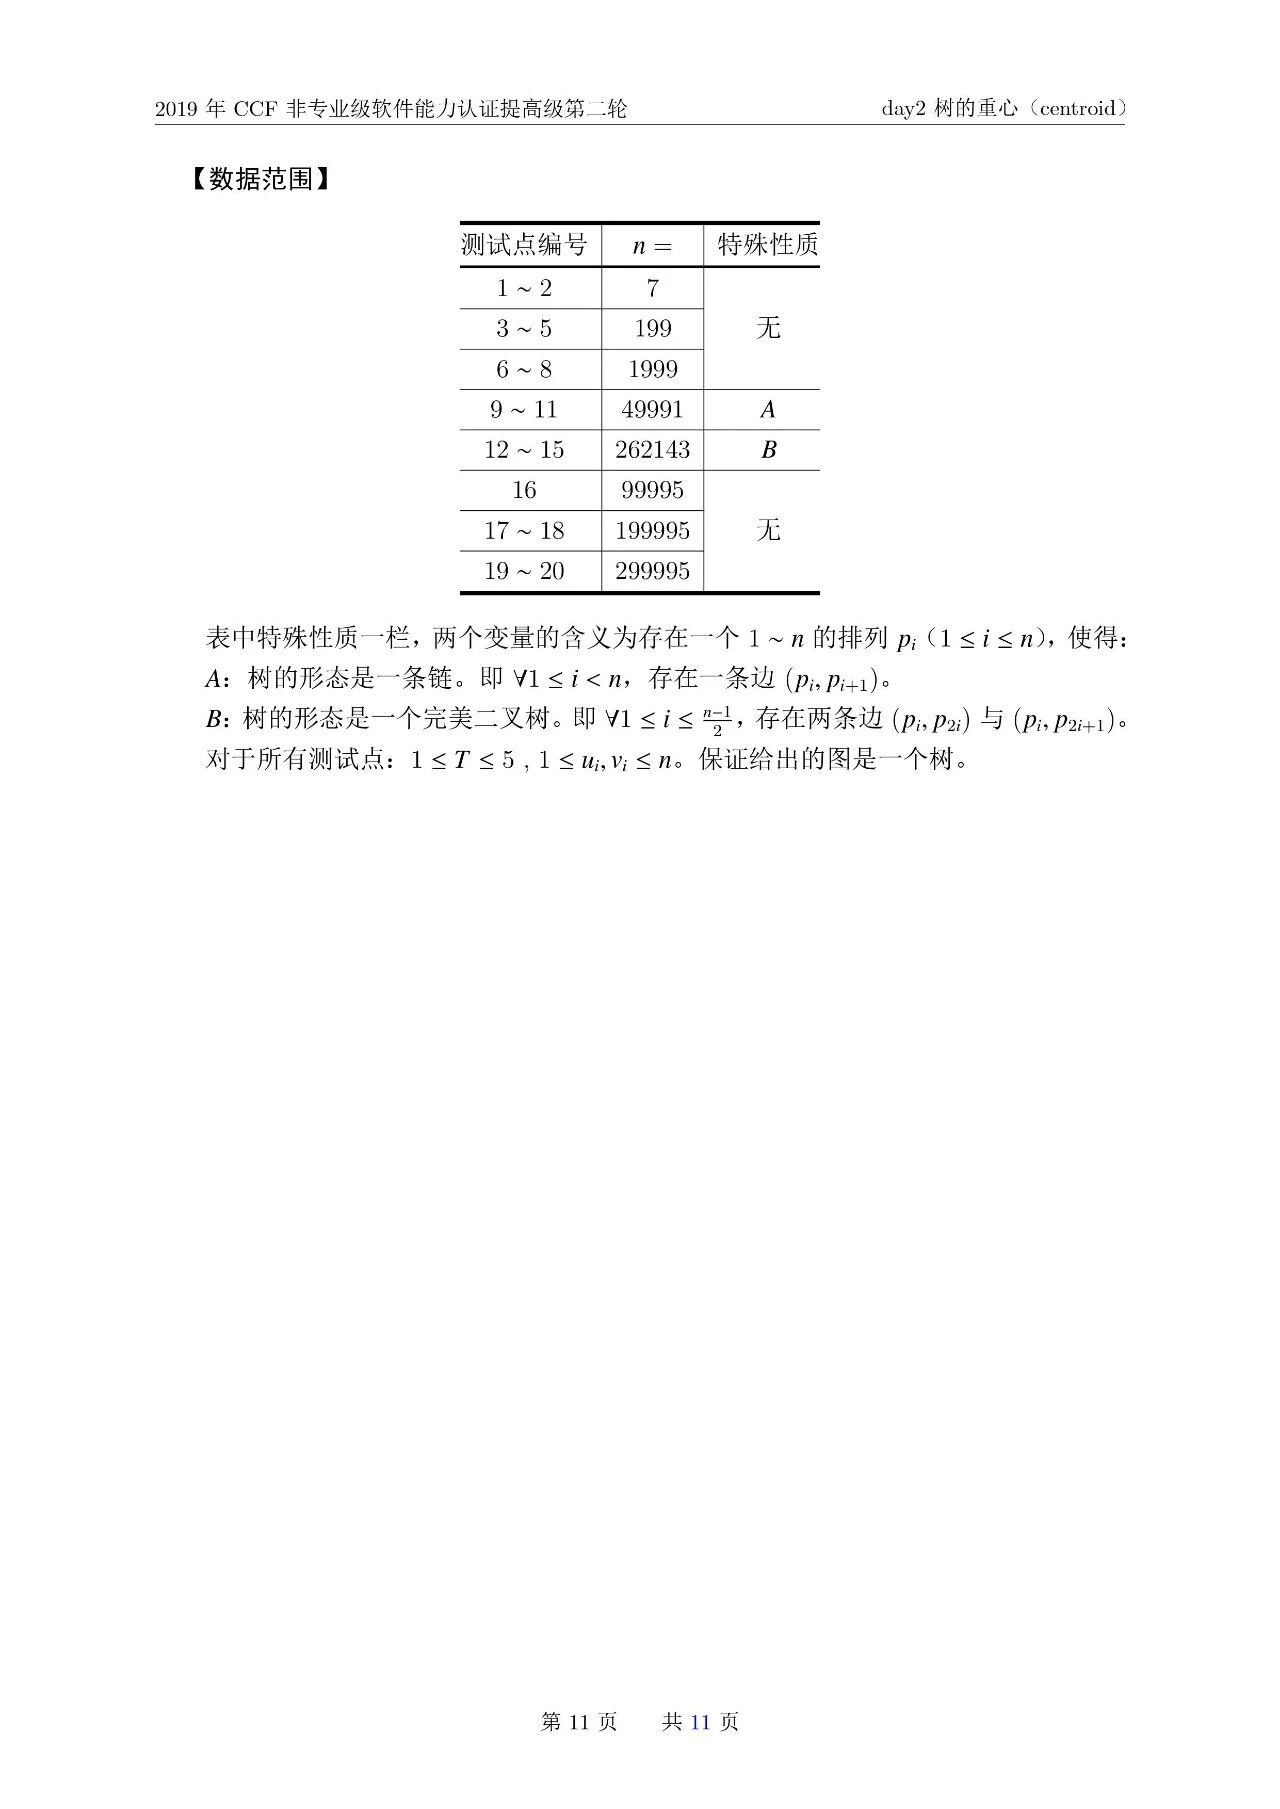
#include <bits/stdc++.h>
using namespace std;

typedef long long ll;
const int MAXN = 3e5 + 10;

vector<int> adj[MAXN];

// 计算以u为根,排除exclude节点的子树大小
int compute_size(int u, int parent, int exclude) {
    int s = 1;
    for (int v : adj[u]) {
        if (v != parent && v != exclude) {
            s += compute_size(v, u, exclude);
        }
    }
    return s;
}

// 查找以root为根,排除exclude节点的子树的所有重心
vector<int> find_centroids(int root, int exclude, int total_size) {
    vector<int> centroids;
    function<void(int, int, int&)> dfs = [&](int u, int p, int& current_size) {
        current_size = 1;
        int max_sub = 0;
        for (int v : adj[u]) {
            if (v != p && v != exclude) {
                int child_size = 0;
                dfs(v, u, child_size);
                current_size += child_size;
                max_sub = max(max_sub, child_size);
            }
        }
        max_sub = max(max_sub, total_size-current_size);
        if (max_sub <= total_size / 2) {
            centroids.push_back(u);
        }
    };
    int dummy = 0;
    dfs(root, exclude, dummy);
    return centroids;
}

ll solve() {
    int n;
    cin >> n;
    for (int i = 1; i <= n; ++i) adj[i].clear();
    vector<pair<int, int>> edges;
    for (int i = 0; i < n-1; ++i) {
        int u, v;
        cin >> u >> v;
        adj[u].push_back(v);
        adj[v].push_back(u);
        edges.emplace_back(u, v);
    }
    ll ans = 0;
    for (auto& e : edges) {
        int u = e.first, v = e.second;
        // 计算分割后两个子树的大小
        int s = compute_size(u, -1, v);
        int t = n-s;
        // 查找两个子树的重心
        vector<int> c1 = find_centroids(u, v, s);
        vector<int> c2 = find_centroids(v, u, t);
        // 累加重心编号
        for (int x : c1) ans += x;
        for (int x : c2) ans += x;
    }
    return ans;
}

int main() {
    ios::sync_with_stdio(false);
    cin.tie(0);
    int T;
    cin >> T;
    while (T--) {
        cout << solve() << '\n';
    }
    return 0;
}
方法思路
1、子树大小计算:对于每条边,删除后会得到两个子树,需要分别计算这两个子树的大小。
2、重心查找:对于每个子树,遍历其所有节点,判断每个节点是否为该子树的重心。判断条件是:删除该节点后,其所有子树的大小(包括父方向的子树)均不超过子树总大小的一半。
3、遍历所有边:对每条边,分别处理分割后的两个子树,找到各自的重心并求和,最终累加所有边的结果。
代码解释
1、compute_size函数:计算以u为根,排除exclude节点的子树大小。通过递归遍历子树,累加所有子节点的大小(排除父节点和exclude节点)。
2、find_centroids函数:查找以root为根,排除exclude节点的子树的所有重心。使用深度优先搜索(DFS)遍历子树,计算每个节点的最大子树大小(包括父方向的子树大小),判断是否为重心。
3、solve函数:处理每组测试用例,读取树的结构,遍历每条边,计算分割后两个子树的大小,查找各自的重心并累加结果。
该方法通过递归和深度优先搜索高效处理每个子树的重心查找,确保了时间复杂度在合理范围内,能够处理题目给定的数据规模。
种树(tree)
【题目描述】
你是一个森林养护员,有一天,你接到了一个任务:在一片森林内的地块上种树,并养护至树木长到指定的高度。
森林的地图有n片地块,其中1号地块连接森林的入口。共有n−1条道路连接这些地块,使得每片地块都能通过道路互相到达。最开始,每片地块上都没有树木。
你的目标是:在每片地块上均种植一棵树木,并使得i号地块上的树的高度生长到不低于ai米。
你每天可以选择一个未种树且与某个已种树的地块直接邻接(即通过单条道路相.连)的地块,种一棵高度为0米的树。如果所有地块均已种过树,则你当天不进行任何操作。特别地,第1天你只能在1号空地种树。
对每个地块而言,从该地块被种下树的当天开始,该地块上的树每天都会生长一定的高度。由于气候和土壤条件不同,在第x天,i号地块上的树会长高max(bi+x∗ci,1)
米。注意这里的x是从整个任务的第一天,而非种下这棵树的第一天开始计算。
你想知道:最少需要多少天能够完成你的任务?
【输入格式】
从文件tree.in中读入数据。
输入的第一行包含一个正整数n,表示森林的地块数量。
接下来n行:每行包含三个整数ai,bi,ci,分别描述一片地块,含义如题目描述中所述。
接下来n−1行:每行包含两个正整数ui,vi,表示一条连接地块ui和vi的道路。
【输出格式】
输出到文件tree.out中。
输出一行仅包含一个正整数,表示完成任务所需的最少天数。
【样例1输入】
【样例1输出】
【样例1解释】
第1天:在地块1种树,地块1的树木长高至2米。
第2天:在地块3种树,地块1,3的树木分别长高至5,3米。
第3天:在地块4种树,地块1,3,4的树木分别长高至9,6,4米。
第4天:在地块2种树,地块1,2,3,4的树木分别长高至14,1,9,6米。
第5天:地块1,2,3,4的树木分别长高至20,2,12,7米。
【样例2】
见选手目录下的tree/tree2.in与tree/tree2.ans。
【样例3】
见选手目录下的tree/tree3.in与tree/tree3.ans。
【样例4】
见选手目录下的tree/tree4.in与tree/tree4.ans。
【数据范围】
对于所有测试数据有:1≤n≤105,1≤ai≤1018,1≤bi≤109,0≤|ci|≤109,1≤ui,vi≤n。保证存在方案能在109天内完成任务
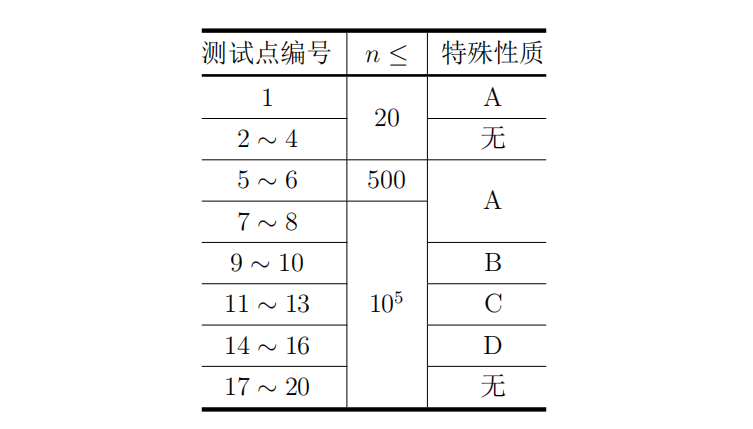
特殊性质A:对于所有1≤i≤n,均有ci=0;
特殊性质B:对于所有1≤i<n,均有ui=i,vi=i+1;
特殊性质C:与任何地块直接相连的道路均不超过2条;
特殊性质D:对于所有1≤i<n,均有ui=1。
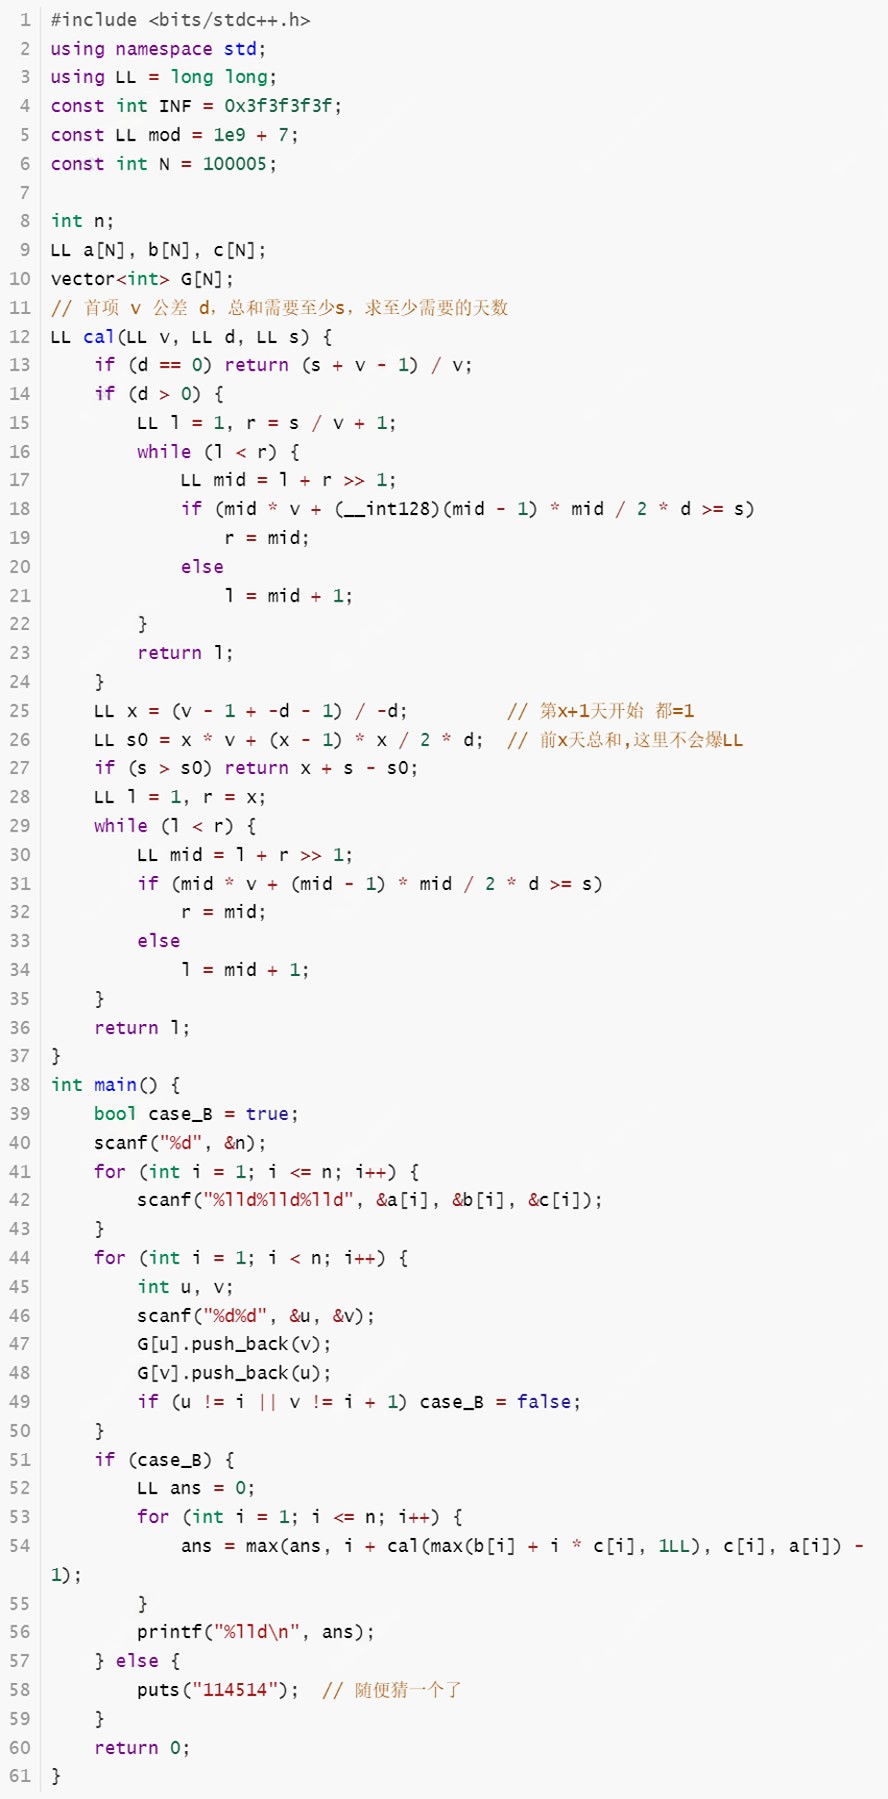
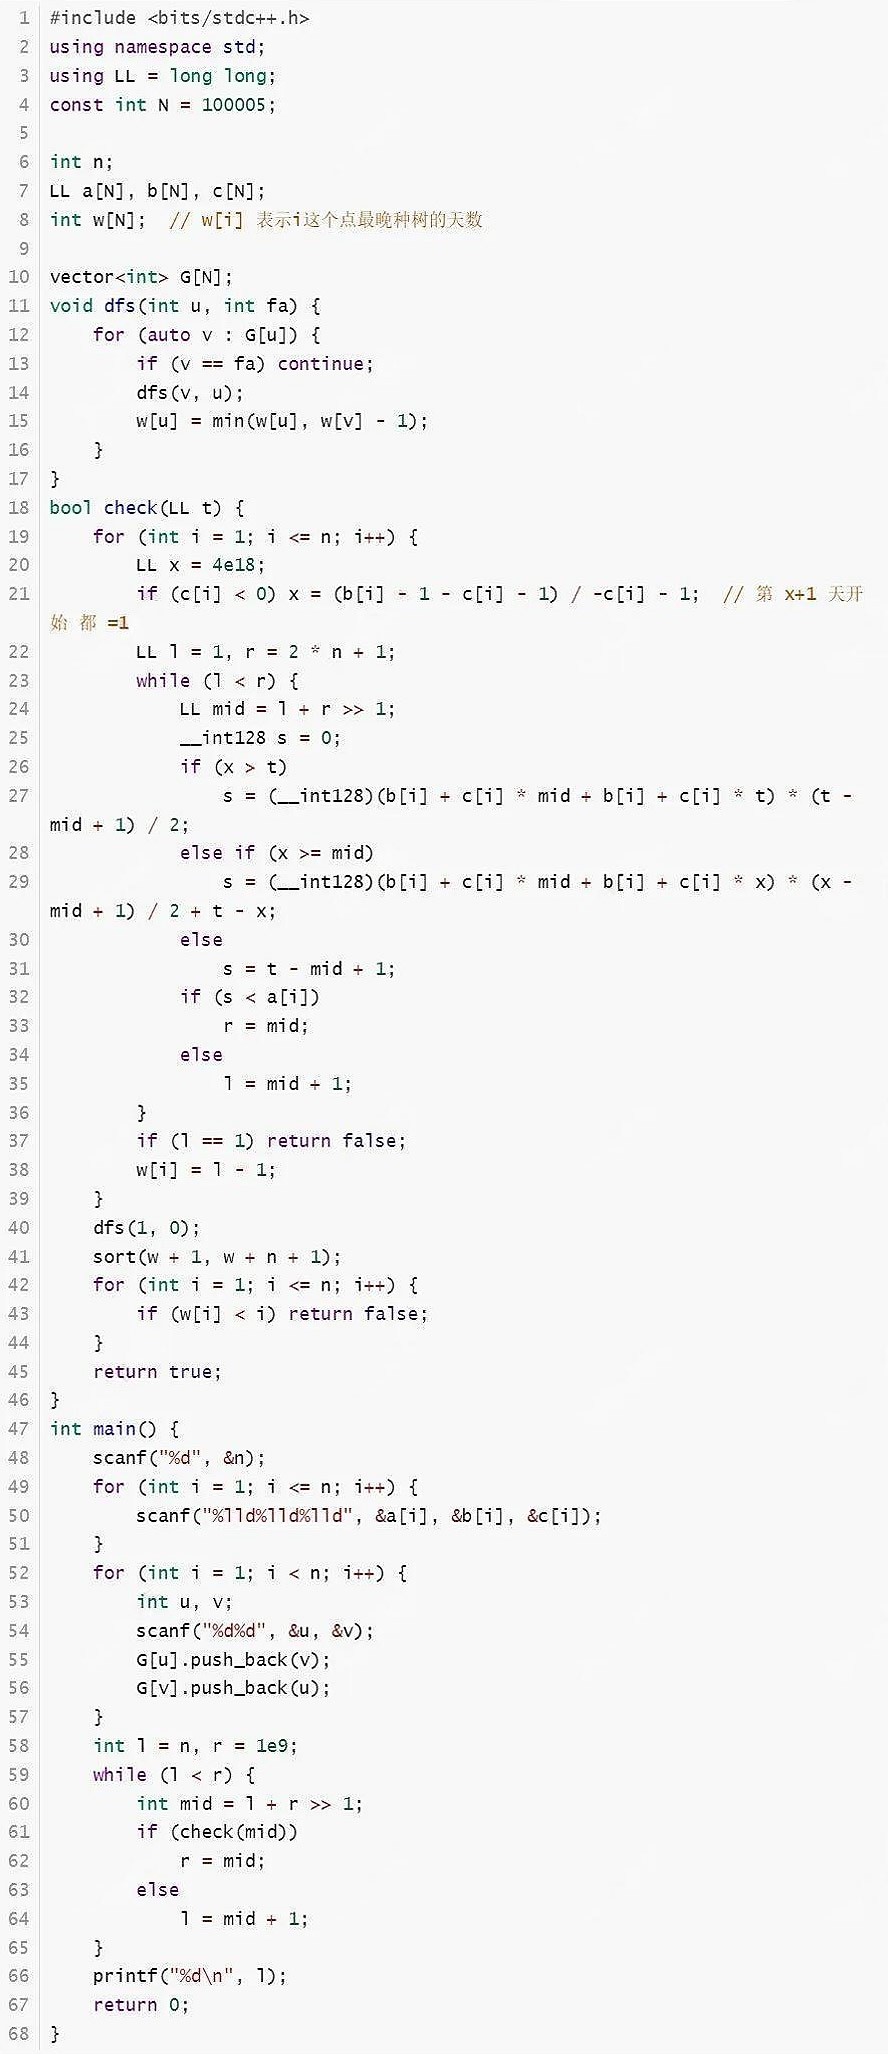
题解1:
题解2:
2-3树是一种特殊的树,它满足两个条件:
(1)每个内部结点有两个或三个子结点;
(2)所有的叶结点到根的路径长度相同。
如果一棵2-3树有10个叶结点,那么它可能有( )个非叶结点。
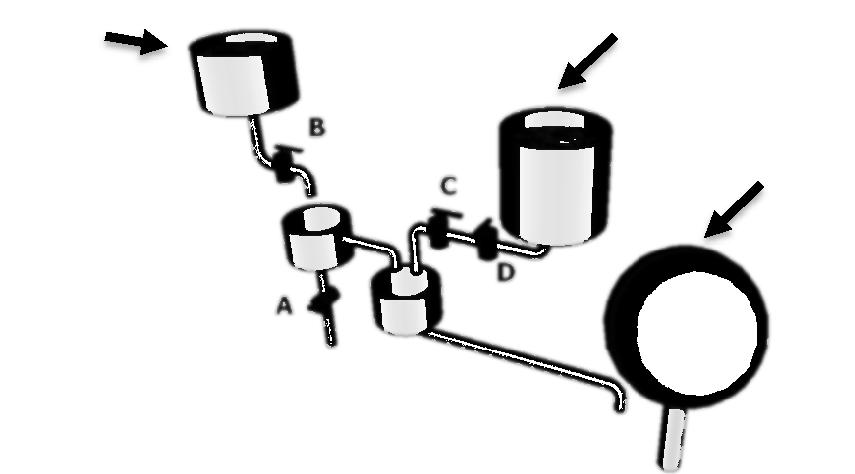
下图表示一个果园灌溉系统,有A、B、C、D四个阀门,每个阀门可以打开或关上,所有管道粗细相同,以下设置阀门的方法中,可以让果树浇上水的有( )。
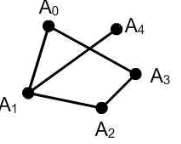
以 A0 作为起点,对下面的无向图进行深度优先遍历时(遍历的顺序与顶点字母的下标无关),最后一个遍历到的顶点可能是( )。
从顶点 A0出发,对有向图( )进行广度优先搜索(BFS)时,一种可能的遍历顺序是 A0, A1, A2, A3, A4。
对于一棵二叉树,独立集是指两两互不相邻的节点构成的集合。例如,图1有5个不同的独立集(1个双点集合、3个单点集合、1个空集),图2有14个不同的独立集。那么,图3有 个不同的独立集。
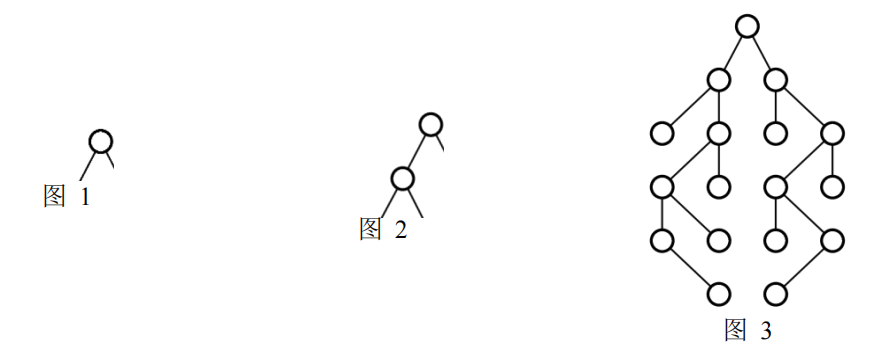
5536
现有一段文言文,要通过二进制哈夫曼编码进行压缩。简单起见,假设这段文言文只由 4 个汉字“之”、“乎”、“者”、“也”组成,它们出现的次数分别为 700、600、300、400。那么,“也”字的编码长度可能是( )。
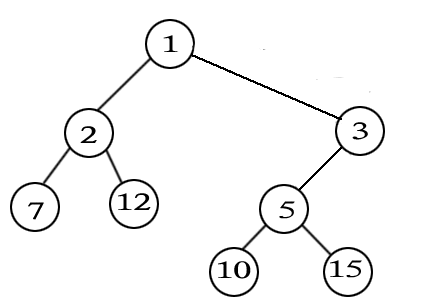
(笛卡尔树)对于一个给定的两两不等的正整数序列,笛卡尔树是这样的一棵二叉树:首先,它是一个最小堆,即除了根结点,每个节点的权值都大雨父节点的权值;其次,它的中序遍历恰好就是给定的序列。例如,对于序列7、2、12、1、10、5、15、3,下图就是一棵对应的笛卡尔树。现输入序列的规模n(1≤n<100)和序列的 n 个元素,试求其对应的笛卡尔树的深度 d(根节点深度为1),以及有多少个叶子节点的深度为d。
#include<iostream>
using namespace std;
const int SIZE=100+5;
const int INFINITY=1000000;
int n,a[SIZE],maxDeep,num;
void solve(int left,int right,int deep)
{
int i,j,min;
if(deep>maxDeep){
maxDeep=deep;
num=1;
}
else if(deep==maxDeep)
① ;
min= INFINITY;
for(i=left;i<=right;i++)
if(min>a[i]){
min=a[i];
② ;
}
if(left<j)
③ ;
if(j<right)
④ ;
}
int main()
{
int i;
cin>>n;
for(i=1;i<=n;i++)
cin>>a[i];
maxDeep=0;
solve(1,n,1);
cout<<maxDeep<<' '<<num<<endl;
return 0;
}
① num++
② j = i
③ solve(left, j – 1, deep + 1)
④ solve(j + 1, right, deep + 1)
天天爱跑步
【问题描述】
小c 同学认为跑步非常有趣,于是决定制作一款叫做《天天爱跑步》的游戏。《天天爱跑步》是一个养成类游戏,需要玩家每天按时上线,完成打卡任务。
这个游戏的地图可以看作一一棵包含 n 个结点和 n−1 条边的树,每条边连接两个结点,且任意两个结点存在一条路径互相可达。树上结点编号为从 1 到 n 的连续正整数。
现在有 m 个玩家,第 i 个玩家的起点为 si,终点为 Ti。每天打卡任务开始时,所有玩家在第 0 秒同时从自己的起点出发,以每秒跑一条边的速度,不间断地沿着最短路径向着自己的终点跑去,跑到终点后该玩家就算完成了打卡任务。 (由于地图是一棵树,所以每个人的路径是唯一的)
小c 想知道游戏的活跃度,所以在每个结点上都放置了一个观察员。在结点 j 的观察员会选择在第 wj 秒观察玩家,一个玩家能被这个观察员观察到当且仅当该玩家在第 wj 秒也正好到达了结点 j。小c 想知道每个观察员会观察到多少人?
注意:我们认为一个玩家到达自己的终点后该玩家就会结束游戏,他不能等待一 段时间后再被观察员观察到。 即对于把结点 j 作为终点的玩家:若他在第 wj 秒前到达终点,则在结点 j 的观察员不能观察到该玩家;若他正好在第 wj 秒到达终点,则在结点 j 的观察员可以观察到这个玩家。
【输入格式】
从文件running.in中读入数据。
第一行有两个整数 n 和 m。其中 n 代表树的结点数量, 同时也是观察员的数量, m 代表玩家的数量。
接下来 n−1 行每行两个整数 u 和 v,表示结点 u 到结点 v 有一条边。
接下来一行 n 个整数,其中第 j 个整数为 wj , 表示结点 j 出现观察员的时间。
接下来 m 行,每行两个整数 Si,和 Ti,表示一个玩家的起点和终点。
对于所有的数据,保证 1≤Si,Ti≤n,0≤Wj≤n。
【输出格式】
输出到文件running.out中。
输出 1 行 n 个整数,第 j 个整数表示结点 j 的观察员可以观察到多少人。
【样例1输入】
6 3
2 3
1 2
1 4
4 5
4 6
0 2 5 1 2 3
1 5
1 3
2 6
【样例1输出】
2 0 0 1 1 1
【样例1说明】
对于 1 号点,w1=0,故只有起点为 1 号点的玩家才会被观察到,所以玩家 1 和玩家 2 被观察到,共有 2 人被观察到。
对于 2 号点,没有玩家在第 2 秒时在此结点,共 0 人被观察到。
对于 3 号点,没有玩家在第 5 秒时在此结点,共 0 人被观察到。
对于 4 号点,玩家 1 被观察到,共 1 人被观察到。
对于 5 号点,玩家 1 被观察到,共 1 人被观察到。
对于 6 号点,玩家 3 被观察到,共 1 人被观察到。
【样例2输入】
5 3
1 2
2 3
2 4
1 5
0 1 0 3 0
3 1
1 4
5 5
【样例2输出】
1 2 1 0 1
【子任务】
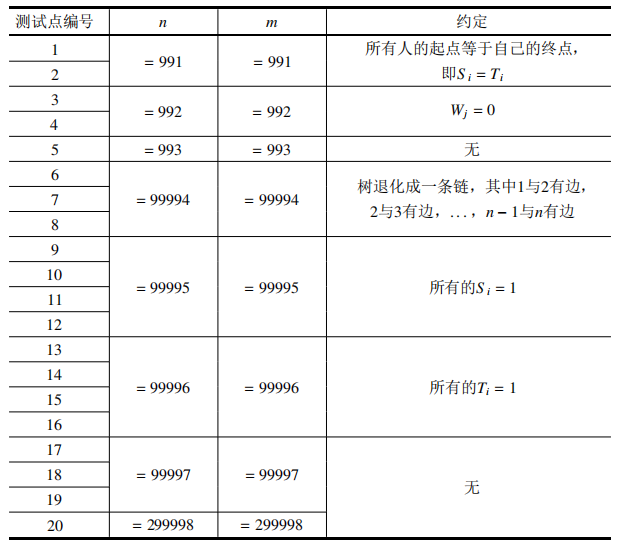
每个测试点的数据规模及特点如下表所示。提示: 数据范围的个位上的数字可以帮助判断是哪一种数据类型。
【提示】
如果你的程序需要用到较大的栈空间 (这通常意味着需要较深层数的递归), 请务必仔细阅读选手目录下的文本文档 running/stack.pdf, 以了解在最终评测时栈空间的限制与在当前工作环境下调整栈空间限制的方法。
#include<bits/stdc++.h>
using namespace std;
const int SIZE=300000;
int n, m, tot, h[SIZE], deep[SIZE], fa[SIZE][20], w[SIZE];
struct edge
{
int to, next;
}E[SIZE*2], e1[SIZE*2], e2[SIZE*2];
void add(int x, int y)
{
E[++tot].to=y;
E[tot].next=h[x];
h[x]=tot;
}
int tot1, tot2, h1[SIZE], h2[SIZE];
void add1(int x, int y)
{
e1[++tot1].to=y;
e1[tot1].next=h1[x];
h1[x]=tot1;
}
void add2(int x, int y)
{
e2[++tot2].to=y;
e2[tot2].next=h2[x];
h2[x]=tot2;
}
void dfs1(int x)
{
for(int i=1; (1<<i)<=deep[x]; i++)
fa[x][i]=fa[fa[x][i-1]][i-1];
for(int i=h[x]; i; i=E[i].next)
{
int y=E[i].to;
if(y==fa[x][0]) continue;
fa[y][0]=x;
deep[y]=deep[x]+1;
dfs1(y);
}
}
int get_lca(int x, int y)
{
if(x==y) return x;
if(deep[x]<deep[y]) swap(x, y);
int t=log(deep[x]-deep[y])/log(2);
for(int i=t; i>=0; i--)
{
if(deep[fa[x][i]]>=deep[y])
x=fa[x][i];
if(x==y)
return x;
}
t=log(deep[x])/log(2);
for(int i=t; i>=0; i--)
{
if(fa[x][i]!=fa[y][i])
x=fa[x][i], y=fa[y][i];
}
return fa[x][0];
}
int b1[SIZE*2], b2[SIZE*2], js[SIZE], dist[SIZE], s[SIZE], t[SIZE], l[SIZE], ans[SIZE];
void dfs2(int x)
{
int t1=b1[w[x]+deep[x]], t2=b2[w[x]-deep[x]+SIZE];
for(int i=h[x]; i; i=E[i].next)
{
int y=E[i].to;
if(y==fa[x][0]) continue;
dfs2(y);
}
b1[deep[x]]+=js[x];
for(int i=h1[x]; i; i=e1[i].next)
{
int y=e1[i].to;
b2[dist[y]-deep[t[y]]+SIZE]++;
}
ans[x]+=b1[w[x]+deep[x]]-t1+b2[w[x]-deep[x]+SIZE]-t2;
for(int i=h2[x]; i; i=e2[i].next)
{
int y=e2[i].to;
b1[deep[s[y]]]--;
b2[dist[y]-deep[t[y]]+SIZE]--;
}
}
int main()
{
scanf("%d%d", &n, &m);
for(int i=1; i<n; i++)
{
int u, v;
scanf("%d%d", &u, &v);
add(u, v);
add(v, u);
}
deep[1]=1;
fa[1][0]=1;
dfs1(1);
for(int i=1; i<=n; i++) scanf("%d", &w[i]);
for(int i=1; i<=m; i++)
{
scanf("%d%d", &s[i], &t[i]);
int lca=get_lca(s[i], t[i]);
dist[i]=deep[s[i]]+deep[t[i]]-2*deep[lca];
js[s[i]]++;
add1(t[i], i);
add2(lca, i);
if(deep[lca]+w[lca]==deep[s[i]]) ans[lca]--;
}
dfs2(1);
for(int i=1; i<=n; i++) printf("%d ", ans[i]);
return 0;
}
括号树
【题目背景】
本题中合法括号串的定义如下:
1.0是合法括号串。
2.如果A是合法括号串,则(A)是合法括号串。
3.如果A, B是合法括号串,则AB是合法括号串。
本题中子串与不同的子串的定义如下:
1.字符串S的子串是S中连续的任意个字符组成的字符串。S的子串可用起始位置l与终止位置r来表示,记为S(l,r)(1≤l≤r≤|S|,|S|表示S的长度)。
2.S的两个子串视作不同当且仅当它们在S中的位置不同,即l不同或r不同。
【题目描述】
一个大小为n的树包含n个结点和n-1条边,每条边连接两个结点,且任意两个 结点间有且仅有一条简单路径互相可达。
小Q是一个充满好奇心的小朋友,有一天他在上学的路上碰见了一个大小为n的 树,树上结点从1~n编号,1号结点为树的根。除1号结点外,每个结点有一个父亲 结点,u (2≤ u≤n)号结点的父亲为fu (1 ≤ fu < u)号结点。
小Q发现这个树的每个结点上恰有一个括号,可能是'('或')'。小Q定义si为:将 根结点到i号结点的简单路径上的括号,按结点经过顺序依次排列组成的字符串。
显然si是个括号串,但不一定是合法括号串,因此现在小Q想对所有的i(1≤i≤n) 求岀,si中有多少个互不相同的子串是合法括号串。
这个问题难倒了小Q,他只好向你求助。设si共有ki个不同子串是合法括号串, 你只需要告诉小Q所有ixki的异或和,即:
(1 x k1) xor (2 x k2) xor (3 x k3)xor .…xor (n x kn)其中xor是位异或运算。
【输入格式】
从文件brackets.in中读入数据。
第一行一个整数n,表示树的大小。
第二行一个长为n的由'('与')'组成的括号串,第i个括号表示i号结点上的括号。
第三行包含n-1个整数,第i(1≤i<n)个整数表示i+1号结点的父亲编号fi+1。
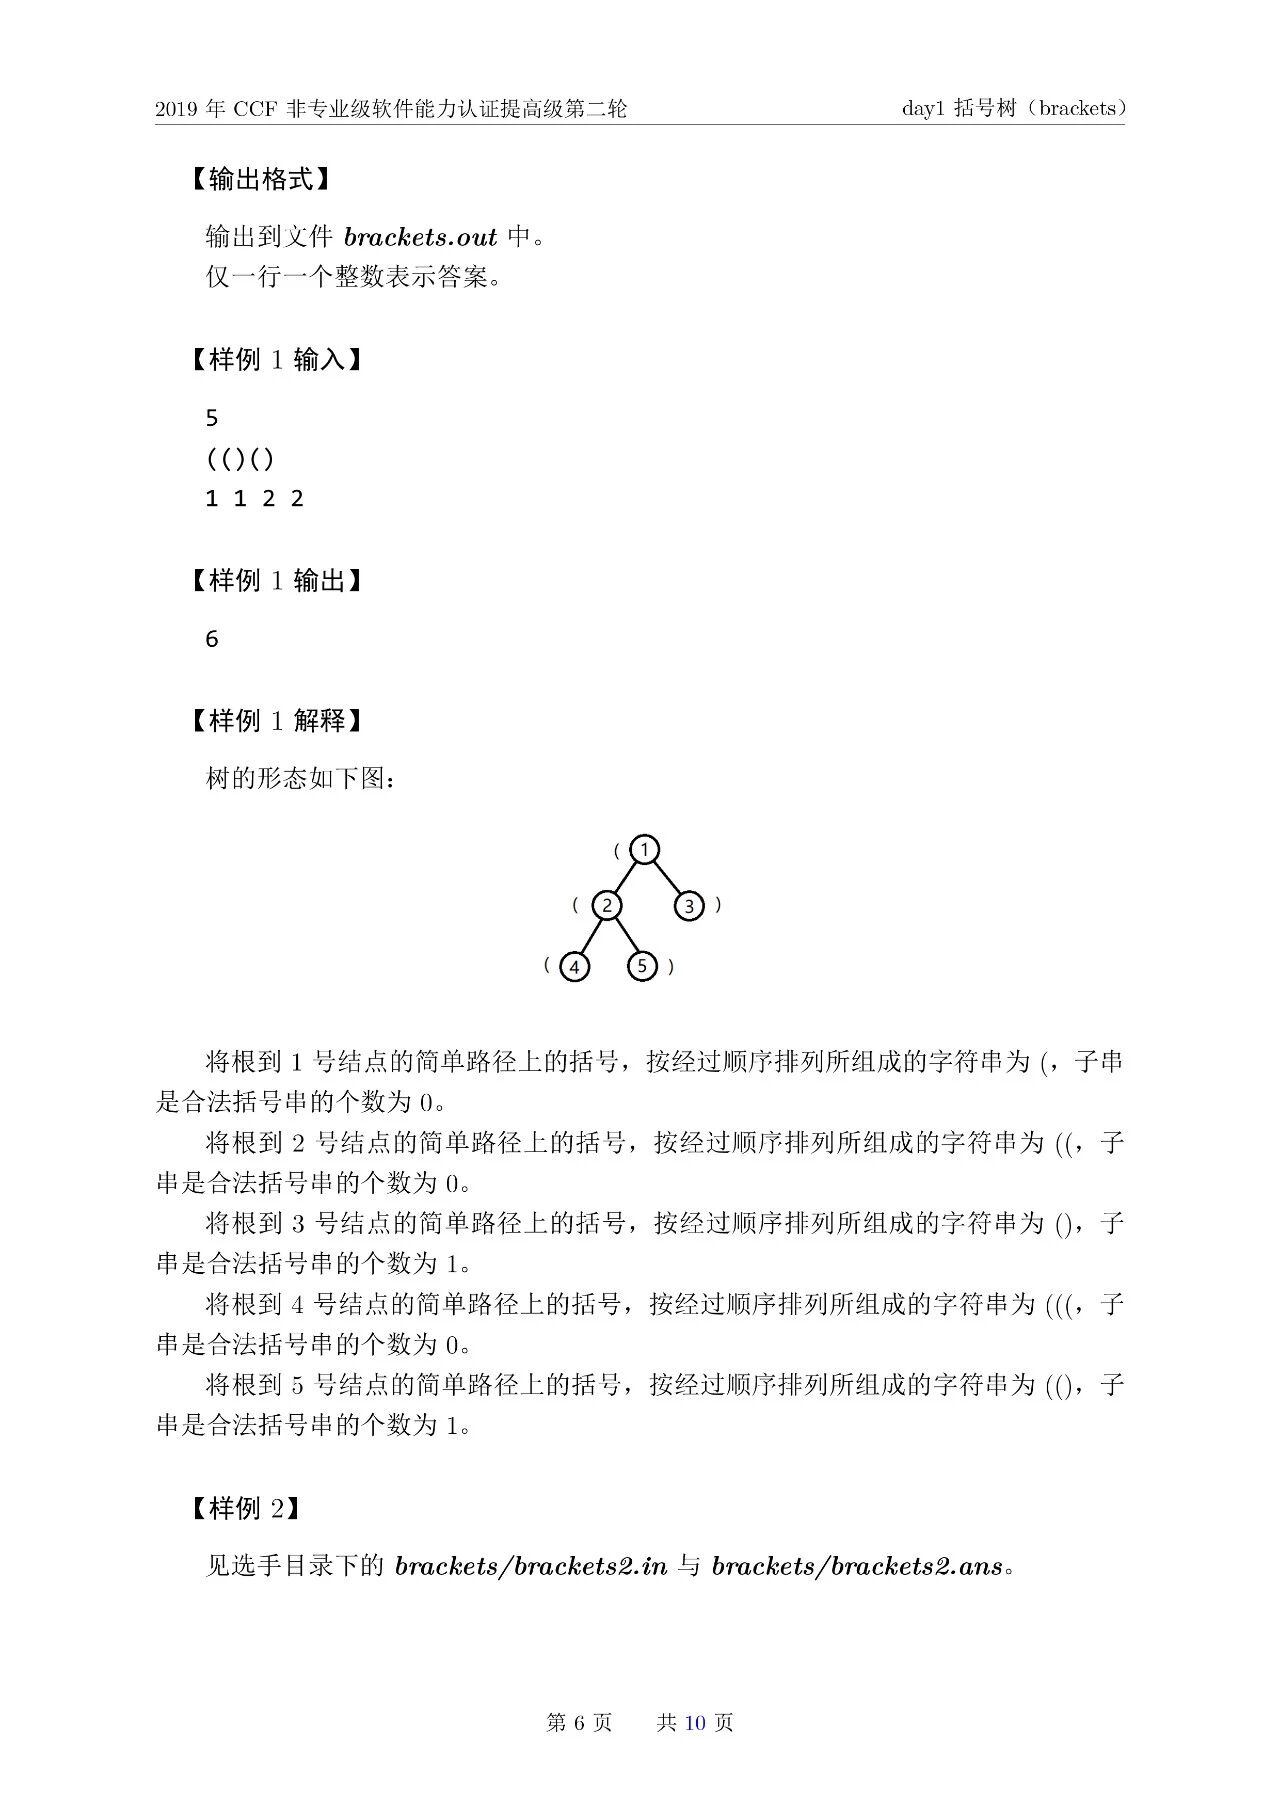
【输出格式】
输出到文件brackets.out中。
仅一行一个整数表示答案。
【样例1输入】
5
(()()
1 1 2 2
【样例1输出】
6
【样例1解释】
树的形态如下图:
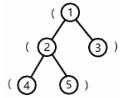
将根到1号结点的简单路径上的括号,按经过顺序排列所组成的字符串为(,子串 是合法括号串的个数为0。
将根到2号结点的简单路径上的括号,按经过顺序排列所组成的字符串为((,子 串是合法括号串的个数为0。
将根到3号结点的简单路径上的括号,按经过顺序排列所组成的字符串为(),子 串是合法括号串的个数为1。
将根到4号结点的简单路径上的括号,按经过顺序排列所组成的字符串为(((,子 串是合法括号串的个数为0。
将根到5号结点的简单路径上的括号,按经过顺序排列所组成的字符串为((),子 串是合法括号串的个数为1。
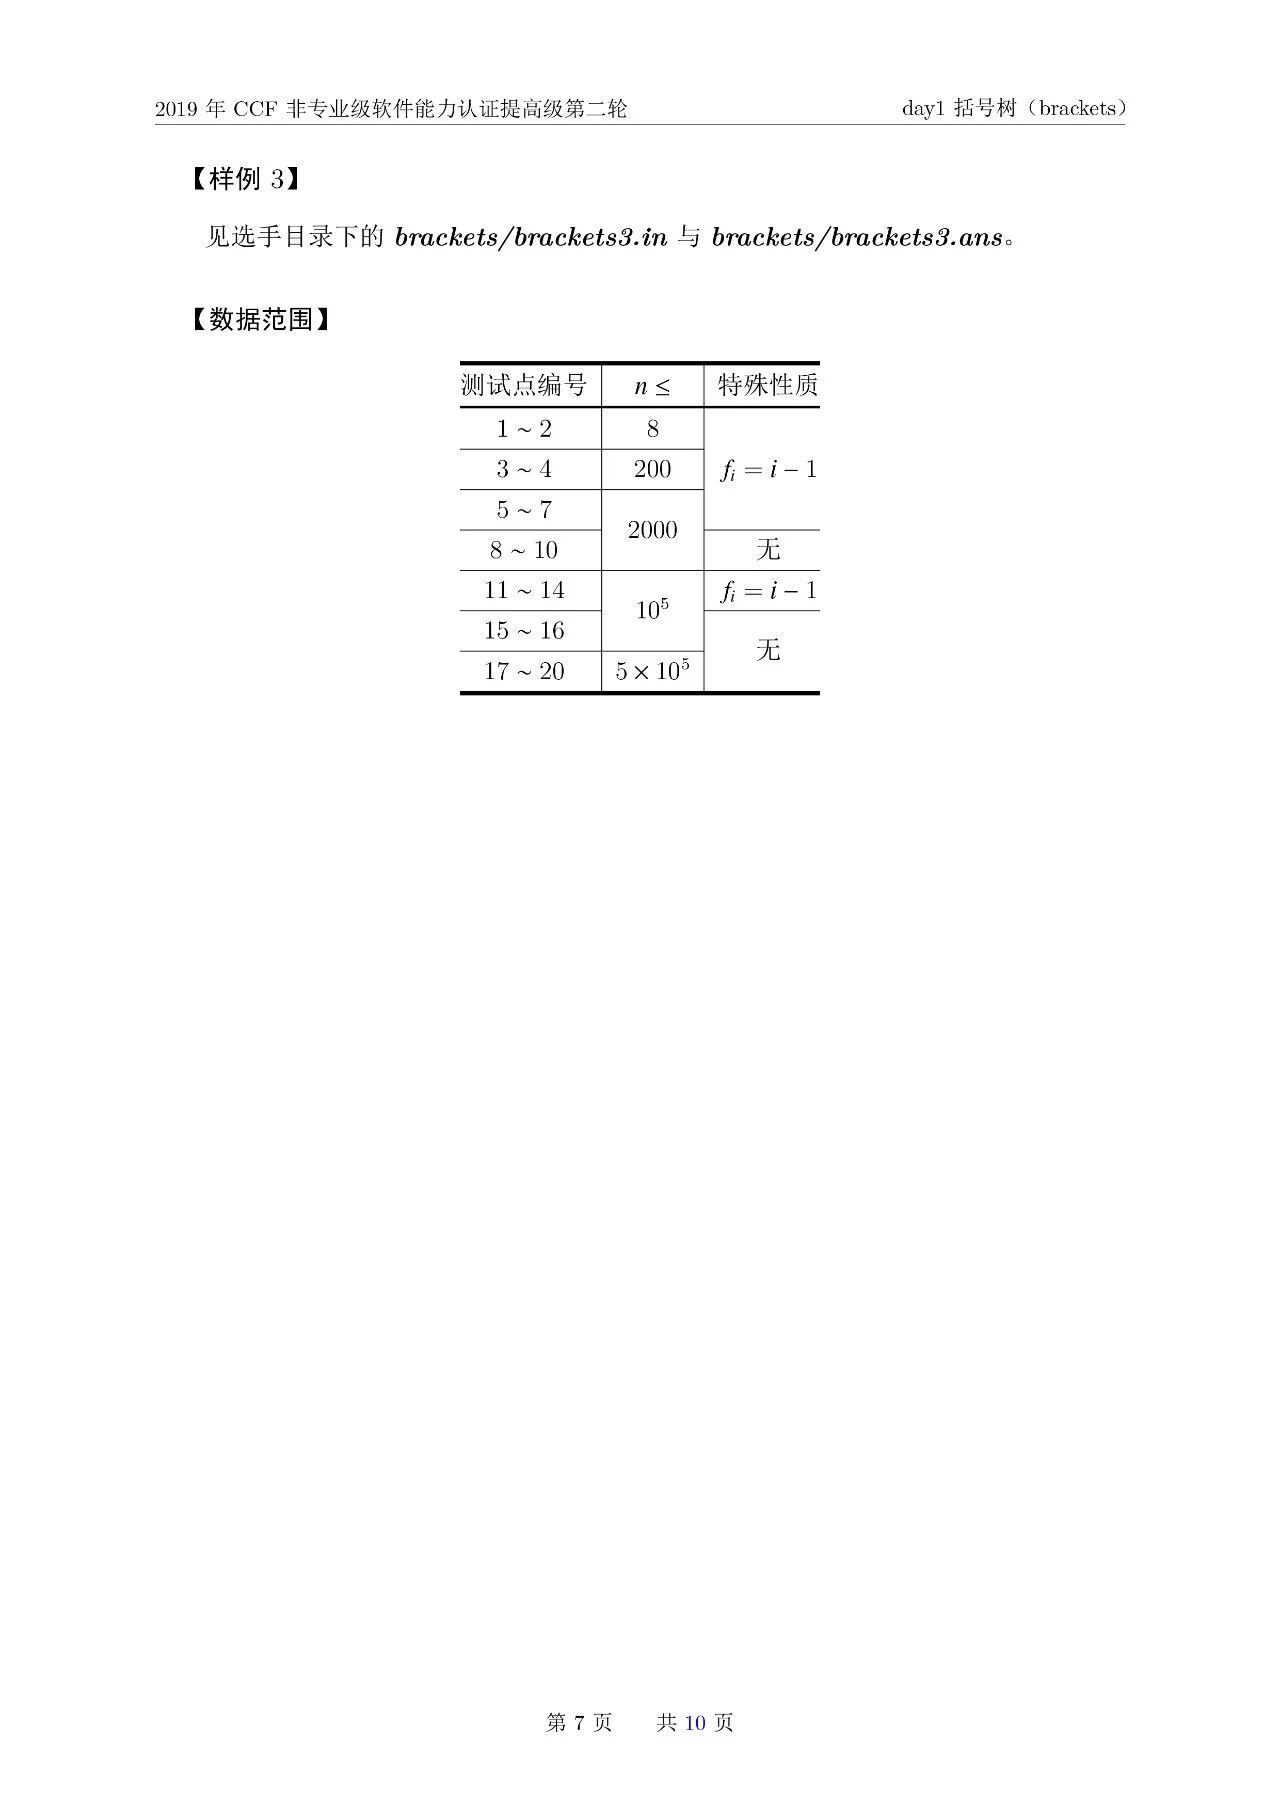
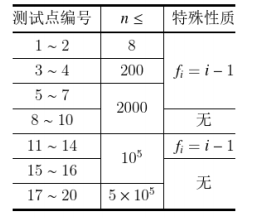
【数据范围】
#include <iostream>
#include <cstdio>
#include <vector>
#include <stack>
typedef long long ll;
const int maxn = 500005;
std :: vector <int> G[maxn];
std :: stack <int> bra;
char str[maxn];
int fa[maxn];
ll con[maxn], k[maxn];
void dfs(int u) {
int num = 0;
if (str[u] == '(')
bra.push(u);
else if (!bra.empty()){
num = bra.top();
bra.pop();
con[u] = con[fa[num]] + 1;
}
k[u] = k[fa[u]] + con[u];
for (int i = 0; i < G[u].size(); ++i)
dfs(G[u][i]);
if (num != 0)
bra.push(num);
else if (!bra.empty())
bra.pop();
return ;
}
int main() {
int n;
std :: scanf("%d", &n);
std :: scanf("%s", str + 1);
for (int i = 2; i <= n; ++i) {
std :: scanf("%d", &fa[i]);
G[fa[i]].push_back(i);
}
ll ans = 0;
dfs(1);
for (int i = 1; i <= n; ++i)
ans ^= k[i] * (ll)i;
std :: printf("%lld\n", ans);
return 0;
}