信息学奥赛-提高级 题库
(容器分水)有两个容器,容器 1 的容量为为 a 升,容器 2 的容量为 b 升;同时允许下列的三种操作,分别为:
1)FILL(i):用水龙头将容器 i(i∈{1,2})灌满水;
2)DROP(i):将容器 i 的水倒进下水道;
3)POUR(i,j):将容器 i 的水倒进容器 j(完成此操作后,要么容器 j 被灌满,要么容器 i 被清空)。
求只使用上述的两个容器和三种操作,获得恰好 c 升水的最少操作数和操作序列。上述 a、b、c 均为不超过 100 的正整数,且 c≤max{a,b}。
试补全程序。
#include <bits/stdc++.h>
using namespace std;
const int N = 110;
int f[N][N];
int ans;
int a, b, c;
int init;
int dfs(int x, int y) {
if (f[x][y] != init)
return f[x][y];
if (x == c || y == c)
return f[x][y] = 0;
f[x][y] = init - 1;
f[x][y] = min(f[x][y], dfs(a, y) + 1);
f[x][y] = min(f[x][y], dfs(x, b) + 1);
f[x][y] = min(f[x][y], dfs(0, y) + 1);
f[x][y] = min(f[x][y], dfs(x, 0) + 1);
int t = min(a - x, y);
f[x][y] = min(f[x][y], ① );
t = min(x, b - y);
f[x][y] = min(f[x][y], ② );
return f[x][y];
}
void go(int x, int y) {
if ( ③ )
return;
if (f[x][y] == dfs(a, y) + 1) {
cout << "FILL(1)" << endl;
go(a, y);
} else if (f[x][y] == dfs(x, b) + 1) {
cout << "FILL(2)" << endl;
go(x, b);
} else if (f[x][y] == dfs(0, y) + 1) {
cout << "DROP(1)" << endl;
go(0, y);
} else if (f[x][y] == dfs(x, 0) + 1) {
cout << "DROP(2)" << endl;
go(x, 0);
} else {
int t = min(a - x, y);
if (f[x][y] == ④ ) {
cout << "POUR(2,1)" << endl;
go(x + t, y - t);
} else {
t = min(x, b - y);
if (f[x][y] == ⑤ ) {
cout << "POUR(1,2)" << endl;
go(x - t, y + t);
} else
assert(0);
}
}
}
int main() {
cin >> a >> b >> c;
ans = 1 << 30;
memset(f, 127, sizeof f);
init = **f;
if ((ans = dfs(0, 0)) == init - 1)
cout << "impossible";
else {
cout << ans << endl;
go(0, 0);
}
}
#include <cstdio>
using namespace std;
int n;
int a[100];
int main( ) {
scanf(“%d”,&n);
for(int i = 1; i <= n; ++i) {
scanf(“%d”,&a[i])
int ans = 1
for (int i = 1; i <= n; ++i) {
if ( i > 1 && a[i] < a[i-1])
ans = i ;
while (ans < n && a[i] >= a[ans+1])
++ans;
printf(“%d/n”, ans);
}
return 0;
}
#include <cstdio>
using namepace std ;
const int maxn =1000;
int n;
int fa[maxn],cnt [maxn];
int getroot(int v ) {
if (fa[v] == v) return v;
return getroot(fa[v]);
}
int main ( ) {
cin >> n;
for (int i =0;i<n;++i){
fa[i]=i;
cnt[i]=1;
}
int ans = 0 ;
for (int i=0; i<n - 1; ++i){
int a,b,x,y,;
cin >>a>>b
x=getRoot(a);
y=getRoot(b);
ans +=cnt[x]cnt[y];
fa[x]=y;
cnt[y] +=cnt[x];
}
cout<<ans<<endl;
return 0;
}
本题t是s的子序列的意思是:从s中删去若干个字符,可以得到t;特别的,如果s=t,那么t也是s的子序列;空串是任何串的子序列。例如“acd”是“abcde”的子序列,“acd”是“acd”的子序列,但“adc”不是“abcde”的子序列。
S[x…y]表示s[x]…s[y]共y-x+1个字符构成的字符串,若x>y则s[x…y]是空串。t[x…y]同理。
#include <cstdio>
#include <algorithm>
using namespace std;
const int max1 = 202;
string s, t ;
int pre[max1], suf[max1]
int main() {
cin>>s>>t;
int slen =s. length(), tlen= t. length();
for (int I = 0 ,j = 0 ; i< slen; ++i) {
if (j< tlen&&s[i]t[j] ) ++j;
pre[i] = j;// t[0…j-1]是s[0…i]的子序列
}
for (int I = slen -1 ,j= tlen -1; I >=0;–i) {
if(j>=0&& s[i] == t [j]) –j;
suf [i]= j; //t[j+1…tlen-1]是s[i…slen-1]的子序列
}
suf[slen] = tlen -1;
int ans = 0;
for (int i=0, j=0, tmp=o; i<=slen; ++i){
while(j<=slen && tmp >=suf[j] + 1) ++j;
ans =max(ans, j – I – 1);
tmp = pre[i];
}
cout <<ans << end1;
return 0;
}
提示:
t[0…pre[i]-1]是s[0…i]的子序列;
t[suf[i]+1…tlen-1]是s[i…slen-1]的子序列。
(匠人的自我修养)一个匠人决定要学习n个新技术,要想成功学习一个新技术,他不仅要拥有一定的经验值,而且还必须要先学会若干个相关的技术。学会一个新技术之后,他的经验值会增加一个对应的值。给定每个技术的学习条件和习得后获得的经验值,给定他已有的经验值,请问他最多能学会多少个新技术。
输入第一行有两个数,分别为新技术个数n(1≤n≤103),以及已有经验值(≤107)。
接下来n行。第i行的两个正整数,分别表示学习第i个技术所需的最低经验值(≤107),以及学会第i个技术后可获得的经验值(≤104)。
接下来n行。第i行的第一个数mi(0≤mi<n),表示第i个技术的相关技术数量。紧跟着m个两两不同的数,表示第i个技术的相关技术编号,输出最多能学会的新技术个数。
下面的程序已O(n2)的时间复杂完成这个问题,试补全程序。
#inclde
using namesoace std;
const int maxn = 1001;
int n;
int cnt [maxn]
int child [maxn] [maxn];
int unlock[maxn];
int unlock[maxn];
int threshold [maxn],bonus[maxn];
bool find(){
int target=-1;
for (int i = 1;i<=n;++i)
if(①&&②){
target = i;
break;
}
if(target-1)
return false;
unlock[target]=-1;
③;
for (int i=0;i<cut[target];++i)
④;
return true;
}
int main(){
scanf(“%d%d”,&n, &points);
for (int I =1; i<=n;++i={
cnt [i]=0;
scanf(“%d%d”,&threshold[i],&bonus[i];
}
for (int i=1;i<=n;++i={
int m;
scanf(“%d”,&m);
⑤;
for (int j=0; j<m ;++j={
int fa;
scanf(“%d”, &fa);
child [fa][cnt[fa]]=i;
++cnt[fa];
}
}
int ans = 0;
while(find())
++ans;
printf(“%d\n”, ans);
return 0;
}
(取石子)Alice和Bob两个人在玩取石子游戏。他们制定了n条取石子的规则,第i条规则为:如果剩余石子的个数大于等于a[i]且大于等于b[il, 那么他们可以取走b[i]个石子。他们轮流取石子。如果轮到某个人取石子, 而他无法按照任何规则取走石子,那么他就输了。一开始石子有m个。请问先取石子的人是否有必胜的方法?
输入第一行有两个正整数,分别为规则个数n(1≤n≤64),以及石子个数m(≤10^7)。
接下来n行。第i行有两个正整数a[i]和b[i](1≤a[i]≤10^7,1≤b[i]≤64)
如果先取石子的人必胜,那么输出“Win”,否则输出“Loss”
提示:
可以使用动态规划解决这个问题。由于b[i]不超过64,所以可以使用64位无符号整数去压缩必要的状态。
status是胜负状态的二进制压缩,trans是状态转移的二进制压缩。
试补全程序。
代码说明:
“~”表示二进制补码运算符,它将每个二进制位的0变成1、1变为0;
而“^”表示二进制异或运算符,它将两个参与运算的数中的每个对应的二进制位一一进行比较,若两个二进制位相同,则运算结果的对应二进制位为0,反之为1。
ull标识符表示它前面的数字是unsigned long long 类型。
#include <cstdio>
#include<algorithm>
using namespace std ;
const int maxn =64;
int n,m;
int a[maxn],b[maxn];
unsigned long long status ,trans;
bool win;
int main() {
scanf("%d%d", &n, &m);
for (int i = 0; i<n; ++i)
scanf("%d%d", &a[i], &b[i]);
for(int i = 0; i < n; ++i)
for(int j = i + 1; j < n; ++j)
if (a[i] > a[j]) {
swap(a[i],a[j]);
swap(b[i],b[j]);
}
status = ___(1)___;
trans = 0;
for(int i = 1, j = 0; i <= m; ++i) {
while (j < n && ___(2)___) {
___(3)___
++j;
}
win = ___(4)___;
___(5)___;
}
puts(win ? "Win" : "Loss");
return 0;
}
蚯蚓
【问题描述】
本题中,我们将用符号 表示对c向下取整,例如:
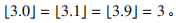
蛐蛐国最近蚯蚓成灾了!隔壁跳蚤国的跳蚤也拿蚯蚓们没办法,蛐蛐国王只好去请神刀手来帮他们消灭蚯蚓。
蛐蛐国里现在共有 n 只蚯蚓(n 为正整数)。每只蚯蚓拥有长度,我们设第 i 只蚯蚓的长度为 ai(i=1,2,…,n),并保证所有的长度都是非负整数(即:可能存在长度为 0的蚯蚓)。
每一秒,神刀手会在所有的蚯蚓中,准确地找到最长的那一只(如有多个则任选一个)将其切成两半。神刀手切开蚯蚓的位置由常数 p(是满足 0 < p < 1 的有理数)决定,设这只蚯蚓长度为 x,神刀手会将其切成两只长度分别为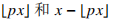 的蚯蚓。特殊地,如果这两个数的其中一个等于 0则这个长度为 0 的蚯蚓也会被保留。此外,除了刚刚产生的两只新蚯蚓,其余蚯蚓的长度都会增加 q(是一个非负整常数)。
蛐蛐国王知道这样不是长久之计,因为蚯蚓不仅会越来越多,还会越来越长。蛐蛐国王决定求助于一位有着洪荒之力的神秘人物,但是救兵还需要 m 秒才能到来……(m 为非负整数)
蛐蛐国王希望知道这 m秒内的战况。具体来说,他希望知道:
m 秒内,每一秒被切断的蚯蚓被切断前的长度(有 m 个数);
m 秒后,所有蚯蚓的长度(有 n+m 个数)。
蛐蛐国王当然知道怎么做啦!但是他想考考你……
【输入格式】
从文件earthworm.in中读入数据。
第一行包含六个整数 n , m , q , u , v , t 其中:n , m , q的意义见【问题描述】;u , v , t均为正整数;你需要自己计算 p = u / v(保证 0 < u < v)t 是输出参数,其含义将会在【输出格式】中解释。
第二行包含 n 个非负整数,为 a 1 , a 2 , … , a n即初始时 n 只蚯蚓的长度。
同一行中相邻的两个数之间,恰好用一个空格隔开。
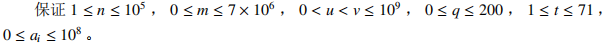
【输出格式】
输出到文件earthworm.out中。
第一行输出 个整数,按时间顺序,依次输出第 t 秒,第 2t 秒,第 3t 秒,……被切断蚯蚓(在被切断前)的长度。
第二行输出 个整数,输出 m 秒后蚯蚓的长度;需要按从大到小的顺序,依次输出排名第 t ,第 2t,第3t,……的长度。
同一行中相邻的两个数之间,恰好用一个空格隔开。即使某一行没有任何数需要输出,你也应输出一个空行。
请阅读样例来更好地理解这个格式。
【样例1输入】
3 7 1 1 3 1
3 3 2
【样例1输出】
3 4 4 4 5 5 6
6 6 6 5 5 4 4 3 2 2
【样例1说明】
在神刀手到来前:3 只蚯蚓的长度为3,3,2。
1 秒后:一只长度为3 的蚯蚓被切成了两只长度分别为1 和2 的蚯蚓,其余蚯蚓的长度增加了1。最终4 只蚯蚓的长度分别为(1,2),4,3。括号表示这个位置刚刚有一只蚯蚓被切断。
2 秒后:一只长度为4 的蚯蚓被切成了1 和3 。5 只蚯蚓的长度分别为:2,3,(1,3),4。
3秒后:一只长度为4 的蚯蚓被切断。6 只蚯蚓的长度分别为:3,4,2,4,(1,3)。
4 秒后:一只长度为4 的蚯蚓被切断。7 只蚯蚓的长度分别为:4,(1,3),3,5,2,4。
5 秒后:一只长度为5 的蚯蚓被切断。8 只蚯蚓的长度分别为:5,2,4,4,(1,4),3,5。
6 秒后:一只长度为5 的蚯蚓被切断。9 只蚯蚓的长度分别为:(1,4),3,5,5,2,5,4,6。
7 秒后:一只长度为6 的蚯蚓被切断。10 只蚯蚓的长度分别为:2,5,4,6,6,3,6,5,(2,4)。
所以,7 秒内被切断的蚯蚓的长度依次为3,4,4,4,5,5,6。7 秒后,所有蚯蚓长度从大到小排序为 6,6,6,5,5,4,4,3,2,2。
【样例2输入】
3 7 1 1 3 2
3 3 2
【样例2输出】
4 4 5
6 5 4 3 2
【样例2说明】
这个数据中只有t=2与上个数据不同。只需在每行都改为每两个数输出一个数即可。
虽然第一行最后有一个6 没有被输出,但是第二行仍然要重新从第二个数再开始输出。
【样例3输入】
3 7 1 1 3 9
3 3 2
【样例3输出】
2
【样例3说明】
这个数据中只有t=9与上个数据不同。
注意第一行没有数要输出,但也要输出一个空行。
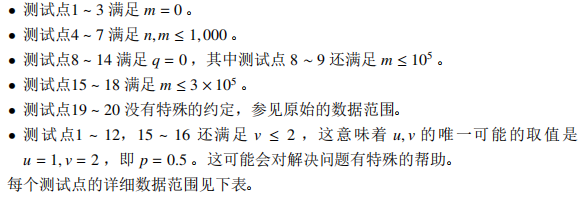
【子任务】
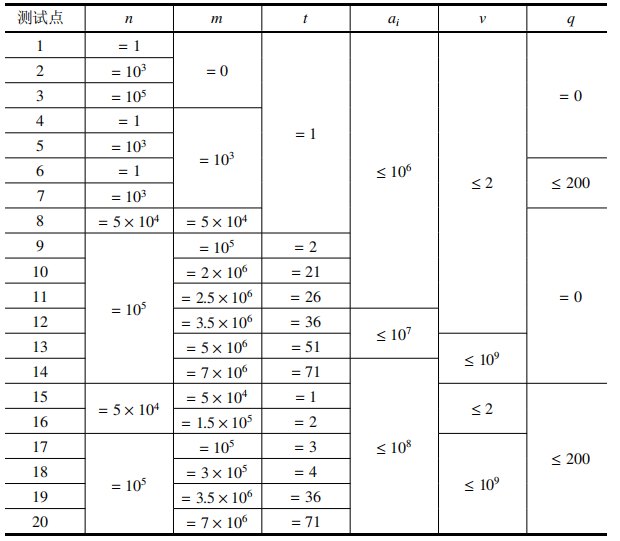
#include <bits/stdc++.h>
using namespace std;
double m,Q,u,v;
int t,n;
int cnt=0,tot=0,num=1;
double p;
int dd;
int ans1[(int)7e6+5];
int a[(int)7e6+5];
queue<int>q1;
queue<int>q2;
queue<int>q3;
inline int read() {
int X = 0, F = 1;
char C = getchar();
while (C < '0' || C>'9') {
if (C == '-') {
F = -1;
}
C = getchar();
}
while (C >= '0' && C <= '9') {
X = (X << 3) + (X << 1) + C - '0';
C = getchar();
}
return X * F;
}
inline void write(int N) {
if (N < 0) {
putchar('-');
N = -N;
}
if (N >= 10) {
write(N / 10);
}
putchar(N % 10 + '0');
}
inline int Get() {
int x1=INT_MIN,x2=INT_MIN,x3=INT_MIN;
if(!q1.empty())
x1=q1.front();
if(!q2.empty())
x2=q2.front();
if(!q3.empty())
x3=q3.front();
if(x1>=x2&&x1>=x3) {
q1.pop();
return x1;
} else if(x2>=x3) {
q2.pop();
return x2;
} else {
q3.pop();
return x3;
}
}//那个公式
int main() {
n=read();
m=read();
Q=read();
u=read();
v=read();
t=read();
p=(double)u/v;
for(register int i=1; i<=n; ++i) {
ans1[i]=read();
}
sort(ans1+1,ans1+n+1, greater<int>());//排序后再压入
for(register int i=1;i<=n;i++){
q1.push(ans1[i]);
}
int tag=0;
for(register int i=1; i<=m; ++i) {
int d=Get();
d+=tag;
a[i]=d;
int tad=d*p;
q2.push(tad-tag-Q);//截断后的第一节
q3.push(d-tad-tag-Q);//第二节
tag+=Q;
}
for(register int i=t; i<=m; i+=t) {
write(a[i]);
printf(" ");
}
puts("");
while(!q1.empty()||!q2.empty()||!q3.empty()) {
int u=Get();
if(num%t==0) {
write(u+tag);//因为前面减了一个tag,现在加上
printf(" ");
}
num++;
}
return 0;
}
玩具谜题
【问题描述】
小南有一套可爱的玩具小人,它们各有不同的职业。
有一天,这些玩具小人把小南的眼镜藏了起来。小南发现玩具小人们围成了一个圈,它们有的面朝圈内,有的面朝圈外。如下图:
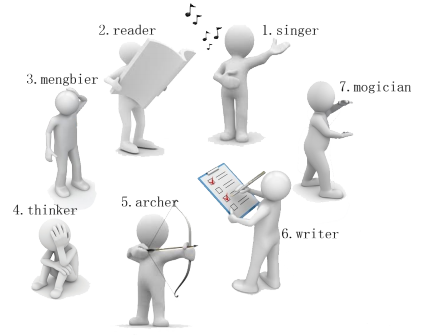
这时singer告诉小南一个谜题:“眼镜藏在我左数第3个玩具小人的右数第1个玩 具小人的左数第2个玩具小人那里。”
小南发现,这个谜题中玩具小人的朝向非常关键,因为朝内和朝外的玩具小人的左右方向是相反的:面朝圈内的玩具小人,它的左边是顺时针方向,右边是逆时针方向;而面向圈外的玩具小人,它的左边是逆时针方向,右边是顺时针方向。
小南一边艰难地辨认着玩具小人,一边数着:
“singer朝内,左数第3个是archer。
“archer朝外,右数第1个是thinker。
“thinker朝外,左数第2个是writer。
“所以眼镜藏在writer这里!”
虽然成功找回了眼镜,但小南并没有放心。如果下次有更多的玩具小人藏他的眼镜,或是谜题的长度更长,他可能就无法找到眼镜了。所以小南希望你写程序帮他解决类似的谜题。这样的谜题具体可以描述为:
有n个玩具小人围成一圈,已知它们的职业和朝向。现在第1个玩具小人告诉小南一个包含m条指令的谜题,其中第i条指令形如“左数/右数第Si个玩具小人”。你需要输出依次数完这些指令后,到达的玩具小人的职业。
【输入格式】
从文件toy.in中读入数据。
输入的第一行包含两个正整数n, m,表示玩具小人的个数和指令的条数。
接下来n行,每行包含一个整数和一个字符串,以 逆时针 为顺序给出每个玩具小人的朝向和职业。其中0表示朝向圈内,1表示朝向圈外。保证不会出现其他的数。字符串长度不超过10且仅由小写字母构成,字符串不为空,并且字符串两两不同。整数和字符串之间用一个空格隔开。
接下来m行,其中第i行包含两个整数ai, si,表示第i条指令。若ai=0,表示向左数Si个人;若ai=1,表示向右数si个人。保证ai不会出现其他的数,1<=Si<n。
【输出格式】
输出到文件toy.out中。
输出一个字符串,表示从第一个读入的小人开始,依次数完m条指令后到达的小人的职业。
【样例1输入】
7 3
0 singer
0 reader
0 mengbier
1 thinker
1 archer
0 writer
1 mogician
0 3
1 1
0 2
【样例1输出】
writer
【样例1说明】
这组数据就是【问题描述】中提到的例子。
【样例2输入】
10 10
1 c
0 r
0 p
1 d
1 e
1 m
1 t
1 y
1 u
0 v
1 7
1 1
1 4
0 5
0 3
0 1
1 6
1 2
0 8
0 4
【样例2输出】
y
【子任务】
子任务会给出部分测试数据的特点。如果你在解决题目中遇到了困难,可以尝试只解决一部分测试数据。
每个测试点的数据规模及特点如下表:
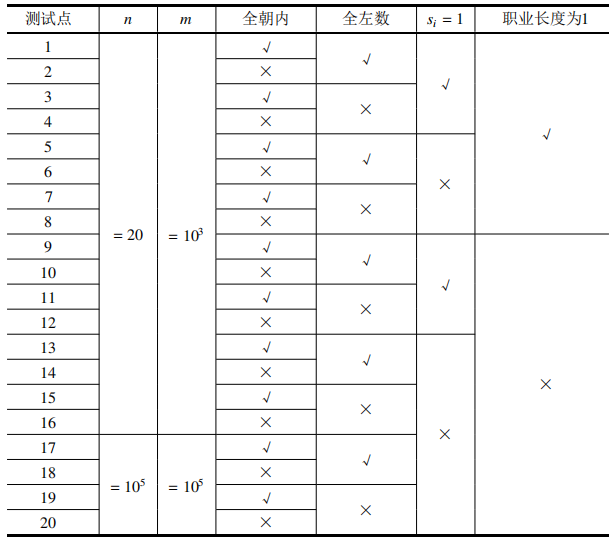
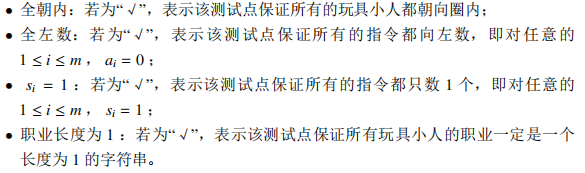
其中一些简写的列意义如下:
#include<bits/stdc++.h>
using namespace std;
const int maxn=1e6+5;
int n,m,ans=1;
int x,y;
char job[maxn][100];//job存储职业
int out[maxn];//out存储小人朝向
inline int read()//读入优化
{
int x=0,f=1;
char ch=getchar();
while(ch<'0' || ch>'9'){if(ch=='-') f=-1;ch=getchar();}
while(ch>='0' && ch<='9'){x=10*x+ch-'0';ch=getchar();}
return x*f;
}
void init()
{
freopen("input.txt","r",stdin);
}
void readdata()
{
n=read(),m=read();
for(int i=0;i<n;i++)
{
scanf("%d",&out[i]);
scanf("%s",job[i]);
}
}
void work()
{
int now=0;
for(int i=1;i<=m;i++)
{
x=read(),y=read();
if(out[now]==0 && x==0) now=(now+n-y)%n;//这儿分四种情况,out[now]为0则朝圈内,再x=0时往左数,找出现在的now,下面的亦是如此。
else if(out[now]==0 && x==1) now=(now+y)%n;
else if(out[now]==1 && x==0) now=(now+y)%n;
else if(out[now]==1 && x==1) now=(now+n-y)%n;//但注意我们存储职业时是按照逆时针的顺序存储的,所以在面向圈外并按照小人右手数时,要减y,可以动手操作下
}
printf("%s",job[now]);
}
int main()
{
// init();
readdata();
work();
return 0;
}
天天爱跑步
【问题描述】
小c 同学认为跑步非常有趣,于是决定制作一款叫做《天天爱跑步》的游戏。《天天爱跑步》是一个养成类游戏,需要玩家每天按时上线,完成打卡任务。
这个游戏的地图可以看作一一棵包含 n 个结点和 n−1 条边的树,每条边连接两个结点,且任意两个结点存在一条路径互相可达。树上结点编号为从 1 到 n 的连续正整数。
现在有 m 个玩家,第 i 个玩家的起点为 si,终点为 Ti。每天打卡任务开始时,所有玩家在第 0 秒同时从自己的起点出发,以每秒跑一条边的速度,不间断地沿着最短路径向着自己的终点跑去,跑到终点后该玩家就算完成了打卡任务。 (由于地图是一棵树,所以每个人的路径是唯一的)
小c 想知道游戏的活跃度,所以在每个结点上都放置了一个观察员。在结点 j 的观察员会选择在第 wj 秒观察玩家,一个玩家能被这个观察员观察到当且仅当该玩家在第 wj 秒也正好到达了结点 j。小c 想知道每个观察员会观察到多少人?
注意:我们认为一个玩家到达自己的终点后该玩家就会结束游戏,他不能等待一 段时间后再被观察员观察到。 即对于把结点 j 作为终点的玩家:若他在第 wj 秒前到达终点,则在结点 j 的观察员不能观察到该玩家;若他正好在第 wj 秒到达终点,则在结点 j 的观察员可以观察到这个玩家。
【输入格式】
从文件running.in中读入数据。
第一行有两个整数 n 和 m。其中 n 代表树的结点数量, 同时也是观察员的数量, m 代表玩家的数量。
接下来 n−1 行每行两个整数 u 和 v,表示结点 u 到结点 v 有一条边。
接下来一行 n 个整数,其中第 j 个整数为 wj , 表示结点 j 出现观察员的时间。
接下来 m 行,每行两个整数 Si,和 Ti,表示一个玩家的起点和终点。
对于所有的数据,保证 1≤Si,Ti≤n,0≤Wj≤n。
【输出格式】
输出到文件running.out中。
输出 1 行 n 个整数,第 j 个整数表示结点 j 的观察员可以观察到多少人。
【样例1输入】
6 3
2 3
1 2
1 4
4 5
4 6
0 2 5 1 2 3
1 5
1 3
2 6
【样例1输出】
2 0 0 1 1 1
【样例1说明】
对于 1 号点,w1=0,故只有起点为 1 号点的玩家才会被观察到,所以玩家 1 和玩家 2 被观察到,共有 2 人被观察到。
对于 2 号点,没有玩家在第 2 秒时在此结点,共 0 人被观察到。
对于 3 号点,没有玩家在第 5 秒时在此结点,共 0 人被观察到。
对于 4 号点,玩家 1 被观察到,共 1 人被观察到。
对于 5 号点,玩家 1 被观察到,共 1 人被观察到。
对于 6 号点,玩家 3 被观察到,共 1 人被观察到。
【样例2输入】
5 3
1 2
2 3
2 4
1 5
0 1 0 3 0
3 1
1 4
5 5
【样例2输出】
1 2 1 0 1
【子任务】
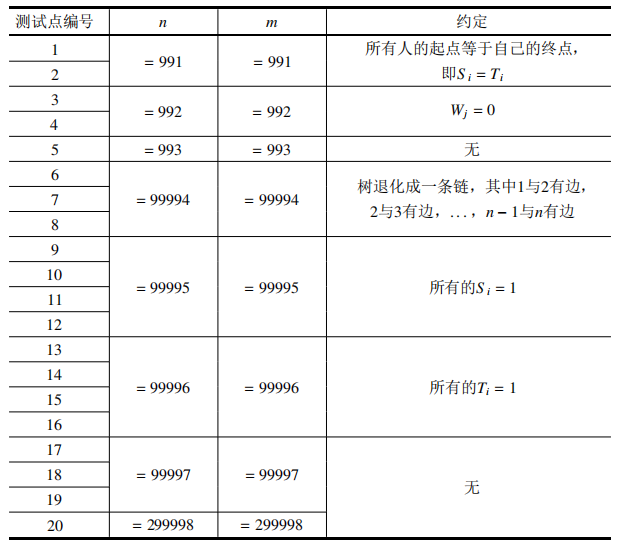
每个测试点的数据规模及特点如下表所示。提示: 数据范围的个位上的数字可以帮助判断是哪一种数据类型。
【提示】
如果你的程序需要用到较大的栈空间 (这通常意味着需要较深层数的递归), 请务必仔细阅读选手目录下的文本文档 running/stack.pdf, 以了解在最终评测时栈空间的限制与在当前工作环境下调整栈空间限制的方法。
#include<bits/stdc++.h>
using namespace std;
const int SIZE=300000;
int n, m, tot, h[SIZE], deep[SIZE], fa[SIZE][20], w[SIZE];
struct edge
{
int to, next;
}E[SIZE*2], e1[SIZE*2], e2[SIZE*2];
void add(int x, int y)
{
E[++tot].to=y;
E[tot].next=h[x];
h[x]=tot;
}
int tot1, tot2, h1[SIZE], h2[SIZE];
void add1(int x, int y)
{
e1[++tot1].to=y;
e1[tot1].next=h1[x];
h1[x]=tot1;
}
void add2(int x, int y)
{
e2[++tot2].to=y;
e2[tot2].next=h2[x];
h2[x]=tot2;
}
void dfs1(int x)
{
for(int i=1; (1<<i)<=deep[x]; i++)
fa[x][i]=fa[fa[x][i-1]][i-1];
for(int i=h[x]; i; i=E[i].next)
{
int y=E[i].to;
if(y==fa[x][0]) continue;
fa[y][0]=x;
deep[y]=deep[x]+1;
dfs1(y);
}
}
int get_lca(int x, int y)
{
if(x==y) return x;
if(deep[x]<deep[y]) swap(x, y);
int t=log(deep[x]-deep[y])/log(2);
for(int i=t; i>=0; i--)
{
if(deep[fa[x][i]]>=deep[y])
x=fa[x][i];
if(x==y)
return x;
}
t=log(deep[x])/log(2);
for(int i=t; i>=0; i--)
{
if(fa[x][i]!=fa[y][i])
x=fa[x][i], y=fa[y][i];
}
return fa[x][0];
}
int b1[SIZE*2], b2[SIZE*2], js[SIZE], dist[SIZE], s[SIZE], t[SIZE], l[SIZE], ans[SIZE];
void dfs2(int x)
{
int t1=b1[w[x]+deep[x]], t2=b2[w[x]-deep[x]+SIZE];
for(int i=h[x]; i; i=E[i].next)
{
int y=E[i].to;
if(y==fa[x][0]) continue;
dfs2(y);
}
b1[deep[x]]+=js[x];
for(int i=h1[x]; i; i=e1[i].next)
{
int y=e1[i].to;
b2[dist[y]-deep[t[y]]+SIZE]++;
}
ans[x]+=b1[w[x]+deep[x]]-t1+b2[w[x]-deep[x]+SIZE]-t2;
for(int i=h2[x]; i; i=e2[i].next)
{
int y=e2[i].to;
b1[deep[s[y]]]--;
b2[dist[y]-deep[t[y]]+SIZE]--;
}
}
int main()
{
scanf("%d%d", &n, &m);
for(int i=1; i<n; i++)
{
int u, v;
scanf("%d%d", &u, &v);
add(u, v);
add(v, u);
}
deep[1]=1;
fa[1][0]=1;
dfs1(1);
for(int i=1; i<=n; i++) scanf("%d", &w[i]);
for(int i=1; i<=m; i++)
{
scanf("%d%d", &s[i], &t[i]);
int lca=get_lca(s[i], t[i]);
dist[i]=deep[s[i]]+deep[t[i]]-2*deep[lca];
js[s[i]]++;
add1(t[i], i);
add2(lca, i);
if(deep[lca]+w[lca]==deep[s[i]]) ans[lca]--;
}
dfs2(1);
for(int i=1; i<=n; i++) printf("%d ", ans[i]);
return 0;
}
换教室
【问题描述】
对于刚上大学的牛牛来说,他面临的第一个问题是如何根据实际情况申请合适的课程。
在可以选择的课程中,有 2n 节课程安排在 n 个时间段上。在第 i(1≤i≤n)个时间段上,两节内容相同的课程同时在不同的地点进行,其中,牛牛预先被安排在教室 ci上课,而另一节课程在教室 di 进行。
在不提交任何申请的情况下,学生们需要按时间段的顺序依次完成所有的 n 节安排好的课程。如果学生想更换第 i 节课程的教室,则需要提出申请。若申请通过,学生就可以在第 i 个时间段去教室 di上课,否则仍然在教室 ci上课。
由于更换教室的需求太多,申请不一定能获得通过。通过计算,牛牛发现申请更换第 i 节课程的教室时,申请被通过的概率是一个已知的实数 ki,并且对于不同课程的申请,被通过的概率是互相独立的。
学校规定,所有的申请只能在学期开始前一次性提交,并且每个人只能选择至多 m 节课程进行申请。这意味着牛牛必须一次性决定是否申请更换每节课的教室,而不能根据某些课程的申请结果来决定其他课程是否申请;牛牛可以申请自己最希望更换教室的 m 门课程,也可以不用完这 m 个申请的机会,甚至可以一门课程都不申请。
因为不同的课程可能会被安排在不同的教室进行,所以牛牛需要利用课间时间从一间教室赶到另一间教室。
牛牛所在的大学有 v 个教室,有 e 条道路。每条道路连接两间教室,并且是可以双向通行的。由于道路的长度和拥堵程度不同,通过不同的道路耗费的体力可能会有所不同。
当第 i(1≤i≤n−1)节课结束后,牛牛就会从这节课的教室出发,选择一条耗费体力最少的路径前往下一节课的教室。
现在牛牛想知道,申请哪几门课程可以使他因在教室间移动耗费的体力值的总和的期望值最小,请你帮他求出这个最小值。
【输入格式】
从文件classroom.in中读入数据。
第一行四个整数 n,m,v,e。n 表示这个学期内的时间段的数量;m 表示牛牛最多可以申请更换多少节课程的教室;v 表示牛牛学校里教室的数量;e表示牛牛的学校里道路的数量。
第二行 n 个正整数,第 i(1≤i≤n)个正整数表示 ci,即第 i 个时间段牛牛被安排上课的教室;保证 1≤ci≤v。
第三行 n 个正整数,第 i(1≤i≤n)个正整数表示 di,即第 i 个时间段另一间上同样课程的教室;保证 1≤di≤v。
第四行 n 个实数,第 i(1≤i≤n)个实数表示 ki,即牛牛申请在第 i 个时间段更换教室获得通过的概率。保证0≤ki≤1。
接下来 e 行,每行三个正整数 aj,bj,wj,表示有一条双向道路连接教室 aj,bj,通过这条道路需要耗费的体力值是 wj;保证 1≤aj,bj≤v,1≤wj≤100。
保证1≤n≤2000,0≤m≤2000,1≤v≤300,0≤e≤90000。
保证通过学校里的道路,从任何一间教室出发,都能到达其他所有的教室。
保证输入的实数最多包含 3 位小数。
【输出格式】
输出到文件classroom.out中。
输出一行,包含一个实数,四舍五入精确到小数点后恰好2位,表示答案。你的输出必须和标准输出完全一样才算正确。
测试数据保证四舍五入后的答案和准确答案的差的绝对值不大于 4×10^−3。(如果你不知道什么是浮点误差,这段话可以理解为:对于大多数的算法,你可以正常地使用浮点数类型而不用对它进行特殊的处理)
【样例1输入】
3 2 3 3
2 1 2
1 2 1
0.8 0.2 0.5
1 2 5
1 3 3
2 3 1
【样例1输出】
2.80
【样例1说明】
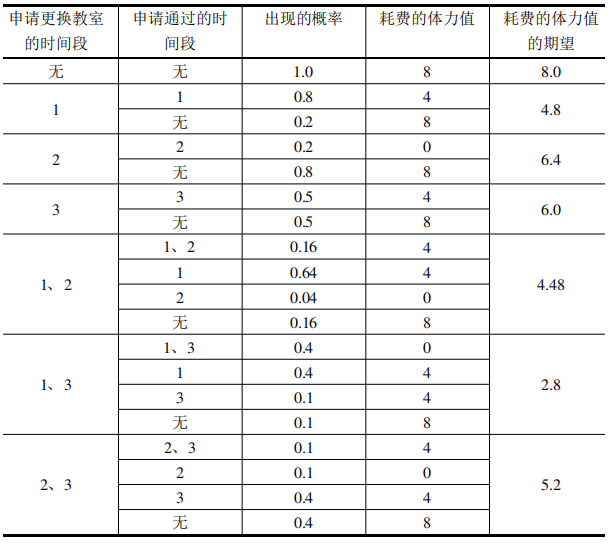
所有可行的申请方案和期望收益如下表:
【提示】
道路中可能会有多条双向道路连接相同的两间教室。也有可能有道路两端连接的是同一间教室。
请注意区分n,m,v,e的意义,n不是教室的数量,m不是道路的数量。
【子任务】
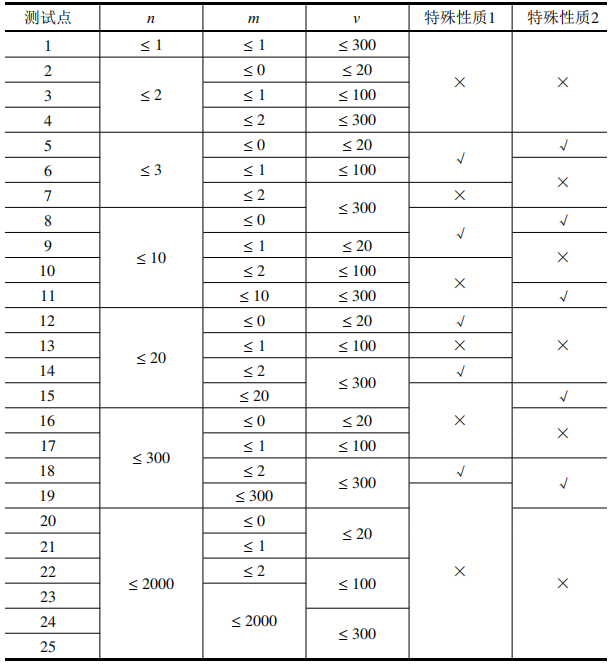
特殊性质1:图上任意两点ai,bi, 间,存在一条耗费体力最少的路径只包含一条道路。
特殊性质2:对于所有的1≤i≤n,ki=1。
#include <bits/stdc++.h>
using namespace std;
const int MAXN = 2e3 + 5;
const double inf = 1e17 + 5;
int n, m, v, e, c[MAXN][2], mp[305][305];
double k[MAXN], dp[MAXN][MAXN][2], ans;
inline int read() {
char ch = getchar(); int u = 0, f = 1;
while (!isdigit(ch)) {if (ch == '-')f = -1; ch = getchar();}
while (isdigit(ch)) {u = u * 10 + ch - 48; ch = getchar();}return u * f;
}
int main(){
memset(mp, 63, sizeof(mp));
n = read(); m = read(); v = read(); e = read();
for (register int i = 1; i <= n; i++)c[i][0] = read();
for (register int i = 1; i <= n; i++)c[i][1] = read();
for (register int i = 1; i <= n; i++)scanf("%lf", &k[i]);
for (register int i = 1; i <= e; i++){
int x = read(), y = read(), w = read();
mp[x][y] = mp[y][x] = min(mp[x][y], w);
}
for (register int k = 1; k <= v; k++)
for (register int i = 1; i <= v; i++)
for (register int j = 1; j <= v; j++)
mp[i][j] = min(mp[i][j], mp[i][k] + mp[k][j]);
for (register int i = 1; i <= v; i++)mp[i][i] = mp[i][0] = mp[0][i] = 0;
for (register int i = 0; i <= n; i++)
for (register int j = 0; j <= m; j++)dp[i][j][0] = dp[i][j][1] = inf;
dp[1][0][0] = dp[1][1][1] = 0;
for (register int i = 2; i <= n; i++){
dp[i][0][0] = dp[i - 1][0][0] + mp[c[i - 1][0]][c[i][0]];
for (register int j = 1; j <= min(i, m); j++){
int C1 = c[i - 1][0], C2 = c[i - 1][1], C3 = c[i][0], C4 = c[i][1];
dp[i][j][0] = min(dp[i][j][0], min(dp[i - 1][j][0] + mp[C1][C3], dp[i - 1][j][1] + mp[C1][C3] * (1 - k[i - 1]) + mp[C2][C3] * k[i - 1]));
dp[i][j][1] = min(dp[i][j][1], min(dp[i - 1][j - 1][0] + mp[C1][C3] * (1 - k[i]) + mp[C1][C4] * k[i], dp[i - 1][j - 1][1] + mp[C2][C4] * k[i] * k[i - 1] + mp[C2][C3] * k[i - 1] * (1 - k[i]) + mp[C1][C4] * (1 - k[i - 1]) * k[i] + mp[C1][C3] * (1 - k[i - 1]) * (1 - k[i])));
}
}
ans = inf;
for (register int i = 0; i <= m; i++)ans = min(ans, min(dp[n][i][0], dp[n][i][1]));
printf("%.2lf", ans);
return 0;
}
#include <iostream>
#include <cmath>
using namespace std;
const double r = acos(0.5);
int a1, b1, c1, d1;
int a2, b2, c2, d2;
inline int sq(const int x) { return x * x; }
inline int cu(const int x) { return x * x * x; }
int main()
{
cout.flags(ios::fixed);
cout.precision(4);
cin >> a1 >> b1 >> c1 >> d1;
cin >> a2 >> b2 >> c2 >> d2;
int t = sq(a1 - a2) + sq(b1 - b2) + sq(c1 - c2);
if (t <= sq(d2 - d1)) cout << cu(min(d1, d2)) * r * 4;
else if (t >= sq(d2 + d1)) cout << 0;
else {
double x = d1 - (sq(d1) - sq(d2) + t) / sqrt(t) / 2;
double y = d2 - (sq(d2) - sq(d1) + t) / sqrt(t) / 2;
cout << (x * x * (3 * d1 - x) + y * y * (3 * d2 - y)) * r;
}
cout << endl;
return 0;
}
假设输入的所有数的绝对值都不超过 1000,完成下面的判断题和单选题:
#include <algorithm>
#include <iostream>
using namespace std;
int n, a[1005];
struct Node
{
int h, j, m, w;
Node(const int _h, const int _j, const int _m, const int _w):
h(_h), j(_j), m(_m), w(_w)
{ }
Node operator+(const Node &o) const
{
return Node(
max(h, w + o.h),
max(max(j, o.j), m + o.h),
max(m + o.w, o.m),
w + o.w);
}
};
Node solve1(int h, int m)
{
if (h > m)
return Node(-1, -1, -1, -1);
if (h == m)
return Node(max(a[h], 0), max(a[h], 0), max(a[h], 0), a[h]);
int j = (h + m) >> 1;
return solve1(h, j) + solve1(j + 1, m);
}
int solve2(int h, int m)
{
if (h > m)
return -1;
if (h == m)
return max(a[h], 0);
int j = (h + m) >> 1;
int wh = 0, wm = 0;
int wht = 0, wmt = 0;
for (int i = j; i >= h; i--) {
wht += a[i];
wh = max(wh, wht);
}
for (int i = j + 1; i <= m; i++) {
wmt += a[i];
wm = max(wm, wmt);
}
return max(max(solve2(h, j), solve2(j + 1, m)), wh + wm);
}
int main()
{
cin >> n;
for (int i = 1; i <= n; i++) cin >> a[i];
cout << solve1(1, n).j << endl;
cout << solve2(1, n) << endl;
return 0;
}
假设输入的所有数的绝对值都不超过 1000,完成下面的判断题和单选题:
#include <iostream>
#include <string>
using namespace std;
char base[64];
char table[256];
void init()
{
for (int i = 0; i < 26; i++) base[i] = 'A' + i;
for (int i = 0; i < 26; i++) base[26 + i] = 'a' + i;
for (int i = 0; i < 10; i++) base[52 + i] = '0' + i;
base[62] = '+', base[63] = '/';
for (int i = 0; i < 256; i++) table[i] = 0xff;
for (int i = 0; i < 64; i++) table[base[i]] = i;
table['='] = 0;
}
string encode(string str)
{
string ret;
int i;
for (i = 0; i + 3 <= str.size(); i += 3) {
ret += base[str[i] >> 2];
ret += base[(str[i] & 0x03) << 4 | str[i + 1] >> 4];
ret += base[(str[i + 1] & 0x0f) << 2 | str[i + 2] >> 6];
ret += base[str[i + 2] & 0x3f];
}
if (i < str.size()) {
ret += base[str[i] >> 2];
if (i + 1 == str.size()) {
ret += base[(str[i] & 0x03) << 4];
ret += "==";
}
else {
ret += base[(str[i] & 0x03) << 4 | str[i + 1] >> 4];
ret += base[(str[i + 1] & 0x0f) << 2];
ret += "=";
}
}
return ret;
}
string decode(string str)
{
string ret;
int i;
for (i = 0; i < str.size(); i += 4) {
ret += table[str[i]] << 2 | table[str[i + 1]] >> 4;
if (str[i + 2] != '=')
ret += (table[str[i + 1]] & 0x0f) << 4 | table[str[i + 2]] >> 2;
if (str[i + 3] != '=')
ret += table[str[i + 2]] << 6 | table[str[i + 3]];
}
return ret;
}
int main()
{
init();
cout << int(table[0]) << endl;
int opt;
string str;
cin >> opt >> str;
cout << (opt ? decode(str) : encode(str)) << endl;
return 0;
}
假设输入总是合法的(一个整数和一个不含空白字符的字符串,用空格隔开),完成下面的判断题和单选题:
(魔法数字)小 H 的魔法数字是 4。给定n,他希望用若干个 4 进行若干次加法、减法和整除运算得到 n。但由于小 H 计算能力有限,计算过程中只能出现不超过M = 10000 的正整数。求至少可能用到多少个 4。
例如,当 n = 2 时,有 2 = (4 + 4)/4,用到了 3 个 4,是最优方案。
试补全程序。
#include <iostream>
#include <cstdlib>
#include <climits>
using namespace std;
const int M = 10000;
bool Vis[M + 1];
int F[M + 1];
void update(int &x, int y) {
if (y < x)
x = y;
}
int main() {
int n;
cin >> n;
for (int i = 0; i <= M; i++)
F[i] = INT_MAX;
①;
int r = 0;
while (②) {
r++;
int x = 0;
for (int i = 1; i <= M; i++)
if (③)
x = i;
Vis[x] = 1;
for (int i = 1; i <= M; i++)
if (④) {
int t = F[i] + F[x];
if (i + x <= M)
update(F[i + x], t);
if (i != x)
update(F[abs(i - x)], t);
if (i % x == 0)
update(F[i / x], t);
if (x % i == 0)
update(F[x / i], t);
}
}
cout << F[n] << endl;
return 0;
}
儒略日(julian)
【题目描述】
为了简便计算,天文学家们使用儒略日(Julian day)来表达时间。所谓儒略日,其定义为从公元前 4713 年 1 月 1 日正午 12 点到此后某一时刻间所经过的天数,不满一天者用小数表达。若利用这一天文学历法,则每一个时刻都将被均匀的映射到数轴上,从而得以很方便的计算它们的差值。
现在,给定一个不含小数部分的儒略日,请你帮忙计算出该儒略日(一定是某一天的中午 12 点)所对应的公历日期。
我们现行的公历为格里高利历(Gregorian calendar),它是在公元 1582 年由教皇格里高利十三世在原有的儒略历(Julian calendar)的基础上修改得到的(注:儒略历与儒略日并无直接关系)。具体而言,现行的公历日期按照以下规则计算:
1. 公元 1582 年 10 月 15 日(含)以后:适用格里高利历,每年一月 31 天、二月 28 天或 29 天、三月 31 天、四月 30 天、五月 31 天、六月 30 天、七月 31 天、八月 31 天、九月 30 天、十月 31 天、十一月 30 天、十二月 31天。其中,闰年的二月为 29 天,平年为 28 天。当年份是 400 的倍数,或日期年份是 4 的倍数但不是 100 的倍数时,该年为闰年。
2. 公元 1582 年 10 月 5 日(含)至 10 月 14 日(含):不存在,这些日期被删除,该年 10 月 4 日之后为 10 月 15 日。
3. 公元 1582 年 10 月 4 日(含)以前:适用儒略历,每月天数与格里高利历相同,但只要年份是 4 的倍数就是闰年。
4. 尽管儒略历于公元前 45 年才开始实行,且初期经过若干次调整,但今天人类习惯于按照儒略历最终的规则反推一切 1582 年 10 月 4 日之前的时间。
注意,公元零年并不存在,即公元前 1 年的下一年是公元 1 年。因此公元前 1 年、前 5 年、前 9 年、前 13 年……以此类推的年份应视为闰年。
【输入格式】
输入文件名为 julian.in。
第一行一个整数 Q,表示询问的组数。
接下来 Q 行,每行一个非负整数 ri,表示一个儒略日。
【输出格式】
输出文件名为 julian.out。
对于每一个儒略日 ri,输出一行表示日期的字符串 si。共计 Q 行。
si 的格式如下:
1.若年份为公元后,输出格式为 Day Month Year。其中日(Day)、月(Month)、年(Year)均不含前导零,中间用一个空格隔开。
例如:公元2020 年 11 月 7 日正午 12 点,输出为 7 11 2020。
2. 若年份为公元前,输出格式为 Day Month Year BC。其中年(Year)输出该年份的数值,其余与公元后相同。例如:公元前 841 年 2 月 1 日正午 12点,输出为 1 2 841 BC。
【样例 1 输入】
3
10
100
1000
【样例 1 输出】
11 1 4713 BC
10 4 4713 BC
27 9 4711 BC
【样例 2 输入】
3
2000000
3000000
4000000
【样例 2 输出】
14 9 763
15 8 3501
12 7 6239
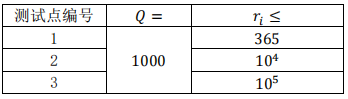
【数据范围与提示】
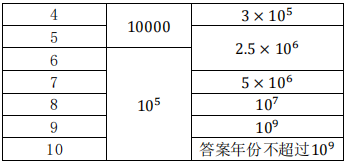
#include <bits/stdc++.h>
using namespace std;
typedef long long LL;
const int INF = 0x3f3f3f3f;
const LL mod = 1e9 + 7;
const int N = 100005;
int a[13] = {0, 31, 28, 31, 30, 31, 30, 31, 31, 30, 31, 30, 31};
LL cal(LL x) {
int sb = -4712;
if (x < sb) return 0;
LL res = (x - sb + 1) * 365;
if (x < 1582) {
res += (x - sb) / 4 + 1;
} else {
res -= 10;
res += (1581 - sb) / 4 + 1;
res += (x - 1580) / 4 - (x - 1500) / 100 + (x - 1200) / 400;
}
return res;
}
bool pd(int x) {
if (x > 1582) {
return x % 4 == 0 && x % 100 != 0 || x % 400 == 0;
} else {
return x % 4 == 0;
}
}
int main() {
// freopen("julian.in", "r", stdin);
// freopen("julian.out", "w", stdout);
int _;
scanf("%d", &_);
while (_--) {
LL n;
scanf("%lld", &n);
n++;
int l = -4712, r = 1e9 + 5;
while (l < r) {
int mid = l + r >> 1;
if (cal(mid) >= n) {
r = mid;
} else {
l = mid + 1;
}
}
n -= cal(l - 1);
a[2] = 28 + pd(l);
a[10] = l == 1582 ? 21 : 31;
int m;
for (int i = 1; i <= 12; i++) {
if (n > a[i]) {
n -= a[i];
} else {
m = i;
break;
}
}
if (l == 1582 && m == 10) {
if (n >= 5) n += 10;
printf("%lld %d %d\n", n, m, l);
} else {
if (l > 0)
printf("%lld %d %d\n", n, m, l);
else
printf("%lld %d %d BC\n", n, m, -l + 1);
}
}
return 0;
}
动物园(zoo)
【题目描述】
动物园里饲养了很多动物,饲养员小 A 会根据饲养动物的情况,按照《饲养指南》购买不同种类的饲料,并将购买清单发给采购员小 B。
具体而言,动物世界里存在 2k 种不同的动物,它们被编号为 0 ∼ 2^k −1。动物园里饲养了其中的 n 种,其中第 i 种动物的编号为 ai。
《饲养指南》中共有 m 条要求,第 j 条要求形如“如果动物园中饲养着某种动物,满足其编号的二进制表示的第 pj 位为 1,则必须购买第 qj 种饲料”。其中饲料共有 c 种,它们从 1 ∼ c 编号。本题中我们将动物编号的二进制表示视为一个 k 位 01 串,第 0 位是最低位,第 k − 1 位是最高位。
根据《饲养指南》,小 A 将会制定饲料清单交给小 B,由小 B 购买饲料。清单形如一个 c 位 01 串,第 i 位为 1 时,表示需要购买第 i 种饲料;第 i 位为 0 时,表示不需要购买第 i 种饲料。
实际上根据购买到的饲料,动物园可能可以饲养更多的动物。更具体地,如果将当前未被饲养的编号为 x 的动物加入动物园饲养后,饲料清单没有变化,那么我们认为动物园当前还能饲养编号为 x 的动物。
现在小 B 想请你帮忙算算,动物园目前还能饲养多少种动物。
【输入格式】
输入文件名为 zoo.in。
第一行包含四个以空格分隔的整数 n、m、c、k。分别表示动物园中动物数量、《饲养指南》要求数、饲料种数与动物编号的二进制表示位数。
. 第二行 n 个以空格分隔的整数,其中第 i 个整数表示 ai。
接下来 m 行,每行两个整数 pi,qi表示一条要求。
数据保证所有 ai 互不相同,所有的 qi 互不相同。
【输出格式】
输出文件名为 zoo.out。
仅一行一个整数表示答案。
【样例 1 输入】
3 3 5 4
1 4 6
0 3
2 4
2 5
【样例 1 输出】
13
【样例 1 解释】
动物园里饲养了编号为 1、4、6 的三种动物,《饲养指南》上 3 条要求为:
1. 若饲养的某种动物的编号的第 0 个二进制位为 1,则需购买第 3 种饲料。
2. 若饲养的某种动物的编号的第 2 个二进制位为 1,则需购买第 4 种饲料。
3. 若饲养的某种动物的编号的第 2 个二进制位为 1,则需购买第 5 种饲料。
饲料购买情况为:
1. 编号为 1 的动物的第 0 个二进制位为 1,因此需要购买第 3 种饲料;
2. 编号为 4、6 的动物的第 2 个二进制位为 1,因此需要购买第 4、5 种饲料。
由于在当前动物园中加入一种编号为 0,2,3,5,7,8, ⋯ ,15 之一的动物,购物清单都不会改变,因此答案为 13。
【样例 2 输入】
2 2 4 3
1 2
1 3
2 4
【样例 2 输出】
2
【数据范围与提示】
对于 20%的数据:k ≤ n ≤ 5,m ≤ 10,c ≤ 10,所有的 pi 互不相同。
对于 40%的数据:n ≤ 15,k ≤ 20,m ≤ 20,c ≤ 20。
对于 60%的数据:n ≤ 30,k ≤ 30,m ≤ 1000。
对于 100%的数据:0 ≤ n, m ≤ 10^6,0 ≤ k ≤ 64,1 ≤ c ≤ 10^8。
#include <bits/stdc++.h>
using namespace std;
typedef long long LL;
typedef unsigned long long ULL;
const int INF = 0x3f3f3f3f;
const LL mod = 1e9 + 7;
const int N = 100005;
int main() {
// freopen("zoo.in", "r", stdin);
// freopen("zoo.out", "w", stdout);
int n, m, c, K;
scanf("%d%d%d%d", &n, &m, &c, &K);
ULL flag = 0, g = 0;
for (int i = 0; i < n; i++) {
ULL x;
scanf("%llu", &x);
flag |= x;
}
while (m--) {
int p;
scanf("%d%*d", &p);
if ((flag >> p & 1) == 0) g |= 1ULL << p;
}
ULL ans = 1;
for (int i = 0; i < K; i++) {
if ((g >> i & 1) == 0) ans <<= 1;
}
if (ans == 0 && n == 0) {
puts("18446744073709551616");
return 0;
}
ans -= n;
printf("%llu\n", ans);
return 0;
}
函数调用(call)
【题目描述】
函数是各种编程语言中一项重要的概念,借助函数,我们总可以将复杂的任务分解成一个个相对简单的子任务,直到细化为十分简单的基础操作,从而使代码的组织更加严密、更加有条理。然而,过多的函数调用也会导致额外的开销,影响程序的运行效率。
某数据库应用程序提供了若干函数用以维护数据。已知这些函数的功能可分为三类:
1. 将数据中的指定元素加上一个值;
2. 将数据中的每一个元素乘以一个相同值;
3. 依次执行若干次函数调用,保证不会出现递归(即不会直接或间接地调用本身)。
在使用该数据库应用时,用户可一次性输入要调用的函数序列(一个函数可能被调用多次),在依次执行完序列中的函数后,系统中的数据被加以更新。某一天,小 A 在应用该数据库程序处理数据时遇到了困难:由于频繁而低效的函数调用,系统在执行操作时进入了无响应的状态,他只好强制结束了数据库程序。为了计算出正确数据,小 A 查阅了软件的文档,了解到每个函数的具体功能信息,现在他想请你根据这些信息帮他计算出更新后的数据应该是多少。
【输入格式】
输入文件名为 call.in。
第 1 行一个正整数 n,表示数据的个数。
第 2 行 n 个整数,第 i 个整数表示下标为 i 的数据的初始值为 ai。
第 3 行一个正整数 m,表示数据库应用程序提供的函数个数。函数从 1 ∼m 编号。
接下来 m 行中,第 j(1 ≤ j ≤ m)行的第一个整数为 Tj,表示 j 号函数的类型:
1. 若 Tj = 1,接下来两个整数 Pj, Vj 分别表示要执行加法的元素的下标及其增加的值;
2. 若 Tj = 2,接下来一个整数 Vj 表示所有元素所乘的值;
3. 若 Tj = 3,接下来一个正整数 Cj 表示 j 号函数要调用的函数个数,随后 Cj个整数 g1(j), g2(j), ⋯ , gCj(j) 依次表示其所调用的函数的编号。
第 m + 4 行一个正整数 Q,表示输入的函数操作序列长度。
第 m+ 5 行 Q 个整数 fi,第 i 个整数表示第 i 个执行的函数的编号。
【输出格式】
输出文件名为 call.out。
一行 n 个用空格隔开的整数,按照下标 1 ∼ n 的顺序,分别输出在执行完输入的函数序列后,数据库中每一个元素的值。答案对 998244353 取模。
【样例 1 输入】
3
1 2 3
3
1 1 1
2 2
3 2 1 2
2
2 3
【样例 1 输出】
6 8 12
【样例 1 解释】
1 号函数功能为将 a1 的值加一。2 号函数功能为所有元素乘 2。3 号函数将先调用 1 号函数,再调用 2 号函数。
最终的函数序列先执行 2 号函数,所有元素的值变为 2,4,6。
再执行 3 号函数时,先调用 1 号函数,所有元素的值变为 3,4,6。再调用 2号函数,所有元素的值变为 6,8,12。
【样例 2 输入】
10
1 2 3 4 5 6 7 8 9 10
8
3 2 2 3
3 2 4 5
3 2 5 8
2 2
3 2 6 7
1 2 5
1 7 6
2 3
3
1 2 3
【样例 2 输出】
36 282 108 144 180 216 504 288 324 360
【数据范围与提示】
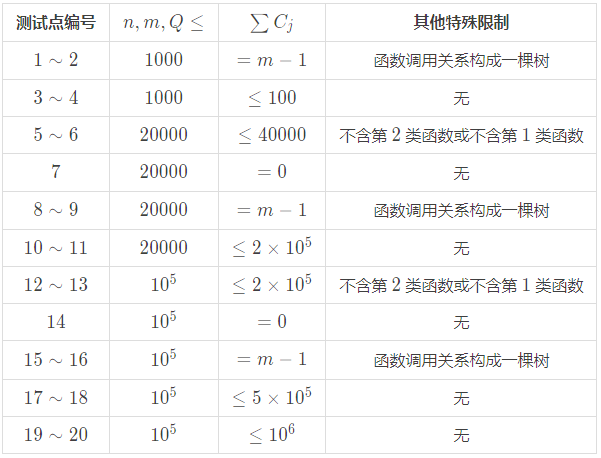
对于所有数据:0 ≤ ai ≤ 10^4,Tj ∈ {1,2,3},1 ≤ Pj ≤ n,0 ≤ Vj ≤ 10^4,1 ≤ ≤ m,1 ≤fi ≤ m。
#include <bits/stdc++.h>
using namespace std;
typedef long long LL;
const int INF = 0x3f3f3f3f;
const LL mod = 998244353;
const int N = 100005;
// d[i]表示全局积 f[i] 表示后继积
int a[N], op[N], b[N], c[N];
LL d[N], f[N];
vector<pair<int, int> > G[N], H[N];
LL dfs(int u) {
if (~d[u]) return d[u];
d[u] = op[u] == 2 ? c[u] : 1;
LL s = 1;
for (int i = G[u].size() - 1; i >= 0; i--) {
int v = G[u][i].first;
G[u][i].second = s;
d[u] = d[u] * dfs(v) % mod;
s = s * d[v] % mod; // 所有右兄弟的积
}
return d[u];
}
LL dfs2(int u) {
if (~f[u]) return f[u];
f[u] = 0;
for (int i = 0; i < H[u].size(); i++) {
int v = H[u][i].first, w = H[u][i].second;
f[u] = (f[u] + w * dfs2(v)) % mod;
}
return f[u];
}
int main() {
// freopen("call.in", "r", stdin);
// freopen("call.out", "w", stdout);
int n, m, q;
scanf("%d", &n);
for (int i = 1; i <= n; i++) scanf("%d", &a[i]);
scanf("%d", &m);
for (int i = 1; i <= m; i++) {
scanf("%d", &op[i]);
if (op[i] == 1) {
scanf("%d %d", &b[i], &c[i]);
} else if (op[i] == 2) {
scanf("%d", &c[i]);
} else {
int t;
scanf("%d", &t);
while (t--) {
int v;
scanf("%d", &v);
G[i].push_back({v, 0});
}
}
}
scanf("%d", &q);
while (q--) {
int v;
scanf("%d", &v);
G[0].push_back({v, 0});
}
memset(d, -1, sizeof d);
memset(f, -1, sizeof f);
dfs(0);
for (int i = 1; i <= n; i++) {
a[i] = a[i] * d[0] % mod;
}
for (int u = 0; u <= m; u++) {
for (int i = 0; i < G[u].size(); i++) {
int v = G[u][i].first, w = G[u][i].second;
H[v].push_back({u, w});
}
}
f[0] = 1;
for (int i = 1; i <= m; i++) {
if (op[i] == 1) {
a[b[i]] = (a[b[i]] + dfs2(i) * c[i]) % mod;
}
}
for (int i = 1; i <= n; i++) {
printf("%d%c", a[i], " \n"[i == n]);
}
return 0;
}
括号树
【题目背景】
本题中合法括号串的定义如下:
1.0是合法括号串。
2.如果A是合法括号串,则(A)是合法括号串。
3.如果A, B是合法括号串,则AB是合法括号串。
本题中子串与不同的子串的定义如下:
1.字符串S的子串是S中连续的任意个字符组成的字符串。S的子串可用起始位置l与终止位置r来表示,记为S(l,r)(1≤l≤r≤|S|,|S|表示S的长度)。
2.S的两个子串视作不同当且仅当它们在S中的位置不同,即l不同或r不同。
【题目描述】
一个大小为n的树包含n个结点和n-1条边,每条边连接两个结点,且任意两个 结点间有且仅有一条简单路径互相可达。
小Q是一个充满好奇心的小朋友,有一天他在上学的路上碰见了一个大小为n的 树,树上结点从1~n编号,1号结点为树的根。除1号结点外,每个结点有一个父亲 结点,u (2≤ u≤n)号结点的父亲为fu (1 ≤ fu < u)号结点。
小Q发现这个树的每个结点上恰有一个括号,可能是'('或')'。小Q定义si为:将 根结点到i号结点的简单路径上的括号,按结点经过顺序依次排列组成的字符串。
显然si是个括号串,但不一定是合法括号串,因此现在小Q想对所有的i(1≤i≤n) 求岀,si中有多少个互不相同的子串是合法括号串。
这个问题难倒了小Q,他只好向你求助。设si共有ki个不同子串是合法括号串, 你只需要告诉小Q所有ixki的异或和,即:
(1 x k1) xor (2 x k2) xor (3 x k3)xor .…xor (n x kn)其中xor是位异或运算。
【输入格式】
从文件brackets.in中读入数据。
第一行一个整数n,表示树的大小。
第二行一个长为n的由'('与')'组成的括号串,第i个括号表示i号结点上的括号。
第三行包含n-1个整数,第i(1≤i<n)个整数表示i+1号结点的父亲编号fi+1。
【输出格式】
输出到文件brackets.out中。
仅一行一个整数表示答案。
【样例1输入】
5
(()()
1 1 2 2
【样例1输出】
6
【样例1解释】
树的形态如下图:
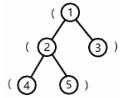
将根到1号结点的简单路径上的括号,按经过顺序排列所组成的字符串为(,子串 是合法括号串的个数为0。
将根到2号结点的简单路径上的括号,按经过顺序排列所组成的字符串为((,子 串是合法括号串的个数为0。
将根到3号结点的简单路径上的括号,按经过顺序排列所组成的字符串为(),子 串是合法括号串的个数为1。
将根到4号结点的简单路径上的括号,按经过顺序排列所组成的字符串为(((,子 串是合法括号串的个数为0。
将根到5号结点的简单路径上的括号,按经过顺序排列所组成的字符串为((),子 串是合法括号串的个数为1。
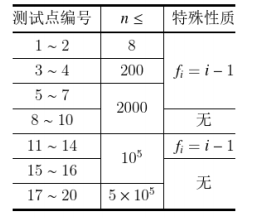
【数据范围】
#include <iostream>
#include <cstdio>
#include <vector>
#include <stack>
typedef long long ll;
const int maxn = 500005;
std :: vector <int> G[maxn];
std :: stack <int> bra;
char str[maxn];
int fa[maxn];
ll con[maxn], k[maxn];
void dfs(int u) {
int num = 0;
if (str[u] == '(')
bra.push(u);
else if (!bra.empty()){
num = bra.top();
bra.pop();
con[u] = con[fa[num]] + 1;
}
k[u] = k[fa[u]] + con[u];
for (int i = 0; i < G[u].size(); ++i)
dfs(G[u][i]);
if (num != 0)
bra.push(num);
else if (!bra.empty())
bra.pop();
return ;
}
int main() {
int n;
std :: scanf("%d", &n);
std :: scanf("%s", str + 1);
for (int i = 2; i <= n; ++i) {
std :: scanf("%d", &fa[i]);
G[fa[i]].push_back(i);
}
ll ans = 0;
dfs(1);
for (int i = 1; i <= n; ++i)
ans ^= k[i] * (ll)i;
std :: printf("%lld\n", ans);
return 0;
}
树上的数
【题目描述】
给定一个大小为n的树,它共有n个结点与n-1条边,结点从1~n编号。初始 时每个结点上都有一个1~n的数字,且每个1~n的数字都只在恰好一个结点上出现。
接下来你需要进行恰好n-1次删边操作,每次操作你需要选一条未被删去的边, 此时这条边所连接的两个结点上的数字将会交换.然后这条边将被删去。
n-1次操作过后,所有的边都将被删去。此时,按数字从小到大的顺序,将数字 1~n所在的结点编号依次排列,就得到一个结点编号的排列Pi。现在请你求出,在最 优操作方案下能得到的字典序最小的Pi。
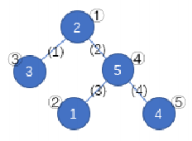
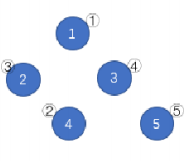
如上图,蓝圈中的数字1〜5 一开始分别在结点②、①、③、⑤、④。按照⑴⑷(3)⑵ 的顺序删去所有边,树变为下图。按数字顺序得到的结点编号排列为 ①③④②⑤,该 排列是所有可能的结果中字典序最小的。
【输入格式】
从文件tree.in中读入数据。
本题输入包含多组测试数据。
第一行一个正整数T,表示数据组数。
对于每组测试数据:
第一行一个整数n,表示树的大小。
第二行n个整数,第i (1≤i≤ n)个整数表示数字i初始时所在的结点编号。 接下来n-1行每行两个整数x,y,表示一条连接x号结点与y号结点的边。
【输出格式】
输出到文件tree.out中。
对于每组测试数据,输出一行共n个用空格隔开的整数,表示最优操作方案下所 能得到的字典序最小的Pi。
【样例1输入】
4
5
2 1 3 5 4
1 3
1 4
2 4
4 5
5
3 4 2 1 5
1 2
2 3
3 4
4 5
5
1 2 5 3 4
1 2
1 3
1 4
1 5
10
1 2 3 4 5 7 8 9 10 6
1 2
1 3
1 4
1 5
5 6
6 7
7 8
8 9
9 10
【样例1输出】
1 3 4 2 5
1 3 5 2 4
2 3 1 4 5
2 3 4 5 6 1 7 8 9 10
【数据范围】
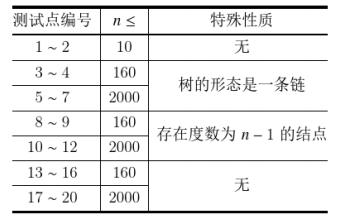
对于所有测试点:1 ≤ T ≤ 10,保证给出的是一个树。
#include<cstdio>
#include<vector>
using namespace std;
#define rep(i,__l,__r) for(int i=__l,i##_end_=__r;i<=i##_end_;++i)
#define fep(i,__l,__r) for(int i=__l,i##_end_=__r;i>=i##_end_;--i)
#define writc(a,b) fwrit(a),putchar(b)
#define mp(a,b) make_pair(a,b)
#define ft first
#define sd second
#define LL long long
#define ull unsigned long long
#define pii pair<int,int>
// #define FILEOI
#define cg (c=getchar())
template<class T>inline void qread(T& x){
char c;bool f=0;
while(cg<'0'||'9'<c)if(c=='-')f=1;
for(x=(c^48);'0'<=cg&&c<='9';x=(x<<1)+(x<<3)+(c^48));
if(f)x=-x;
}
inline int qread(){
int x=0;char c;bool f=0;
while(cg<'0'||'9'<c)if(c=='-')f=-1;
for(x=(c^48);'0'<=cg&&c<='9';x=(x<<1)+(x<<3)+(c^48));
return f?-x:x;
}
#undef cg
template<class T,class... Args>inline void qread(T& x,Args&... args){qread(x),qread(args...);}
template<class T>inline T Max(const T x,const T y){return x>y?x:y;}
template<class T>inline T Min(const T x,const T y){return x<y?x:y;}
template<class T>inline T fab(const T x){return x>0?x:-x;}
inline void getInv(int inv[],const int lim,const int MOD){
inv[0]=inv[1]=1;for(int i=2;i<=lim;++i)inv[i]=1ll*inv[MOD%i]*(MOD-MOD/i)%MOD;
}
template<class T>void fwrit(const T x){
if(x<0)return (void)(putchar('-'),fwrit(-x));
if(x>9)fwrit(x/10);putchar(x%10^48);
}
const int MAXN=2000;
struct edge{
int to,nxt;
edge(){}
edge(const int T,const int N):to(T),nxt(N){}
}e[(MAXN<<1)+5];
int tail[MAXN+5],ecnt,siz[MAXN+5];
inline void add_edge(const int u,const int v){
++siz[u],++siz[v];
e[++ecnt]=edge(v,tail[u]);tail[u]=ecnt;
e[++ecnt]=edge(u,tail[v]);tail[v]=ecnt;
}
int N,minp;
int pt[MAXN+5];
int pre[MAXN+5][MAXN+5],nxt[MAXN+5][MAXN+5];
//这条边的 前驱,后继
int rt[MAXN+5][MAXN+5][2];
//点 u 的某一条边的 前根节点、后根节点
int len[MAXN+5][MAXN+5];
//这条边 所在链 的链表长度
inline void init(){
qread(N);
ecnt=0;
rep(i,1,N)qread(pt[i]),tail[i]=siz[i]=0;
rep(i,1,N+1)rep(j,1,N+1)len[i][j]=pre[i][j]=nxt[i][j]=rt[i][j][0]=rt[i][j][1]=0;
int u,v;
rep(i,1,N-1){
qread(u,v);
add_edge(u,v);
pre[u][v]=pre[v][u]=nxt[u][v]=nxt[v][u]=0;
rt[u][v][0]=rt[u][v][1]=v;
rt[v][u][0]=rt[v][u][1]=u;
len[u][v]=len[v][u]=1;
}
}
void findPath(const int u,const int p){//当前节点、前一个节点
int a=rt[u][p][0],b=rt[u][p][1],ta,tb;
//a:来的边的前根 ; b:来的边的后根
if(p==N+1){//这是起点
for(int i=tail[u],v;i;i=e[i].nxt){//从哪条边起飞
v=e[i].to;
ta=rt[u][v][0],tb=rt[u][v][1];
if(ta!=v || (pre[u][p]==tb && len[u][ta]<siz[u]))
//条件一:如果这条边已经有一个起点且不是自己
//条件二:如果后面的那条边已经连接尾端, 且这条链的长度无法满足将所有边连起来
continue;//那么就不能把 边{u,p} 与 边{u,v} 连在一起
findPath(v,u);//否则可行
}
}
else{
if(p==b){//如果 边{u,p} 的后面还暂时没有指定必须删哪一条边, 那么就可以考虑枚举一条边接在后面
if(pre[u][N+1]==0 && (nxt[u][N+1]!=a || len[u][a]==siz[u]))//则可以考虑在点 u 进行降落, 满足以下条件:
//如果这个点的末删边还没有被指定(必须满足)
//并且:
//1.如果这条链接上开头,那么如果必须满足所有的边都在这条链上
//2.如果没有接上开头,那么长度随意
minp=Min(minp,u);//如果满足, 则 u 可以作为一个降落点
for(int i=tail[u],v;i;i=e[i].nxt){//假定 u 为一个中转点, 则再枚举一条边作为 边{u,p} 的出边,与其尾相连
v=e[i].to;
ta=rt[u][v][0],tb=rt[u][v][1];
if(a==ta || ta!=v || nxt[u][N+1]==v)//第一种大情况
//如果这两条边已经在同一条链上
//或者这个边不是一个起始边, 即枚举边的前面还有东西
//或者枚举边是一条起飞边, 即保证它是所有对于 u 的边必须最先删除的边
continue;//那么 当前 边{u,p} 都不能接在这条枚举边之上
if(nxt[u][N+1]==a && pre[u][N+1]==tb && len[u][a]+len[u][ta]<siz[u])
//如果这两条边分别属于这个点 最先删除、最后删除 的链表上的 尾、头
//那么它们组合起来必须等于所有边的数量之和
//否则, 这就是 提前自闭 的情况
continue;
findPath(v,u);//如果以上都不满足, 那么这条边是合法的
}
}
else findPath(nxt[u][p],u);//否则我们只能按照之前的规定访问这条边
}
}
inline void merge(const int u,const int a,const int b){
//函数条件:以 a 所在的链表为前链表
//并且满足 a 是前链表尾, b 是后链表头
int ta=rt[u][a][0],tb=rt[u][b][1];
nxt[u][a]=b;
pre[u][b]=a;
for(int i=ta;i && i!=N+1;i=nxt[u][i]){
//访问链表的基本操作
//更新每个点的前根、后根
rt[u][i][0]=ta;
rt[u][i][1]=tb;
}
len[u][ta]+=len[u][b];
}
bool getMark(const int u,const int p){//还原路径, 并且给路径打上标记
//如果这条路径找到终点, 返回 1, 否则返回 0
if(u==minp){//如果找到了终点
pre[u][N+1]=p;//把这条边设为最后删除的边
nxt[u][p]=N+1;//并且把这条边的下一条边标记为 N+1, 表示这条边是最后删除的
return 1;
}
int a=rt[u][p][0],b=rt[u][p][1],ta,tb;
if(p==N+1){//这是起飞点
for(int i=tail[u],v;i;i=e[i].nxt){
v=e[i].to;
ta=rt[u][v][0],tb=rt[u][v][1];
if(ta!=v || (pre[u][N+1]==tb && len[u][ta]<siz[u]))
//如果枚举边前面有东西, 那么这肯定不能接在起始边的后面, 因为它前面已经有个什么 逼 了
//或者是枚举边连接到末尾, 但是这条单链长度不够将所有的边包含到链里面
continue;//那么这条边肯定不在路径上面, 可直接跳过
if(getMark(v,u)){//如果这就是正确的路径
nxt[u][N+1]=v;//因为 u 点是起飞点, 所以把这条边记录为 u 的起飞边
pre[u][v]=N+1;//同时标记这条边的前驱, 与前面的 if 相互呼应(这不是语文...)
return 1;
}
}
}
else{//如果点 u 是中转点, 那么考虑枚举中转边
if(p==b){//如果这条边在链上后面没有其他边的时候
for(int i=tail[u],v;i;i=e[i].nxt){
v=e[i].to;
ta=rt[u][v][0],tb=rt[u][v][1];
if(a==ta || ta!=v || nxt[u][N+1]==v)//参考 findPath() 中相同位置的注释
continue;
if(nxt[u][N+1]==a && pre[u][N+1]==tb && len[u][a]+len[u][ta]<siz[u])//同样参考 findPath() 中同样位置
continue;
if(getMark(v,u)){
merge(u,p,v);//把链表合并为一个
return 1;
}
}
}
else getMark(nxt[u][p],u);
}
return 0;
}
signed main(){
#ifdef FILEOI
freopen("rdata.out","r",stdin);
freopen("file.out","w",stdout);
#endif
int T=qread();
while(T--){
init();
if(N==1){
writc(1,'\n');
continue;
}
rep(i,1,N){
minp=N+1;
findPath(pt[i],N+1);
// printf("%d\n",minp);
getMark(pt[i],N+1);
writc(minp,' ');
}
putchar('\n');
}
return 0;
}
树的重心
小简单正在学习离散数学,今天的内容是图论基础,在课上他做了如下两条笔记:
1.一个大小为n的树由n个结点与n-1条无向边构成,且满足任意两个结点间有 且仅有一条简单路径。在树中删去一个结点及与它关联的边,树将分裂为若干个 子树;而在树中删去一条边(保留关联结点,下同),树将分裂为恰好两个子树。
2.对于一个大小为n的树与任意一个树中结点c,称c是该树的重心当且仅当在树 中删去c及与它关联的边后,分裂出的所有子树的大小均不超过 (其中Lx」 是下取整函数)。对于包含至少一个结点的树.它的重心只可能有1或2个。
课后老师给出了一个大小为n的树S,树中结点从1~n编号。小简单的课后作业 是求出S单独删去每条边后,分裂出的两个子树的重心编号和之和。即:
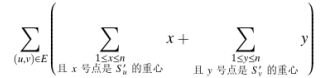
上式中,E表示树S的边集,(u,n)表示一条连接u号点和V号点的边。S'u与S'v 分别表示树S删去边(u,v)后,u号点与V号点所在的被分裂出的子树。
小简单觉得作业并不简单,只好向你求助,请你教教他。
【输入格式】
从文件centroid.in中读入数据。
本题输入包含多组测试数据。
第一行一个整数T表示数据组数。
接下来依次给岀每组输入数据,对于每组数据:
第一行一个整数n表示树S的大小。
接下来n -1行,每行两个以空格分隔的整数 ui,vi,表示树中的一条边(ui,vi)。
【输出格式】
输出到文件centroid.out中。
共T行,每行一个整数.第i行的整数表示:第i组数据给岀的树单独删去每条边 后,分裂出的两个子树的重心编号和之和。
【样例1输入】
2
5
12
23
24
35
7
1 2
1 3
1 4
3 5
3 6
6 7
【样例1输出】
32
56
【样例1解释】
对于第一组数据:
删去边(1,2), 1号点所在子树重心编号为{1}, 2号点所在子树重心编号为{2,3}。 删去边(2,3), 2号点所在子树重心编号为⑵,3号点所在子树重心编号为{3,5}。
删去边(2,4), 2号点所在子树重心编号为{2,3}, 4号点所在子树重心编号为{4}。 删去边(3,5), 3号点所在子树重心编号为{2}, 5号点所在子树重心编号为{5}。
因此答案为 1 + 2 + 3 + 2 + 3 + 5 + 2 + 3 + 4 + 2 + 5 = 32。
【数据范围】
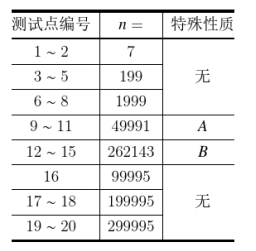
表中特殊性质一栏,两个变量的含义为存在一个1~n的排列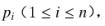 使得:
A:树的形态是一条链。即 存在一条边(pi,pi+1)。
B:树的形态是一个完美二叉树。即 存在两条边(Pi,P2i)与(Pi,P2i+1)。 对于所有测试点:
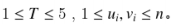 保证给岀的图是一个树。
#include <cstdio>
#include <algorithm>
using namespace std;
const int Maxn = 300000;
const int Maxlog = 19;
typedef long long ll;
#ifdef LOACL
bool ___;
#endif
struct Edge {
int to;
Edge *nxt;
};
Edge pool[Maxn * 2 + 5];
Edge *G[Maxn + 5], *ecnt;
inline void addedge(int u, int v) {
Edge *p = ++ecnt;
p->to = v, p->nxt = G[u];
G[u] = p;
}
int N;
int siz[Maxn + 5];
int mxson[Maxn + 5], mx2son[Maxn + 5];
ll ans;
int s[Maxn + 1][Maxlog + 2];
int f[Maxn + 5];
inline void clear() {
for(int i = 1; i <= N; i++)
mxson[i] = mx2son[i] = 0;
for(int i = 1; i <= N; i++)
for(int j = 0; j <= Maxlog; j++)
s[i][j] = 0;
for(int i = 1; i <= N; i++)
G[i] = NULL;
ecnt = &pool[0];
ans = 0;
}
inline void modify(int u) {
for(int i = 1; i <= Maxlog; i++)
s[u][i] = s[s[u][i - 1]][i - 1];
}
void PreDFS(int u, int fa) {
siz[u] = 1, f[u] = fa;
for(Edge *p = G[u]; p != NULL; p = p->nxt) {
int v = p->to;
if(v == fa) continue;
PreDFS(v, u);
siz[u] += siz[v];
if(siz[v] > siz[mxson[u]]) {
mx2son[u] = mxson[u];
mxson[u] = v;
} else if(siz[v] > siz[mx2son[u]])
mx2son[u] = v;
}
s[u][0] = mxson[u];
modify(u);
}
inline void calc(int u) {
int tot = siz[u], rt = u;
for(int i = Maxlog; i >= 0; i--)
if(tot - siz[s[u][i]] <= tot / 2)
u = s[u][i];
if(siz[s[u][0]] <= tot / 2) ans += u;
if(u != rt && siz[u] <= tot / 2) ans += f[u];
}
void DFS(int u, int fa) {
if(fa != 0) calc(fa), calc(u);
int flag = 0, t1;
if(N - siz[u] > siz[mxson[u]]) {
t1 = mx2son[u], flag = 1;
mx2son[u] = mxson[u], mxson[u] = fa;
} else if(N - siz[u] > siz[mx2son[u]]){
t1 = mx2son[u], flag = 2;
mx2son[u] = fa;
}
for(Edge *p = G[u]; p != NULL; p = p->nxt) {
int v = p->to;
if(v == fa) continue;
siz[u] += siz[fa] - siz[v], f[u] = v;
if(v == mxson[u]) s[u][0] = mx2son[u];
else s[u][0] = mxson[u];
modify(u);
DFS(v, u);
siz[u] -= siz[fa] - siz[v], f[u] = fa;
}
if(flag == 1) {
mxson[u] = mx2son[u], mx2son[u] = t1;
} else if(flag == 2) mx2son[u] = t1;
s[u][0] = mxson[u];
modify(u);
}
#ifdef LOACL
bool ____;
#endif
int main() {
#ifdef LOACL
freopen("in.txt", "r", stdin);
freopen("out.txt", "w", stdout);
#endif
int _;
scanf("%d", &_);
while(_--) {
scanf("%d", &N);
clear();
for(int i = 1; i < N; i++) {
int u, v;
scanf("%d %d", &u, &v);
addedge(u, v), addedge(v, u);
}
PreDFS(1, 0);
DFS(1, 0);
printf("%lld\n", ans);
}
#ifdef LOACL
printf("%.2f\n", (&____ - &___) / 1048576.0);
#endif
return 0;
}