GESP-C++五级 题库
下述C++代码实现了快速排序算法,下面说法错误的是( )。

. 快速排序之所以叫“快速”,是因为它在平均情况下运行速度较快,常数小、就地排序,实践中通常比归并排序更高效。
在平均情况下,划分的递归层数为 log n,每层中的总循环数为 ,总时间为 O(nlog n)。
在最差情况下,每轮划分操作都将长度为 的数组划分为长度为 0 和 n-1的两个子数组,此时递归层数达到 n,每层中的循环数为 ,总时间为 。
划分函数 partition 中“从右往左查找”与“从左往右查找”的顺序可以交换
关于下述C++代码的快速排序算法,说法【错误】的是?( )
考虑以下C++代码实现的快速排序算法,将数据从小到大排序,则横线上应填的最佳代码是?( )
快速排序是一种分治算法,其基本步骤如下:
选择基准:从数组中选择一个元素作为基准(通常选择最后一个元素)。
分区:重新排列数组,使得所有比基准小的元素放在基准前面,所有比基准大的元素放在基准后面。分区完成后,基准就位于其最终排序后的正确位置。
递归排序:递归地对基准前后的子数组进行快速排序。
在分区过程中:
i初始化为low - 1,表示小于基准的区域最初为空。
j从low到high - 1遍历数组。
如果arr[j]小于pivot,则i增加1,并将arr[i]和arr[j]交换。这样,arr[i]现在是一个小于pivot的元素。
本题答案为选项B。
考虑以下C++代码实现的快速排序算法:
以下关于快速排序的说法,正确的是( )。
假设快速排序算法的输入是一个长度为 n 的已排序数组,且该快速排序算法在分治过程总是选择第一个元素作为基准元素。下面选项( )描述的是在这种情况下的快速排序行为。
快速排序的过程是,每次选择一个基准值,比基准值大的放到它的右边 ,比基准值小的放到它的左边,但是这个序列是一个有序序列,且每次都是选择最小的元素作为基准值,所以每次所有的值都会放到基准值的右边,也就是说,每次都只是把基准值这个位置排序好。
为了正确实现快速排序,下面横线上的代码应为( )。
快速排序的分区过程中,我们使用两个指针i和j分别从左到右和从右到左遍历数组,将小于基准值的元素放到基准值的左边,大于基准值的元素放到右边。
具体的分区过程如下:
首先选择一个基准值pivot,通常选择中间元素arr[mid]。
使用两个指针i和j,分别从数组的左右两端开始向中间移动。
i从左向右移动,直到找到一个大于或等于pivot的元素。
j从右向左移动,直到找到一个小于或等于pivot的元素。
如果i <= j,则交换arr[i]和arr[j],然后i向后移动一位,j向前移动一位。
重复步骤2和3,直到i大于j,此时所有小于等于pivot的元素都在pivot的左边,所有大于等于pivot的元素都在pivot的右边。
在填写横线上的代码时,应该使用while (i <= j),因为分区过程应该持续进行直到i超过j,这样保证了整个分区过程的完成。
在快速排序中,选择的主元素(pivot)会影响算法的( )。
下面的C++代码实现对list的快速排序,有关说法,错误的是( )。
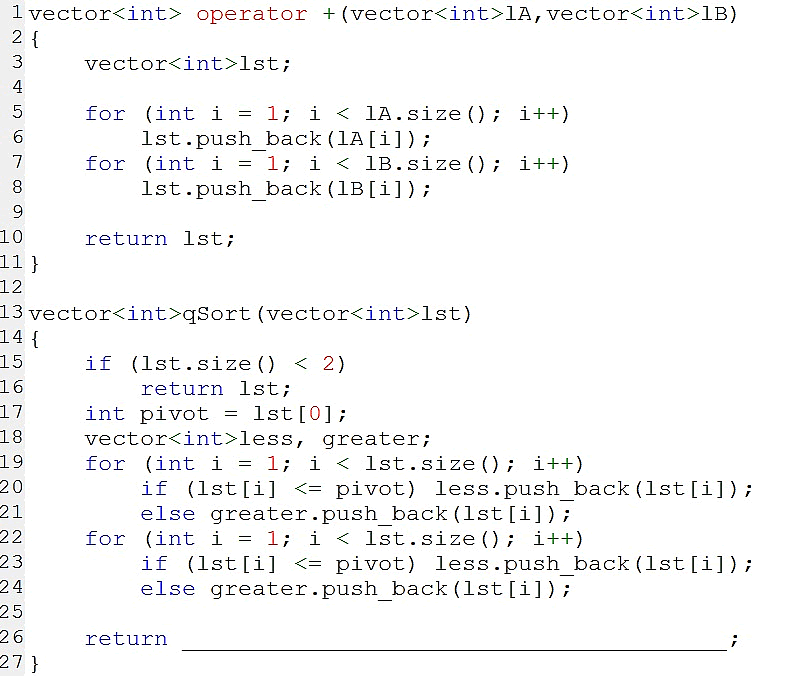
qSort(less) + qSort(greater) + (vector<int>)pivot
(vector<int>)pivot + (qSort(less) + qSort(greater))
(qSort(less) + (vector<int>)pivot + qSort(greater))
qSort(less) + pivot + qSort(greater)
通过在数组的第一个、最中间和最后一个这3个数据中选择中间值作为枢轴(比较基准),快速排序算法可降低落入最坏情况的概率。