GESP-C++五级 题库
下述代码实现素数表的线性筛法,筛选出所有小于等于 的素数,则横线上应填的代码是( )。
下列C++代码判断一个正整数是否是质数,说法正确的是?( )
下面的代码用于判断整数 n 是否是质数,错误的说法是?( )
下述代码实现素数表的线性筛法,筛选出所有小于等于 n 的素数,横线上应填的最佳代码是?( )
线性筛法的核心思想是 每个合数只被其最小质因数筛除一次,从而保证 O(n) 的时间复杂度。
内层循环的目的是 筛除 i×primes[j],因此需要满足:
j 不超过 primes 数组的大小(避免越界访问)。
i×primes[j]≤n(筛除的合数不能超过 n)。
本题答案为选项C。
唯一分解定理表明,每个大于1的自然数可以唯一地写成若干个质数的乘积。下面函数将自然数 n 的所有质因素找出来,横线上能填写的最佳代码是( )。
下述代码实现素数表的埃拉托色尼(埃氏)筛法,筛选出所有小于等于 n 的素数。
下面说法,正确的是( )。
下述代码实现素数表的线性筛法,筛选出所有小于等于 n 的素数。下面说法正确的是( )。
下述代码实现素数表的埃拉托斯特尼筛法,筛选出所有小于等于 n 的素数,则横线上应填的最佳代码是( )。
下述代码实现素数表的线性筛法,筛选出所有小于等于 n 的素数,则横线上应填的代码是( )。
这个地方是要枚举质数表,然后把质数的i倍数都筛掉,所以应该是选A。
下述代码实现素数表的线性筛法,筛选出所有小于等于 的素数,则横线上应填的代码是( )。
使用for (int j = 0; j < primes.size() && i * primes[j] <= n; j++) 这个循环来遍历当前已知的素数列表primes,确保了我们使用当前素数i 来乘以已知素数primes[j],并且正确地筛选掉不超过n 的合数。
下面的代码片段用于判断一个正整数是否为素数。请对以下代码进行修改,使其能正确实现相应功能。( )
在埃拉托斯特尼筛法中,要筛选出不大于 n 的所有素数,最外层循环应该遍历什么范围( )?
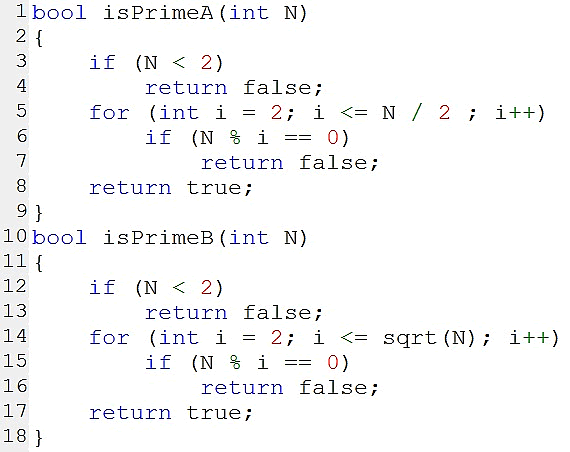
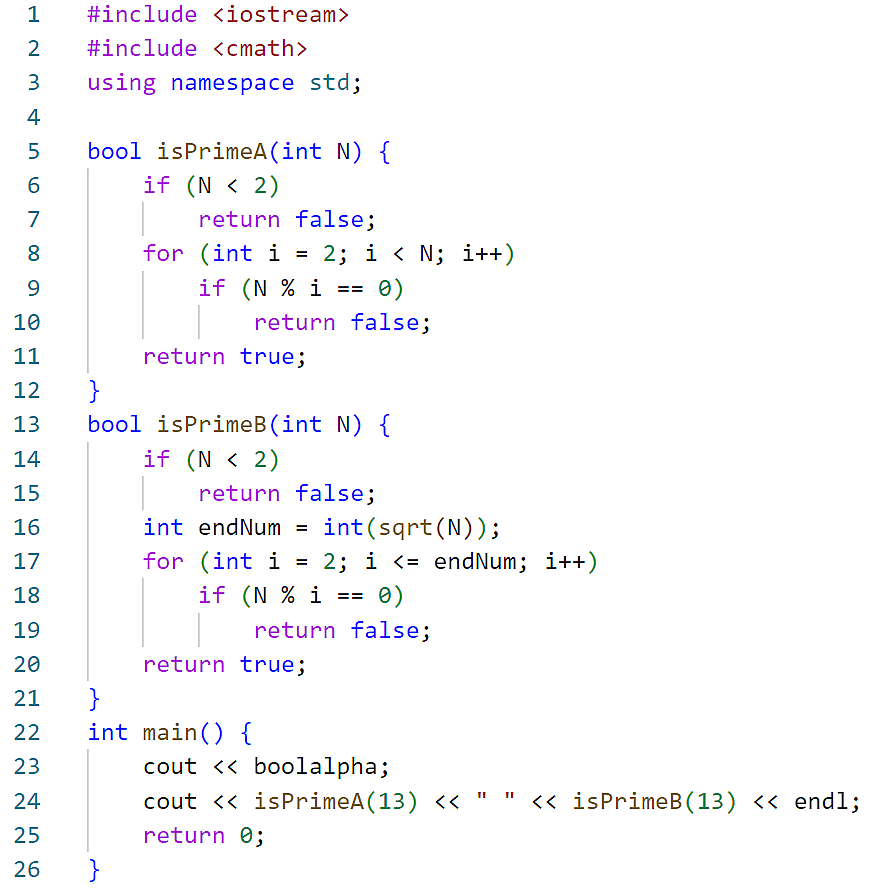
下面C++代码中的 isPrimeA() 和 isPrimeB() 都用于判断参数N是否素数,有关其时间复杂度的正确说法是( )。
isPrimeA( ) 的最坏时间复杂度是 , isPrimeB( ) 的最坏时间复杂度是
 , isPrimeA() 优于 isPrimeB()
isPrimeA() 的最坏时间复杂度是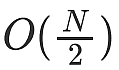 , isPrimeB( ) 的最坏时间复杂度是
 , isPrimeB() 绝大多数情况下优于 isPrimeA()
isPrimeA() 的最坏时间复杂度是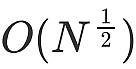 , isPrimeB( ) 的最坏时间复杂度是
 , isPrimeA( ) 优于isPrimeB( )
isPrimeA() 的最坏时间复杂度是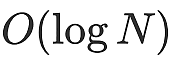 , isPrimeB( ) 的最坏时间复杂度是
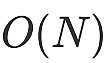 , isPrimeA() 优于isPrimeB( )
小杨想编写一个判断任意输入的整数N是否为素数的程序,下面哪个方法不合适?( )(2023年12月C++五级)
埃氏筛法
线性筛法
二分答案
枚举法
下面代码中的 isPrimeA() 和 isPrimeB() 都用于判断参数 N 是否素数,有关其时间复杂度的正确说法是( )。
在求解所有不大于 n 的素数时,线性筛法(欧拉筛)都应当优先于埃氏筛法使用,因为线性筛法的时间复杂度为O(n),低于埃氏筛法的O(n log log n)。

如下为线性筛法,用于高效生成素数表,其核心思想是每个合数只被它的最小质因数筛掉一次,时间复杂度为 O(n)。( )
线性筛相对于埃拉托斯特尼筛法,每个合数只会被它的最小质因数筛去一次,因此效率更高。( )
线筛的时间复杂度是 O(n),每个合数只被其最小质因数筛去一次。
而埃筛的时间复杂度是 O(nlog log n),相对来说会更高,是在筛选过程中存在重复操作。
本题答案为正确。