GESP-C++五级 题库


二分查找依赖数据的有序性,通过循环逐步缩减一半搜索区间来进行查找,且仅适用于数组或基于数组实现的数据结构。2025.9-5
下面C++代码是用欧几里得算法(辗转相除法)求两个正整数的最大公约数, a 大于 b 还是小于 b 都适用。( )
假设函数 gcd() 函数能正确求两个正整数的最大公约数,则下面的 lcm() 函数能求相应两数的最小公倍数。( )
下面的C++代码用于输出每个数对应的质因数列表,输出形如: {5: [5], 6: [2, 3], 7: [7], 8: [2, 2, 2]} 。( )
下面的C++代码实现归并排序。代码在执行时,将输出一次 HERE 字符串,因为merge()函数仅被调用一次。( )
查字典这个小学生必备技能,可以把字典视为一个已排序的数组。
假设小杨要查找一个音首字母为 g 的单词,他首先翻到字典约一半的页数,发现该页的首字母是 m ,由于字母表中 g 位于 m 之前,所以排除字典后半部分,查找范围缩小到前半部分;不断重复上述步骤,直至找到首字母为 g 的页码。
这种查字典的一系列操作可看作二分查找。( )
求解下图中A点到D点最短路径,其中A到B之间的12可以理解为距离。求解这样的问题常用Dijkstra算法,其思路是通过逐步选择当前距离起点最近的节点来求解非负权重图(如距离不能为负值)单源最短路径的算法。
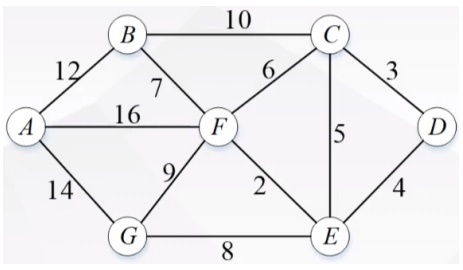
从该算法的描述可以看出,Dijkstra算法是贪心算法。( )
分治算法将原问题可以分解成规模更小的子问题,使得求解问题的难度降低。
但由于分治算法需要将问题进行分解,并且需要将多个子问题的解合并为原问题的解,所以分治算法的效率通常比直接求解原问题的效率低。( )
如下为线性筛法,用于高效生成素数表,其核心思想是每个合数只被它的最小质因数筛掉一次,时间复杂度为 O(n)。( )
单链表中删除某个结点 p(非尾结点),但不知道头结点,可行的操作是将 p 的值设为 p->next 的值,然后删除 p->next 。( )
删除某个结点 p,但不知道头结点,无法直接找到 p 的前驱结点。
但是可以复制后继结点的值,然后删除后继节点。
假设单链表为:A -> B -> C -> D,要删除 B:
将 B 的值设为 C 的值:B->data = C->data(链表变为 A -> C -> C -> D)。
删除 B->next(即 C):B->next = C->next(链表变为 A -> C -> D)。
最终效果:B 被删除了。
链表存储线性表时要求内存中可用存储单元地址是连续的。( )
链表中的结点在内存中,是 动态分配 的。
每个结点可以分布在内存的任意位置,通过指针(next)连接。
存储单元的地址可以不连续,也可以是连续的。
线性筛相对于埃拉托斯特尼筛法,每个合数只会被它的最小质因数筛去一次,因此效率更高。( )
线筛的时间复杂度是 O(n),每个合数只被其最小质因数筛去一次。
而埃筛的时间复杂度是 O(nlog log n),相对来说会更高,是在筛选过程中存在重复操作。
本题答案为正确。
贪心算法通过每一步选择当前最优解,从而一定能获得全局最优解。( )
贪心算法是一种在每一步选择中都采取当前状态下最优(局部最优)的决策,从而希望导致全局最优解的算法策略,但是贪心算法 不一定能得到全局最优解。
递归函数必须具有一个终止条件,以防止无限递归。( )
正确,如果没有终止条件,函数会无限调用自身;
终止条件是递归的出口,确保问题规模能逐步缩小至可直接求解的情况。