GESP-Python五级 题库
下述python代码实现了快速排序算法,最差情况时间复杂度是()。
关于算法复杂度,下列说法不正确的是()
上面代码的时间复杂度是( )。
这段代码的主要操作是:
1、两层嵌套循环:外层循环遍历字符串的每个字符作为子字符串的起点,内层循环则从这个起点开始,尝试所有可能的子字符串长度(直到字符串末尾)。
外层循环:for i in range(len(srcStr)),执行次数为n(n 是字符串长度)。
内层循环:for j in range(i + 2, len(srcStr) + 1),对于外层循环的每次迭代,内层循环的次数大致为n - i - 1(因为从i+2 开始到字符串末尾)。
2、内层循环的累加:如果我们把内层循环的每次迭代都加起来,我们会发现这是一个等差数列的和,大致为n + (n-1) + (n-2) + … + 2 + 1,这个和是n(n+1)/2 - 1,但在分析时间复杂度时,我们更关心的是它的阶(order),即O(n^2)。
3、其他操作:虽然代码中还有回文检查和排序操作,但这些操作的时间复杂度相对于内层循环的O(n^2) 来说是可以忽略的(特别是当考虑到平均情况和最坏情况时的实际影响)。
因此,我们可以简单地说,这段代码的时间复杂度是O(n^2),其中n 是输入字符串的长度。这意味着随着输入字符串长度的增加,算法的执行时间将呈平方级增长。
上题代码的时间复杂度是( )。
整体时间复杂度仍然是主要由循环决定,为C
不同的排序算法,其空间复杂度也不同。与冒泡法排序空间复杂度相同的是( )
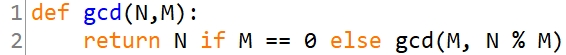
在 Python 实现的单链表中,已知引用 p 指向要删除的节点(该节点不是尾节点),若想在 O(1) 时间复杂度内删除这个节点,可行的做法是:用 p 的后继节点 p.next 的值覆盖 p 自身的值,再用 p 的后继节点的 next 引用覆盖 p 的 next 引用,最后断开 p 的后继节点的引用以辅助垃圾回收。()
以下 fib 函数计算第 n 项斐波那契数( fib(0)=0 , fib(1)=1 ),其时间复杂度为 O(n)。()
 。

 。

时间复杂度对比O(1)<O(logn)<O(n)<O(nlogn)<O(n2logn)<O(n2)<O(n3) 。
贪婪算法的复杂度通常是线性的,即O(n),其中n是输入的大小
宏观考虑的话,在不考虑其他如排序这样的运算的情况下,贪心算法通常是线性的,就是一次考虑每一个物品的最优情况即可。
在Python中,set或dict因为存储时即自动排序,因此可以用二分法查找,时间复杂度为 O(logN)。( )
在 Python 中,set 和 dict 并不是自动排序的。它们分别用于存储唯一元素(set)和键值对(dict),但都不保证元素的顺序。set 的元素是无序的,而 dict 的元素(即键值对)虽然在 Python 3.7+ 中是按照插入顺序排序的(这被称为插入顺序保留),但这并不意味着它们是“自动排序”以支持二分查找等高效查找算法。
二分查找是一种在有序数组中查找特定元素的快速算法,其时间复杂度为 O(log n)。由于 set 和 dict 都不是基于有序数组实现的,因此不能使用二分查找来在这些数据结构上查找元素。
在Python中,当对dict类型进行in运算查找元素是否存在时,其时间复杂度为 O(1) ,set类型也如此。( )