GESP-Python五级 题库
下述代码实现素数表的线性筛法,筛选出所有小于等于 n 的素数,则横线上应填的代码是( )。
下列Python代码用于判断一个正整数是否是质数(素数),相关说法中正确的是( )。

代码存在错误,比如5是质数,但因为 5 % 5 余数是0返回了False
finish_number 的值应该是 N // 2 ,当前写法将导致错误
当前while循环正确的前提是:所有大于3的质数都符合 6k±1 形式
while循环修改如下,其执行效果与执行时间相同

下面的代码用于列出求1到N之间的所有质数,错误的说法是( )。

埃氏筛算法相对于上面的代码效率更高
线性筛算法相对于上面的代码效率更高
上面的代码,有很多重复计算,因为不是判断单个数是否为质数,故而导致筛选出连续数中质数的效率不高
相对而言,埃氏筛算法比上面代码以及线性筛算法效率都高
下述代码实现素数表的线性筛法,筛选出所有小于等于 的素数,横线上应填的最佳代码是( )。
下列程序是素数筛的程序,横线处应该填上( )。
第7行判断如果当前i是质数,则i的倍数都不是质数,所以这个地方是要枚举i的所有的倍数,注意右边界。
下面是埃氏素数筛的Python实现,横线上应填入的代码是( )。
埃氏筛法(埃拉托斯特尼筛法)是一种用于查找一定范围内所有素数的有效算法
我们需要填入的三个空白分别是:
第一个空白:表示从i*i 开始标记非素数。
第二个空白:表示循环范围,即N 之内需要标记非素数。
第三个空白:表示步长,即每次增加i。
i * i, N + 1, i
第一个空白:i * i,从i*i 开始标记非素数。
第二个空白:N + 1,循环范围是正确的。
第三个空白:i,表示每次增加i,符合埃氏筛法的步长要求。
小杨想编写一个判断任意输入的整数N是否为素数的程序,下面哪个方法不合适?( )(2023年12月五级)
埃氏筛法
线性筛法
二分答案
枚举法
下面Python代码中的 isPrimeA() 和 isPrimeB() 都用于判断参数N是否素数,有关其时间复杂度的正确说法是( )。
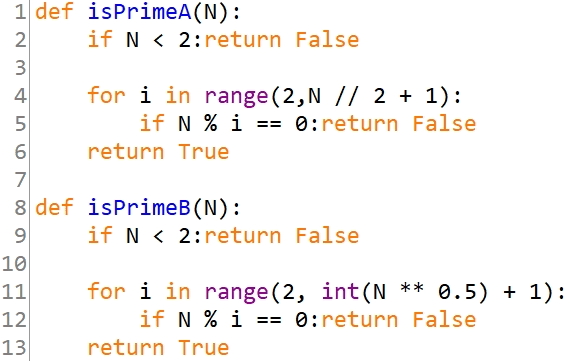
isPrimeA( ) 的最坏时间复杂度是 , isPrimeB( ) 的最坏时间复杂度是 ,isPrimeA()优于isPrimeB()
isPrimeA() 的最坏时间复杂度是 , isPrimeB( ) 的最坏时间复杂度是 ,isPrimeB()绝大多数情况下优于isPrimeA()
isPrimeA() 的最坏时间复杂度是 , isPrimeB( ) 的最坏时间复杂度是 , isPrimeA( ) 优于isPrimeB( )
isPrimeA() 的最坏时间复杂度是 , isPrimeB( ) 的最坏时间复杂度是 ,isPrimeA()优于isPrimeB( )
下面Python代码中的 isPrimeA() 和 isPrimeB() 都用于判断参数 是否为素数,有关其时间复杂度的正确说法是( )。
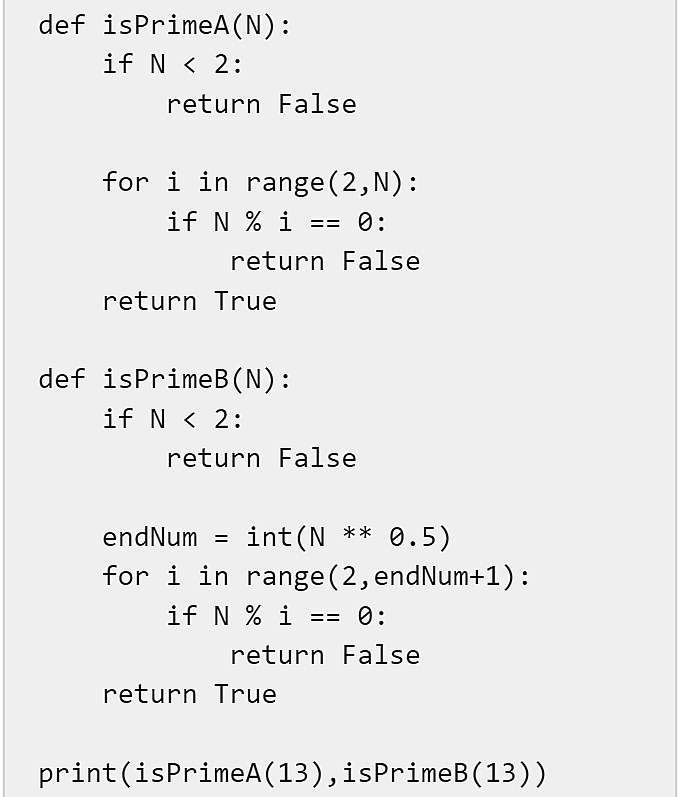
4. 在求解所有不大于 n 的素数时,线性筛法(欧拉筛)都应当优先于埃氏筛法使用,因为线性筛法的时间复杂度为 O(n),低于埃氏筛法的O(n loglogn)。()
 。
每个大于1的整数可以唯一地写成质数的乘积的形式
唯一分解定理概念:任意大于等于2的整数,都可以唯一分解位若干个质数的幂次方的乘积的形式。
求解指定正整数范围内所有质数,采用线性筛算法比埃氏筛效率更高。( )
埃氏筛:算法思想,从小到大枚举每个素数,将其所有的倍数标记为非素数。效率,时间复杂度约为O(n log log n),其中n是给定范围内的最大整数。
线性筛法:算法思想,类似于埃氏筛,但是通过线性的方式来标记非素数,而不是简单地使用倍数关系。效率,时间复杂度为O(n),相对于埃氏筛有更好的性能。
相等序列
时间限制:3.0 s
内存限制:512.0 MB
题目描述
小 A 有一个包含 N 个正整数的序列A = {A₁ , A₂ , · · ,A_N}。小 A 每次可以花费 1 个金币执行以下任意一种操作:
1. 选择序列中一个正整数 A_i( 1 ≤ i ≤ N),将 A_i 变为 A_i × P,P 为任意质数;
2. 选择序列中一个正整数 A_i( 1 ≤ i ≤ N),将 A_i 变为 A_i ÷ P,P 为任意质数,要求 A_i 能整除 P。
小 A 想请你帮他计算出令序列中所有整数都相同,最少需要花费多少金币。
输入格式
第一行一个正整数 N,含义如题面所示。
第二行包含 N 个正整数 A₁ , A₂ , · · ,A_N,代表序列 A。
输出格式
输出一行,代表最少需要花费的金币数量。
样例
输入样例
输出样例
数据范围
对于60%的测试点,保证 1 ≤ N, A_i ≤ 100。
对于所有测试点,保证 1 ≤ N, A_i ≤ 10⁵。
tokens = []
def get_val() :
    while not tokens:
        tokens.extend(input().split())
    return int(tokens.pop(0))

# 一共有多少数
n = get_val()
# key:质数
# value:一个列表 ,num[p][exp]表示有多少数质因数分解后可以包含p^exp
# 因为一个数最大就到10^5 ,相当于是10w ,所以列表最多包含20个数肯定够用 ,即2^20
num = {}

for _ in range(n) :
    # 统计一下各个输入数字有多少质因数
    x = get_val()
    d = 2
    # 质因数必定小于根号x
    tmp = x
    while d * d <= tmp:
        # 如果找到了一个数是x的因数
        if tmp % d == 0 :
            cnt = 0
            # 那就一直除以这个数 ,并且更新x的质因数数目
            # 这样一来剩下能够整除x的必定是质数
            while tmp % d == 0 :
                tmp //= d
                cnt += 1
            if d not in num:
                num[d] = [0] * 20
            # 数字x包含d^cnt ,更新状态
            num[d][cnt] += 1
        d += 1
    # 如果x是质数
    if tmp > 1 :
        if tmp not in num:
            num[tmp] = [0] * 20
        num[tmp][1] += 1

ans = 0
for p in num:
    counts = num[p]
    # 计算有多少数字不包含这个质因数
    counts[0] = n - sum(counts)
    # 寻找中位数指数
    # 也就是寻找一个指数e,使得一半的数字包含超过e次方的p,另一半不包含
    pos = 0
    median_exponent = 0
    for j in range(20) :
        pos += counts[j]
        if pos * 2 >= n:
            median_exponent = j
            break
    # 计算代价
    for j in range(20) :
        if counts[j] :
            ans += counts[j] * abs(j - median_exponent)
print(ans)原根判断
题目描述
小 A 知道,对于质数p 而言,p 的原根g 是满足以下条件的正整数:
·1<g<p
·gp-1 mod p=1
·对于任意1≤i<p-1 均有 gi mod p≠1。
其中a mod p 表示a 除以 p的余数。
小 A 现在有一个整数a ,请你帮他判断 a是不是p 的原根。
输入格式
第一行,一个正整数 T,表示测试数据组数。
每组测试数据包含一行,两个正整数a ,p 。
输出格式
对于每组测试数据,输出一行,如果 a是 p的原根则输出 Yes ,否则输出 No 。
输入样例
输出样例
数据范围
对于 40% 的测试点,保证3≤p≤103 。
对于所有测试点,保证1≤T≤20 ,3≤p≤109,1<a<p ,p为质数。
def fpw(b, e, p):
	if e == 0:
		return 1
	r = fpw(b, e >> 1, p)
	return r * r * (b if e & 1 else 1) % p

def solve():
	a, p = map(int, input().split())
	phi, v = p - 1, p - 1
	for i in range(2, int(phi ** 0.5) + 2):
		if v % i == 0:
			while v % i == 0:
				v //= i
			if fpw(a, phi // i, p) == 1:
				print("No")
				return
	if v > 1:
		if fpw(a, phi // v, p) == 1:
			print("No")
			return
	print("Yes")

[solve() for _ in range(int(input()))]