GESP-Python五级 题库
共 296 道题
,第 8 / 15 页
· 按题型筛选,点「查看答案」核对解析
141
单选题
适中
根据下面Python代码的注释,横线处应填入( )。
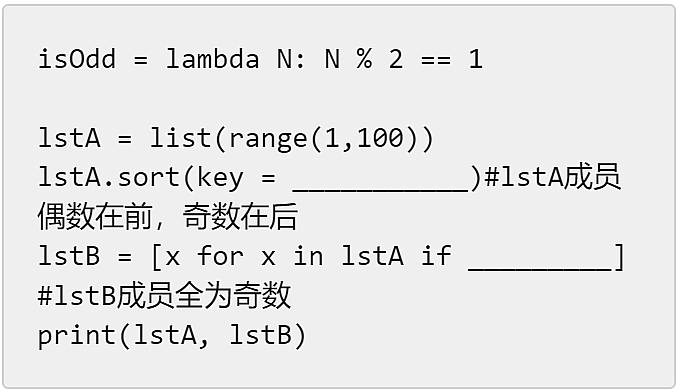
A
isOdd isOdd(x)
B
isOdd(x) isOdd
C
isOdd isOdd
D
isOdd(x) isOdd(x)
答案与解析
正确答案:A
这道题暂未补解析。
142
单选题
适中
有关下面Python代码正确的是( )。
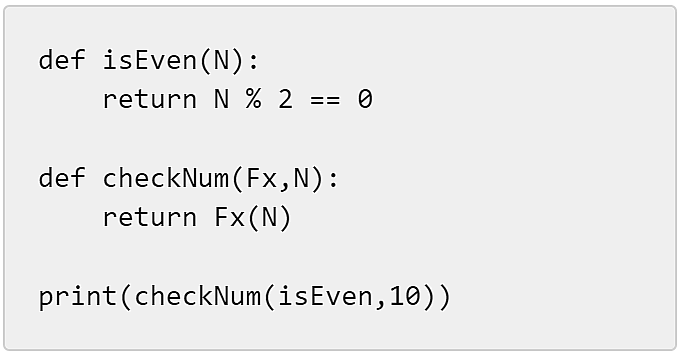
A
checkNum() 函数定义错误
B
最后一行代码将 isEven 作为 checkNum() 参数将导致错误
C
最后一行代码执行后将输出 True
D
触发异常
答案与解析
正确答案:C
这道题暂未补解析。
143
单选题
适中
有关下面Python代码正确的是( )。
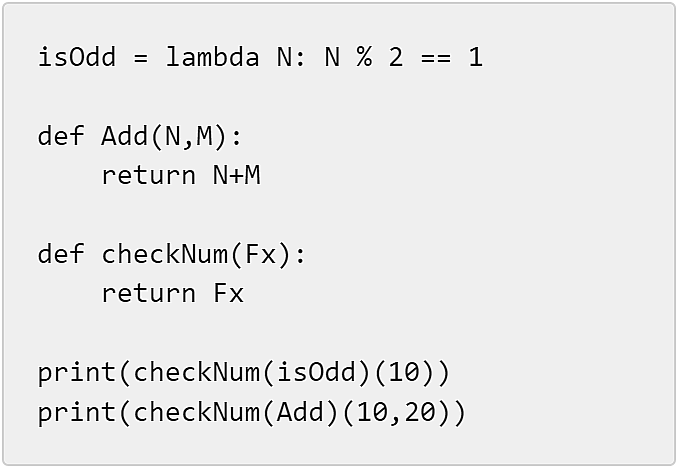
A
checkNum() 函数定义错误
B
倒数第 行代码将 isOdd 作为 checkNum() 参数将导致错误
C
最后一行代码将 Add 作为 checkNum() 参数将导致错误
D
倒数两行代码执行后都将没有错误
答案与解析
正确答案:D
这道题暂未补解析。
144
单选题
适中
下面代码执行后的输出是( )。
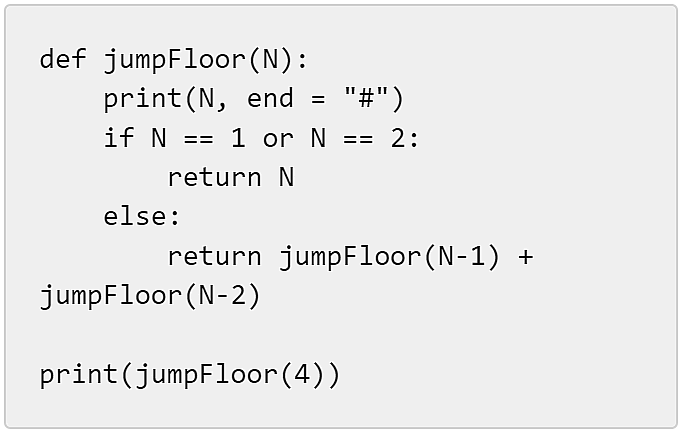
A
4#3#2#2#4
B
4#3#2#2#1#5
C
4#3#2#1#2#4
D
4#3#2#1#2#5
答案与解析
正确答案:D
这道题暂未补解析。
145
单选题
适中
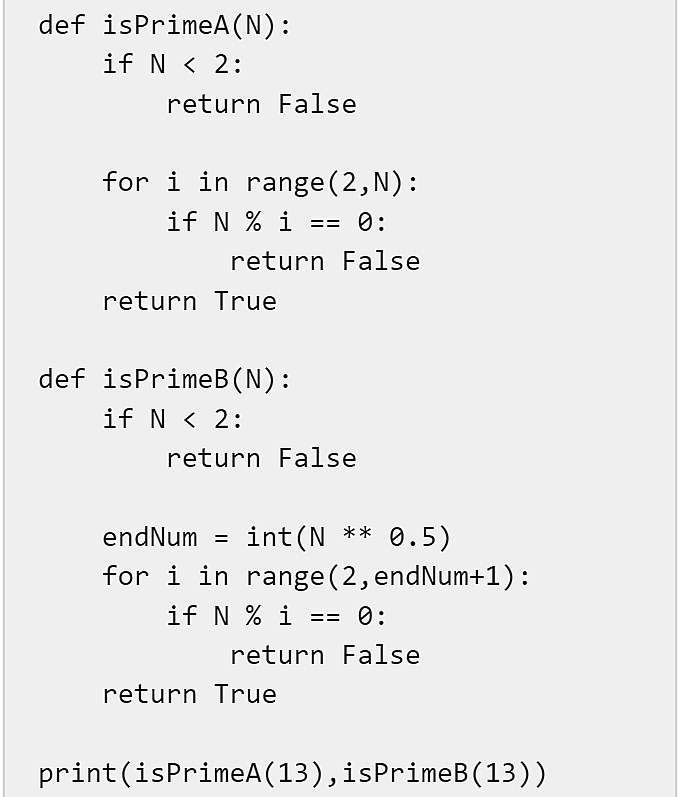
下面Python代码中的 isPrimeA() 和 isPrimeB() 都用于判断参数 是否为素数,有关其时间复杂度的正确说法是( )。
A
isPrimeA() 的最坏时间复杂度是0(N) , isPrimeB() 的最坏时间复杂度是0(logN) , isPrimeA() 优于isPrimeB()
B
isPrimeA() 的最坏时间复杂度是0(N) , isPrimeB() 的最坏时间复杂度是 0(N1/2), isPrimeB() 优于isPrimeA()
C
isPrimeA() 的最坏时间复杂度是 0(N1/2), isPrimeB() 的最坏时间复杂度是 0(N), isPrimeA() 优于isPrimeB()
D
isPrimeA() 的最坏时间复杂度是 0(logN), isPrimeB() 的最坏时间复杂度是 0(N), isPrimeB() 优于isPrimeB()
答案与解析
正确答案:B
这道题暂未补解析。
147
单选题
适中
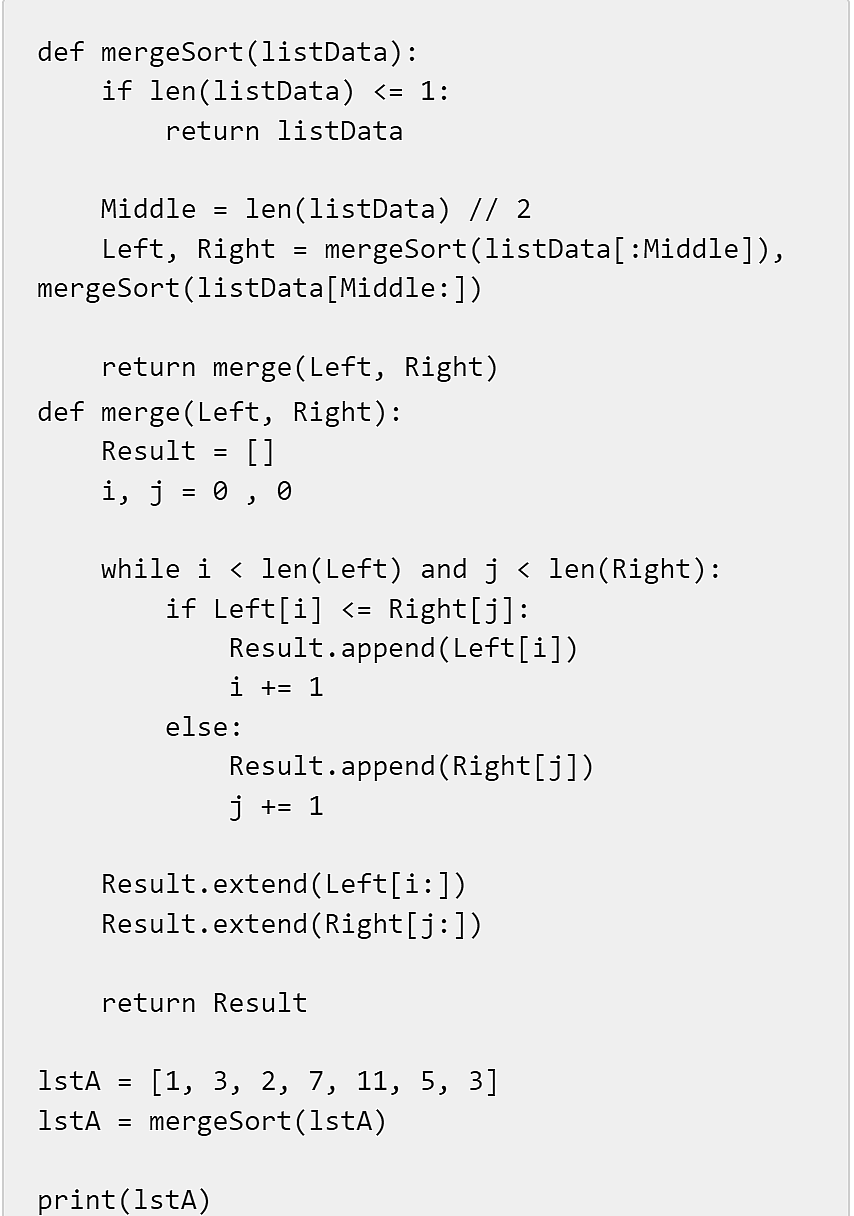
在上题的归并排序算法中,代码
Left, Right = mergeSort(listData[:Middle]),
mergeSort(listData[Middle:]) 涉及到的算法有( )。
A
搜索算法
B
分治算法
C
贪心算法
D
递推算法
答案与解析
正确答案:B
这道题暂未补解析。
148
单选题
适中
归并排序算法的基本思想是( )。
A
将数组分成两个子数组,分别排序后再合并。
B
随机选择一个元素作为枢轴,将数组划分为两个部分。
C
从数组的最后一个元素开始,依次与前一个元素比较并交换位置。
D
比较相邻的两个元素,如果顺序错误就交换位置。
答案与解析
正确答案:A
这道题暂未补解析。
149
单选题
适中
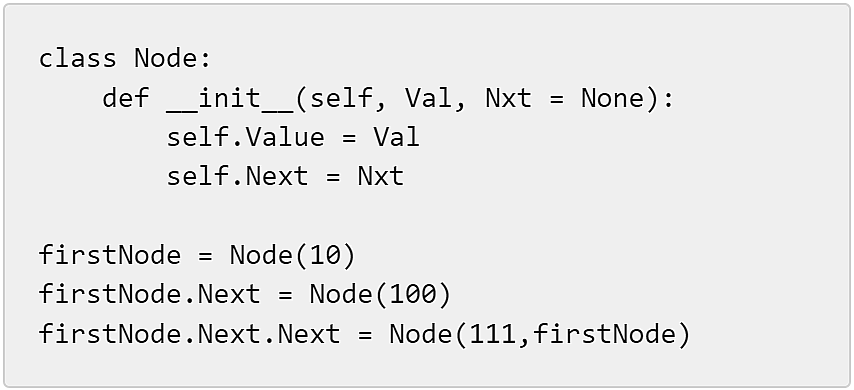
有关下面Python代码的说法正确的是( )。
A
上述代码构成单向链表
B
上述代码构成双向链表
C
上述代码构成循环链表
D
上述代码构成指针链表
答案与解析
正确答案:C
这道题暂未补解析。
150
单选题
适中
题关于Python 实现的单链表、双链表和循环链表,下列说法正确的是()。
A
在Python 实现的单链表中,若已知任意结点对象的引用,则可以在O(1)时间内删除该结点。
B
Python 实现的循环链表中一定不存在值为None 的引用属性。
C
在Python 实现的循环双链表中,尾结点对象的next 属性值一定为None。
D
在Python 实现的带头结点的循环单链表中,判定链表是否为空只需判断头结点对象的next 属性是否引用头结点自身(即head.next is head)。
答案与解析
正确答案:D
这道题暂未补解析。
151
单选题
适中
双向循环链表中要在结点p 之前插入新结点s(均非空),以下操作正确的是()。
A
s.next=pp .prev=sq.next=ss .prev=q
B
s .prev=ps.next=p.next p.next.prev=sp.next=s
C
s.next=ps .prev=p .prev p.prev.next=sp .prev=s
D
s.next=ps .prev=nullptrp .prev=s
答案与解析
正确答案:C
这道题暂未补解析。
152
单选题
适中
下面函数删除单向链表中val == x 的节点,并且使用哑结点统一对头结点和中间节点的删除操作。横线处应填()。
A
cur = cur.next
B
cur.next = cur.next.next
C
cur.next = None
D
cur.next = nullptr
答案与解析
正确答案:B
使用哑结点后,当前指针cur从dummy开始,遍历链表。当cur.next存在时,判断其值是否等于x。若相等,则通过修改cur.next指向其下下个节点跳过目标节点,此时不应移动cur,因为下一个节点可能仍需删除。若不相等,则将cur向前移动一个节点。循环继续直到遍历结束。返回dummy.next作为新头节点。填空处位于删除操作后的分支,需决定删除后cur的移动行为。
153
单选题
适中
对如下代码实现的欧几里得算法(辗转相除法),调用gcd(48 , 18) 得到的调用序列为()。
def gcd(a, b):
    if b == 0:
        return a
    else:
        return gcd(b, a % b)
A
gcd(48 ,18) -> gcd(18 ,12) -> gcd(12 ,6) -> gcd(6 ,0)
B
gcd(48 ,18) -> gcd(30 ,18) -> gcd(12 ,18)
C
gcd(48 ,18) -> gcd(18 ,30) -> gcd(30 ,6)
D
gcd(48 ,18) -> gcd(12 ,18) -> gcd(6 ,12)
答案与解析
正确答案:A
函数gcd接收两个参数a和b,当b不为0时,递归调用gcd(b, a % b);每次递归将原b作为新的a,原a对b取模的结果作为新的b。初始调用为gcd(48, 18),进入递归过程:首先计算48 % 18得12,生成下一层调用gcd(18, 12);接着计算18 % 12得6,生成gcd(12, 6);再计算12 % 6得0,生成gcd(6, 0);此时b为0,递归终止,返回当前a的值。整个调用链由连续取模操作驱动,每一步的第二个参数均为前一步的模运算结果,直到模为0停止。
154
单选题
适中
下面代码实现了欧拉(线性)筛,横线处应填写()。
def euler_sieve_for(n):
    if n < 2:
        return []
    is_composite = [False] * (n + 1)
    primes = []

    for i in range(2, n + 1):
        if not is_composite[i]:
            primes.append(i)

        for j in range(len(primes)):  # 填空处
            p = primes[j]
            if i * p > n:
                break
            is_composite[i * p] = True
            if i % p == 0:
                break
    return primes
A
for j in range(len(primes+1)):
B
for j in range(len(primes)+1):
C
for j in range(len(primes)):
D
for j in range(len(primes)-1):
答案与解析
正确答案:C
函数目标是生成不超过n的质数列表。使用欧拉筛时,每个合数仅被其最小质因子筛去。外层循环遍历2到n的整数i,内层循环遍历已记录的质数列表primes中的元素p。当i能被p整除时,说明p是i的最小质因子,之后的合数将由更大的i处理,因此立即break。若i为质数,则加入primes。is_composite数组用于标记合数,避免重复筛选。内层循环需遍历当前全部已得质数,故循环范围应为primes的有效索引区间。j作为索引变量,应覆盖0到len(primes)-1的所有值,确保访问每个已知质数p = primes[j]。循环上限为len(primes),下限为0,步长为1,因此range参数应为len(primes)。
155
单选题
适中
埃氏筛中将内层循环从j = i*i 开始而不是j = 2*i 的主要原因是()。
def eratosthenes_sieve_for(n):
    if n < 2:
        return []
    is_composite = [False] * (n + 1)
    primes = []

    for i in range(2, n + 1):
        if is_composite[i]:
            continue
        primes.append(i)

        # 用for循环模拟C++的 j = i*i; j <=n; j +=i
        for j in range(i * i, n + 1, i):
            is_composite[j] = True

    return primes
A
因为2*i 一定不是合数
B
i*i 一定是质数
C
小于i*i 的i 的倍数已被更小质因子筛过
D
这样可以把时间复杂度降为O(n)
答案与解析
正确答案:C
埃氏筛法标记合数时,对于当前质数i,其倍数中需被筛去的合数从i*i开始。因小于i*i的i的倍数可表示为k*i(k < i),其中k必有小于i的质因子,这些倍数已在处理更小质数时被标记。内层循环跳过2*i、3*i等直至i*i,是因它们已被先前步骤覆盖。时间复杂度仍为O(n log log n),未降至O(n)。i*i不一定是质数,且2*i在i>1时为合数。
156
单选题
适中
下面程序的运行结果为()。
def check(n, a, k, dist):
    cnt = 1
    last = a[0]

    for i in range(1, n):
        if a[i] - last >= dist:
            cnt += 1
            last = a[i]

    return cnt >= k

def solve(n, a, k):
    a.sort()

    l = 0
    r = a[-1] - a[0]

    while l < r:
        mid = (l + r + 1) // 2
        if check(n, a, k, mid):
            l = mid
        else:
            r = mid - 1

    return l

if __name__ == "__main__":
    a = [1, 2, 8, 4, 9]
    n = 5
    k = 3
    result = solve(n, a, k)
    print(result)
A
2
B
3
C
4
D
5
答案与解析
正确答案:B
函数 check 接收四个参数:n 表示数组长度,a 为升序排列的数值数组,k 为目标数量,dist 为最小距离。遍历数组 a,统计满足相邻元素差值不小于 dist 的元素个数 cnt,返回 cnt 是否大于等于 k。函数 solve 对数组 a 排序后,使用二分查找确定最大化的最小距离。左边界 l 初始化为 0,右边界 r 初始化为数组最大值与最小值之差。在二分过程中,计算中点 mid,通过 check 函数判断是否存在至少 k 个元素,其相邻元素间距离不小于 mid。若满足条件,则尝试增大距离;否则减小距离。循环持续至区间收敛。
157
单选题
适中
在升序数组中查找第一个大于等于x 的位置,下面循环中横线应填()。
def lowerBound(a, x):
    l = 0
    r = len(a)
    while l < r:
        mid = l + (r - l) // 2
        if a[mid] >= x:
            r = mid  # 填空处
        else:
            l = mid + 1
    return l

if __name__ == "__main__":
    a1 = [1, 3, 5, 7, 9]
    x1 = 5
    print(f"数组{a1}中第一个≥{x1}的位置: {lowerBound(a1, x1)}")
A
r = mid
B
r = mid - 1
C
l = mid
D
l = mid + 1
答案与解析
正确答案:A
使用二分查找在升序数组中定位第一个大于等于x的位置。初始化左指针l为0,右指针r为数组长度。循环条件为l < r,取中点mid = (l + r) // 2。若a[mid] >= x,则mid可能是解,将r更新为mid以保留该位置;否则a[mid] < x,说明mid及左侧均不可能满足条件,将l更新为mid + 1以排除该区域。循环结束时l即为首个满足条件的位置。填空处位于a[mid] >= x分支内,需维护右边界向左收缩的逻辑。
158
单选题
适中
关于递归函数调用,下列说法错误的是()。
A
递归调用层次过深时,可能会耗尽栈空间导致栈溢出
B
尾递归函数可以通过编译器优化来避免栈溢出
C
所有递归函数都可以通过循环结构来改写,从而避免栈溢出
D
栈溢出发生时,程序会抛出异常并可以继续执行后续代码
答案与解析
正确答案:D
递归函数调用时,每次调用都会在调用栈中创建新的栈帧,保存局部变量和返回地址。调用层次过深会导致栈空间耗尽,引发栈溢出。尾递归在特定条件下可被编译器优化为迭代形式,复用栈帧,避免栈空间持续增长。理论上,所有递归逻辑均可转换为循环结构,通过显式维护状态数据实现等价功能。栈溢出属于运行时严重错误,触发后程序控制流中断,无法保证后续代码的正常执行路径。
159
单选题
适中
给定n 根木头,第i 根长度为a [i]。要切成不少于m 段等长木段,求最大可能长度,则横线上应填写()。
def check(a, m, x):
    cnt = 0
    for length in a:
        if x == 0:
            return True
        cnt += length
        if cnt >= m:
            return True
    return cnt >= m

def main():
    import sys
    input = sys.stdin.read().split()
    idx = 0
    n = int(input[idx])
    idx += 1
    m = int(input[idx])
    idx += 1

    a = []
    mx = 0
    for _ in range(n):
        num = int(input[idx])
        idx += 1
        a.append(num)
        mx = max(mx, num)

    l = 1
    r = mx
    ans = 0

    while l <= r:
        mid = l + (r - l) // 2
        if check(a, m, mid):
            ans = mid
            _________________
        else:
            _________________

    print(ans)

if __name__ == "__main__":
    main()
A
l = mid + 1 和 r = mid - 1
B
r = mid - 1 和l = mid + 1
C
l = mid + 1 和 r = mid
D
l = mid - 1 和 r = mid + 1
答案与解析
正确答案:A
使用二分查找确定最大可能长度。左边界为1,右边界为最长木头的长度。每次取中点作为候选长度,通过check函数验证是否能切出至少m段。若可以,则尝试更大的长度,更新左边界;否则尝试更小的长度,更新右边界。循环直至区间收敛,得到最大可行解。
160
单选题
适中
下面代码用分治求“最大连续子段和”,其时间复杂度为()。
import sys
def solve(a , l , r):
    if l == r:
        return a [l]
    mid = l + (r - l) // 2
    left = solve(a , l , mid)
    right = solve(a , mid + 1 , r)
    sum_val = 0
    lmax = -sys .maxsize - 1
    for i in range(mid , l - 1 , -1):
        sum_val += a [i]
        lmax = max (lmax , sum_val)
    sum_val = 0
    rmax = -sys .maxsize - 1
    for i in range(mid + 1 , r + 1):
        sum_val += a [i]
        rmax = max (rmax , sum_val)
    return max(left , right , lmax + rmax)

if __name__ == "__main__":
    a1 = [-2 , 1 , -3 , 4 , -1 , 2 , 1 , -5 , 4]
    print(solve(a1 , 0 , len(a1)-1))
    a2 = [-5 , -3 , -1 , -4]
    print(solve(a2 , 0 , len(a2)-1))
    a3 = [10]
    print(solve(a3 , 0 , 0))
A
O(n2)
B
O(nlogn)
C
O(logn)
D
O(n)
答案与解析
正确答案:B
这道题暂未补解析。