GESP-Python五级 题库
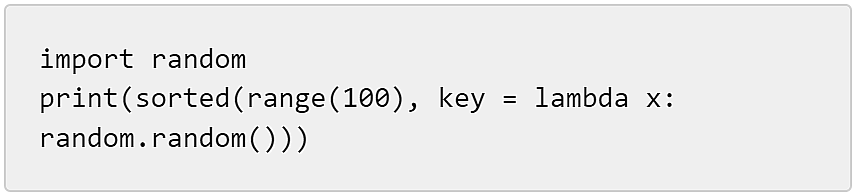
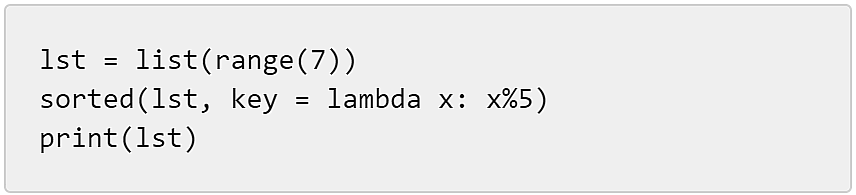
Python的内置函数 sorted() 可以对支持 for-in 循环的 str 、 list 、 tuple 、 dict 、 set 排序,且是稳定排序。
有一个存储了 n 个整数的线性表,分别用 Python 列表(数组)和自定义单链表两种方式实现。在已知元素下标(或结点对象引用)的前提下,Python 列表的随机访问操作时间复杂度为O(1);而在 Python 实现的单链表中,已知某结点对象的引用时,在该结点之后插入一个新结点的操作时间复杂度也为O(1)。
若数组a 已按升序排列,则下面代码可以正确实现“在a 中查找第一个大于等于x 的元素的位置”。
def lowerBound(a, x):
    l = 0
    r = len(a)
    while l < r:
        mid = (l + r) // 2
        if a[mid] >= x:
            r = mid
        else:
            l = mid + 1
    return l

if __name__ == "__main__":
    a1 = [1, 3, 5, 7, 9]
    x1 = 5
    print(f"数组{a1}中第一个≥{x1}的位置: {lowerBound(a1, x1)}")

    x2 = 6
    print(f"数组{a1}中第一个≥{x2}的位置: {lowerBound(a1, x2)}")

    x3 = 10
    print(f"数组{a1}中第一个≥{x3}的位置: {lowerBound(a1, x3)}")

    x4 = 0
print(f"数组{a1}中第一个≥{x4}的位置: {lowerBound(a1, x4)}")快速排序只要每次都选取中间元素作为枢轴,就一定是稳定排序。
在一个数组中,如果两个元素a [i] 和a [j]满足i < j 且a [i] > a [j],则a [i] 和a [j]是一个逆序对。
下面代码可以正确统计数组a 区间[l ,r] 内的逆序对总数。
cnt = 0
def merge_count(a , l , m , r):
    global cnt
    i = l
    j = m + 1
    while i <= m and j <= r:
        if a [i] <= a [j]:
            i += 1
        else:
            cnt += (m - i + 1)
            j += 1
if __name__  == "__main__":
    a = [2 , 4 , 1 , 3]
    merge_count(a , 0 , 1 , 3)
print(f "跨区间逆序对数量:{cnt}")唯一分解定理保证:若一个数未被任何不超过其平方根的质数筛去,则它一定是质数。
假设数组a的值域范围是D,以下程序的时间复杂度是O(nlogn+nlogD)。
def check(n , a , k , dist):
    cnt = 1
    last = a [0]
    for i in range(1 , n):
        if a [i] - last >= dist :
            cnt += 1
            last = a [i]
    return cnt >= k

def solve(n , a , k):
    a_sorted = a .copy()
    a_sorted .sort()
    l = 0
    r = a_sorted [-1] - a_sorted [0]
    while l < r:
        mid = (l + r + 1) // 2
        if check(n , a_sorted , k , mid):
            l = mid
        else:
            r = mid - 1
    return l

if __name__   == "__main__":
    a = [1 , 2 , 8 , 4 , 9]
    n = 5
    k = 3
    result = solve(n , a , k)
    print(result)
若一个问题满足最优子结构性质,则一定可以用贪心算法得到最优解。()
线性筛相比埃氏筛的核心改进在于:埃氏筛中一个合数可能被多个质数重复标记,线性筛通过"每个合数只被其最大质因子筛去"的策略,保证每个合数恰好被标记一次,从而实现O(n)的时间复杂度。
任何递归程序都可以改写为等价的非递归程序,但改写后的非递归程序一定需要显式地使用栈来模拟递归调用过程。
数字移动
时间限制:3.0 s
内存限制:512.0 MB
题目描述
小 A 有一个包含 N 个正整数的序列 A = A₁ , A₂, … …A_N,序列 A 恰好包含成对不同的正整数。形式化地,对于任意 1 ≤ i ≤ N ,存在唯一一个 j 满足 1 ≤j≤ N, i≠ j, A_i = A_j。
小 A 希望每对相同的数字在序列中相邻,为了实现这一目的,小 A 每次操作会选择任意 i (1 ≤ i ≤ N),将当前序列的第 i 个数字移动到任意位置,并花费对应数字的体力。
例如,假设序列 A = {1 , 2, 1 , 3, 2, 3},小 A 可以选择 i = 2,将 A₂ = 2 移动到 A₃=1 的后面,此时序列变为{1 , 1 , 2, 3, 2, 3},耗费 2 点体力。小 A 也可以选择 i = 3,将 A₃=1 移动到A₂ = 2 的前面,此时序列变为{1 , 1 , 2, 3, 2, 3},花费 1 点体力
小 A 可以执行任意次操作,但他希望自己每次花费的体力尽可能小。小 A 希望你能帮他计算出一个最小的 X,使得他能够在每次花费的体力均不超过 X 的情况下令每对相同的数字在序列中相邻。
输入格式
第一行一个正整数 N,代表序列长度,保证 N 为偶数。
第二行包含 N 个正整数 A₁ , A₂ , · · . , A_N,代表序列 A。且对于任意 1 ≤ i ≤ N,存在唯一一个j 满足1 ≤ j ≤ N, i≠ j, A_i= A_j。
数据保证小 A 至少需要执行一次操作。
输出格式
输出一行,代表满足要求的 X 的最小值。
样例
输入样例
输出样例
仅移动数值1即可完成全部配对,所有操作体力≤1,最小X=1。 数据范围 对于40%的测试点,保证 1 ≤ N, A_i ≤ 100。 对于所有测试点,保证 1 ≤ N, A_i ≤ 10⁵。
# 输入n和a数组
n = int(input())
a = []
while len(a) < n:
    a.extend(map(int, input().split()))

# 答案的上下界
left, right = 0, 1000000
ans = 1000000

# 二分搜索
while left <= right:
    # 考虑mid的力气能否完成任务
    mid = (left + right) // 2
    # 筛选出所有大于mid的数字
    b = [x for x in a if x > mid]
    # 先假设能够完成任务
    possible = True
    for i in range(0, len(b), 2):
        # 如果两个相同且大于mid的数字 ,中间还有其它的大于mid的数字 ,则本任务无法完成
        # 以 (1  2  1  3)为例 ,两个1之间存在2。假设最大只能挪动1 ,则不论如何两个1之间的2不会被挪动,最终无法完成配对
        if b[i] != b[i+1]:
            possible = False
            break
    # 如果能够成功 ,则尝试更小的mid
    if possible:
        ans = mid
        right = mid - 1
    else:
        left = mid + 1
print(ans)
相等序列
时间限制:3.0 s
内存限制:512.0 MB
题目描述
小 A 有一个包含 N 个正整数的序列A = {A₁ , A₂ , · · ,A_N}。小 A 每次可以花费 1 个金币执行以下任意一种操作:
1. 选择序列中一个正整数 A_i( 1 ≤ i ≤ N),将 A_i 变为 A_i × P,P 为任意质数;
2. 选择序列中一个正整数 A_i( 1 ≤ i ≤ N),将 A_i 变为 A_i ÷ P,P 为任意质数,要求 A_i 能整除 P。
小 A 想请你帮他计算出令序列中所有整数都相同,最少需要花费多少金币。
输入格式
第一行一个正整数 N,含义如题面所示。
第二行包含 N 个正整数 A₁ , A₂ , · · ,A_N,代表序列 A。
输出格式
输出一行,代表最少需要花费的金币数量。
样例
输入样例
输出样例
数据范围
对于60%的测试点,保证 1 ≤ N, A_i ≤ 100。
对于所有测试点,保证 1 ≤ N, A_i ≤ 10⁵。
tokens = []
def get_val() :
    while not tokens:
        tokens.extend(input().split())
    return int(tokens.pop(0))

# 一共有多少数
n = get_val()
# key:质数
# value:一个列表 ,num[p][exp]表示有多少数质因数分解后可以包含p^exp
# 因为一个数最大就到10^5 ,相当于是10w ,所以列表最多包含20个数肯定够用 ,即2^20
num = {}

for _ in range(n) :
    # 统计一下各个输入数字有多少质因数
    x = get_val()
    d = 2
    # 质因数必定小于根号x
    tmp = x
    while d * d <= tmp:
        # 如果找到了一个数是x的因数
        if tmp % d == 0 :
            cnt = 0
            # 那就一直除以这个数 ,并且更新x的质因数数目
            # 这样一来剩下能够整除x的必定是质数
            while tmp % d == 0 :
                tmp //= d
                cnt += 1
            if d not in num:
                num[d] = [0] * 20
            # 数字x包含d^cnt ,更新状态
            num[d][cnt] += 1
        d += 1
    # 如果x是质数
    if tmp > 1 :
        if tmp not in num:
            num[tmp] = [0] * 20
        num[tmp][1] += 1

ans = 0
for p in num:
    counts = num[p]
    # 计算有多少数字不包含这个质因数
    counts[0] = n - sum(counts)
    # 寻找中位数指数
    # 也就是寻找一个指数e,使得一半的数字包含超过e次方的p,另一半不包含
    pos = 0
    median_exponent = 0
    for j in range(20) :
        pos += counts[j]
        if pos * 2 >= n:
            median_exponent = j
            break
    # 计算代价
    for j in range(20) :
        if counts[j] :
            ans += counts[j] * abs(j - median_exponent)
print(ans)试题名称:数字选取
时间限制:1.0 s
内存限制:512.0 MB


n = int(input())
# p[0]、p[1]占位/置0,2~n初始标记为1(是质数)
p = [1] * (n + 1)
p[0] = p[1] = 0

# 只筛到根号n
for i in range(2, int(n ** 0.5) + 1):
    if p[i] == 1:  # i是质数,筛掉它所有倍数
        # 从i*i开始,步长i
        for j in range(i * i, n + 1, i):
            p[j] = 0

# sum(p) 等于1~n内质数总个数
print(sum(p))
试题名称:有趣的数字和
时间限制:1.0 s
内存限制:512.0 MB


def cal2(n, p):
    """
    计算奇偶性为p的 0~n 的有趣的数之和,要求n为2^k - 1的形式
    :return: 有趣的数量, 有趣的数之和
    """
    if n == 0:
        return 1 - p, 0
    if n == 1:
        return 1, p
    return (n + 1) // 2, n * (n + 1) // 4


def cal(n, p):
    """
    计算奇偶性为p的 0~n 的有趣的数之和
    :return: 有趣的数量, 有趣的数之和
    """
    if n <= 1:
        return cal2(n, p)
    x = 1
    while x * 2 <= n:
        x *= 2
    # 找出最大x=2^k,x-1=2^k-1 <= n
    cntl, sl = cal2(x - 1, p)
    # 剩下部分:最高位1去掉,剩余数位奇偶性相反 1-p
    cntr, sr = cal(n - x, 1 - p)
    # 总数 = 左半部分 + 右半部分
    total_cnt = cntl + cntr
    # 总和 = 左半和 + 右半和 + 高位x 乘右边数字个数
    total_sum = sl + sr + x * cntr
    return total_cnt, total_sum


# 主程序
l, r = map(int, input().split())
# 0 ~ l-1 的符合条件数字总和
_, ansl = cal(l - 1, 1)
# 0 ~ r 的符合条件数字总和
_, ansr = cal(r, 1)
# [l, r] 区间和 = 0~r总和 - 0~l-1总和
print(ansr - ansl)
奖品兑换


# 接受小A持有的两种券的数量
n, m = map(int, input().split())
# 兑换1份奖品分别所需两种券的数量
a, b = map(int, input().split())

# 统一处理:把持有券、所需券都调整为 (少, 多) 的顺序,简化后续计算
n, m = min(n, m), max(n, m)
a, b = min(a, b), max(a, b)


def check(v):
    """
    检测手头的券能否兑换 v 份礼品
    :param v: 目标礼品数目
    :return: 能兑换返回True,不能返回False
    """
    # 兑换v份礼品原始需求:x=少券总需求,y=多券总需求
    x, y = a * v, b * v

    # 如果多券需求超过持有上限,调整兑换组合
    if y >= m and b > a:
        t = (y - m + (b - a) - 1) // (b - a)
        y -= t * (b - a)
        x += t * (b - a)

    # 调整后两种券需求都不超过持有量则可行
    return x <= n and y <= m


# 二分查找最大可兑换份数
l, r = 0, int(1e9)
while l < r:
    mid = (l + r + 1) // 2
    if check(mid):
        l = mid
    else:
        r = mid - 1

print(r)
最大公因数


# 读取数字个数n、查询次数q
n, q = map(int, input().split())
# 读取数组并升序排序
a = sorted(list(map(int, input().split())))

# 欧几里得算法求最大公约数
def gcd(a, b):
    if a == 0 or b == 0:
        return a + b
    return gcd(b, a % b)

# 计算相邻元素差值的整体最大公约数
g = 0
for i in range(1, n):
    diff = a[i] - a[i - 1]
    g = gcd(g, diff)

# 处理每组查询
for i in range(q):
    val = a[0] + i + 1
    print(gcd(g, val))