GESP-C++七级 题库
图的广度优先搜索中既要维护一个标志数组标志已访问的图的结点,还需哪种结构存放结点以实现遍历?( )
双向栈
队列
哈希表
堆
学生在读期间所上的某些课程中需要先上其他的课程,所有课程和课程间的先修关系构成一个有向图 G ,有向边 <U, V> 表示课程 U 是课程 V 的先修课,则要找到某门课程 C 的全部先修课下面哪种方法不可行?( )
BFS搜索
DFS搜索
DFS+BFS
动态规划
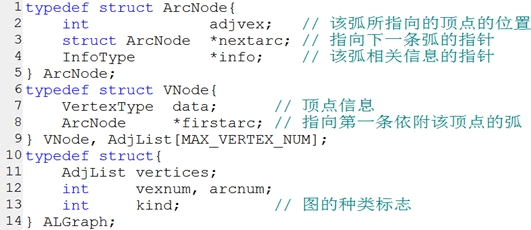
用下面的邻接表结构保存一个有向图 G , InfoType 和 VertexType 是定义好的类。设 G 有 n 个顶点、e 条弧,则求图 G 中某个顶点 u (其顶点序号为 k )的度的算法复杂度是( )。
O(n)
O(e)
O(n+e)
O(n+2*e)
给定一个简单有向图 G ,判断其中是否存在环路的下列说法哪个最准确?( )
BFS更快
DFS更快
BFS和DFS一样快
不确定
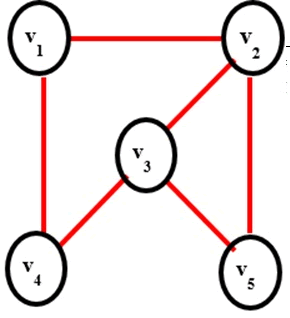
从顶点 v1 开始遍历下图 G 得到顶点访问序列,在下面所给的 4 个序列中符合广度优先的序列有几个?( )
{v1 v2 v3 v4 v5} , {v1 v2 v4 v3 v5} , {v1 v4 v2 v3 v5} , {v1 v2 v4 v5 v3}
求两个长度为 序列的最长公共子序列(LCS)长度时,可以使用滚动数组将空间复杂度从优化到。
使用邻接矩阵存储一个有 个顶点、 条边的图,对该图进行一次完整的BFS遍历,时间复杂度为。
一个包含V个顶点的连通无向图,其任何一棵生成树都恰好包含 V-1条边。
在无向图中,所有顶点的度数之和等于边数的两倍。2025.12-7

邻接表和邻接矩阵都是图的存储形式。为了操作时间复杂度考虑,同一个图可以同时维护两种存储形式。( )
两种维护方式并不冲突。(图结构的存储)
邻接表和邻接矩阵都是图的存储形式。邻接表在遍历单个顶点的所有边时,时间复杂度更低;邻接矩阵在判断两个顶点之间是否有边时,时间复杂度更低。
一个图中,每个顶点表达一个城市,连接两个顶点的边表达从一个城市到达另一个城市的一种交通方式。这个图可以用来表达交通网络,且是简单有向图。
埃氏筛法和欧拉筛法都是使用筛法思想生成素数表的算法,欧拉筛法的时间复杂度更低。
埃氏筛法的时间复杂度是O(n log logn),欧拉筛法是O(n)。
一个图,不管是否连通,都可以使用深度优先搜索算法进行遍历。
与连通性无关。对于非连通图,遍历完一个连通分量后,可以在未访问的节点中选择新的起点,继续进行DFS,直到所有节点都被访问。
一个图中,每个结点表达一个人,连接两个结点的边表达两个结点对应的人相互认识,则这个图可以用来表达社交网络
图属于网状结构可以表示社交网络。
唯一分解定理(算术基本定理)指出,每个大于1的自然数都可以唯一地分解成若干个素数的乘积。因此,我们可以很容易的对给定的自然数 n 进行质因数分解,时间复杂度仅为O(log(n))。
对n进行质因数分解的时间复杂度为O(sqrt(n)