GESP-C++七级 题库
共 27 道题
,第 1 / 2 页
· 按题型筛选,点「查看答案」核对解析
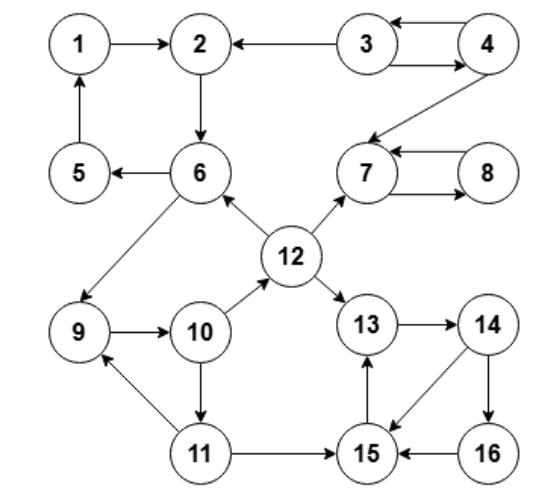
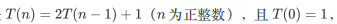 那么这个算法的时间复杂度是( )。


2
单选题
适中
下面关于“唯一分解定理”和“素数筛法”的说法中,错误的是( )。
A
如果预处理出n以内每个数的最小质因子,那么可以在O(logn)时间内完成任意一个不超过 的整数的质因 数分解。
B
线性筛(欧拉筛)能够保证每个合数只被其最小质因子筛掉一次,这一性质依赖于唯一分解定理。
C
唯一分解定理保证:若一个数未被任何不超过其平方根的质数筛去,则它一定是质数。
D
唯一分解定理是埃氏筛时间复杂度为 的根本原因。
 答案与解析
正确答案:D
这道题暂未补解析。
3
单选题
适中
若字符串 与字符串 的最长公共子序列(LCS)长度为 5,则( )。
A
它们的编辑距离为 5
B
它们至少有 5 个公共字符
C
它们最长公共子串长度为 5
D
它们一定长度相等
答案与解析
正确答案:B
最长公共子序列(LCS)是指两个字符串中按顺序出现且字符相同的最长子序列,不要求连续。LCS长度为5表示存在5个字符在两个字符串中以相同顺序出现。编辑距离衡量通过插入、删除、替换操作将一个字符串转换为另一个的最少步数,与LCS无直接数值对应关系。公共字符数量至少等于LCS长度,因为LCS由实际存在的字符构成。最长公共子串要求字符连续,其长度小于或等于LCS长度,但不一定相等。字符串长度可以不同,LCS长度仅反映公共部分的顺序匹配程度,不约束总长度是否一致。

5
单选题
适中
题 关于哈希表(Hash Table)在不考虑扩容且采用简单均匀哈希函数的前提下,下列说法中错误的是( )。
A
装载因子越大,发生冲突的概率通常越高
B
开放定址法在删除元素时实现相对复杂
C
链地址法在最坏情况下查找时间复杂度为
D
查找哈希表的时间复杂度总是
答案与解析
正确答案:D
这道题暂未补解析。
6
单选题
适中
深度优先搜索(DFS)在遍历图时,每当访问到某个顶点后,选择一个相邻的未访问顶点继续搜索,直到某个顶点的所有相邻顶点均已被访问,则退回到前一顶点继续搜索。该算法主要运用了( )。
A
分治
B
贪心
C
动态规划
D
回溯
答案与解析
正确答案:D
深度优先搜索在访问顶点后,选择一个未访问的相邻顶点深入遍历,当无法继续前进时,返回上一顶点尝试其他分支。该过程依赖于系统调用栈或手动维护栈记录路径,每次回退到前一状态以探索其余可能路径。这种机制体现的是在搜索过程中保存状态并在无路可走时退回尝试其他选择的行为模式。分治将问题拆解为独立子问题求解;贪心每一步选择当前最优解;动态规划保存子问题结果避免重复计算;回溯则通过逐步构建解并在不可行时撤销选择继续搜索。
7
单选题
适中
下面程序的运行结果为( )。
#include <iostream>
#include <algorithm>

bool check(int n, int a[], int k, int dist) {
    int cnt = 1;
    int last = a[0];

    for (int i = 1; i < n; i++) {
        if (a[i] - last >= dist) {
            cnt++;
            last = a[i];
        }
    }

    return cnt >= k;
}

int solve(int n, int a[], int k) {
    std::sort(a, a + n);

    int l = 0;
    int r = a[n - 1] - a[0];

    while (l < r) {
        int mid = (l + r + 1) / 2;
        if (check(n, a, k, mid))
            l = mid;
        else
            r = mid - 1;
    }

    return l;
}

int main() {
    int a[] = {1, 2, 8, 4, 9};
    int n = 5;
    int k = 3;

    std::cout << solve(n, a, k) << std::endl;

    return 0;
}
A
2
B
3
C
4
D
5
答案与解析
正确答案:B
程序包含两个函数:check 和 solve。check 函数接收数组 a、其长度 n、整数 k 和 dist,判断在排序后的数组中能否选出至少 k 个元素,使得相邻被选元素之间的差值不小于 dist。通过贪心策略遍历数组,统计满足条件的元素个数 cnt,并与 k 比较返回布尔结果。solve 函数先对数组排序,然后使用二分查找确定最大化的最小距离。左边界 l 初始化为 0,右边界 r 初始化为最大值与最小值之差。在 while 循环中,取 mid 为当前尝试的距离,根据 check 结果调整边界:若满足则增大下界,否则减小上界。最终逼近最优解。主函数调用 solve 并输出结果。
8
单选题
适中
下面程序的时间复杂度是( ),假设数组 的值域范围是 。
#include <iostream>
#include <algorithm>

bool check(int n, int a[], int k, int dist) {
    int cnt = 1;
    int last = a[0];

    for (int i = 1; i < n; i++) {
        if (a[i] - last >= dist) {
            cnt++;
            last = a[i];
        }
    }

    return cnt >= k;
}

int solve(int n, int a[], int k) {
    std::sort(a, a + n);

    int l = 0;
    int r = a[n - 1] - a[0];

    while (l < r) {
        int mid = (l + r + 1) / 2;
        if (check(n, a, k, mid))
            l = mid;
        else
            r = mid - 1;
    }

    return l;
}

int main() {
    int a[] = {1, 2, 8, 4, 9};
    int n = 5;
    int k = 3;

    std::cout << solve(n, a, k) << std::endl;

    return 0;
}
A
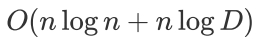
B
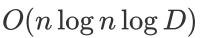
C
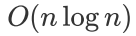
D
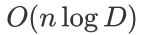
答案与解析
正确答案:A
这道题暂未补解析。
9
单选题
适中
某二叉树共有 10 个结点,记为 A~J,已知它的先序遍历序列为:A B D H I E C F J G,中序遍历序列为:H D I B E A F J C G,则该二叉树的后序遍历序列是( )。
A
H I D E B J F G C A
B
H I D B E J F G C A
C
I H D E B J F G C A
D
H I D E B F J G C A
答案与解析
正确答案:A
根据先序遍历序列确定根节点,结合中序遍历序列划分左右子树。先序序列首元素为当前子树根节点,在中序序列中定位该节点,其左侧为左子树中序序列,右侧为右子树中序序列。通过左右子树结点数量反推先序序列中对应子树的范围。递归构建左右子树结构,直至所有子树均分解至空或单个结点。后序遍历顺序为左子树、右子树、根节点,依据重建的树结构按此顺序收集结点即可得到后序序列。
10
单选题
适中
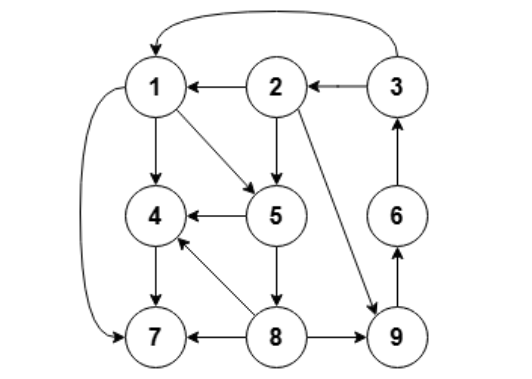
下面哪一个可能是下图的深度优先遍历序列( )。
A
1, 5, 4, 8, 7, 9, 6, 3, 2
B
1, 5, 8, 4, 7, 9, 6, 3, 2
C
2, 5, 8, 7, 9, 6, 3, 4, 1
D
8, 9, 6, 3, 2, 5, 1, 4, 7
答案与解析
正确答案:B
这道题暂未补解析。
11
单选题
适中
关于泛洪算法(Flood Fill)的说法,正确的是( )。
A
泛洪算法只适用于二维网格中的四连通或八连通问题。
B
泛洪算法必须使用递归方式实现。
C
泛洪算法本质上是对图进行一次从起点出发的搜索
D
泛洪算法只能用于统计连通块个数,不能用于计算面积或周长。
答案与解析
正确答案:C
泛洪算法是一种基于图搜索的技术,从指定起点出发,遍历所有可达节点,常用于标记或修改连通区域。该算法不限于二维网格,可应用于任意图结构;实现方式包括递归和非递归(如使用栈或队列),无强制要求;其应用不仅限于统计连通块个数,还可用于计算面积、周长等属性。连通性判断取决于访问机制而非维度或方向限制。算法核心为节点访问与扩展,不依赖特定数据结构或实现形式。
12
单选题
适中
有 6 个字符,它们出现的次数分别为: {2, 3, 3, 4, 6, 8} ,现在用哈夫曼编码为这些字符编码,最小加权路径长度 WPL(每个字符的出现次数 它的编码长度,再把每个字符结果加起来)的值为( )。
A
58
B
60
C
62
D
64
答案与解析
正确答案:D
将给定的字符频次按从小到大排列,构建哈夫曼树:每次选取频次最小的两个节点合并为新节点,新节点的权值为两者之和,重复此过程直至只剩一个根节点。合并过程中,每个字符的编码长度等于其在树中的深度。计算最小加权路径长度WPL时,将每个字符的频次乘以其对应编码长度(即合并时参与的层数),累加所有结果。整个过程基于贪心策略,确保频次小的字符路径更长,频次大的字符路径更短,从而使得总加权路径长度最小。
13
单选题
适中
关于单链表、双链表和循环链表,下列说法正确的是( )。
A
在单链表中,若已知某结点的指针,则可以在 时间内删除该结点。
B
循环链表中一定不存在空指针
C
在循环双链表中,尾结点的 next 指针一定为 NULL。
D
在带头结点的循环单链表中,判定链表是否为空只需判断头结点的 next 是否指向自身
答案与解析
正确答案:D
这道题暂未补解析。
14
单选题
适中
下列关于树的遍历的说法中,正确的一项是( )。
A
对任意一棵树进行深度优先遍历,所得序列一定唯一。
B
已知一棵二叉树的先序遍历和后序遍历序列,可以唯一确定这棵二叉树
C
已知一棵二叉树的先序遍历和中序遍历序列,可以唯一确定这棵二叉树。
D
一棵二叉树的中序遍历序列是单调递增的,则该二叉树一定是二叉平衡树。
答案与解析
正确答案:C
深度优先遍历的序列唯一性取决于访问子节点的顺序是否固定。先序与后序遍历组合无法唯一确定二叉树结构,因缺乏根节点在序列中的明确分割位置。先序与中序遍历可唯一确定二叉树,先序提供根节点信息,中序区分左右子树范围。中序遍历单调递增仅说明节点值在中序下有序,不保证树形结构满足平衡条件。遍历序列的重建能力依赖于能否划分左右子树区间并定位根节点。
16
判断题
适中
C++ 语言中,表达式 4 ^ 2 的结果类型为 int ,值为 6 。
A
正确
B
错误
答案与解析
正确答案:对
分析表达式中运算符的语义:'^' 在 C++ 中为按位异或运算符,非数学幂运算;确定操作数类型:4 和 2 均为整型字面量,默认类型为 int;根据 C++ 类型规则,两个 int 操作数进行按位异或运算,结果类型仍为 int;按位异或运算的执行基于二进制位逐位计算,参与运算的两个整数转换为二进制形式后,相同位值为 0,不同位值为 1,最终合成结果整数。
17
判断题
适中
C++ 中引用可以重新绑定。
A
正确
B
错误
答案与解析
正确答案:错
引用在C++中是别名机制,绑定到初始化时指定的对象后无法更改。引用必须在定义时初始化,且不能重新指向其他对象。重新绑定意味着解除当前绑定并关联新对象,这与引用的底层实现机制冲突。指针可通过赋值改变所指向地址,但引用不具备此操作。语言标准规定引用一经绑定即固定,无语法支持重新绑定。任何试图修改引用的行为实际是对所绑定对象的操作。
18
判断题
适中
在 C++ 中,若函数形参为引用类型,则在函数内部对该形参的修改会影响对应的实参。
A
正确
B
错误
答案与解析
正确答案:对
在C++中,当函数形参为引用类型时,该形参成为实参的别名,二者绑定至同一内存地址。引用本身不分配独立存储空间,所有对形参的操作直接作用于原对象。函数调用时,实参被用来初始化引用形参,建立绑定关系。一旦绑定完成,对引用形参的读取或修改均等效于对实参本身的读取或修改。此机制由编译器保障,无需运行时额外解引用操作。引用形参的存在使得函数能够访问并改变外部对象的状态,其行为由语言标准明确规定,与指针不同,引用一经初始化不可重新绑定。
19
判断题
适中
如果一个最值问题可以用动态规划在多项式时间内求解,那么也一定存在一种贪心策略,可以在多项式时间 内求得最优解。
A
正确
B
错误
答案与解析
正确答案:错
动态规划适用于具有最优子结构和重叠子问题的问题,通过自底向上求解所有子问题保证全局最优。贪心算法基于贪心选择性质,在每一步选择局部最优,期望达到全局最优,其正确性依赖于问题是否满足贪心选择性和最优子结构。两个算法的适用条件不同:动态规划能解决的问题不一定满足贪心选择性质,因此无法保证存在贪心策略得到最优解。判断时需分析两类算法对问题结构性质的要求差异,不能由动态规划可解推出贪心策略必然存在。