GESP-C++六级 题库
划分字符串


#include <algorithm>
#include <cstdio>
#include <vector>
using namespace std;

const int N = 100005;
int n;
char s[N];
int a[N];
long long f[N];

int main() {
    scanf("%d", &n);
    scanf("%s", s + 1);  // 字符串下标从1开始
    for (int i = 1; i <= n; ++i) {
        scanf("%d", &a[i]);
    }

    // DP:f[i] = 前i个字符分割后的最大收益
    for (int i = 1; i <= n; ++i) {
        int mask = 0; // 位掩码,记录当前分段出现过的字符
        // j向左枚举分段起点,区间 [j, i]
        for (int j = i; j >= 1; --j) {
            int cur_bit = 1 << (s[j] - 'a');
            // 当前字符已在分段内,无法继续向左拓展
            if (mask & cur_bit) break;
            mask |= cur_bit;
            // 分段长度 len = i - j + 1
            int seg_len = i - j + 1;
            f[i] = max(f[i], f[j - 1] + a[seg_len]);
        }
    }

    printf("%lld\n", f[n]);
    return 0;
}货物运输


#include <algorithm>
#include <cstdio>
#include <vector>
using namespace std;

const int N = 100005;
int n;
vector<vector<pair<int, int>>> e;
long long total_sum, max_dist;

// u当前节点 fa父节点 d从起点1走到u的距离
void dfs(int u, int fa, long long d) {
    max_dist = max(d, max_dist);
    for (auto edge : e[u]) {
        int v = edge.first;
        int w = edge.second;
        if (v != fa) {
            dfs(v, u, d + w);
        }
    }
}

int main() {
    scanf("%d", &n);
    e.resize(n + 1);
    for (int i = 1; i < n; ++i) {
        int u, v, w;
        scanf("%d%d%d", &u, &v, &w);
        e[u].emplace_back(v, w);
        e[v].emplace_back(u, w);
        total_sum += w;
    }
    dfs(1, 0, 0);
    // 总往返路程 - 最长单条路径(不用折返)
    long long ans = total_sum * 2 - max_dist;
    printf("%lld\n", ans);
    return 0;
}学习小组
时间限制:1 s,内存限制:512 MB
【问题描述】
班主任计划将班级里的 n 名同学划分为若干个学习小组,每名同学都需要分入某一个学习小组中。观察发现,如果一个学习小组中恰好包含 k 名同学,则该学习小组的讨论积极度为 ak。
给定讨论积极度 a1、a2、……、an,请你计算将这 n 名同学划分为学习小组的所有可能方案中,讨论积极度之和的最大值。
【输入描述】
第一行,一个正整数 n,表示班级人数。
第二行,n 个非负整数 a1、a2、……、an,表示不同人数学习小组的讨论积极度。
【输出描述】
输出共一行,一个整数,表示所有划分方案中,学习小组讨论积极度之和的最大值。
【样例输入1】
【样例输出1】
【样例输入2】
【样例输出2】
【数据范围】
对于40%测试点,保证 1 <= n <= 10。
对于所有测试点,保证 1 <= n <= 1000,0 <= ai <= 10000。
#include <iostream>
using namespace std;
const int N = 1005;
int n, a[N];
int main() {
cin >> n;
    for (int i = 1; i <= n; i++) {
     cin >> a[i];
        for (int j = 1; j < i; j++)
            a[i] = max(a[i], a[j] + a[i - j]);
    }
    cout << a[n] << endl;
    return 0;
}环线
时间限制:1 s,内存限制:512 MB
【问题描述】
小 A 喜欢坐地铁。地铁环线有 n 个车站,依次以 1、2、……、n标号。车站 i(1<=i<n )的下一个车站是车站 i+1。
特殊地,车站 n 的下一个车站是车站 1。
小 A 会从某个车站出发,乘坐地铁环线到某个车站结束行程,这意味着小 A 至少会经过一个车站。小 A 不会经过一个车站多次。
当小 A 乘坐地铁环线经过车站 i 时,小 A 会获得 ai 点快乐值。请你安排小 A 的行程,选择出发车站与结束车站,使得获得的快乐值总和最大。
【输入描述】
第一行,一个正整数 n,表示车站的数量。
第二行, n 个整数 a1、a2、……、an,分别表示经过每个车站时获得的快乐值。
【输出描述】
一行,一个整数,表示小 A 能获得的最大快乐值。
【样例输入1】
【样例输出1】
【样例输入2】
【样例输出2】
【数据范围】
对于 20% 的测试点,保证 1<=n<=200。
对于 40% 的测试点,保证 1<=n<=2000。
对于所有测试点,保证 1<=n<=200000, -10^9<=ai<=10^9。
正确答案: 暂无(答题 0次,答对 0次,正确率:0%)
#include <cstdio>
#include <algorithm>
using namespace std;
const int N = 4e5 + 5;
int n;
long long a[N], pre[N];
int q[N], ql, qr;
long long ans;
int main() {
    scanf("%d", &n);
    for (int i = 1; i <= n; i++) {
        scanf("%lld", &a[i]);
        a[n + i] = a[i];
    }
    for (int i = 1; i <= 2 * n; i++)
        pre[i] = pre[i - 1] + a[i];
    ql = qr = 1;
    ans = -1e18;
    for (int i = 1; i <= 2 * n; i++) {
        while (ql <= qr && q[ql] < i - n)
            ql++;
        ans = max(ans, pre[i] - pre[q[ql]]);
        while (ql <= qr && pre[i] < pre[q[qr]])
            qr--;
        q[++qr] = i;
    }
    printf("%lld\n", ans);
    return 0;
}运送物资
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨管理着 m 辆货车,每辆货车每天需要向 A 市和 B 市运送若干次物资。小杨同时拥有 n 个运输站点,这些站点位于 A 市和 B 市之间。
每次运送物资时,货车从初始运输站点出发,前往 A 市或 B 市,之后返回初始运输站点。A 市、B 市和运输站点的位置可以视作数轴上的三个点,其中 A 市的坐标为 0,B 市的坐标为 x ,运输站点的坐标为 p 且有 0<p<x,货车每次去 A 市运送物资的总行驶路程为 2p,去 B 市运送物资的总行驶路程为 2(x−p)。
对于第 i 个运输站点,其位置为 pi且至多作为 ci辆车的初始运输站点。小杨想知道,在最优分配每辆货车的初始运输站点的情况下,所有货车每天的最短总行驶路程是多少。
输入格式
第一行包含三个正整数 n,m,x,代表运输站点数量,货车数量和两市距离。
之后 n 行,每行包含两个正整数 pi,ci,代表第 i 个运输站点的位置和最多容纳车辆数。
之后 m 行,每行包含两个正整数 ai,bi,代表第 i 辆货车每天需要向 A 市运送 ai次物资,向 B 市运送 bi次物资。
输出格式
输出一个正整数,代表所有货车每天的最短总行驶路程。
输入样例
输出样例
样例解释
第 1 辆车的初始运输站点为站点 3,第 2 辆车的初始运输站点为站点 2。第 3 辆车的初始运输站点为站点 1,第 4 辆车的初始运输站点为站点 3。此时总行驶路程最短,为 40186。
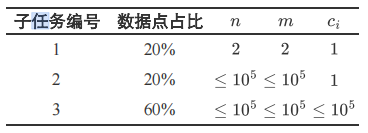
对于全部数据,保证有 1≤n,m≤105,2≤x≤108,0<pi<x,1≤ci≤105,0≤ai,bi≤105。数据保证∑ci≥m。
#include<bits/stdc++.h>
using namespace std;
#define ll long long
const int N = 1e5+10;
int n,m;
ll x;
vector<pair<int,int> > st;
int a[N],b[N];
int main(){
	cin>>n>>m>>x;
	for(int i=1;i<=n;i++){
		int p,c;
		cin>>p>>c;
		st.push_back(make_pair(p,c));
	}
	sort(st.begin(),st.end());
	for(int i=1;i<=m;i++){
		cin>>a[i]>>b[i];
	}
	vector<pair<int,int> > neg,pos;
	ll res=0;
	for(int i=1;i<=m;i++){
		if(a[i]>=b[i])
			pos.push_back(make_pair(a[i]-b[i],i));
		else{
			neg.push_back(make_pair(a[i]-b[i],i));
		}
		res+=1ll*b[i]*x;
	}
	sort(neg.begin(),neg.end());
	sort(pos.begin(),pos.end());
	reverse(pos.begin(),pos.end());
	int l=0,r=n-1;
	for(auto i:neg){
		while(r>=1&&st[r].second==0)r--;
		res+=1ll*(a[i.second]-b[i.second])*st[r].first;
		st[r].second-=1;
	}
	for(auto i:pos){
		while(l<=n&&st[l].second==0)l++;
		res+=1ll*(a[i.second]-b[i.second])*st[l].first;
		st[l].second-=1;
	}
	cout<<res*2<<"\n";
}小杨和整数拆分
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨有一个正整数n,小杨想将它拆分成若干完全平方数的和,同时小杨希望拆分的数量越少越好。
小杨请你编写程序计算出总和为n 的完全平方数的最少数量。
输入格式
第一行包含一个正整数n,含义如题面所示。
输出格式
输出一个整数,代表总和为n 的完全平方数的最少数量。
输入样例
输出样例
18=9+9=16+1+1,其中最少需要2 个完全平方数。
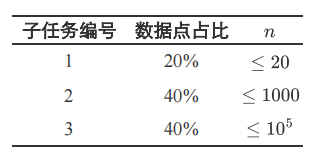
对于全部数据,保证有1≤n≤105。
#include<bits/stdc++.h>
using namespace std;
const int N = 1e5+10;
int n;
int dp[N];
int main(){
	cin>>n;
	for(int i=1;i<=n;i++){
		dp[i]=i;
		for(int j=1;j<=sqrt(i);j++){
			dp[i] =min(dp[i-j*j]+1,dp[i]);
		}
	}
	cout<<dp[n]<<"\n";
}
题目大意:给定一个正整数n,将其拆分成若干个完全平方数的和,要求拆分的数量越少越好。求最少需要多少个完全平方数才能构成n。
用DP进行求解
状态定义
设dp[i]表示构成整数i的最少完全平方数的数量。
状态转移方程
考虑如何通过已知的dp[j](其中j < i)来推导出dp[i]。
对于任意一个整数i,我们可以考虑将它拆分成一个完全平方数j2加上剩余部分i - j2 的和。因此,
dp[i]可以通过dp[i - j2] 来推导出来,即:
dp[i] =min 1≤ k ≤ i (dp[ i−j 2 ]+1)
解释:
dp[i - j2] 表示剩余部分 i - j2 的最少完全平方数数量。+ 1 表示当前添加了一个完全平方数 j2。
我们需要取所有可能的 j 的最小值,以确保 dp[i] 最小。
算法学习
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨计划学习 m 种算法,为此他找了 n 道题目来帮助自己学习,每道题目至多学习一次。
小杨对于 m 种算法的初始掌握程度均为 0 。第 i 道题目有对应的知识点ai,即学习第 i 道题目可以令小杨对第ai种算法的掌握程度提高bi。小杨的学习目标是对 m 种算法的掌握程度均至少为 k 。
小杨认为连续学习两道相同知识点的题目是不好的,小杨想请你编写程序帮他计算出他最少需要学习多少道题目才能使得他在完成学习目标的同时避免连续学习两道相同知识点的题目。
输入格式
第一行三个正整数m,n,k,代表算法种类数,题目数和目标掌握程度。
第二行n个正整数a1,a2,a3,...,an,代表每道题目的知识点。
第二行n个正整数b1,b2,b3,...,bn,代表每道题目提升的掌握程度。
输出格式
输出一个整数,代表小杨最少需要学习题目的数量,如果不存在满足条件的方案,输出 -1。
输入样例1
输出样例1
输入样例2
输出样例2
对于样例1,一种最优学习顺序为第一道题,第三道题,第四道题,第二道题。
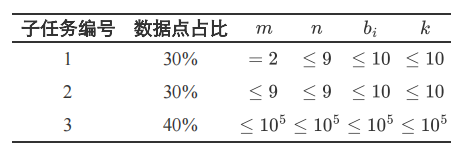
对于全部数据,保证有1≤m,n≤105,1≤bi,k≤105,1≤ai≤m。
#include <bits/stdc++.h>
using namespace std;
const int N = 1e5 + 5;
const int inf = 0x3f3f3f3f;
int f[N];
vector<int> score[N + 2], a, b;
bool cmp(int i, int j) {
	return i > j;
}
int main() {
	int n, m, k;
	cin >> m >> n >> k;
	a.resize(n), b.resize(n);
	for (int i = 0; i < n; i ++)
		cin >> a[i];
	for (int i = 0; i < n; i ++) {
		cin >> b[i];
		score[a[i]].emplace_back(b[i]);
	}

	vector<int> need(m + 2);
	int ans = 0, mx_meed = 0, mx_need_i = -1;
	for (int i = 1; i <= m; i ++) {
		sort(score[i].begin(), score[i].end(), cmp);
		int sum = 0;
		for (int j = 0; j < (int) score[i].size(); j ++) {
			sum += score[i][j];
			if (sum >= k) {
				need[i] = j + 1; break ;
			}
		}
		if (sum < k) {
			puts("-1"); return 0;
		}
		ans += need[i];
		if (need[i] > mx_meed)
			mx_meed = need[i], mx_need_i = i;
	}
	if (mx_meed - 1 <= ans - mx_meed) {
		cout << ans << endl;
		return 0;
	}

	int last = 0;
	for (int i = 1; i <= m; i ++)
		if (i != mx_need_i)
			last += score[i].size() - need[i];

	cout << (mx_meed - 1 <= ans - mx_meed + last ? 2 * mx_meed - 1 : -1) << endl;
	return 0;
}
1.数据准备
读入数据,并将每道题目按知识点分类,记录每种算法通过题目提升掌握程度的列表score。
2.计算每种算法所需的题目数量
对于每种算法,我们需要计算达到目标掌握程度k所需的题目数量。为了最大化利用高分题目,我们需要按分数降序排序。
3.确定最少题目数量
我们需要找到一种安排,使得小杨学习的题目数量最少,并且避免连续学习相同知识点的题目。为此,我们找出需要题目最多的算法,并尝试调整学习顺序。
4.调整学习顺序
如果最多需要的题目数量mx_need减去1之后仍然不超过总需要的题目数量减去mx_need,那么可以通过调整顺序来满足要求;否则,输出-1。
计算得分
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨想要计算由m个小写字母组成的字符串的得分。
小杨设置了一个包含n个正整数的计分序列A=[a1,a2,...,an],如果字符串的一个子串由k(1≤k≤n) 个 abc 首尾相接组成,那么能够得到分数ak,并且字符串包含的字符不能够重复计算得分,整个字符串的得分是计分子串的总和。
例如,假设a=3,字符串 dabcabcabcabzabc 的所有可能计分方式如下:d+abc+abcabc+abz+abc 或者 d+abcabc+abc+abz+abc,其中 d 和 abz 不计算得分,总得分为a1+a2+a1d+abc+abc+abc+abz+abc,总得分为a1+a1+a1+a1d+abcabcabc+abz+abc,总得分为a3+a1
小杨想知道对于给定的字符串,最大总得分是多少。
输入格式
第一行包含一个正整数n,代表计分序列 A 的长度。
第二行包含 n 个正整数,代表计分序列A。
第三行包含一个正整数m,代表字符串的长度。
第四行包含一个由 m 个小写字母组成的字符串。
输出格式
输出一个整数,代表给定字符串的最大总得分。
输入样例
输出样例
样例解释
最优的计分方式为 d+abc+abc+abc+abz,总得分为a1+a1+a1,共9 分。
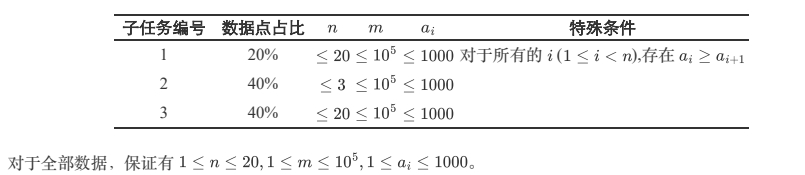
数据范围
#include<bits/stdc++.h>
using namespace std;
const int N = 1e5+10;
int a[30];
string s;
int dp[N];
int main(){
	int n;
	cin>>n;
	for(int i=1;i<=n;i++){
		cin>>a[i];
	}
	int m;
	cin>>m;
	cin>>s;
	for(int i=1;i<=m;i++){
		dp[i]=dp[i-1];
		for(int j=1;j<=n;j++){
			if(i-3*j+1<=0)break;
			int l = i-3*j+1;
			if(s.substr(l-1,3)=="abc"){
				dp[i]=max(dp[i],dp[l]+a[j]);
			}else break;
		}
	}
	cout<<dp[m]<<"\n";
}
20分思路,考虑到ai>=ai+1,此时将abc单独算是最多的,答案为A[1]*abc的个数。
满分思路
状态表示:DP[i]表示前i个字符组成的最大得分。
状态转移方程:
对第i个字符,有两种情况:①不作为答案的一部分。②作为abc的一部分对答案产生贡献;
对于①:DP[i]=DP[i-1] (也可以理解为将i-1的答案顺延到i),这保证了答案为DP[m]
对于②:前i个字符中,最后一个位置作为“abc”,可以考虑用连续的j个abc连接更新答案;
此时i-3*j+1 ~i的范围都为连续的j个abc,产生的代价为A[j]
DP[i]=DP[i-3*j]+A[j]
①和②构成了答案的所有解
有:DP[i]=max(DP[i-1],max(DP[i-3j]+A[j]); i-3j+1>=1
游戏
题面描述
你有四个正整数n,a,b,c,并准备用它们玩一个简单的小游戏。
在一轮游戏操作中,你可以选择将n减去a,或是将n减去b。游戏将会进行多轮操作,直到当n≤c时游戏结束。
你想知道游戏结束时有多少种不同的游戏操作序列。两种游戏操作序列不同,当且仅当游戏操作轮数不同,或是某一轮游戏操作中,一种操作序列选择将n减去a,而另一种操作序列选择将n减去b。如果a=b,也认为将n减去a与将n减去b是不同的操作。
由于答案可能很大,你只需要求出答案对1000000007取模的结果。
输入格式
一行四个正整数n,a,b,c。保证1≤a,b,c≤n。
输出格式
一行一个整数,表示不同的游戏操作序列数量对1000000007取模的结果。
样例输入1
样例输出1
样例输入2
样例输出2
样例输入3
样例输出3
数据范围
对于20的测试点,保证a=b=c=1,n≤30。
对于40的测试点,保证c=1,n≤103。
对于所有测试点,保证1≤n≤2×10⁵。
#include <cstdio>
using namespace std;
const int N = 2e5 + 5;
const int mod = 1e9 + 7;
int n, a, b, c;
int f[N << 1];
int ans;
int main()
{
	scanf("%d%d%d%d", &n, &a, &b, &c);
	f[N + n] = 1;
	for (int i = n; i > c; i--)
	{
		f[N + i - a] = (f[N + i - a] + f[N + i]) % mod;
		f[N + i - b] = (f[N + i - b] + f[N + i]) % mod;
	}
	for (int i = 0; i <= N + c; i++)
		ans = (ans + f[i]) % mod;
	printf("%d\n", ans);
	return 0;
}好斗的牛
问题描述
你有109个牛棚,从左到右一字排开。你希望把N头牛安置到牛棚里。麻烦的是,你的牛很好斗,如果他们附近有其他的牛,他们就会不安分地去挑事。其中,第i头牛的攻击范围是(ai,bi),这意味着,如果他的左边ai个牛棚或右边bi个牛棚里有其他牛,他就会去挑事。
你想留下连续的一段牛棚,并把其他牛棚都卖掉。请问你最少需要留下多少牛棚,才能保证至少存在一种方案能够把所有的N头牛都安置进剩余的牛棚里,且没有牛会挑事?
输入描述
第一行 1 个正整数N。
接下来一行N个用空格隔开的正整数a1,...,aN。
接下来一行 个用空格隔开的正整数b1,...,bN。
输出描述
输出一行一个整数,表示你最少需要留下多少牛棚。
特别提醒
在常规程序中,输入、输出时提供提示是好习惯。但在本场考试中,由于系统限定,请不要在输入、输出中附带任何提示信息。
样例输入 1
样例输出 1
样例解释 1
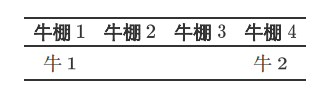
你可以留下 个牛棚,并如此安排你的牛:
样例输入 2
样例输出 2
数据规模
对于20的测试点,保证N=2;
对于另外20的测试点,保证N=3;
对于80的测试点,保证N≤8;
对于所有测试点,保证N≤9,ai,bi≤1000。
#include <iostream>
#include <vector>
#include <algorithm>
using namespace std;
int N;
vector<int> a, b;
int ans = 1e9;
int main() {
	cin >> N;
	a.resize(N);
	b.resize(N);
	for (int i = 0; i < N; ++i) {
		cin >> a[i];
	}
	for (int i = 0; i < N; ++i) {
		cin >> b[i];
	}
	vector<int> permutation;
	permutation.resize(N);
	for (int i = 0; i < N; i ++)
		permutation[i] = i;
	do {
		int curr_len = N;
		for (int i = 1; i < N; ++i) {
			curr_len += max(b[permutation[i - 1]], a[permutation[i]]);
		}
		ans = min(ans, curr_len);
	} while(next_permutation(permutation.begin(), permutation.end()));
	cout << ans << endl;
	return 0;
}闯关游戏
时间限制:1.0 s
内存限制:128.0 MB
问题描述
你来到了一个闯关游戏。
这个游戏总共有N关,每关都有M个通道,你需要选择一个通道并通往后续关卡。其中,第i个通道可以让你前进ai关,也就是说,如果你现在在第x关,那么选择第i个通道后,你将直接来到第x+ai关(特别地,如果x+ai≥N,那么你就通关了)。此外,当你顺利离开第s关时,你还将获得bs分。
游戏开始时,你在第0关。请问,你通关时最多能获得多少总分?
输入描述
第一行两个整数N,M,分别表示关卡数量和每关的通道数量。
接下来一行M个用单个空格隔开的整数a0,a1,……,aM-1。保证1≤ai≤N。
接下来一行N个用单个空格隔开的整数b0,b1,……,bN-1。保证|bi|≤105。
输出描述
一行一个整数,表示你通关时最多能够获得的分数。
特别提醒
在常规程序中,输入、输出时提供提示是好习惯。但在本场考试中,由于系统限定,请不要在输入、输出中附带任何提示信息。
样例输入 1
样例输出 1
样例解释 1
你可以在第0关选择第1个通道,获得1分并来到第3关;随后再选择第0个通道,获得100分并来到第5关;最后任选一个通道,都可以获得30分并通关。如此,总得分为1+100+30=131。
样例输入 2
样例输出 2
样例解释 2
请注意,一些关卡的得分可能是负数。
数据规模
对于20%的测试点,保证M=1。
对于40%的测试点,保证N≤20;保证M≤2。
对于所有测试点,保证N≤104;保证M≤100。
#include <algorithm>
#include <cmath>
#include <cstdio>
#include <cstdlib>
#include <cstring>
#include <iostream>
#include <map>
#include <string>

using namespace std;
const int N = 10005;
const int M = 105;
const int inf = 0x3f3f3f3f;
int a[M], b[N], f[N];
int main() {
  // freopen("data/1.in", "r", stdin);
  int n, m;
  scanf("%d%d", &n, &m);
  for (int i = 1; i <= m; i++)
    scanf("%d", &a[i]);
  for (int i = 0; i < n; i++)
    scanf("%d", &b[i]);
  memset(f, -0x3f, sizeof(f));
  f[0] = 0;
  for (int i = 1; i < n; i++)
    for (int j = 1; j <= m; j++)
      if (i - a[j] >= 0)
        f[i] = max(f[i], f[i - a[j]] + b[i - a[j]]);
  int ans = -inf;
  for (int i = 0; i < n; i++)
    for (int j = 1; j <= m; j++)
      if (i + a[j] >= n) {
        ans = max(ans, f[i] + b[i]);
        break;
      }
  cout << ans << endl;
  return 0;
}工作沟通
时间限制:1.0 s
内存限制:128.0 MB
问题描述
某公司有N名员工,编号从0至N-1。其中,除了0号员工是老板,其余每名员工都有一个直接领导。我们假设编号为i的员工的直接领导是fi。
该公司有严格的管理制度,每位员工只能受到本人或本人直接领导或间接领导的管理。具体来说,规定员工x可以管理员工y,当且仅当x=y,或f=fy,或x可以管理fy。特别地,0号员工老板只能自我管理,无法由其他任何员工管理。
现在,有一些同事要开展合作,他们希望找到一位同事来主持这场合作,这位同事必须能够管理参与合作的所有同事。如果有多名满足这一条件的员工,他们希望找到编号最大的员工。你能帮帮他们吗?
输入描述
第一行一个整数N,表示员工的数量。
第二行N-1个用空格隔开的正整数,依次为f1,f2…,fN-1。
第三行一个整数Q,表示共有Q场合作需要安排。
接下来Q行,每行描述一场合作:开头是一个整数m(2≤m≤N),表示参与本次合作的员工数量;接着是m个整数,依次表示参与本次合作的员工编号(保证编号合法且不重复)。
保证公司结构合法,即不存在任意一名员工,其本人是自己的直接或间接领导。
输出描述
输出Q行,每行一个整数,依次为每场合作的主持人选。
特别提醒
在常规程序中,输入、输出时提供提示是好习惯。但在本场考试中,由于系统限定,请不要在输入、输出中附带任何提示信息。
样例输入 1
样例输出 1
样例解释 1
对于第一场合作,员工3,4有共同领导2,可以主持合作。
对于第二场合作,员工2本人即可以管理所有参与者。
对于第三场合作,只有0号老板才能管理所有员工。
样例输入 2
样例输出 2
数据规模
对于50%的测试点,保证N≤50。
对于所有测试点,保证3≤N≤300;Q≤100 。
#include <algorithm>
#include <cmath>
#include <cstdio>
#include <cstdlib>
#include <cstring>
#include <iostream>
#include <map>
#include <string>
#include <vector>

using namespace std;
const int N = 305;
int fa[N], dep[N];
bool vis[N];
vector<int> ch[N];
int getdep(int x) { return x == 0 ? 0 : getdep(fa[x]) + 1; }
void dfs(int x) {
  vis[x] = 1;
  for (int y : ch[x])
    dfs(y);
}
bool check(int x, int n, const vector<int> &vec) {
  for (int i = 0; i <= n; i++)
    vis[i] = 0;
  dfs(x);
  for (int y : vec)
    if (!vis[y])
      return 0;
  return 1;
}
int main() {
  // freopen("data/1.in", "r", stdin);
  // freopen("tmp.txt", "w", stdout);
  int n;
  scanf("%d", &n);
  for (int i = 1; i < n; i++) {
    scanf("%d", &fa[i]);
    ch[fa[i]].push_back(i);
  }
  for (int i = 1; i < n; i++)
    dep[i] = getdep(i);
  int q;
  scanf("%d", &q);
  while (q--) {
    int m, mnd = n + 1;
    scanf("%d", &m);
    vector<int> vec(m);
    for (int i = 0; i < m; i++) {
      scanf("%d", &vec[i]);
      mnd = min(mnd, dep[vec[i]]);
    }
    for (int i = n - 1; i >= 0; i--)
      if (dep[i] <= mnd && check(i, n, vec)) {
        printf("%d\n", i);
        break;
      }
  }
  return 0;
}小杨买饮料(2023.9C++六级)
时间限制:1.0 s
内存限制:128.0 MB
问题描述
小杨来到了一家商店,打算购买一些饮料。这家商店总共出售N种饮料,编号从0至N-1,其中编号为i的饮料售价ci元,容量li毫升。
小杨的需求有如下几点:
1. 小杨想要尽可能尝试不同种类的饮料,因此他希望每种饮料至多购买 1 瓶;
2. 小杨很渴,所以他想要购买总容量不低于L的饮料;
3. 小杨勤俭节约,所以在 1 和 2 的前提下,他希望使用尽可能少的费用。
方便起见,你只需要输出最少花费的费用即可。特别地,如果不能满足小杨的要求,则输出 no solution 。
输入描述
第一行两个整数N,L。
接下来N行,依次描述第i=0,1,...,N-1种饮料:每行两个整数ci,li。
输出描述
输出一行一个整数,表示最少需要花费多少钱,才能满足小杨的要求。特别地,如果不能满足要求,则输出 no
solution 。
特别提醒
在常规程序中,输入、输出时提供提示是好习惯。但在本场考试中,由于系统限定,请不要在输入、输出中附带任何提示信息。
样例输入 1
5 100
100 2000
2 50
4 40
5 30
3 20
样例输出 1
9
样例解释 1
小杨可以购买1,2,4号饮料,总计获得50+40+20=110毫升饮料,花费2+4+3=9元。
如果只考虑前两项需求,小杨也可以购买1,2,4号饮料,它们的容量总和为50+30+20=100毫升,恰好可以满足需求。但遗憾的是,这个方案需要花费2+5+3=10元。
样例输入 2
5 141
100 2000
2 50
4 40
5 30
3 20
样例输出 2
100
样例解释 2
1,2,3,4号饮料总计140毫升,如每种饮料至多购买 1 瓶,则恰好无法满足需求,因此只能花费100元购买0号饮料。
样例输入 3
4 141
2 50
4 40
5 30
3 20
样例输出 3
no solution
数据规模
对于40%的测试点,保证N≤20 ;1≤L≤100 ;li≤100。
对于70%的测试点,保证li≤100。
对于所有测试点,保证1≤N≤500 ;1≤L≤2000 ;1≤ci,li≤106。
#include <iostream>
using namespace std;

const int INF = 1000000000;
int cost[2001];
int main() {
	int N = 0, L = 0;
	cin >> N >> L;
	cost[0] = 0;
	for (int i = 1; i <= L; i++)
		cost[i] = INF;
	for (int i = 0; i < N; i++) {
		int c = 0, l = 0;
		cin >> c >> l;
		for (int j = L; j >= 0; j--)
			cost[j] = min(cost[j], cost[max(j - l, 0)] + c);
	}
	if (cost[L] == INF)
		cout << "no solution" << endl;
	else
		cout << cost[L] << endl;
	return 0;
}