GESP-C++六级 题库
以下关于哈夫曼编码的说法,正确的是( )。2025.12-6
设有字符集 {a, b, c, d, e},其出现频率分别为 {5, 8, 12, 15, 20},得到的哈夫曼编码为?( )
哈夫曼编码是一种数据压缩算法。以下关于哈夫曼编码的描述中,【不正确】的是?( )
哈夫曼编码是一种基于字符出现频率的无损数据压缩算法,其核心思想是:
变长编码:频率高的字符用较短的编码,频率低的字符用较长的编码。
前缀编码:任何字符的编码都不是其他字符编码的前缀,确保解码唯一性。
贪心算法:通过合并频率最低的节点构建哈夫曼树。
选项B错误,哈夫曼树的构造规则是:频率越低的字符离根节点越远(路径更长),频率越高的字符离根节点越近(路径更短)。
给定字符集 {A, B, C, D} 的出现频率分别为 {5, 1, 6, 2} ,则正确的哈夫曼编码是?( )
上一题中各字符的哈夫曼编码是( )。
假设字母表 {a,b,c,d,e} 在字符串出现的频率分别为 10%,15%,30%,16%,29%。若使用哈夫曼编码方式对字母进行二进制编码,则字符 abcdef 分别对应的一组哈夫曼编码的长度分别为( )。(2024.9-6)
对 hello world 使用霍夫曼编码(Huffman Coding),最少bit(比特)为( )。
4
32
64
88
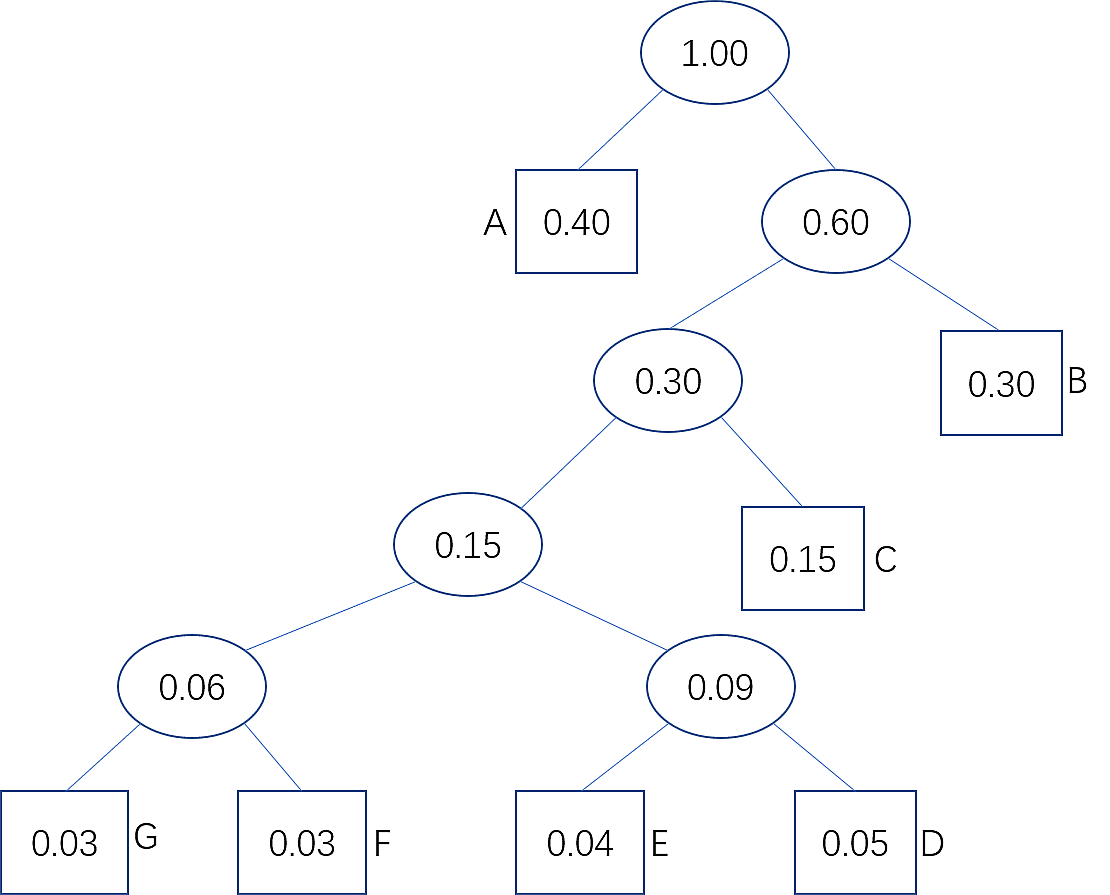
某内容仅会出现 ABCDEFG ,其对应的出现概率为0.40、0.30、0.15、0.05、0.04、0.03、0.03,如下图所示。
按照哈夫曼编码规则,假设 B 的编码为 11 ,则 D 的编码为( )。
10010
10011
10111
10001
哈夫曼编码本质上是一种贪心策略。(2024.9-6)
哈夫曼编码是一种用于无损数据压缩的算法,它通过构建一棵特殊的二叉树——哈夫曼树(Huffman tree)来为字符分配编码。哈夫曼编码的目标是最小化加权路径长度(weighted path length),即编码后的总长度最短。在构建哈弗曼树时,每次选择局部最优解(即频率最小的两个节点进行合并),最终构建出全局最优的哈夫曼树。因此,题目描述是正确的。
哈夫曼编码(Huffman Coding)具有唯一性,因此有确定的压缩率。 ( )(2023年12月C++六级)