GESP-C++六级 题库
设有字符集 {a, b, c, d, e},其出现频率分别为 {5, 8, 12, 15, 20},得到的哈夫曼编码为?( )
给定一个二叉树,返回每一层中最大的节点值,结果以数组形式返回,横线处应填入?( )
哈夫曼编码是一种数据压缩算法。以下关于哈夫曼编码的描述中,【不正确】的是?( )
哈夫曼编码是一种基于字符出现频率的无损数据压缩算法,其核心思想是:
变长编码:频率高的字符用较短的编码,频率低的字符用较长的编码。
前缀编码:任何字符的编码都不是其他字符编码的前缀,确保解码唯一性。
贪心算法:通过合并频率最低的节点构建哈夫曼树。
选项B错误,哈夫曼树的构造规则是:频率越低的字符离根节点越远(路径更长),频率越高的字符离根节点越近(路径更短)。
以下代码实现了树的哪种遍历方式?( )
树的遍历主要方式:
前序遍历:访问顺序:根节点 → 左子树 → 右子树。
中序遍历:访问顺序:左子树 → 根节点 → 右子树。
后序遍历:访问顺序:左子树 → 右子树 → 根节点。
这段代码实现了树的 前序遍历(根→左→右)。
以下关于完全二叉树的代码描述,正确的是?( )
使用队列 q 进行层序遍历,hasNull 标记是否遇到过空节点(初始为 false)。
遍历过程:
每次从队列中取出一个节点 node。
如果 node 是 nullptr:设置 hasNull = true。
如果 node 非空:若之前已遇到空节点(hasNull == true),则直接返回 false(违反完全二叉树的定义)。
否则,将 node 的左右子节点(无论是否为空)加入队列。
代码实现了 完全二叉树的判断逻辑。
以下代码实现了二叉排序树的哪种操作?( )
程序中:
if (root == nullptr) return new TreeNode(val)
若目标值不存在,则在叶子节点位置创建新节点。
若目标值更小,递归查找左子树;若目标值更大,递归查找右子树。
这段代码通过递归查找插入位置并动态创建新节点,实现了 二叉排序树的插入操作。
给定字符集 {A, B, C, D} 的出现频率分别为 {5, 1, 6, 2} ,则正确的哈夫曼编码是?( )
以下代码实现了二叉树的深度优先搜索(DFS),并统计叶子结点的数量,则横线上应填写?( )
空缺的位置在 while 循环的末尾,当前代码已经处理了右子树的压栈操作,需要补充左子树的处理逻辑。
程序使用栈(stack<TreeNode*>)来实现 DFS,空缺部分应该是一个类似的逻辑:如果 node 有左子节点,则将其压入栈。
本题答案为选项A。
以下代码实现了二叉树的广度优先搜索(BFS),并查找特定值的节点,则横线上应填写?( )
BFS 遍历:使用队列(queue)来实现 BFS。
初始时,将根节点 root 入队。
在 while 循环中,取出队首节点 current:
如果 current->val == target,则返回 current(找到目标节点)。
空缺部分需要将 current 的子节点(左子节点和右子节点)入队。
本题答案为选项A。
N 个节点的双向循环链,在其中查找某个节点的平均时间复杂度是( )。
以下关于树的说法,( )是正确的。
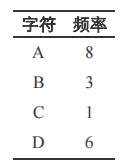
上一题中各字符的哈夫曼编码是( )。
根据下面二叉树和给定的代码,
给定以下二叉搜索树,调用函数 search(root,7) 时,输出的结果是( )。
阅读以下二叉树的深度优先搜索算法,横线上应填写( )。
阅读以下二叉树的广度优先搜索的代码,横线上应填写( )。
使用上题中的宽度优先搜索算法遍历以下这棵树,可能的输出是( )。
假设字母表 {a,b,c,d,e} 在字符串出现的频率分别为 10%,15%,30%,16%,29%。若使用哈夫曼编码方式对字母进行二进制编码,则字符 abcdef 分别对应的一组哈夫曼编码的长度分别为( )。(2024.9-6)
给定一棵二叉树,其前序遍历结果为:ABDECFG,中序遍历结果为:DEBACFG,则这棵树的正确后序遍历结果是( )。(2024.9-6)
在前序遍历中找根,在中序遍历中找根的左右子树,建好树后进行后序遍历。