GESP-Python七级 题库
一棵深度为 6(根节点深度为1)的完全二叉树,节点总数最少有( )。
31
32
63
64
下面程序中,函数 query 的时间复杂度是( )。
O(1)
O(log n)
O(n)
O(n log n)
有5个字符,它们出现的次数分别为2次、2次、3次、3次、5次。现在要用哈夫曼编码的方式来为这些字符进行编码,最小加权路径长度WPL(每个字符的出现次数 它的编码长度,再把每个字符结果加起来)的值为( )。
30
34
43
47
一个简单无向图 G 有36条边,且每个顶点的度数都为4,则图 G 的顶点个数为( )。
9
12
18
36
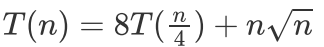 (n为正整数),和T(0)=1,那么这个算法的时间复杂度是( )。


下面哪一个可能是下图的深度优先遍历序列( )。

1, 5, 6, 3, 2, 8, 9, 4, 7
1, 5, 8, 9, 7, 4, 6, 3, 2
3, 2, 1, 4, 7, 6, 9, 5, 8
2, 5, 6, 3, 8, 7, 9, 4, 1

给定一个无向图,图的节点编号从 0 到 n-1,图的边以邻接表的形式给出。编写的一个python程序,使用深度优先搜索(DFS)遍历该图,并输出遍历的节点顺序。
下面程序中横线处应该填写的是()
在无向图中,所有顶点的度数之和等于边数的两倍。
使用邻接矩阵存储一个有 V 个顶点、E 条边的图,对该图进行一次完整的BFS遍历,时间复杂度为 O(V+E)。
在图像处理或游戏开发中,泛洪(flood fill)算法既可以用BFS实现,也可以用DFS实现。
使用链地址法处理冲突的哈希表,当所有元素都映射到同一个槽位时,查找操作的最坏时间复杂度为O(n),其中 n 为元素个数。
一个包含 V 个顶点的连通无向图,其任何一棵生成树都恰好包含 V-1 条边。
学习小组

3.2.3 输出格式
输出一行,一个整数,表示所有划分方案中,学习小组综合讨论积极度之和的最大值。
3.2.4.1 输入样例 1
3.2.4.2 输出样例 1
3.2.4.3 输入样例 2
3.2.4.4 输出样例 2

getint = lambda: map(int, input().split())
getints = lambda: list(getint())

# 同学数量
n = int(input())
# 按照讨论积极程度从小到大排序,方便后面计算转移方程
c = sorted(getints())
# 不同分组的基础讨论度
a = [0] + getints()
# 用来进行动态规划的数组
# f[j][k]表示在当前已经用掉k个学生,且包含了j个人数不为1的组的情况下的最大积极度
# 我们在这里使用了滚动数组优化,所以没有题解中的i维度
f = [[0] * (n + 1) for _ in range(n + 1)]

# 考虑人数最少的组不少于i个人的情况
for i in range(n, 0, -1):
    # j表示分成了多少个组
    # 一共就n个人,所以组的数量绝对不大于n//i+1
    for j in range(1, n // i + 1):
        # 如果最后一个小组刚刚好有i个人,因为之前的组都有至少i个人,所以新加入的组应该选择第j大和第j小的元素作为极大极小值
        diff = c[n - j] - c[j - 1] if i > 1 else 0
        if diff < 0:
            break
        # 假设我们考虑用掉了k个学生,只需要考虑k>=i的情况即可
        for k in range(i, n + 1):
            # 判断最后一个小组如果刚刚好有i个人能否比
            f[j][k] = max(f[j][k], f[j - 1][k - i] + a[i] + diff)

print(max(f[i][n] for i in range(n + 1)))
图上移动
题目描述
小 A 有一张包含n 个结点与 m条边的无向图,结点以1,2,...,n 标号。小 A 会从图上选择一个结点作为起点,每一步移动到某个与当前小 A 所在结点相邻的结点。对于每个结点 i(1≤i≤n ),小 A 想知道从结点i 出发恰好移动1,2,...,k步之后,小 A 可能位于哪些结点。由于满足条件的结点可能有很多,你只需要求出这些结点的数量。
输入格式
第一行,三个正整数 n,m,k,分别表示无向图的结点数与边数,最多移动的步数。
接下来m 行,每行两个正整数 ui,vi,表示图中的一条连接结点 ui与vi 的无向边。
输出格式
共n 行,第 i行(1≤i≤n )包含 k个整数,第j 个整数(1≤j≤k )表示从结点 i出发恰好移动j 步之后可能位于的结点数量。
输入样例
输出样例
数据范围
对于20 % 的测试点,保证k=1 。
对于另外20 % 的测试点,保证 1≤n≤50,1≤m≤50 。
对于所有测试点,保证 1≤n≤500,1≤m≤500 ,1≤k≤20 ,1≤ui,vi≤n。
n, m, k = map(int, input().split())
to = [[] for i in range(n + 2)]
for i in range(m):
	x, y = map(int, input().split())
	to[x].append(y)
	to[y].append(x)

f = [[[False] * (n + 2) for _ in range(n + 2)] for __ in range(k + 2)]

for i in range(1, n + 1):
	f[0][i][i] = True

for t in range(1, k + 1):
	for x in range(1, n + 1):
		for y in range(1, n + 1):
			if f[t - 1][x][y]:
				for z in to[y]:
					f[t][x][z] = True

for i in range(1, n + 1):
	Ans = []
	for t in range(1, k + 1):
		ans = 0
		for j in range(1, n + 1):
			ans += (f[t][i][j] == True)
		Ans.append(str(ans))
print(' '.join(Ans))等价消除
题目描述
小 A 有一个仅包含小写英文字母的字符串 S。
对于一个字符串,如果能通过每次删去其中两个相同字符的方式,将这个字符串变为空串,那么称这个字符串是可以被等价消除的。
小 A 想知道 S有多少子串是可以被等价消除的。
一个字符串 S'是S 的子串,当且仅当删去 S的某个可以为空的前缀和某个可以为空的后缀之后,可以得到 S'。
输入格式
第一行,一个正整数|S| ,表示字符串S 的长度。
第二行,一个仅包含小写英文字母的字符串 S。
输出格式
一行,一个整数,表示答案。
输入样例 1
输出样例 1
输入样例 2
输出样例 2
数据范围
对于20 % 的测试点,保证S 中仅包含 a 和 b 两种字符。
对于另外20 % 的测试点,保证 1≤|S|≤2000。
对于所有测试点,保证 1≤|S|≤2*105 。
n = int(input())
s = input()
state, cnt, ans = 0, {}, 0
cnt[0] = 1
for i in range(n):
	c = ord(s[i]) - ord('a')
	state ^= (1 << c)
	if state not in cnt:
		cnt[state] = 0
	ans += cnt[state]
	cnt[state] += 1
print(ans)