GESP-Python六级 题库
共 12 道题
· 按题型筛选,点「查看答案」核对解析
1
单选题
适中
有6 个字符,它们出现的次数分别为:{2 , 3 , 3 , 4 , 6 , 8 },现在用哈夫曼编码为这些字符编码,最小加权路径长度WPL(每个字符的出现次数X它的编码长度,再把每个字符结果加起来)的值为()。
A
58
B
60
C
62
D
64
答案与解析
正确答案:D
将给定的6个字符出现次数作为叶节点权重,构建哈夫曼树。每次选择当前权值最小的两个节点合并为新节点,新节点的权值为两者之和,重复此过程直至只剩一个根节点。每个字符的编码长度等于其在哈夫曼树中的路径长度(从根到该叶节点的边数)。计算每个字符的权值与其路径长度的乘积,再求所有字符的乘积之和,即得最小加权路径长度WPL。
2
单选题
适中
以下关于哈夫曼编码的说法,正确的是( )。
A
哈夫曼编码是定长编码
B
哈夫曼编码中,没有任何一个字符的编码是另一个字符编码的前缀
C
哈夫曼编码一定唯一
D
哈夫曼编码不能用于数据压缩
答案与解析
正确答案:B
哈夫曼编码基于字符出现频率构建二叉树,频率越低的字符位于更深的叶节点。编码通过从根到叶路径生成,左分支标记0,右分支标记1,或反之。每个字符对应唯一路径,路径序列即为其编码。由于编码由叶节点决定,任意编码均无法通过另一条完整路径延伸得到,故一个字符的编码不会是另一个字符编码的前缀。构建过程中,不同合并顺序可能产生不同结构的二叉树,导致编码方案不唯一。编码长度随字符频率动态变化,非固定长度。该机制将高频字符映射为短码,低频字符映射为长码,整体编码长度趋于最小化。
3
单选题
适中
设有字符集 {a, b, c, d, e},其出现频率分别为 {5, 8, 12, 15, 20},得到的哈夫曼编码为( )。
A

B

C

D

答案与解析
正确答案:A
这道题暂未补解析。
4
单选题
适中
哈夫曼编码是一种用于数据压缩的算法。以下关于哈夫曼编码的描述中,不正确的是( )。
A
哈夫曼编码是一种变长编码,频率高的字符使用较短的编码,频率低的字符使用较长的编码。
B
在构造哈夫曼树时,频率越低的字符离根节点越近,频率越高的字符离根节点越远。
C
哈夫曼编码的生成过程基于贪心算法,每次选择频率最低的两个节点进行合并。
D
哈夫曼编码是一种前缀编码,任何一个字符的编码都不会是另一个字符编码的前缀,因此可以实现唯一解码。
答案与解析
正确答案:B
这道题暂未补解析。
5
单选题
适中
给定字符集 {A, B, C, D} 的出现频率分别为 {5, 1, 6, 2} ,则正确的哈夫曼编码是( )。
A
A: 0, B: 100, C: 11, D: 101
B
A: 11, B: 100, C: 0, D: 101
C
A: 0, B: 101, C: 11, D: 100
D
A: 10, B: 101, C: 0, D: 100
答案与解析
正确答案:B
这道题暂未补解析。
6
单选题
适中
假设字母表 {a,b,c,d,e} 在字符串出现的频率分别为 10%,15%,30%,16%,29%。若使用哈夫曼编码方式对字母进行二进制编码,则字符 abcdef 分别对应的一组哈夫曼编码的长度分别为( )。
A
4, 4, 1, 3, 2
B
3, 3, 2, 2, 2
C
3, 3, 1, 2, 1
D
4, 4, 1, 2, 2
答案与解析
正确答案:B
求哈夫曼编码需要先构建哈夫曼树,构建方法:① 从频率表中取出最小的两个元素,构建出新元素,② 将新元加入到频率表中,所以很明显abcdef分别对应的一组哈夫曼编码长度为3 3 2 2 2
7
单选题
适中
对 hello world 使用霍夫曼编码(Huffman Coding),最少 bit(比特)为( )。
A
4
B
32
C
64
D
88
答案与解析
正确答案:B
这道题暂未补解析。
8
单选题
适中
某内容仅会出现ABCDEFG,其对应的出现概率为0.40、0.30、0.15、0.05、0.04、0.03、0.03,如下图所示。
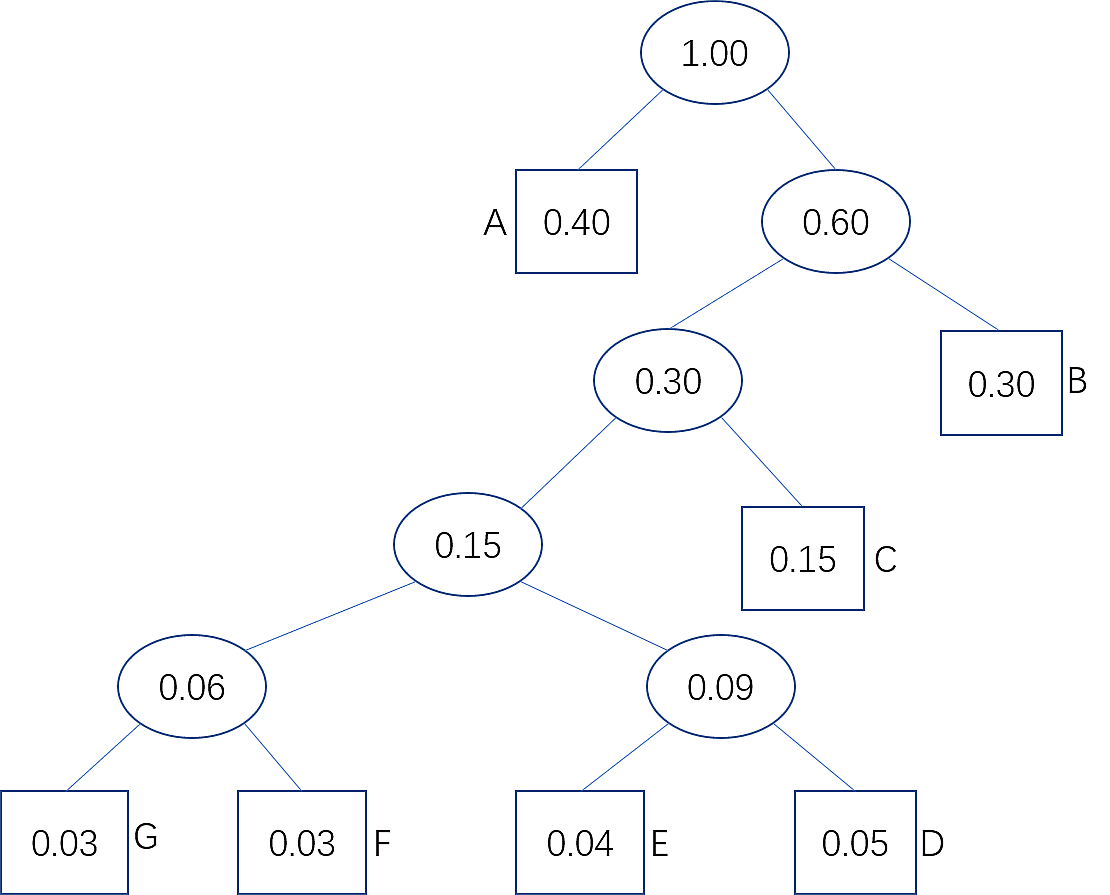
按照哈夫曼编码规则,假设B的编码为11,则D的编码为( B )。
A
10010
B
10011
C
10111
D
10001
答案与解析
正确答案:B
这道题暂未补解析。