GESP-Python六级 题库
选数
# 接受输入
# n
n = int(input())
# 接受a和b的输入
a = [0] + list(map(int, input().split()))
b = [0] + list(map(int, input().split()))
# 准备动态规划的数组f
# f[i]的含义如题解所述
f = [0] * (n + 5)
# ans表示目前找到的最大的答案
ans = 0
for i in range(1, n + 1):
    # 比较一下,如果将i加入到下标序列中,那么可能得到的最大序列和为f[i]+a[i],比较这个值和最大的已发现的答案
    ans = max(ans, f[i] + a[i])
    # f[i+b[i]]表示最后一个被选中的下标<=i的情况下能够找到的最大序列和。如果加入a[i]能够让这个值更大,则更新
    if i + b[i] <= n:
        f[i + b[i]] = max(f[i + b[i]], f[i] + a[i])
    # 因为f[i]表示的是i及i以后的下标都能被选中情况下的最大序列和,所以利用f[i]来更新f[i+1]
    f[i + 1] = max(f[i + 1], f[i])
print(ans)
完全二叉树
n = int(input())
# l[i]:i的左孩子;r[i]:i的右孩子,0为空
l = [0] * (n + 1)
r = [0] * (n + 1)
# mn[u]:u子树中,叶子节点的最小深度
mn = [0] * (n + 1)
# mx[u]:u子树中,叶子节点的最大深度
mx = [0] * (n + 1)
# chk[u]:布尔标记,1代表以u为根的子树是完全二叉树,0不是
chk = [0] * (n + 1)
ans = 0

for i in range(1, n + 1):
    li, ri = map(int, input().split())
    l[i] = li
    r[i] = ri

def dfs(u):
    global ans
    chk[u] = 1
    if u == 0:
        return
    # 后序:先递归左右子树
    dfs(l[u])
    dfs(r[u])

    # 条件1:左右子树本身都必须是完全二叉树
    chk[u] &= chk[l[u]] & chk[r[u]]

    # mn[u]:当前子树叶子最小深度
    mn[u] = 1 + min(mn[l[u]], mn[r[u]])
    # mx[u]:当前子树叶子最大深度
    mx[u] = 1 + max(mx[l[u]], mx[r[u]])

    # 条件2:左子树叶子最小深度 >= 右子树叶子最大深度
    chk[u] &= mn[l[u]] >= mx[r[u]]
    # 条件3:整棵子树叶子最小深度 >= 最大深度 - 1
    chk[u] &= mn[u] >= mx[u] - 1

    # 如果u是完全二叉树,答案+1
    ans += chk[u]

dfs(1)
print(ans)
路径覆盖
时间限制:3.0 s
内存限制:512.0 MB
题目描述
给定一棵有 n 个结点的有根树 T ,结点依次以 1 , 2, . , n 编号 ,根结点编号为 1 。方便起见 ,编号为 i 的结点称为结点 i。
初始时 T 中的结点均为白色。你需要将 T 中的若干个结点染为黑色,使得所有叶子到根的路径上至少有一个黑色结
点。将结点 i 染为黑色需要代价 c,你需要在满足以上条件的情况下,最小化染色代价之和。
叶子是指 T 中没有子结点的结点。
输入格式
第一行,一个正整数 n,表示结点数量。

输出格式
一行,一个整数,表示在满足所有叶子到根的路径上至少有一个黑色结点的前提下,染色代价之和的最小值。
输入样例 1
输出样例 1
输入样例 2
输出样例 2
数据范围

getint = lambda: map(int, input().split())
getints = lambda: list(getint())
# 获取节点数
n = int(input())
# 各个节点的根节点
f = [0, 0] + getints()
# 各个节点涂黑的成本
c = [0] + getints()
# cnt[i]表示节点i有多少子节点
cnt = [0] * (n + 1)
# ans[i]表示以节点i为根节点的子树,需要多少成本才能让所有叶子结点到根节点都有涂黑的节点
ans = [0] * (n + 1)
# 统计一个节点有多少子节点
for i in range(2, n + 1):
	cnt[f[i]] += 1
# 遍历每一个节点,因为一个节点的父节点编号肯定这个节点,所以大编号的一定更深
for i in range(n, 0, -1):
	# 如果一个节点没有子节点,那么显然ans[i]=c[i]就是把自己涂黑
	if cnt[i] == 0:
		ans[i] = c[i]
	# 一个节点当前已经找到的答案等于
	ans[i] = min(ans[i], c[i])
	ans[f[i]] += ans[i]
print(ans[1])
道具商店
题目描述
道具商店里有n件道具可供挑选 。第 i 件道具可为玩家提升 ai 点攻击力 ,需要 ci 枚金币才能购买 ,每件道具只能购买一次 。现在你有k枚金币 ,请问你最多可以提升多少点攻击力?
输入格式
第一行 ,两个正整数 n, k ,表示道具数量以及你所拥有的金币数量。
接下来 n行 ,每行两个正整数 ai , ci ,表⽰道具所提升的攻击力点数, 以及购买所需的金币数量。
输出格式
输出一行,一个整数 ,表示最多可以提升的攻击力点数。
输入样例 1
3 5
99 1
33 2
11 3
输出样例 1
132
输入样例 2
1 4 100
2 10 1
3 20 11
4 40 33
5 100 99
输出样例 2
110
数据范围
对于 60 的测试点,保证 1 ≤ k ≤ 500,1 ≤ ci ≤ 500 。
对于所有测试点,保证 1 ≤ n ≤ 500,1≤ k ≤ 109 ,1≤ ai ≤ 500, 1≤ ci ≤ 109。
getint = lambda: map(int, input().split())
getints = lambda: list(getint())
# 得到物品数量和预算
n, k = getint()
# 这里进行了滚动优化,dp[j]表示攻击力为j的情况下的最小预算
# 最大攻击力为500*500,所以初始化这么大的数组,并且所有值都是1e10表示无穷大预算
f = [0] + [int(1e10)] * 500 * 500
# 能够达到的最大攻击力,用来缩小遍历的范围
s = 0
for i in range(n):
	# 输入当前物品的攻击力和价格
	a, c = getint()
	s += a
	# 计算题解中的转移公式,因为j是从高到低遍历的,f[j-a]和f[j]此时尚未被更新,相当于是f[i-1][j-a]与
f[i-1][j]
	for j in range(s, a - 1, -1):
		f[j] = min(f[j], f[j - a] + c)
# 遍历f[i]得到符合预算条件的最高攻击力
ans = 0
for i in range(s + 1):
	if f[i] <= k:
		ans = i
print(ans)
试题名称:划分字符串
时间限制:3.0 s
内存限制:512.0 MB


n = int(input())  # 字符串长度
s = input().strip()  # 原字符串
# a[k] 代表长度为k的合法无重复字符子串的价值,a[0]占位不用
a = [0] + list(map(int, input().split()))

# DP数组:f[i] 表示字符串前i个字符分割后的最大收益
f = [0] * (n + 1)

for i in range(1, n + 1):
    # 存储当前末尾分段已出现过的字符
    exist_chars = set()
    # j从i向左枚举,最后一段从j到i(下标j-1 ~ i-1)
    for j in range(i, 0, -1):
        c = s[j - 1]
        # 当前字符在末尾分段重复,不能继续往左拓展
        if c in exist_chars:
            break
        exist_chars.add(c)
        # 最后一段长度 len = i - j + 1
        seg_len = i - j + 1
        f[i] = max(f[i], f[j - 1] + a[seg_len])

print(f[n])
试题名称:货物运输
时间限制:1.0 s
内存限制:512.0 MB


# 递归深度扩容,防止长树DFS栈溢出
import sys
sys.setrecursionlimit(int(1.5e5))

n = int(input())  # 树的节点总数
# 邻接表 e[u] 存储 [相连节点, 边权长度]
e = [[] for _ in range(n + 1)]
total_edge_sum = 0  # 所有边的总长度

# 建树,无向树
for _ in range(n - 1):
    u, v, w = map(int, input().split())
    e[u].append([v, w])
    e[v].append([u, w])
    total_edge_sum += w

# DFS:返回起点1到以u为根的子树内最远点距离
# u: 当前节点 fa: 父节点 d: 首都(1)到u的距离
def dfs(u, fa, d):
    max_dist = d  # 初始最远距离为当前节点自身距离d
    for neighbor, weight in e[u]:
        if neighbor != fa:
            # 递归子节点,更新全局最远距离
            sub_max = dfs(neighbor, u, d + weight)
            max_dist = max(max_dist, sub_max)
    return max_dist

# 公式推导:遍历整棵树每条边会走2次,减去最长一条单程路径(不用折返)
longest_path = dfs(1, 0, 0)
ans = total_edge_sum * 2 - longest_path
print(ans)
学习小组


# 首先记录同学总数
n = int(input())
# a[k]:小组恰好k人时的讨论积极度
a = [0] + list(map(int, input().split()))
# dp[k]:k个同学能得到的最大讨论积极度
dp = [0]

# 遍历总人数k
for k in range(1, n + 1):
    dp.append(0)
    # 拆分k人为i人和j人两部分
    for i in range(0, k):
        j = k - i
        # 状态转移:不拆分a[k] / 拆分为两部分dp[i]+dp[j],取最大值
        dp[k] = max(a[k], dp[i] + dp[j], dp[k])

print(dp[n])
最大因数


# 读取询问的组数
n = int(input())

def factorize(x):
    """
    得到x以及其全部祖先节点的编号列表,从大到小排列
    第一个是x,最后一个是根节点1
    :param x: 输入节点的编号
    :return: 路径列表
    """
    f = [x]
    # 寻找质因数分解
    for i in range(2, int(x ** 0.5) + 1):
        while x % i == 0:
            x //= i
            f.append(f[-1] // i)
    # 末尾补上根节点1
    if f[-1] != 1:
        f.append(1)
    return f

# 处理每组查询
for _ in range(n):
    # 读取x、y两个节点
    x, y = map(int, input().split())
    a = factorize(x)
    b = factorize(y)
    p1, p2 = 0, 0
    # 双指针找第一个相同公共节点
    while a[p1] != b[p2]:
        if a[p1] > b[p2]:
            p1 += 1
        else:
            p2 += 1
    # 输出两段路径步数之和
    print(p1 + p2)
树上漫步
题目描述
小 A 有一棵 n个结点的树,这些结点依次以 1,2,...,n标号。
小 A 想在这棵树上漫步。具体来说,小 A 会从树上的某个结点出发,每一步可以移动到与当前结点相邻的结点,并且小 A 只会在偶数步(可以是零步)后结束漫步。
现在小 A 想知道,对于树上的每个结点,从这个结点出发开始漫步,经过偶数步能结束漫步的结点有多少个(可以经过重复的节点)。
输入格式
第一行,一个正整数n 。
接下来n-1 行,每行两个整数ui,vi ,表示树上有一条连接结点ui 和结点vi 的边。
输出格式
一行, n个整数,第 i个整数表示从结点i 出发开始漫步,能结束漫步的结点数量。
输入样例 1
输出样例 1
输入样例 2
输出样例 2
数据范围
对于40 % 的测试点,保证1≤n≤103 。
对于所有测试点,保证1≤n≤2*105 。
n = int(input())
to = [[] for i in range(n + 2)]
for i in range(n - 1):
	x, y = map(int, input().split())
	to[x].append(y)
	to[y].append(x)

cnt = [0, 0]
color = [0 for i in range(n + 2)]
def dfs(x, c, f):
	color[x] = c
	cnt[c] += 1
	for y in to[x]:
		if y != f:
			dfs(y, c ^ 1, x)

dfs(1, 0, 0)
ans = []
for i in range(1, n + 1):
	ans.append(str(cnt[color[i]]))

print(' '.join(ans))环线
题目描述
小 A 喜欢坐地铁。地铁环线有 n个车站,依次以 1,2,...,n标号。车站 i( 1≤i<n)的下一个车站是车站i+1 。
特殊地,车站n 的下一个车站是车站1 。
小 A 会从某个车站出发,乘坐地铁环线到某个车站结束行程,这意味着小 A 至少会经过一个车站。小 A 不会经过一个车站多次。当小 A 乘坐地铁环线经过车站 i时,小 A 会获得 ai点快乐值。请你安排小 A 的行程,选择出发车站与结束车站,使得获得的快乐值总和最大。
输入格式
第一行,一个正整数n ,表示车站的数量。
第二行, n个整数a1,a2,...an, ,分别表示经过每个车站时获得的快乐值。
输出格式
一行,一个整数,表示小 A 能获得的最大快乐值。
输入样例 1
输出样例 1
输入样例 2
输出样例 2
数据范围
对于20% 的测试点,保证1≤n≤200 。
对于40 % 的测试点,保证 1≤n≤2000。
对于所有测试点,保证 1≤n≤2*105,-109≤ai≤109 。
n = int(input())
a = [0] + list(map(int, input().split()))
pre = [0 for i in range(2 * n + 5)]

for i in range(1, n + 1):
	a.append(a[i])

for i in range(1, 2 * n + 1):
	pre[i] = pre[i - 1] + a[i]

ql, qr, ans = 1, 1, -1e18
q = [0 for i in range(2 * n + 5)]

for i in range(1, 2 * n + 1):
	while ql <= qr and q[ql] < i - n:
		ql += 1
	ans = max(ans, pre[i] - pre[q[ql]])
	while ql <= qr and pre[i] < pre[q[qr]]:
		qr -= 1
	qr += 1
	q[qr] = i

print(ans)
树上游走
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨有一棵包含无穷节点的二叉树(即每个节点都有左儿子节点和右儿子节点;除根节点外,每个节点都有父节点),其中根节点的编号为 1 ,对于节点 i ,其左儿子的编号为 2×i,右儿子的编号为 2×i+1。
小杨会从节点 s 开始在二叉树上移动,每次移动为以下三种移动方式的任意一种:
第1种移动方式: 如果当前节点存在父亲节点,向上移动到当前节点的父亲节点,否则不移动;
第2种移动方式: 移动到当前节点的左儿子;
第3种移动方式: 移动到当前节点的右儿子。
小杨想知道移动 n 次后自己所处的节点编号。数据保证最后的所处的节点编号不超过1012。
输入格式
第一行包含一个正整数 n,s,代表移动次数和初始节点编号。
第二行包含一个长度为 n 且仅包含大写字母 U,L,R 的字符串,代表每次移动的方式,其中U 代表第1种移动方式,L 代表第2种移动方式,R 代表第3种移动方式。
输出格式
输出一个正整数,代表最后所处的节点编号。
输入样例
输出样例
样例解释
小杨的移动路线为 2-1-3-7。
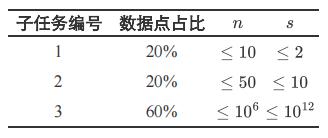
对于全部数据,保证有1≤n≤106,1≤s≤1012。
INF = 1e12
n, s = map(int, input().split())
c = input()
st = []

for i in range(n):
	if c[i] == 'U':
		if s == 1:
			continue
		if st:
			st.pop()
			continue
		s >>= 1
	elif c[i] == 'L':
		if (s << 1) > INF:
			st.append('L')
			continue
		s = s << 1
	else:
		if (s << 1 | 1) > INF:
			st.append('R')
			continue
		s = s << 1 | 1
print(int(s))运送物资
时间限制:2.0 s
内存限制:512.0 MB
题面描述
小杨管理着 m 辆货车,每辆货车每天需要向 A 市和 B 市运送若干次物资。小杨同时拥有 n 个运输站点,这些站点位于 A 市和 B 市之间。
每次运送物资时,货车从初始运输站点出发,前往 A 市或 B 市,之后返回初始运输站点。A 市、B 市和运输站点的位置可以视作数轴上的三个点,其中 A 市的坐标为 ,B 市的坐标为 x ,运输站点的坐标为 p 且有 0<p<x,货车每次去 A 市运送物资的总行驶路程为 2p,去 B 市运送物资的总行驶路程为 2(x−p)。
对于第 i 个运输站点,其位置为 pi 且至多作为 ci 辆车的初始运输站点。小杨想知道,在最优分配每辆货车的初始运输站点的情况下,所有货车每天的最短总行驶路程是多少。
输入格式
第一行包含三个正整数 n,m,x,代表运输站点数量,货车数量和两市距离。
之后 n 行,每行包含两个正整数 pi,ci,代表第 i 个运输站点的位置和最多容纳车辆数。
之后 m 行,每行包含两个正整数 ai,bi,代表第 i 辆货车每天需要向 A 市运送 ai 次物资,向 B 市运送 bi 次物资。
输出格式
输出一个正整数,代表所有货车每天的最短总行驶路程。
输入样例
输出样例
样例解释
第1辆车的初始运输站点为站点 3,第 2 辆车的初始运输站点为站点 2。第 3 辆车的初始运输站点为站点 1,第 4 辆车的初始运输站点为站点 3。此时总行驶路程最短,为 40186。
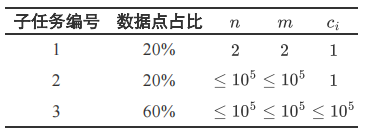
对于全部数据,保证有1≤n,m≤105,2≤x≤108,0<pi<x,1≤ci≤105,0≤ai,bi≤105。数据保证 ∑ci≥m。
n, m, x = map(int, input().split())
st = []
for _ in range(n):
	p, c = map(int, input().split())
	st.append((p, c))

st.sort()

a = [0] * m
b = [0] * m
for i in range(m):
	a[i], b[i] = map(int, input().split())

neg = []
pos = []
res = 0

for i in range(m):
	if a[i] >= b[i]:
		pos.append((a[i] - b[i], i))
	else:
		neg.append((a[i] - b[i], i))
	res += b[i] * x

neg.sort()
pos.sort(reverse=True)

l, r = 0, n - 1
for i in neg:
	while r >= 0 and st[r][1] == 0:
		r -= 1
	res += (a[i[1]] - b[i[1]]) * st[r][0]
	st[r] = (st[r][0], st[r][1] - 1)

for i in pos:
	while l < n and st[l][1] == 0:
		l += 1
	res += (a[i[1]] - b[i[1]]) * st[l][0]
	st[l] = (st[l][0], st[l][1] - 1)

print(res * 2)
小杨和整数拆分
时间限制:20.0 s
内存限制:512.0 MB
题面描述
小杨有一个正整数n,小杨想将它拆分成若干完全平方数的和,同时小杨希望拆分的数量越少越好。
小杨请你编写程序计算出总和为n的完全平方数的最少数量。
输入格式
第一行包含一个正整数n,含义如题面所示。
输出格式
输出一个整数,代表总和为 n nn 的完全平方数的最少数量。
输入样例
输出样例
18=9+9=16+1+1,其中最少需要2个完全平方数。
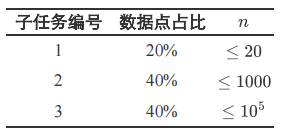
对于全部数据,保证有1≤n≤105。
import math

N = int(1e5) + 10
dp = [0] * N

n = int(input())

for i in range(1, n + 1):
	dp[i] = i
	for j in range(1, int(math.sqrt(i)) + 1):
		dp[i] = min(dp[i - j * j] + 1, dp[i])

print(dp[n])
题目大意:给定一个正整数n,将其拆分成若干个完全平方数的和,要求拆分的数量越少越好。求最少需要多少个完全平方数才能构成n。
用DP进行求解
状态定义
设dp[i]表示构成整数i的最少完全平方数的数量。
状态转移方程
考虑如何通过已知的dp[j](其中j < i)来推导出dp[i]。
对于任意一个整数i,我们可以考虑将它拆分成一个完全平方数j2加上剩余部分i - j2 的和。因此, dp[i] 可以通过dp[i - j2] 来推导出来,即:
dp[i] =min 1≤ k ≤ i (dp[ i−j 2 ]+1)
解释:
dp[i - j2] 表示剩余部分 i - j2 的最少完全平方数数量。+ 1 表示当前添加了一个完全平方数 j2。
我们需要取所有可能的 j 的最小值,以确保 dp[i] 最小。
算法学习
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨计划学习m种算法,为此他找了n道题目来帮助自己学习,每道题目至多学习一次。
小杨对于m种算法的初始掌握程度均为 0。第i道题目有对应的知识点ai即学习第i道题目可以令小杨对第ai种算法的掌握程度提高bi。小杨的学习目标是对m种算法的掌握程度均至少为k 。
小杨认为连续学习两道相同知识点的题目是不好的,小杨想请你编写程序帮他计算出他最少需要学习多少道题目才能使得他在完成学习目标的同时避免连续学习两道相同知识点的题目。
输入格式
第一行三个正整数m,n,k,代表算法种类数,题目数和目标掌握程度。
第二行n个正整数a1,a2,a3,...,an,代表每道题目的知识点。
第二行n个正整数b1,b2,b3,...,bn,代表每道题目提升的掌握程度。
输出格式
输出一个整数,代表小杨最少需要学习题目的数量,如果不存在满足条件的方案,输出 -1。
输入样例1
输出样例1
输入样例2
输出样例2
对于样例1,一种最优学习顺序为第一道题,第三道题,第四道题,第二道题。
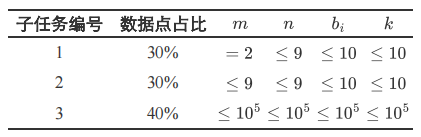
对于全部数据,保证有1≤m,n≤105,1≤bi,k≤105,1≤ai≤m。
N = int(1e5) + 5

def cmp(i, j):
	return i > j

m,n, k = map(int, input().split())
score = [[] for _ in range(m + 2)]
a = [0] * n
b = [0] * n

s = input().split()
for i in range(n):
	a[i] = int(s[i])

s = input().split()
for i in range(n):
	b[i] = int(s[i])
	score[a[i]].append(b[i])

need = [0] * (m + 2)
ans = 0
mx_meed = 0
mx_need_i = -1

for i in range(1, m + 1):
	score[i].sort(reverse=True)
	sum_vals = 0
	for j in range(len(score[i])):
		sum_vals += score[i][j]
		if sum_vals >= k:
			need[i] = j + 1
			break

	if sum_vals < k:
		print("-1")
		exit(0)

	ans += need[i]
	if need[i] > mx_meed:
		mx_meed = need[i]
		mx_need_i = i

if mx_meed - 1 <= ans - mx_meed:
	print(ans)
else:
	last = 0
	for i in range(1, m + 1):
		if i != mx_need_i:
			last += len(score[i]) - need[i]

	print(2 * mx_meed - 1 if mx_meed - 1 <= ans - mx_meed + last else -1)
1.数据准备
读入数据,并将每道题目按知识点分类,记录每种算法通过题目提升掌握程度的列表score。
2.计算每种算法所需的题目数量
对于每种算法,我们需要计算达到目标掌握程度k所需的题目数量。为了最大化利用高分题目,我们需要按分数降序排序。
3.确定最少题目数量
我们需要找到一种安排,使得小杨学习的题目数量最少,并且避免连续学习相同知识点的题目。为此,我们找出需要题目最多的算法,并尝试调整学习顺序。
4.调整学习顺序
如果最多需要的题目数量mx_need减去1之后仍然不超过总需要的题目数量减去mx_need,那么可以通过调整顺序来满足要求;否则,输出-1。
闯关游戏
时间限制:2.0 s
内存限制:128.0 MB
问题描述
你来到了一个闯关游戏。
这个游戏总共有N关,每关都有M个通道,你需要选择一个通道并通往后续关卡。其中,第i个通道可以让你前进ai关,也就是说,如果你现在在第x关,那么选择第i个通道后,你将直接来到第x+ai关(特别地,如果x+ai≥N,那么你就通关了)。此外,当你顺利离开第s关时,你还将获得bs分。
游戏开始时,你在第0关。请问,你通关时最多能获得多少总分?
输入描述
第一行两个整数N,M,分别表示关卡数量和每关的通道数量。
接下来一行M个用单个空格隔开的整数a0,a1,……,aM-1。保证1≤ai≤N。
接下来一行N个用单个空格隔开的整数b0,b1,……,bN-1。保证|bi|≤105。
输出描述
一行一个整数,表示你通关时最多能够获得的分数。
特别提醒
在常规程序中,输入、输出时提供提示是好习惯。但在本场考试中,由于系统限定,请不要在输入、输出中附带任何提示信息。
样例输入 1
样例输出 1
样例解释 1
你可以在第0关选择第1个通道,获得1分并来到第3关;随后再选择第0个通道,获得100分并来到第5关;最后任选一个通道,都可以获得30分并通关。如此,总得分为1+100+30=131。
样例输入 2
样例输出 2
样例解释 2
请注意,一些关卡的得分可能是负数。
数据规模
对于20%的测试点,保证M=1。
对于40%的测试点,保证N≤20;保证M≤2。
对于所有测试点,保证N≤104;保证M≤100。
n, m = input().split()
n, m = int(n), int(m)

a = list(map(int, input().split()))
b = list(map(int, input().split()))

max_b = max(a)

f = [b[0]]

ans = - 10 ** 18

for i in range(1, n):
	f.append(None)
	for step in a:
		if i - step >= 0 and f[i - step] is not None:
			f[i] = max(f[i], f[i - step]) if f[i] is not None else f[i - step]
	if f[i] is not None:
		f[i] += b[i]
	if f[i] is not None and i + max_b >= n:
		ans = max(ans, f[i])
print(ans)