C/C++编程二级 题库
执行以下代码,数组arr中元素的最终结果是?( )
int arr[4] = {2,4,6,8};
for(int i=0;i<4;i++)
{
      arr[i] = arr[i] * 2;
}以下代码用于求数组中所有元素的平均值,横线处应填入的代码是?( )
int arr[5] = {10,20,30,40,50};
int sum = 0;
for(int i=0;i<5;i++)
{
     sum += arr[i];
}
double avg = _________;
cout << avg;以下定义数组的方式【不正确】的是?( )
选项C错误,定义数组长度为3,但是初始化数组4个元素,超过数组长度。
以下代码的输出是?( )
int a[3] = {10, 20, 30};
cout << a[2-1];a[2-1]即:a[1],数组的第二个元素:20。
一维数组名代表数组首元素的内存地址。( )
数组逆序重放
将一个数组中的值按逆序重新存放。例如,原来的顺序为8,6,5,4,1。要求改为1,4,5,6,8。
输入
输入为两行:第一行数组中元素的个数n(1<n<100),第二行是n个整数,每两个整数之间用空格分隔。
输出
输出为一行:输出逆序后数组的整数,每两个整数之间用空格分隔。
样例输入
5
8 6 5 4 1
样例输出
1 4 5 6 8
#include <stdio.h>
int main() {
  int n;
  int a[10000];
  scanf("%d", &n);
  for (int i = 0; i < n; i++) {
    scanf("%d", &a[i]);
  }
  for (int i = n - 1; i >= 1; i--) {
    printf("%d ", a[i]);
  }
  printf("%d\n", a[0]);
  return 0;
}最长最短单词
输入1行句子(不多于200个单词,每个单词长度不超过100),只包含字母、空格和逗号。单词由至少一个连续的字母构成,空格和逗号都是单词间的间隔。
试输出第1个最长的单词和第1个最短单词。
输入
一行句子。
输出
两行输出: 第1行,第一个最长的单词。 第2行,第一个最短的单词。
样例输入
I am studying Programming language C in Peking University
样例输出
Programming
I
//解法1:用字符数组,用二维数组保存多个单词
//将字符串拆解为多个单词,用二维数组保存。
//遍历该二维数组,找出其中最长和最短单词。
#include<bits/stdc++.h>
using namespace std;
int main()
{
    char s[205][105]; //保存分割后的多个单词,s[i]是第i个单词字符串
    char c;//当前读取的字符
    int w = 0, j = 0;//w:s的第一下标,表示单词编号。 j:s的第二下标,表示某单词的第几字符
    while((c = getchar()) != '\n')//不断读取字符
    {
        if(c != ' ' && c != ',')//如果不是分隔符,那么向单词s[w]添加一个字符
            s[w][j++] = c;
        else if(j != 0)//如果是分隔符,且排除有连续空格或逗号的情况
        {
            s[w][j] = '\0';//为单词s[w]添加字符串末尾
            w++;//开始填充下一个单词
            j = 0;
        }
    }
    s[w][j] = '\0';//为最后一个单词添加末尾
    w++;
    int wordNum = w;//单词总数量
    int maxlen = 0, minlen = 200;//maxlen:最长单词长度、 minlen:最短单词长度
    int max_i, min_i;//max_i:最长单词编号, min_i:最短单词编号
    for(int i = 0; i < wordNum; ++i)//遍历所有单词,寻找其中最长和最短单词
    {
        if(strlen(s[i]) > maxlen)
        {
           max_i = i;
           maxlen = strlen(s[i]);
        }
        if(strlen(s[i]) < minlen)
        {
           min_i = i;
           minlen = strlen(s[i]);
        }
    }
    puts(s[max_i]);//puts输出一个字符串后自动输出换行符
    puts(s[min_i]);
    return 0;
}
// 解法2:用string类,遍历字符串,构造单词并看其是否是最长或最短单词
#include <bits/stdc++.h>
using namespace std;
int main() {
string s, word, maxWord, minWord; // s:输入的字符串 word:分解出的一个单词
// maxWord:最长单词 minWord最短单词
getline(cin, s);
s += ' '; // 字符串末尾加上一个空格分隔符,便于统一处理
int wst = 0, wlen = 0; // wst:单词的起始位置 wlen:单词的长度
int minLen = 200, maxLen = 0; // minLen:最短长度 maxLen:最大长度
for (int i = 0; i < s.length(); ++i) {
if (s[i] == ' ' || s[i] == ',') // 如果遇到分隔符
{
if (wlen > 0) // wlen > 0 排除有连续的分隔符的情况
{
word = s.substr(
wst,
wlen); // 从wst位置到i-1位置构成一个单词,其长度为wlen,截取该单词
if (wlen > maxLen) // 如果该单词比最长单词长,那么该单词就是最长单词
{
maxWord = word;
maxLen = wlen;
}
if (wlen < minLen) // 如果该单词比最短单词短,那么该单词就是最短单词
{
minWord = word;
minLen = wlen;
}
}
wst = i + 1; // 分隔符的下一个位置作为下一个单词的起始位置
wlen = 0;
} else // 如果遇到一般字符
wlen++; // 增加该单词长度
}
cout << maxWord << endl;
cout << minWord << endl;
return 0;
}数组指定部分逆序重放
将一个数组中的前k项按逆序重新存放。例如,将数组8,6,5,4,1前3项逆序重放得到5,6,8,4,1。
时间限制:1000
内存限制:65536
输入
输入为两行: 第一行两个整数,以空格分隔,分别为数组元素的个数n(1 < n < 100)以及指定的k(1 <= k <= n)。 第二行是n个整数,每两个整数之间用空格分隔。
输出
输出为一行:输出按题目要求逆序后数组的整数,每两个整数之间用空格分隔。
样例输入
5 3
8 6 5 4 1
样例输出
5 6 8 4 1
#include <bits/stdc++.h>
using namespace std;
int a[105];
int main() {
  int n, k;
  cin >> n >> k;
  for (int i = 1; i <= n; i++) {
    cin >> a[i];
  }
  for (int i = k; i >= 1; i--) {
    cout << a[i] << " ";
  }
  for (int i = k + 1; i <= n; i++) {
    cout << a[i] << " ";
  }
  return 0;
}
//样例代码 数组 排序
#include <bits/stdc++.h>
using namespace std;
int n,k,a[105];
int main()
{
scanf("%d %d",&n,&k);
for(int i=1;i<=n;i++)
scanf("%d",&a[i]);
sort(a+1,a+k+1);
for(int i=1;i<=n;i++)
printf("%d ",a[i]);
return 0;
}内部元素之和
输入一个整数矩阵,计算位于矩阵内部的元素之和。所谓矩阵内部的元素,不在第一行和最后一行的元素以及第一列和最后一列的元素。
时间限制:1000
内存限制:65536
输入
第一行分别为矩阵的行数m和列数n(m < 100,n < 100),两者之间以一个空格分开。 接下来输入的m行数据中,每行包含n个整数(每个数大于等于0,小于1000),整数之间以一个空格分开。
输出
输出对应矩阵的内部元素和
样例输入
3 3
3 4 1
3 7 1
2 0 1
样例输出
7
//样例代码  二维数组
#include <bits/stdc++.h>
using namespace std;
int n,m,a[105][105];
int main()
{
	scanf("%d %d",&m,&n);
	int res=0;
	for(int i=0;i<m;i++)
		for(int j=0;j<n;j++){
			scanf("%d",&a[i][j]);
			if(i!=0&&i!=m-1&&j!=0&&j!=n-1)
				res+=a[i][j];
		}
	printf("%d",res);
    return 0;
}小偷踩点
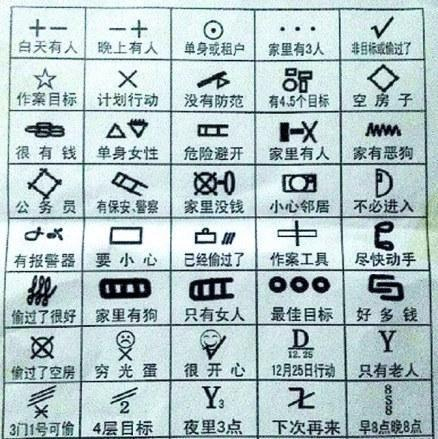
俗话说不怕贼偷,就怕贼惦记。
小偷在作案前有时会在居民家的门、墙上做一些标记,每一种记号代表一个含义,一般人看不懂,但同行一看便知道这个家庭的情况。不过派出所干警也不是吃素的,很快破译了这些记号的含义(如上图),并且在辖区内广为张贴,告知居民。
随后小偷们又改变了方法,将这些记号从 1 到 N 编号,然后将这些编号按照某种规则重新打乱再做标记,标记变成了一串数字。不过这种新的编号方法又被破译了!干警们发现这些数字的规律可以用一个二维矩阵来表示:矩阵有 10 列,顺序对应数字 0 到 9;矩阵一般不超过 10 行,每行对应一个 0 到 9 之间的数字,这些数字保证不重复。小偷的新标记由若干个两位数组成,每个数字的十位对应行、个位对应列,而对应位置上的数字就是原始标记的编号。
如上图 40 种标记从上到下、从左到右顺序编号后,按下图所示的规律打乱,则如果我们看到标记“71”,就是行标记为 7,列标记为 1 的单元格对应的数字 11,对应原始标记中第 11 个,即“很有钱”。那么标记“71 78 57”就表示原始标记的第 11、8、7 号,意思是“很有钱”、“没有防范”、“计划行动”。
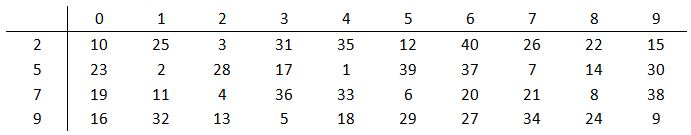
本题就请你编写程序,自动破译小偷的新标记。
时间限制:4000
内存限制:65536
输入
输入第一行给出 2 个正整数:N(≤ 100)为小偷的原始标记个数,M(≤ 10)为新标记对照矩阵的行数。 随后 N 行,第 i 行给出第 i 个标记的解释,由不超过 100 个英文字母和空格组成。 接下来一行给出 M 个数字,为 0 到 9 之间的数字,保证不重复,其中第 i 个数对应矩阵第 i 行。 接下来 M 行,每行给出 10 个数字,或者是 1 到 N 之间的一个编号,或者是 -1 表示没有对应的编号。 最后一行给出小偷留在墙上的数字标记,格式为: k t[1] … t[k] 其中 k 是数字个数(不超过 N),后面跟着 k 个数字。
输出
对小偷留下的每个数字,在一行中输出其对应的意义,顺序与输入顺序相同。如果没有对应的意义,则在对应行中输出 ?。
样例输入
10 2
jia li you ren
kong fang zi
jia you e gou
dan shen
hen you qian
xiao xin lin ju
you bao jing qi
jin kuai dong shou
xia ci zai lai
bu bi jin ru
6 2
-1 6 5 1 -1 10 3 4 -1 9
2 4 7 -1 3 -1 5 -1 8 2
5 20 64 61 22 13
样例输出
kong fang zi
?
xiao xin lin ju
you bao jing qi
?
#include#include using namespace std; int main() { int N, M, mat[10][10] = {0}; scanf("%d%d", &N, &M); cin.ignore(numeric_limits ::max(), '\n'); string marks[N + 1]; for (int i = 1; i <= N; ++i) getline(cin, marks[i]); int row_nums[M]; for (int i = 0; i < M; ++i) scanf("%d", &row_nums[i]); for (int i = 0; i < M; ++i) { for (int j = 0; j < 10; ++j) { scanf("%d", &mat[row_nums[i]][j]); } } int k; scanf("%d", &k); int num, idx; while (k--) { scanf("%d", &num); idx = mat[num / 10][num % 10]; if (idx <= 0) printf("?\n"); else printf("%s\n", marks[idx].c_str()); } return 0; }