Scratch编程一级 题库
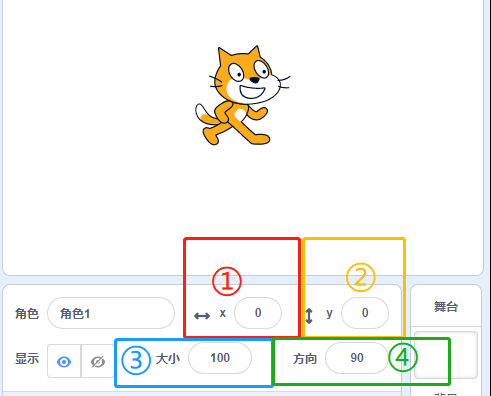
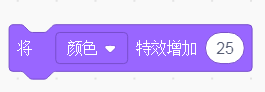
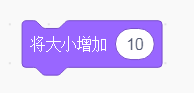
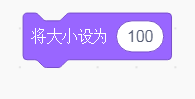
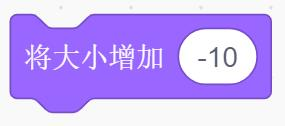
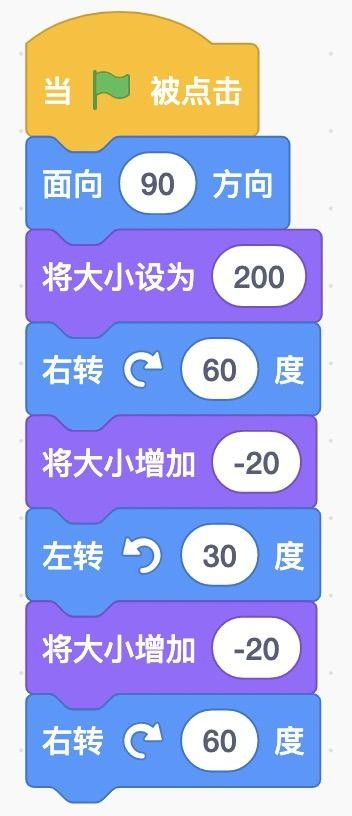
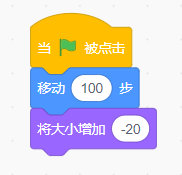
角色初始方向为 90,右转时方向值增加,左转时方向值减少,90+60-30+60=180, 角色最终面向 180 方向;角色的初始大小为 200,200-20-20=160,角色最终大小为 160。
下列说法不正确的是?
针对声音可以进行导入,上传,修改声音大小和速度这些操作,故正确答案选择D。
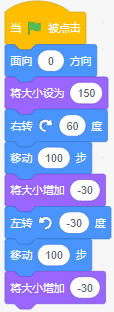
点击绿旗后,篮球初始方向为0,先右转60度,再左转-30度,篮球的最终面向方向为90度;篮球的初始大小为150,先增加-30,再增加-30,篮球最终大小为90,故正确答案为D。
有A、B、C、D、E五个自然数,其中A<B,E>C>D,D>B,E>A,那么五个自然数大小顺序是?
E>C>D>B>A
A>E>C>D>B
E>C>D>A>B
C>D>A>B>E
由E>C>D,D>B,可以推出E>C>D>B,由A<B,可以推出E>C>D>B>A,故选项A正确。
大猴子和小猴子一起摘桃子。小猴子摘了10个桃子,大猴子摘的桃子比小猴子少。后来小猴子给了大猴子1个桃子,这时两只猴子的桃子就一样多了。想一想,大猴子原来摘了几个桃子?( )
如下图所示,每个小正方形长度为100,下列哪个选项的程序不能帮助小猴子走到香蕉的位置?( )
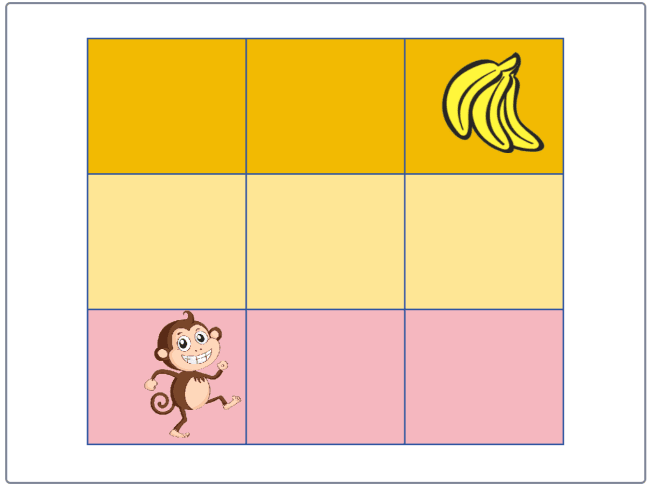
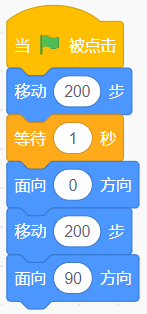
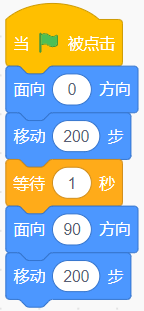
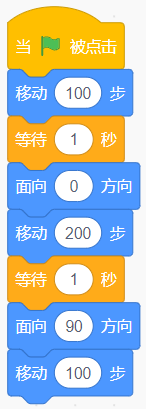
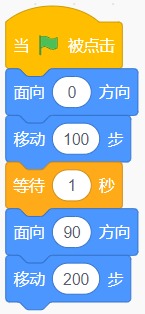
每个格子的大小是100,D选项中面向0方向,让角色向上,接着移动100步,向上移动了一格,等待1秒后再面向90方向,将方向朝右,最后移动200步,是向右移动了2格。所以运行后香蕉是在猴子上方一格,并不能走到香蕉的位置。故选D!
星际穿越
1.准备工作
(1)删除默认角色小猫,添加角色Rocketship,并将大小设置为50;
(2)添加背景Blue Sky、Galaxy、Space。
2.功能实现
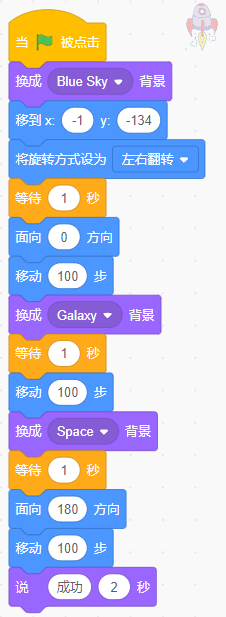
(1)程序开始,火箭出现在舞台中间下方的位置,初始背景为Blue Sky;
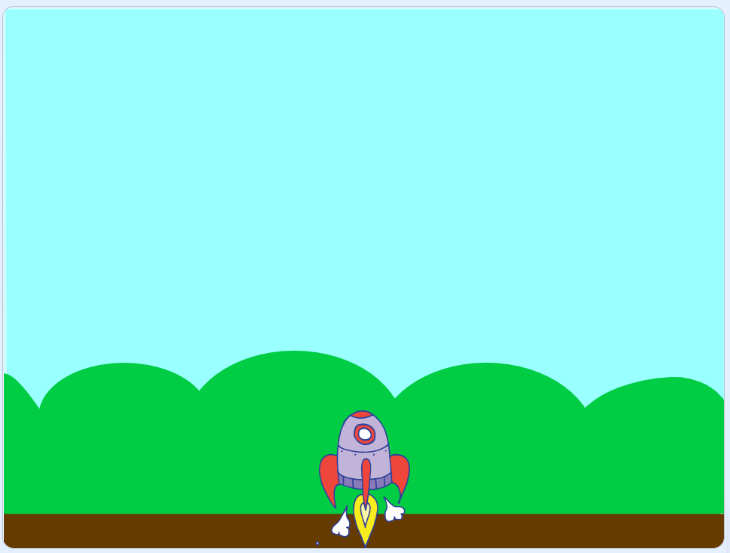
(2)等待1秒后,火箭向上移动100步,背景切换成Galaxy背景;
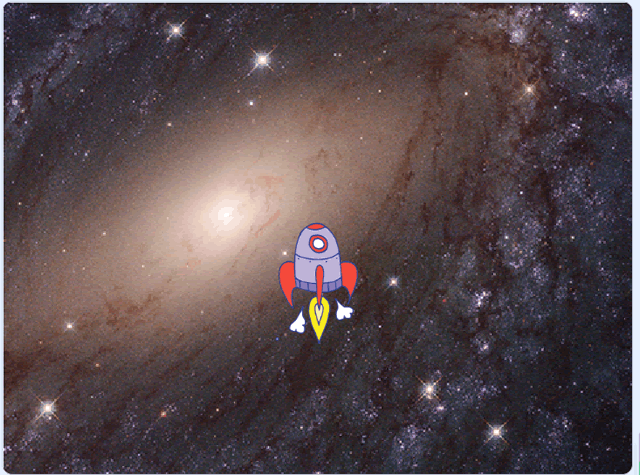
(3)等待1秒后,火箭继续往上飞100步,切换成Space背景;
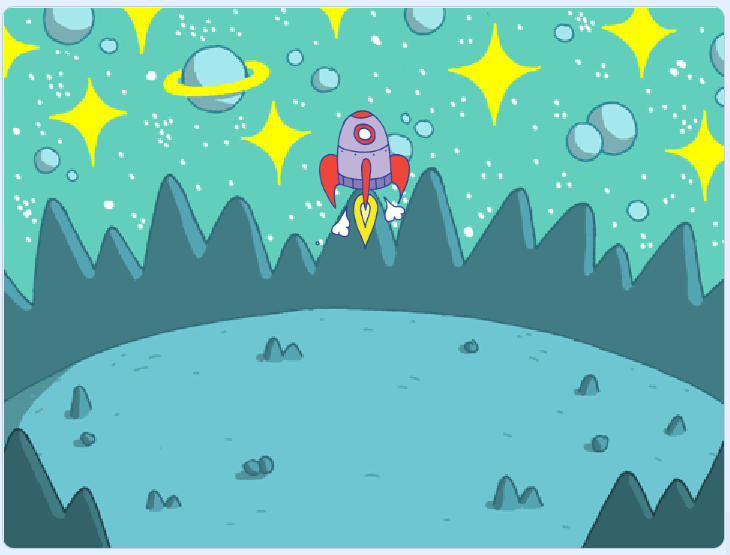
(4)等待1秒后,向下移动100步,着陆,说:“成功”2秒。
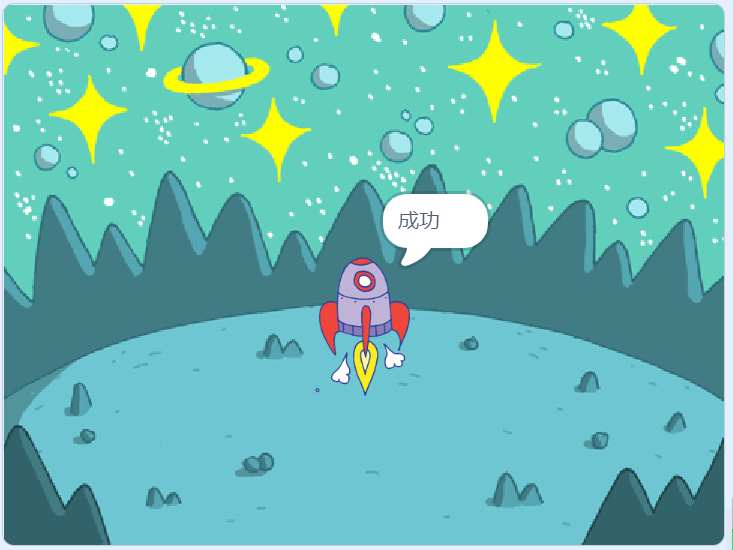
参考程序:
评分标准:
(1)能够添加Blue Sky、Galaxy、Space三个背景;(3分)
(2)能够添加角色Rocketship;(1分)
(3)初始背景为Blue Sky;(1分)
(4)能切换三次背景;(4分)
(5)每切换一次背景,Rocketship向上移动100步;(3分)
(6)最后向下移动100步;(1分)
(7)说“成功”2秒。(2分)
删除数字
娇娇一年级了,刚刚学会了识数和比大小。有一天,她在黑板上写上了一串数字:2,1,2,5,4。接着她擦掉了第一个2,发现剩下1,2,4都在自己的位置上,即:1在第1位,2在第2位,4在第4位。
娇娇希望擦掉某些数后,剩下的数列中在自己位置上的数尽量多。她发现这个问题很有趣,想知道最多能有几个数在自己的位置上,请你帮帮她!
时间限制:1000
内存限制:65536
输入
第一行,一个整数 TestNum( ≤ 10),表示测试数据的组数。 接下来每组数据有两行,第一行:一个整数n( ≤ 1000),第二行:n个正整数(≤ 1000)。
输出
对于每组测试数据,输出一个数表示答案。
样例输入
3
5
2 1 2 5 4
7
2 2 3 2 4 5 3
10
1 1 2 2 3 3 4 4 5 5
样例输出
3
4
5
提示
第一组测试数据:擦掉第一个数,1 2 4 有 3 个数在自己的位置上。
第二组测试数据:擦掉第4个、第7个数,2 3 4 5 有 4 个数在自己的位置上。
第三组测试数据:每种相同的数擦掉一个,1 2 3 4 5 有 5 个数在自己的位置上。
#include <cstdio>
#include <cstring>
#include <iostream>

using namespace std;
struct node {
  int data, lenth;
  int next;
} a[1010];
int main() {
  int t, n, i, j, p, maxn, o;
  cin >> t;
  for (o = 1; o <= t; o++) {
    cin >> n;
    for (i = 1; i <= n; i++)
      cin >> a[i].data;
    a[n].lenth = 1;
    a[n].next = 0;
    for (i = n - 1; i >= 1; i--) {
      maxn = p = 0;
      for (j = i + 1; j <= n; j++)
        if ((a[j].lenth > maxn) && (a[i].data < a[j].data)) {
          p = j;
          maxn = a[j].lenth;
        }
      a[i].lenth = maxn + 1;
      a[i].next = p;
    }
    maxn = j = 0;
    for (i = 1; i <= n; i++)
      if (a[i].lenth > maxn) {
        maxn = a[i].lenth;
        j = i;
      }
    cout << maxn << endl;
  }
  return 0;
}错误探测
给定n*n由0和1组成的矩阵,如果矩阵的每一行和每一列的1的数量都是偶数,则认为符合条件。
你的任务就是检测矩阵是否符合条件,或者在仅改变一个矩阵元素的情况下能否符合条件。
"改变矩阵元素"的操作定义为0变成1或者1变成0。
时间限制:1000
内存限制:65536
输入
输入n + 1行,第1行为矩阵的大小n(0 < n < 100),以下n行为矩阵的每一行的元素,元素之间以一个空格分开。
输出
如果矩阵符合条件,则输出OK; 如果矩阵仅改变一个矩阵元素就能符合条件,则输出需要改变的元素所在的行号和列号,以一个空格分开。 如果不符合以上两条,输出Corrupt。
样例输入
样例输入1
4
1 0 1 0
0 0 0 0
1 1 1 1
0 1 0 1
样例输入2
4
1 0 1 0
0 0 1 0
1 1 1 1
0 1 0 1
样例输入3
4
1 0 1 0
0 1 1 0
1 1 1 1
0 1 0 1
样例输出
样例输出1
OK
样例输出2
2 3
样例输出3
Corrupt
#include <bits/stdc++.h>
using namespace std;
int main() {
  int a[101][101], x[101], y[101], r, c, n, i, j, rs = 0, cs = 0;
  memset(x, 0, sizeof(x));
  memset(y, 0, sizeof(y));
  cin >> n;
  for (i = 0; i < n; i++) {
    for (j = 0; j < n; j++) {
      cin >> a[i][j];
      if (a[i][j] == 1)
        x[i]++;
    }
    if (x[i] & 1) {
      rs++;
      r = i;
    }
  }
  if (rs > 1) {
    cout << "Corrupt" << endl;
    return 0;
  }
  for (i = 0; i < n; i++) {
    for (j = 0; j < n; j++) {
      if (a[j][i] == 1)
        y[i]++;
    }
    if (y[i] & 1) {
      cs++;
      c = i;
      if (cs > 1)
        break;
    }
  }
  if (cs > 1) {
    cout << "Corrupt";
    return 0;
  }
  if (rs == 0 && cs == 0)
    cout << "OK";
  else
    cout << r + 1 << " " << c + 1 << endl;
  return 0;
}求满足条件的3位数
编写程序,按从小到大的顺序寻找同时符合条件1和2的所有3位数,条件为:
1.该数为完全平方数
2.该数至少有2位数字相同
例如,100同时满足上面两个条件。
输入
输入一个数n,n的大小不超过实际满足条件的3位数的个数。
输出
输出为第n个满足条件的3位数(升序)
样例输入
1
样例输出
100
#include <bits/stdc++.h>
using namespace std;
int a[1005];
int s = 1;
int main() {
  int x;
  cin >> x;
  if (x == 1)
    cout << 100;
  if (x == 2)
    cout << 121;
  if (x == 3)
    cout << 144;
  if (x == 4)
    cout << 225;
  if (x == 5)
    cout << 400;
  if (x == 6)
    cout << 441;
  if (x == 7)
    cout << 484;
  if (x == 8)
    cout << 676;
  if (x == 9)
    cout << 900;
}扩号匹配问题
在某个字符串(长度不超过100)中有左括号、右括号和大小写字母;规定(与常见的算数式子一样)任何一个左括号都从内到外与在它右边且距离最近的右括号匹配。写一个程序,找到无法匹配的左括号和右括号,输出原来字符串,并在下一行标出不能匹配的括号。不能匹配的左括号用"$"标注,不能匹配的右括号用"?"标注.
时间限制:3000
内存限制:65536
输入
输入包括多组数据,每组数据一行,包含一个字符串,只包含左右括号和大小写字母,字符串长度不超过100
输出
对每组输出数据,输出两行,第一行包含原始输入字符,第二行由"$","?"和空格组成,"$"和"?"表示与之对应的左括号和右括号不能匹配。
样例输入
((ABCD(x)
)(rttyy())sss)(
样例输出
((ABCD(x)
$$
)(rttyy())sss)(
?            ?$
//解法1:递归
#include <bits/stdc++.h>
using namespace std;
#define N 105
char s[N], sign[N];
int si, len;
void find()//找下一个右括号 如果找到,si指向右括号 如果没找到,做标记
{
    int lp = si;//当前左括号的下标
    si++;
    while(si < len)
    {
        if(s[si] == ')')
            return;
        else if(s[si] == '(')
            find();
        si++;
    }
    sign[lp] = '$';//没有找到右括号,左括号的位置标记为$
}
int main()
{
 while(cin >> s)
 {
     len = strlen(s);
  for(int i = 0; i < len; ++i)//初始化sign字符串为空格
            sign[i] = ' ';
        sign[len] = '\0';
        si = 0;
        while(si < len)
        {
            if(s[si] == ')')//右括号的位置标记为?
                sign[si] = '?';
            else if(s[si] == '(')
                find();
            si++;
        }
        cout << s << endl << sign << endl;
 }
 return 0;
}
//解法2
// 就近原则匹配:栈
// 遍历字符串
// 遇到左括号,将其下标入栈
// 右括号则先判断栈内元素情况
// 1.空,则将其下表记录到数组中
// 2.非空,则栈顶元素弹出(匹配到了)
// 将字符串便遍历后,将栈内元素记录入另一个数组
// 用两数组内的对应下标分别改成对应字符
#include <bits/stdc++.h>
using namespace std;
const int N = 1e5 + 10;
string s;
char ans[N]; // 第二排的输出数组
stack<int> st;
int a[N], cnt = 1; // 未匹配的右括号的下标存储
int b[N], cnn = 1; // 未匹配的左括号的下标存储
int main() {
while (getline(cin, s)) { // 输入不结束
memset(ans, 0, sizeof(ans));
memset(a, 0, sizeof(a));
memset(b, 0, sizeof(b));
cnt = 1;
cnn = 1; // 数据初始化
for (int i = 0; i < s.size(); i++) {
if (s[i] == '(') {
st.push(i); // 左括号统一入栈
}
if (s[i] == ')') {
if (!st.empty()) {
st.pop(); // 若栈非空,则可以匹配
} else {
a[cnt++] = i; // 否则无法匹配,记录
}
}
}
if (!st.empty())
while (!st.empty()) {
b[cnn++] = st.top();
st.pop();
} // 栈内数据(下标)的出栈
for (int i = 1; i < cnn; i++) {
ans[b[i]] = '$'; // 在ans内标记
}
for (int i = 1; i < cnt; i++) {
ans[a[i]] = '?'; // 在ans内标记
}
cout << s << endl;
for (int i = 0; i < s.size(); i++) {
if (ans[i] == 0)
cout << " ";
if (ans[i] == '$')
cout << "$";
if (ans[i] == '?')
cout << "?"; // 格式转化
}
cout << endl;
}
return 0;
}最大子矩阵
已知矩阵的大小定义为矩阵中所有元素的和。给定一个矩阵,你的任务是找到最大的非空(大小至少是1 * 1)子矩阵。 比如,如下4 * 4的矩阵
0 -2 -7 0
9 2 -6 2
-4 1 -4 1
-1 8 0 -2
的最大子矩阵是
9 2
-4 1
-1 8
这个子矩阵的大小是15。
时间限制:1000
内存限制:65536
输入
输入是一个N * N的矩阵。输入的第一行给出N (0 < N <= 100)。再后面的若干行中,依次(首先从左到右给出第一行的N个整数,再从左到右给出第二行的N个整数……)给出矩阵中的N2个整数,整数之间由空白字符分隔(空格或者空行)。已知矩阵中整数的范围都在[-127, 127]。
输出
输出最大子矩阵的大小。
样例输入
4
0 -2 -7 0 9 2 -6 2
-4 1 -4  1 -1
8  0 -2
样例输出
15
#include <stdio.h>
#define N 110
int a[N][N];
int sums[N][N];
int main() {
  int i, j, k, l, n, t, max;
  scanf("%d", &n);

  for (i = 1; i <= n; i++) // 前缀和
  {
    for (j = 1; j <= n; j++) {
      scanf("%d", &a[i][j]);
      sums[i][j] =
          sums[i - 1][j] + sums[i][j - 1] - sums[i - 1][j - 1] + a[i][j];
    }
  }
  max = sums[1][1];
  for (i = 1; i <= n; i++) {
    for (j = 1; j <= n; j++) {
      for (k = 1; k <= i;
           k++) // 枚举每个子矩阵,左上角(k,1),右下角(i,j),子矩阵和
      {
        for (l = 1; l <= j; l++) {
          t = sums[i][j] - sums[i][l - 1] - sums[k - 1][j] + sums[k - 1][l - 1];
          if (t > max)
            max = t;
        }
      }
    }
  }
  printf("%d\n", max);
  return 0;
}统一文件名
小A在命名文件的时候经常不注意大小写,格式比较混乱。现要求你写一个程序将目录下的文件统一规范的格式,即文件名的第一个字符如果是字母要大写,其他字母小写。如将Test、test整理成Test。
时间限制:1000
内存限制:65536
输入
第一行一个数字n,表示有n个文件名要统一,n不超过100。 接下来n行,每行一个单词,长度不超过20,表示文件的名字。文件名由字母、数字和-组成。
输出
n行,每行一个单词,对应统一后的文件名。
样例输入
4
Test
data
2-TEST
problem-6
样例输出
Test
Data
2-test
Problem-6
#include <iostream>
#include <string>
using namespace std;
int main() {
  string s;
  int n;
  cin >> n;
  while (n--) {
    cin >> s;
    if (s[0] >= 'a' && s[0] <= 'z')
      s[0] -= 32;
    int ls = s.size();
    for (int i = 1; i < ls; i++)
      if (s[i] >= 'A' && s[i] <= 'Z')
        s[i] += 32;
    cout << s << endl;
  }
  return 0;
}机器翻译
VariantF的电脑上安装了一个机器翻译软件,他经常用这个软件来翻译英语文章。这个翻译软件的原理很简单,它只是从头到尾,依次将每个英文单词用对应的中文含义来替换。对于每个英文单词,软件会先在内存中查找这个单词的中文含义,如果内存中有,软件就会用它进行翻译;如果内存中没有,软件就会在外存中的词典内查找,查出单词的中文含义然后翻译,并将这个单词和译义放入内存,以备后续的查找和翻译。
假设内存中有M 个单元,每单元能存放一个单词和译义。每当软件将一个新单词存入内存前,如果当前内存中已存入的单词数不超过M,软件会将新单词存入一个未使用的内存单元;若内存中已存入M 个单词,软件会清空最早进入内存的那个单词,腾出单元来,存放新单词。
假设一篇英语文章的长度为N 个单词。给定这篇待译文章,翻译软件需要去外存查找多少次词典?假设在翻译开始前,内存中没有任何单词。
时间限制:1000
内存限制:262144
输入
第一行为两个正整数M 和N,代表内存容量和文章的长度。 第二行为N 个非负整数,按照文章的顺序,每个数(大小不超过1000000)代表一个英文单词。文章中两个单词是同一个单词,当且仅当它们对应的非负整数相同。 对于50%的数据,1<=N、M<=1000; 对于100%的数据,1<=N、M<=1000000。
输出
一个整数,为软件需要查词典的次数。
样例输入
3 7
1 2 1 5 4 4 1
样例输出
5
提示
整个查字典过程如下:每行表示一个单词的翻译,冒号前为本次翻译后的内存状况: 空:内存初始状态为空。 1. 1:查找单词1 并调入内存。 2. 1 2:查找单词2 并调入内存。 3. 1 2:在内存中找到单词1。 4. 1 2 5:查找单词5 并调入内存。 5. 2 5 4:查找单词4 并调入内存替代单词1。 6. 2 5 4:在内存中找到单词4。 7. 5 4 1:查找单词1 并调入内存替代单词2。 共计查了5 次词典。
#include <cstdio>
int word[2000];
bool sch(int tgt, int range) // 线性搜索,因为数据<1000,不会超时。
{
  for (int i = 0; i < range; i++) {
    if (word[i] == tgt) {
      return true;
    }
  }
  return false;
}
int main() {
  int mem, num, tm, wor, ans = 0;
  scanf("%d %d", &mem, &num);
  tm = 0;
  for (int i = 0; i < 2000; i++) {
    word[i] = -1; // 数组初始化一定要初始化成-1!!!!
    // 字母代号有可能是0,所以初始化成0会出错!!!!
  }
  for (int i = 0; i < num; i++) {
    scanf("%d", &wor);
    // 非常节省空间和时间的模拟
    if (tm >= mem) {
      tm = 0;
    }
    if (!sch(wor, mem)) {
      // 自己进行轮回。。。
      ans++;
      word[tm] = wor;
      tm++;
    }
  }
  printf("%d", ans);
}