信息学奥赛-入门级 题库
定义字符串的基本操作为:删除一个字符\插入一个字符和将一个字符修改成另外一个字符这三种操作。将字符串A变成字符串B的最少操作步数,称为字符串A到字符串B的编辑距离。字符串“ ABCDEFG ”到字符串“ BADECG ”的编辑距离为 。
3
标题统计
【问题描述】
凯凯刚写了一篇美妙的作文,请问这篇作文的标题中有多少个字符?
注意:标题中可能包含大、小写英文字母、数字字符、空格和换行符。统计标题字
符数时,空格和换行符不计算在内。
【输入格式】
输入文件名为 title.in。
输入文件只有一行,一个字符串 s。
【输出格式】
输出文件名为 title.out。
输出文件只有一行,包含一个整数,即作文标题的字符数(不含空格和换行符)。
【输入输出样例 1】
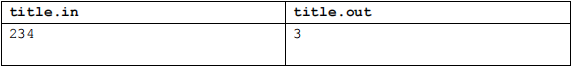
【输入输出样例 1 说明】
标题中共有 3 个字符,这 3 个字符都是数字字符。
【输入输出样例 2】
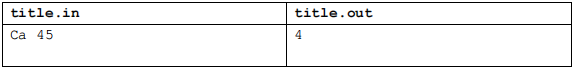
【输入输出样例 2 说明】
标题中共有 5 个字符,包括 1 个大写英文字母,1 个小写英文字母和 2 个数字字符,
还有 1 个空格。由于空格不计入结果中,故标题的有效字符数为 4 个。
【数据规模与约定】
规定 |s| 表示字符串 s 的长度(即字符串中的字符和空格数)。
对于 40% 的数据,1 ≤ |s| ≤ 5,保证输入为数字字符及行末换行符。
对于 80% 的数据,1 ≤ |s| ≤ 5,输入只可能包含大、小写英文字母、数字字符及
行末换行符。
对于 100% 的数据,1 ≤ |s| ≤ 5,输入可能包含大、小写英文字母、数字字符、空
格和行末换行符。
import java.util.Scanner;
public class P5015 {
public static void main(String[] args) {
Scanner sc = new Scanner(System.in);
String s = sc.nextLine();
int count = 0;
for (int i = 0; i < s.length(); i++) {
if (s.charAt(i)==' '){
count++;
}
}
System.out.print(s.length()-count);
}
}
数字游戏
【问题描述】
小K同学向小P同学发送了一个长度为8的 01字符串来玩数字游戏,小P 同学想 要知道字符串中究竟有多少个1。
注意:01字符串为每一个字符是0或者1的字符串,如“101”(不含双引号)为一 个长度为3的01字符串。
【输入格式】
输入文件名为number in。
输入文件只有一行, 一个长度为8的01字符串s。
【输出格式】
输出文件名为number.out。
输出文件只有一行,包含一个整数,即01字符串中字符1 的个数。
【输入输出样例1】
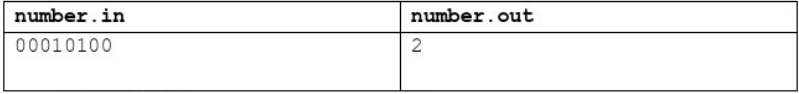
【输入输出样例1说明】
该01字符串中有2个字符1。
【输入输出样例2】
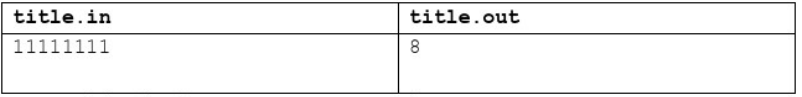
【输入输出样例2说明】
该01字符串中有8个字符1。
【数据规模与约定】
对于20%的数据,保证输入的字符全部为0。
对于100%的数据,输入只可能包含字符0和字符1,字符串长度固定为8。
#include<bits/stdc++.h>
using namespace std;
string str;
int cnt = 0;
int main(){
cin >> str;
for(int i = 0;str[i];i++) if(str[i] == '1') cnt++;
cout << cnt << endl;
return 0;
}
加工零件
【问题描述】
凯凯的工厂正在有条不紊地生产一种神奇的零件,神奇的零件的生产过程自然也很 神奇。工厂里有n位工人,工人们从1~n编号。某些工人之间存在双向的零件传送 带。保证每两名工人之间最多只存在一条传送带。
如果x号工人想生产一个被加工到第L(L>1)阶段的零件,则所有 与 x 号 工 人 有传送带直接相连的工人,都需要生产一个被加工到第L- 1阶段的零件(但x号工 人自己无需生产第L - 1阶段的零件)。
如果x号工人想生产一个被加工到第1阶段的零件,则所有与x号工人有传送带直接 相连的工人,都需要为x号工人提供一个原材料。
轩 轩 是 1 号工人。现在给出q张工单,第i张工单表示编号为ai的工人想生产 一个第Li阶段的零件。轩轩想知道对于每张工单,他是否需要给别人提供原材料。他 知道聪明的你一定可以帮他计算出来!
【输入格式】
输入文件名为work.in。
第一行两个正整数n,m和q,分别表示工人的数目、传送带的数目和工单的数目。
接下来m行,每行两个正整数u和v,表示编号为u和v的工人之间存在 一条零 件传输带。保证u≠v。
接下来q行,每行两个正整数a和L,表示编号为a的工人想生产 一个第L阶段 的零件。
【输出格式】
输出文件名为work . out。
共q行,每行一个字符串“Yes”或者“No”。如果按照第i张工单生产,需要编号为 1的轩轩提供原材料,则在第i行输出“Yes”;否则在第i行输出“No”。注意输出不含 引号。
【输入输出样例 1】
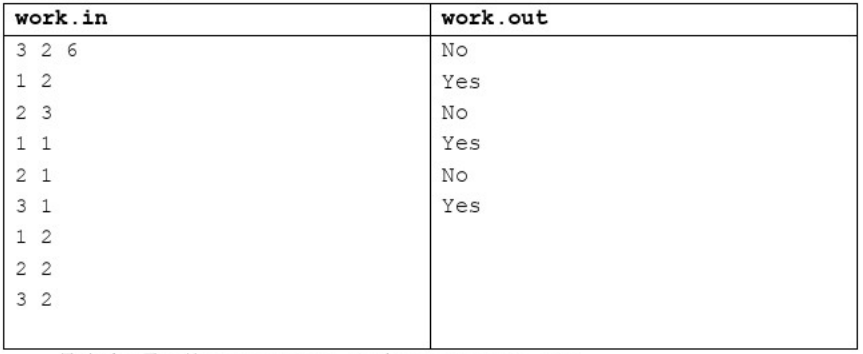
【输入输出样例1说明】
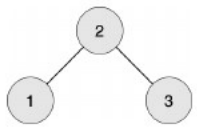
编号为1的工人想生产第1阶段的零件,需要编号为2的工人提供原材料。
编号为2的工人想生产第1阶段的零件,需要编号为1和3的工人提供原材料。
编号为3的工人想生产第1阶段的零件,需要编号为2的工人提供原材料。
编号为1的工人想生产第2阶段的零件,需要编号为2的工人生产第1阶段的零 件,需要编号为1和3的工人提供原材料。
编号为2的工人想生产第2阶段的零件,需要编号为1和3的工人生产第1阶段 的零件,他/她们都需要编号为2的工人提供原材料。
编号为3的工人想生产第2阶段的零件,需要编号为2的工人生产第1阶段的零件,需要编号为1和3的工人提供原材料。
【输入输出样例2】
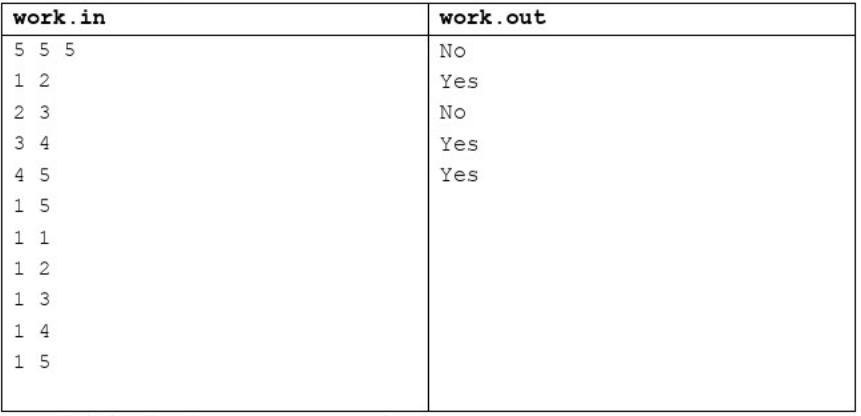
【输入输出样例2说明】
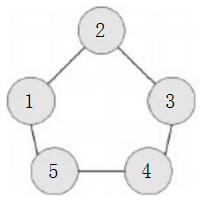
编号为1的工人想生产第1阶段的零件,需要编号为2和5的工人提供原材料。
编号为1的工人想生产第2阶段的零件,需要编号为2和5的工人生产第1阶段 的零件,需要编号为1,3,4 的工人提供原材料。
编号为1的工人想生产第3阶段的零件,需要编号为2和5的工人生产第2阶段的零件,需要编号为1,3,4的工人生产第1阶段的零件,需要编号为2,3,4,5 的工人提供 原材料。
编号为1的工人想生产第4阶段的零件,需要编号为2和5的工人生产第3阶段 的零件,需要编号为1,3,4的工人生产第2阶段的零件,需要编号为2,3,4,5 的工人生产 第1阶段的零件,需要全部工人提供原材料。
编号为1的工人想生产第5阶段的零件,需要编号为2和5的工人生产第4阶段 的零件,需要编号为1,3,4的工人生产第3阶段的零件,需要编号为2,3,4,5 的工人生产 第2阶段的零件,需要全部工人生产第1阶段的零件,需要全部工人提供原材料。
【数据规模与约定】
共20个测试点。
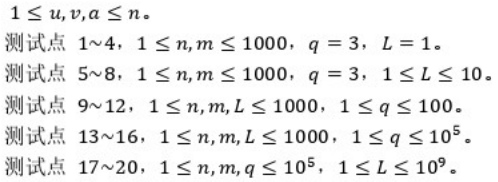
#include<bits/stdc++.h>
using namespace std;
const int N = 2e5+10;
const int M = 2*N;
typedef long long ll;
int n,m,q;
int head[N],edge[M],ver[M],nex[M] ,tot = 1;
void addEdge(int x,int y,int z){
ver[++tot] = y; edge[tot] = z;
nex[tot] = head[x]; head[x] = tot;
}
int getInt(){
int res = 0;
bool neg = false;
char c = getchar();
while(c != '-' && (c < '0' || c > '9')) c = getchar();
if(c == '-') neg = true, c = getchar();
while(c >= '0' && c <= '9') res = res*10+c-'0',c = getchar();
return neg?-res:res;
}
queue<int> que;
int dis[N],vis[N];
bool solve(int a,int l){
if(dis[a] <= l && !((dis[a]&1) ^ (l&1))) return true;
if(dis[a+n] <= l && !((dis[a+n]&1) ^ (l&1))) return true;
return false;
}
void SPFA(int s){
que.push(s);
memset(dis,0x3f,sizeof dis);
dis[s] = 0;
while(que.size()){
int x = que.front(); que.pop();
vis[x] = false;
for(int i = head[x];i ;i = nex[i]){
int y = ver[i], z = edge[i];
if(dis[y] > dis[x]+z){
dis[y] = dis[x]+z;
if(!vis[y]) que.push(y),vis[y] = true;
}
}
}
}
int main(){
n = getInt(); m = getInt(); q = getInt();
for(int i = 1,x,y;i <= m;i++){
x = getInt(); y = getInt();
addEdge(x,y+n,1); addEdge(y+n,x,1);
addEdge(x+n,y,1); addEdge(y,x+n,1);
}
SPFA(1);
//for(int i = 1;i <= n<<1;i++) cout << dis[i] << endl;
for(int i = 1,a,l;i <= q;i++){
a = getInt(); l = getInt();
if(solve(a,l)) puts("Yes");
else puts("No");
}
return 0;
}
统计单词数
【问题描述】
一般的文本编辑器都有查找单词的功能,该功能可以快速定位特定单词在文章中的位 置,有的还能统计出特定单词在文章中出现的次数。
现在,请你编程实现这一功能,具体要求是:给定一个单词,请你输出它在给定的文章 中出现的次数和第一次出现的位置。 注意:匹配单词时,不区分大小写,但要求完全匹配, 即给定单词必须与文章中的某一独立单词在不区分大小写的情况下完全相同(参见样例1), 如果给定单词仅是文章中某一单词的一部分则不算匹配(参见样例2)。
【输入】
输入文件名为stat.in,2行。
第1行为一个字符串,其中只含字母,表示给定单词;
第2行为一个字符串,其中只可能包含字母和空格,表示给定的文章。
【输出】
输出文件名为stat .out。
只有一行,如果在文章中找到给定单词则输出两个整数,两个整数之间用一个空格隔开, 分别是单词在文章中出现的次数和第一次出现的位置(即在文章中第一次出现时,单词首字 母在文章中的位置,位置从0开始);如果单词在文章中没有出现,则直接输出一个整数- 1。
【输入输出样例1】
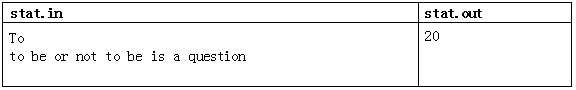
【输入输出样例1说明】
输出结果表示给定的单词To在文章中出现两次,第一 次出现的位置为0。
【输入输出样例2】
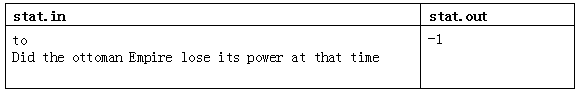
【输入输出样例2说明】
表示给定的单词to在文章中没有出现,输出整数- 1。
【 数据范围】
1≤单词长度≤10。
1≤文章长度≤1,000,000。
#include<cstdio>
#include<cstring>
#include<iostream>
using namespace std;
int main()
{
char w[11],s[1000001]; //w为输入的单词,s为输入的文章
int j=0,x=0; //j用来遍历单词,x是表示状态的变量
//x为-1时,表示目前检测道德单词不是要输入的单词
//x为0时,表示遇到文章中的空格,准备开始下一个单词的检测
//x为1时,就是找到啦!
int oc,count=0,h=0; //oc用来储存第一个找到的位置
//count记录出现的次数,h用来确保oc只存储第一次找到的位置
gets(w);
gets(s); //最适合新手的输入方式
int a1,a2;
a1=strlen(w);
a2=strlen(s); //a1,a2分别是w,s的长度,strlen是系统自带函数
//注意,strlen函数很慢,务必事先把值存储到a1,a2中
//否则后几个测试点会出现TLE错误
for(int i=0;i<a1;i++) //遍历单词和文章,将其统一转换为小写
w[i]=tolower(w[i]);
for(int i=0;i<a2;i++) //tolower是系统自带函数
s[i]=tolower(s[i]); //相应变成大写的函数是toupper
for(int i=0;i<a2;i++) //遍历文章
{
j=0; //确保每次检测单词从第一个字母开始
if(w[j]==s[i]&&x==0) //x=0表示为空格状态,开始新单词的检测
//若第一个字母相同则进入下述判断流程
{
for(;j<a1;j++) //遍历单词
{
if(w[j]!=s[i+j]) //如果出现不同,x赋值为-1,退出循环
{
x=-1;
break;
}
x=-1; //如果一直一样,但后面还有单词,x赋值为-1
if(s[i+j+1]==' '||i+j+1==a2) //如果下一个是空格或者文章结束,则找到啦!
x=1;
}
if(x==1) //找到了后,要简单的储存一下
{
count++;
if(h==0)
oc=i;
h=1;
i=i+a1-1; //因为遍历的是单词,i没有变化,因此给i加上单词的长度
//注意,for循环有i++,因此要事先-1!
}
}
else if(s[i]==' ') //空格情况
x=0;
else //其他情况则为非相同的单词
x=-1;
}
if(count!=0) //如果找到了,按要求输出
cout << count << " " << oc;
else //没找到就输出-1
cout << "-1";
return 0;
}
表达式的值
【问题描述】
对于1位二进制变量定义两种运算:
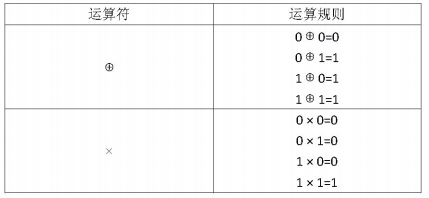
运算的优先级是:
1. 先计算括号内的,再计算括号外的。

现给定一个未完成的表达式,例如 +( * ),请你在横线处填入数字0或者1,请问有多少种填法可以使得表达式的值为0。
【输入】
输入文件名为exp.in,共2行。
第1行为一个整数L,表示给定的表达式中除去横线外{的运算符和括号的个数。
第2行为一个字符串包含L个字符,其中只包含’(’、’)’、²+’、”*这4种字符,其中’ (’、’)’是左右括号,’+’、’*’分别表示前面定义的运算符“田”和“×”。这行字符按顺序 给出了给定表达式中除去变量外的运算符和括号。
【输出】
输出文件exp.out共1行。包含一个整数,即所有的方案数。 注意:这个数可能会很大, 请输出方案数对10007取模后的结果。
【输入输出样例1】
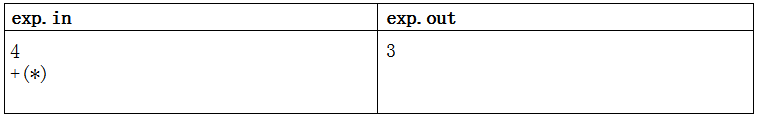
【输入输出样例说明】
给定的表达式包括横线字符之后为: +( * )
在横线位置填入(0、0、0)、(0、1、0)、(0、0、1)时,表达式的值均为0,所以共有3 种填法。
【数据范围】
对于20%的数据有O≤L≤10。
对于50%的数据有O≤L≤1,000。
对于70%的数据有O≤L≤10,000。
对于100%的数据有O≤L≤100,000。
对于50%的数据输入表达式中不含括号。
#include <bits/stdc++.h>
using namespace std;
const int MOD=10007;
int f[2][100005]; //每一位是0的可能性和是1的可能性
int main()
{
int len;
string c,pol=".";
cin>>len>>c;
stack<char> sta;
for(int i=0;i<len;i++)
{
if(c[i]=='(' || c[i]=='*')
sta.push(c[i]);
if(c[i]=='+')
{
while(!sta.empty() && sta.top()=='*')
{
pol+=sta.top();
sta.pop();
}
sta.push('+');
}
if(c[i]==')')
{
while(sta.top()!='(')
{
pol+=sta.top();
sta.pop();
}
sta.pop();
}
if(c[i]!='(' && c[i]!=')')
pol+='.';
}
while(!sta.empty())
{
pol+=sta.top();
sta.pop();
}
int j=0;
for(int i=0;i<(int)pol.length();i++)
{
if(pol[i]=='.')
{
j++;
f[0][j]=1;
f[1][j]=1;
}
if(pol[i]=='*')
{
j--;
f[0][j]=(f[0][j+1]*f[1][j]+f[0][j]*f[1][j+1]+f[0][j]*f[0][j+1])%MOD;
f[1][j]=(f[1][j]*f[1][j+1])%MOD;
}
if(pol[i]=='+')
{
j--;
f[1][j]=(f[0][j]*f[1][j+1]+f[0][j+1]*f[1][j]+f[1][j]*f[1][j+1])%MOD;
f[0][j]=(f[0][j]*f[0][j+1])%MOD;
}
}
cout<<f[0][j]<<endl; //f[0][1]
return 0;
}
扫雷游戏
【问题描述】
扫雷游戏是一款十分经典的单机小游戏。在 n 行 m 列的雷区中有一些格子含有地雷(称之为地雷格),其他格子不含地雷(称之为非地雷格)。玩家翻开一个非地雷格时,该格将会出现一个数字——提示周围格子中有多少个是地雷格。游戏的目标是在不翻出任何地雷格的条件下,找出所有的非地雷格。
现在给出n行m列的雷区中的地雷分布,要求计算出每个非地雷格周围的地雷格数。
注:一个格子的周围格子包括其上、下、左、右、左上、右上、左下、右下八个方向上与之直接相邻的格子。
【输入格式】
输入文件名为 mine.in。
输入文件第一行是用一个空格隔开的两个整数n和m,分别表示雷区的行数和列数。
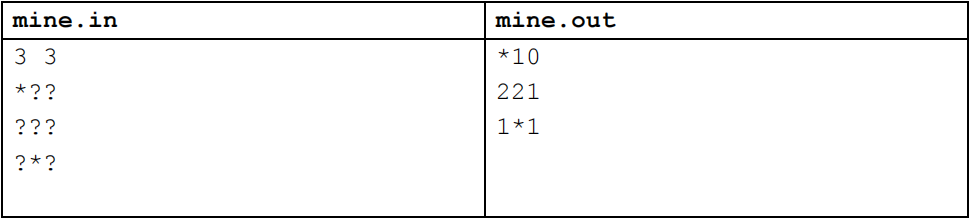
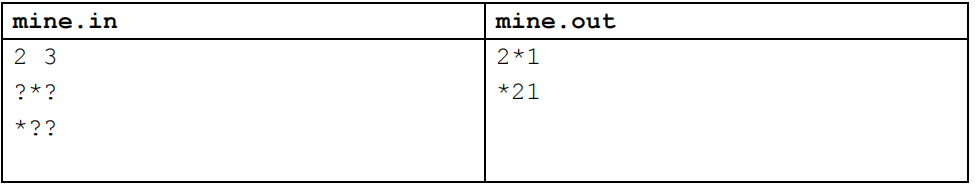
接下来 n 行,每行 m 个字符,描述了雷区中的地雷分布情况。字符’*’表示相应格子是地雷格,字符’?’表示相应格子是非地雷格。相邻字符之间无分隔符。
【输出格式】
输出文件名为 mine.out。
输出文件包含 n 行,每行 m 个字符,描述整个雷区。用’*’表示地雷格,用周围的地雷个数表示非地雷格。相邻字符之间无分隔符。
【输入输出样例 1】
【输入输出样例 2】
【数据说明】
对于 100%的数据,1≤n≤100,1≤m≤100。
#include <iostream>
using namespace std;
int main(){
int n,m,cnt=0;
char a[102][102];
cin>>n>>m;
for(int i=0;i<n;i++){
for(int j=0;j<m;j++){
cin>>a[i][j];
}
}
for(int i=0;i<n;i++){
for(int j=0;j<m;j++){
if(a[i][j]!='*'){
if(a[i-1][j-1]=='*') cnt++;
if(a[i-1][j]=='*') cnt++;
if(a[i-1][j+1]=='*') cnt++;
if(a[i][j-1]=='*') cnt++;
if(a[i][j+1]=='*') cnt++;
if(a[i+1][j-1]=='*') cnt++;
if(a[i+1][j]=='*') cnt++;
if(a[i+1][j+1]=='*') cnt++;
cout<<cnt;
cnt=0;
}
else{
cout<<"*";
}
}
cout<<" "<<endl;
}
return 0;
}
表达式求值
【问题描述】
给定一个只包含加法和乘法的算术表达式,请你编程计算表达式的值。
【输入】
输入文件为 expr.in。
输入仅有一行,为需要你计算的表达式,表达式中只包含数字、加法运算符“+”和乘法运算符“*”,且没有括号,所有参与运算的数字均为 0 到 之间的整数。输入数据保证这一行只有 0~ 9、+、*这 12 种字符。
【输出】
输出文件名为 expr.out。
输出只有一行,包含一个整数,表示这个表达式的值。注意:当答案长度多于 4 位时,请只输出最后 4 位,前导 0 不输出。
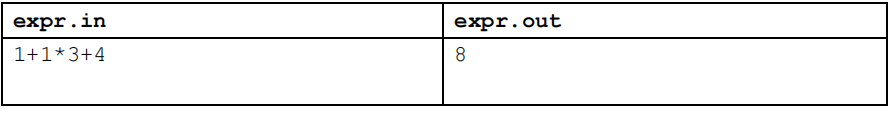
【输入输出样例 1】
【输入输出样例 2】
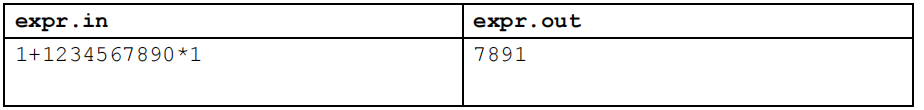
【输入输出样例 3】
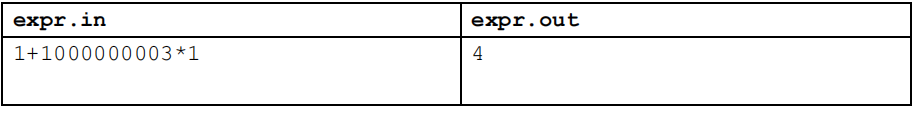
【输入输出样例说明】
样例 1 计算的结果为 8,直接输出 8。
样例 2 计算的结果为 1234567891,输出后 4 位,即 7891。
样例 3 计算的结果为 1000000004,输出后 4 位,即 4。
【数据范围】
对于 30%的数据,0≤表达式中加法运算符和乘法运算符的总数≤100;
对于 80%的数据,0≤表达式中加法运算符和乘法运算符的总数≤1000;
对于 100%的数据,0≤表达式中加法运算符和乘法运算符的总数≤100000。
#include<cstdio>
#include<iostream>
using namespace std;
int sum=0,num,tmp; //定义和,要操作的数,临时数
int main()
{
char op; //定义操作符
scanf("%d",&num); //首先读入一个数字,之后就是一个符号和一个数字的格式
while(scanf("%c",&op) && op !='\n') //没有遇到回车符就继续读入
{
scanf("%d",&tmp); //读入第二个数,根据上面的符号进行下面的操作
if(op == '+')
{
sum=(sum+num)%10000; //遇到加号就加上上一段的值,
num=tmp; //将每次读入的数 赋值给num
}
else //除了加号就是乘号
{
num=(num*tmp)%10000; //遇到乘号先把两个数乘起来
}
}
sum=(sum+num)%10000; //因为我们每次都是先读取符号再操作上一步的值,所以要加上最后一步操作的值。
printf("%d",sum);
return 0;
}
细胞分裂
【问题描述】
Hanks 博士是 BT (Bio-Tech,生物技术) 领域的知名专家。现在,他正在为一个细胞实验做准备工作:培养细胞样本。
Hanks 博士手里现在有 N 种细胞,编号从 1~N,一个第 i 种细胞经过 1 秒钟可以分裂为Si 个同种细胞(Si 为正整数)。现在他需要选取某种细胞的一个放进培养皿,让其自由分裂,进行培养。一段时间以后,再把培养皿中的所有细胞平均分入 M 个试管,形成 M 份样本,用于实验。Hanks 博士的试管数 M 很大,普通的计算机的基本数据类型无法存储这样大的M 值,但万幸的是,M 总可以表示为 m1的 m2 次方,即 M =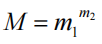 ,其中 m1,m2 均为基本数据类型可以存储的正整数。
注意,整个实验过程中不允许分割单个细胞,比如某个时刻若培养皿中有 4 个细胞,Hanks 博士可以把它们分入 2 个试管,每试管内 2 个,然后开始实验。但如果培养皿中有 5
个细胞,博士就无法将它们均分入 2 个试管。此时,博士就只能等待一段时间,让细胞们继续分裂,使得其个数可以均分,或是干脆改换另一种细胞培养。
为了能让实验尽早开始,Hanks 博士在选定一种细胞开始培养后,总是在得到的细胞“刚好可以平均分入 M 个试管”时停止细胞培养并开始实验。现在博士希望知道,选择哪种细胞培养,可以使得实验的开始时间最早。
【输入】
输入文件名为 cell.in,共有三行。
第一行有一个正整数 N,代表细胞种数。
第二行有两个正整数 m1,m2,以一个空格隔开, m1
m2 即表示试管的总数 M。
第三行有 N 个正整数,第 i 个数 Si 表示第 i 种细胞经过 1 秒钟可以分裂成同种细胞的个
数。
【输出】
输出文件 cell.out 共一行,为一个整数,表示从开始培养细胞到实验能够开始所经过的
最少时间(单位为秒)。
如果无论 Hanks 博士选择哪种细胞都不能满足要求,则输出整数-1。
【输入输出样例 1】
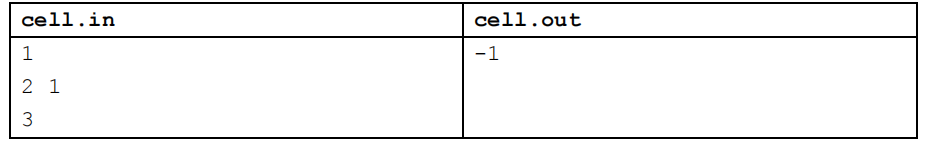
【输入输出样例 1 说明】
经过 1 秒钟,细胞分裂成 3 个,经过 2 秒钟,细胞分裂成 9 个,……,可以看出无论怎么分
裂,细胞的个数都是奇数,因此永远不能分入 2 个试管。
【输入输出样例 2】
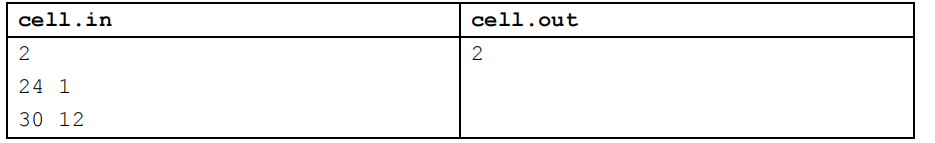
【输入输出样例 2 说明】
第 1 种细胞最早在 3 秒后才能均分入 24 个试管,而第 2 种最早在 2 秒后就可以均分(每
试管 144/(241
)=6 个)。故实验最早可以在 2 秒后开始。
【数据范围】
对于 50%的数据,有 m1
m2 ≤ 30000。
对于所有的数据,有 1≤ N ≤ 10000,1≤ m1 ≤ 30000,1≤ m2 ≤ 10000,1≤ Si≤ 2,000,000,000。
#include <bits/stdc++.h>
using namespace std;
int n,xb[10010],m1,m2,last=0;
int fj[30010]={0};
int max(int a,int b)
{
return a>b?a:b;
}
int main()
{
freopen("cell.in","r",stdin);
freopen("cell.out","w",stdout);
scanf("%d",&n);
scanf("%d%d",&m1,&m2);
while(m1)
{
int sqr = sqrt(m1);
bool bflag = 1;
for(int i=2;i<=sqr&&bflag;i++)
{
while(m1%i==0)
{
fj[i]+=m2;
bflag=0;
m1 /= i;
last=max(last,i);
}
}
if(bflag) {
if(m1) fj[m1]+=m2;
last = max(last,m1);
break;
}
}
int minn = 99999999;
for(int i=1;i<=n;i++)
{
int x;
scanf("%d",&x);
int maxx = 0;
for(int j = 2;j <= last;j++)
{
if(fj[j])
{
int p = 0;
while(x%j==0&&x){
p++;
x/=j;
}
if(!p) {
maxx = 99999999;
break;
}
maxx = max(maxx,ceil(1.0*fj[j]/p));
}
}
if(minn > maxx) minn = maxx;
}
if(minn==99999999)
printf("-1\n");
else printf("%d\n",minn);
return 0;
}
ISBN号码
【问题描述】
每一本正式出版的图书都有一个ISBN号码与之对应,ISBN码包括9位数字、1位识别码和3位分隔符,其规定格式如“x-xxx-xxxxx-x”,其中符号“-”是分隔符(键盘上的减号),最后一位是识别码,例如0-670-82162-4就是一个标准的ISBN码。ISBN码的首位数字表示书籍的出版语言,例如0代表英语;第一个分隔符“-”之后的三位数字代表出版社,例如670代表维京出版社;第二个分隔之后的五位数字代表该书在出版社的编号;最后一位为识别码。
识别码的计算方法如下:
首位数字乘以1加上次位数字乘以2……以此类推,用所得的结果mod 11,所得的余数即为识别码,如果余数为10,则识别码为大写字母X。例如ISBN号码0-670-82162-4中的识别码4是这样得到的:对067082162这9个数字,从左至右,分别乘以1,2,…,9,再求和,即0×1+6×2+……+2×9=158,然后取158 mod 11的结果4作为识别码。
你的任务是编写程序判断输入的ISBN号码中识别码是否正确,如果正确,则仅输出“Right”;如果错误,则输出你认为是正确的ISBN号码。
【输入】
输入文件isbn.in只有一行,是一个字符序列,表示一本书的ISBN号码(保证输入符合ISBN号码的格式要求)。
【输出】
输出文件isbn.out共一行,假如输入的ISBN号码的识别码正确,那么输出“Right”,否则,按照规定的格式,输出正确的ISBN号码(包括分隔符“-”)。
【输入输出样例1】

【输入输出样例2】

#include<stdio.h>
int main()
{
char ch[100]={0};
int sum,i;
while(scanf("%s",ch)!=EOF)
{
i=0;
sum=0;
sum=sum+(ch[i]-'0');
for(i=2;i<5;i++)
{
sum=sum+((ch[i]-'0')*i);
}
for(i=6;i<11;i++)
{
sum=sum+((ch[i]-'0')*(i-1));
}
sum=sum%11;
if(sum==10)
{
if(ch[12]=='X')
printf("Right\n");
else{
ch[12]='X';
printf("%s\n",ch) ;
}
}
else if(sum==(ch[12]-'0'))
printf("Right\n");
else
{
ch[12]=(char)(sum+'0');
printf("%s\n",ch);
}
}return 0;
}
守望者的逃离
【问题描述】
恶魔猎手尤迪安野心勃勃,他背叛了暗夜精灵,率领深藏在海底的娜迦族企图叛变。守望者在与尤迪安的交锋中遭遇了围杀,被困在一个荒芜的大岛上。为了杀死守望者,尤迪安开始对这个荒岛施咒,这座岛很快就会沉下去。到那时,岛上的所有人都会遇难。守望者的跑步速度为17m/s,以这样的速度是无法逃离荒岛的。庆幸的是守望者拥有闪烁法术,可在1s内移动60m,不过每次使用闪烁法术都会消耗魔法值10点。守望者的魔法值恢复的速度为4点/s,只有处在原地休息状态时才能恢复。
现在已知守望者的魔法初值M,他所在的初始位置与岛的出口之间的距离S,岛沉没的时间T。你的任务是写一个程序帮助守望者计算如何在最短的时间内逃离荒岛,若不能逃出,则输出守望者在剩下的时间内能走的最远距离。注意:守望者跑步、闪烁或休息活动均以秒(s)为单位,且每次活动的持续时间为整数秒。距离的单位为米(m)。
【输入】
输入文件escape.in仅一行,包括空格隔开的三个非负整数M, S, T。
【输出】
输出文件escape.out包含两行:
第1行为字符串“Yes”或“No”(区分大小写),即守望者是否能逃离荒岛。
第2行包含一个整数。第一行为“Yes”(区分大小写)时表示守望者逃离荒岛的最短时间;第一行为“No”(区分大小写)时表示守望者能走的最远距离。
【输入输出样例1】
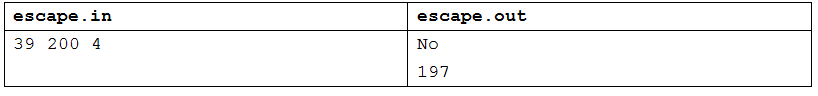
【输入输出样例2】
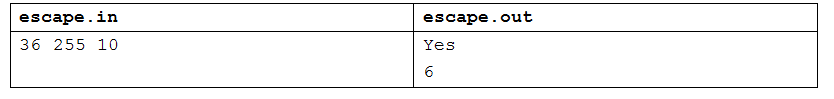
【限制】
30%的数据满足:1 <= T <= 10, 1 <= S <= 100
50%的数据满足:1 <= T <= 1000, 1 <= S <= 10000
100%的数据满足:1 <= T <= 300000, 0 <= M <= 1000, 1 <= S <= 108.
#include <algorithm>
#include <iostream>
using namespace std;
int m,s,t;
int now_s,now_time;
int nows,tim;
int main()
{
cin>>m>>s>>t;
while(now_time<t&&s>now_s)
{
now_s+=17;
if(m>=10) m-=10,nows+=60;
else m+=4;
now_s=max(now_s,nows);
now_time++;
}
if(now_s<s||now_time>t) cout<<"No"<<endl<<now_s;
else cout<<"Yes"<<endl<<now_time;
return 0;
}
Jam的计数法
【问题描述】
Jam是个喜欢标新立异的科学怪人。他不使用阿拉伯数字计数,而是使用小写英文字母计数,他觉得这样做,会使世界更加丰富多彩。在他的计数法中,每个数字的位数都是相同的(使用相同个数的字母),英文字母按原先的顺序,排在前面的字母小于排在它后面的字母。我们把这样的“数字”称为Jam数字。在Jam数字中,每个字母互不相同,而且从左到右是严格递增的。每次,Jam还指定使用字母的范围,例如,从2到10,表示只能使用{b,c,d,e,f,g,h,i,j}这些字母。如果再规定位数为5,那么,紧接在Jam数字“bdfij”之后的数字应该是“bdghi”。(如果我们用U、V依次表示Jam数字“bdfij”与“bdghi”,则U<V< span>,且不存在Jam数字P,使U<P<V< span>)。你的任务是:对于从文件读入的一个Jam数字,按顺序输出紧接在后面的5个Jam数字,如果后面没有那么多Jam数字,那么有几个就输出几个。
【输入文件】
输入文件counting.in 有2行,第1行为3个正整数,用一个空格隔开:
s t w
(其中s为所使用的最小的字母的序号,t为所使用的最大的字母的序号。w为数字的位数,这3个数满足:1≤s<T< span>≤26, 2≤w≤t-s )
第2行为具有w个小写字母的字符串,为一个符合要求的Jam数字。
所给的数据都是正确的,不必验证。
【输出文件】
输出文件counting.out 最多为5行,为紧接在输入的Jam数字后面的5个Jam数字,如果后面没有那么多Jam数字,那么有几个就输出几个。每行只输出一个Jam数字,是由w个小写字母组成的字符串,不要有多余的空格。
【输入样例】
2 10 5
bdfij
【输出样例】
bdghi
bdghj
bdgij
bdhij
befgh
#include<cstdio>
int main()
{
int s,t,w,num[26];
scanf("%d %d %d\n",&s,&t,&w);
for(int i=0;i<w;i++){
num[i]=getchar();
num[i]=num[i]-'a'+1;
}
for(int k=0;k<5;k++)
for(int i=w-1;i>=0;i--){
if(num[i]+1<=t-(w-1-i)){
num[i]+=1;
for(int j=i+1;j<w;j++)num[j]=num[i]+j-i;
for(int i=0;i<w;i++)printf("%c",num[i]+'a'-1);
printf("\n");
break;
}
}
return 0;
}
program program1;
Var
a,b,c,d,e:integer;
begin
a:=79 ; b:=34; c:=57;d:=0 ; e:=-1;
if (a<c) or (b>c) then d:=d+e
else if (d+10<e) then d:=e+10
else d:=e-a;
writeln(d);
end.
输出:_____________________。
program program2;
var
i,j:integer;
str1,str2:string;
begin
str1:='pig-is-stupid';
str2:='clever';
str1[1]:='d'; str1[2]:='o';
i:=8;
for j:=1 to 6 do begin
str1[i]:=str2[j];inc(i);
end;
writeln(str1);
end.
输出:_____________________。
program program3;
var
u:array[0..3] of integer;
a,b,c,x,y,z:integer;
begin
read(u[0],u[1],u[2],u[3]);
a:=u[0]+u[1]+u[2]+u[3]-5;
b:=u[0]*(u[1]-u[2] div u[3]+8);
c:=u[0]*u[1] div u[2] * u[3];
x:=(a+b+2)*3-u[(c+3) mod 4];
y:=(c*100-13) div a div (u[b mod 3]*5);
if ((x+y) mod 2=0) then z:=(a+b+c+x+y) div 2;
z:=(a+b+c-x-y)*2;
writeln(x+y-z);
read(a);
end.
输出:_____________________。
program program4 ;
var c:array[1..2] of string[200];
s:array[1..10] of integer;
m,n,i:integer ;
procedure numara;
var cod:boolean;
i,j,nr:integer;
begin
for j:=1 to n do begin
nr:=0;cod:=true;
for i:=1 to m do
if c[i,j]='1' then begin
if not cod then begin
cod:=true;inc(s[nr]);nr:=0;
end
end
else begin
if cod then begin
nr:=1;cod:=false ;
end
else inc(nr);
end;
if not cod then inc(s[nr]);
end;
end;
begin
readln(m,n);
for i:=1 to m do readln(c[i]);
numara;
for i:=1 to m do
if s[i] <>0 then write(i,' ',s[i],' ');
read(i);
end.
输出:_____________________。