信息学奥赛-入门级 题库
甲乙丙丁四人在考虑周末要不要外出郊游。
已知①如果周末下雨,并且乙不去,则甲一定不去;②如果乙去,则丁一定去;③如果丙去,则丁一定不去;④如果丁不去,而且甲不去,则丙一定不去。如果周末丙去了,则甲________(去了/没去)(1 分),乙________(去了/没去)(1 分),丁________(去了/没去)(1 分),周末________(下雨/没下雨)(2 分)。
答:去了 没去 没去 没下雨 (第4 空 2 分,其余 1 分)
从 1 到 2018 这 2018 个数中,共有__________个包含数字 8 的数。
包含数字 8 的数是指有某一位是“8”的数, 例如“2018”与“188”。
答:544
标题统计
【问题描述】
凯凯刚写了一篇美妙的作文,请问这篇作文的标题中有多少个字符?
注意:标题中可能包含大、小写英文字母、数字字符、空格和换行符。统计标题字
符数时,空格和换行符不计算在内。
【输入格式】
输入文件名为 title.in。
输入文件只有一行,一个字符串 s。
【输出格式】
输出文件名为 title.out。
输出文件只有一行,包含一个整数,即作文标题的字符数(不含空格和换行符)。
【输入输出样例 1】
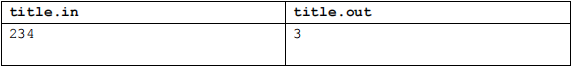
【输入输出样例 1 说明】
标题中共有 3 个字符,这 3 个字符都是数字字符。
【输入输出样例 2】
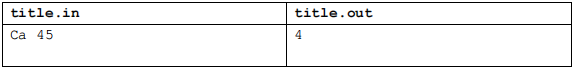
【输入输出样例 2 说明】
标题中共有 5 个字符,包括 1 个大写英文字母,1 个小写英文字母和 2 个数字字符,
还有 1 个空格。由于空格不计入结果中,故标题的有效字符数为 4 个。
【数据规模与约定】
规定 |s| 表示字符串 s 的长度(即字符串中的字符和空格数)。
对于 40% 的数据,1 ≤ |s| ≤ 5,保证输入为数字字符及行末换行符。
对于 80% 的数据,1 ≤ |s| ≤ 5,输入只可能包含大、小写英文字母、数字字符及
行末换行符。
对于 100% 的数据,1 ≤ |s| ≤ 5,输入可能包含大、小写英文字母、数字字符、空
格和行末换行符。
import java.util.Scanner;
public class P5015 {
public static void main(String[] args) {
Scanner sc = new Scanner(System.in);
String s = sc.nextLine();
int count = 0;
for (int i = 0; i < s.length(); i++) {
if (s.charAt(i)==' '){
count++;
}
}
System.out.print(s.length()-count);
}
}
成绩
【问题描述】
牛牛最近学习了 C++入门课程,这门课程的总成绩计算方法是:
总成绩 = 作业成绩 × 20% + 小测成绩 × 30% + 期末考试成绩 × 50%
牛牛想知道,这门课程自己最终能得到多少分。
【输入格式】
输入文件名为 score.in。
输入文件只有 1 行,包含三个非负整数A、B、C,分别表示牛牛的作业成绩、小测
成绩和期末考试成绩。相邻两个数之间用一个空格隔开,三项成绩满分都是 100 分。
【输出格式】
输出文件名为 score.out。
输出文件只有 1 行,包含一个整数,即牛牛这门课程的总成绩,满分也是 100 分。
【输入输出样例 1】
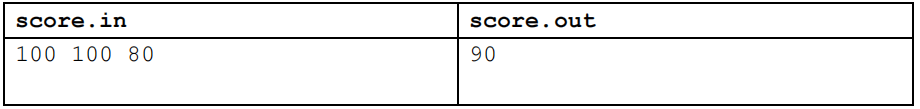
【输入输出样例 1 说明】
牛牛的作业成绩是 100 分,小测成绩是 100 分,期末考试成绩是 80 分,总成
绩是 100 × 20% + 100 × 30% + 80 × 50% = 20 + 30 + 40 = 90。
【输入输出样例 2】
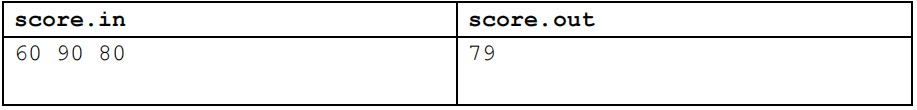
【输入输出样例 2 说明】
牛牛的作业成绩是 60 分,小测成绩是 90 分,期末考试成绩是 80 分,总成绩是
60 × 20% + 90 × 30% + 80 × 50% = 12 + 27 + 40 = 79。
【数据说明】
对于 30% 的数据,A = B = 0。
对于另外 30% 的数据,A = B = 100。
对于 100% 的数据, 0 ≤ A、B、C ≤ 100 且 A、B、C 都是 10 的整数倍。
#include<iostream>
using namespace std;
int main()
{
int A, B, C;
cin >> A >> B >> C;
cout << A * 0.2 + B * 0.3 + C * 0.5;
return 0;
}
数字游戏
【问题描述】
小K同学向小P同学发送了一个长度为8的 01字符串来玩数字游戏,小P 同学想 要知道字符串中究竟有多少个1。
注意:01字符串为每一个字符是0或者1的字符串,如“101”(不含双引号)为一 个长度为3的01字符串。
【输入格式】
输入文件名为number in。
输入文件只有一行, 一个长度为8的01字符串s。
【输出格式】
输出文件名为number.out。
输出文件只有一行,包含一个整数,即01字符串中字符1 的个数。
【输入输出样例1】
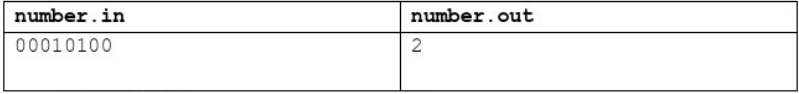
【输入输出样例1说明】
该01字符串中有2个字符1。
【输入输出样例2】
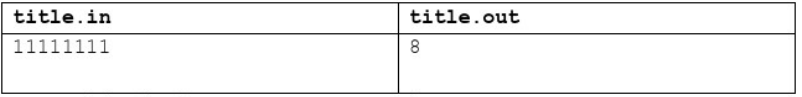
【输入输出样例2说明】
该01字符串中有8个字符1。
【数据规模与约定】
对于20%的数据,保证输入的字符全部为0。
对于100%的数据,输入只可能包含字符0和字符1,字符串长度固定为8。
#include<bits/stdc++.h>
using namespace std;
string str;
int cnt = 0;
int main(){
cin >> str;
for(int i = 0;str[i];i++) if(str[i] == '1') cnt++;
cout << cnt << endl;
return 0;
}
加工零件
【问题描述】
凯凯的工厂正在有条不紊地生产一种神奇的零件,神奇的零件的生产过程自然也很 神奇。工厂里有n位工人,工人们从1~n编号。某些工人之间存在双向的零件传送 带。保证每两名工人之间最多只存在一条传送带。
如果x号工人想生产一个被加工到第L(L>1)阶段的零件,则所有 与 x 号 工 人 有传送带直接相连的工人,都需要生产一个被加工到第L- 1阶段的零件(但x号工 人自己无需生产第L - 1阶段的零件)。
如果x号工人想生产一个被加工到第1阶段的零件,则所有与x号工人有传送带直接 相连的工人,都需要为x号工人提供一个原材料。
轩 轩 是 1 号工人。现在给出q张工单,第i张工单表示编号为ai的工人想生产 一个第Li阶段的零件。轩轩想知道对于每张工单,他是否需要给别人提供原材料。他 知道聪明的你一定可以帮他计算出来!
【输入格式】
输入文件名为work.in。
第一行两个正整数n,m和q,分别表示工人的数目、传送带的数目和工单的数目。
接下来m行,每行两个正整数u和v,表示编号为u和v的工人之间存在 一条零 件传输带。保证u≠v。
接下来q行,每行两个正整数a和L,表示编号为a的工人想生产 一个第L阶段 的零件。
【输出格式】
输出文件名为work . out。
共q行,每行一个字符串“Yes”或者“No”。如果按照第i张工单生产,需要编号为 1的轩轩提供原材料,则在第i行输出“Yes”;否则在第i行输出“No”。注意输出不含 引号。
【输入输出样例 1】
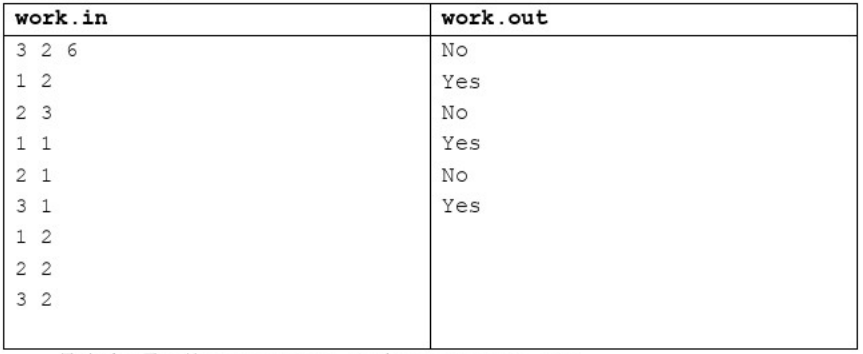
【输入输出样例1说明】
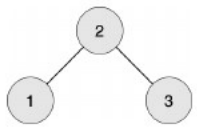
编号为1的工人想生产第1阶段的零件,需要编号为2的工人提供原材料。
编号为2的工人想生产第1阶段的零件,需要编号为1和3的工人提供原材料。
编号为3的工人想生产第1阶段的零件,需要编号为2的工人提供原材料。
编号为1的工人想生产第2阶段的零件,需要编号为2的工人生产第1阶段的零 件,需要编号为1和3的工人提供原材料。
编号为2的工人想生产第2阶段的零件,需要编号为1和3的工人生产第1阶段 的零件,他/她们都需要编号为2的工人提供原材料。
编号为3的工人想生产第2阶段的零件,需要编号为2的工人生产第1阶段的零件,需要编号为1和3的工人提供原材料。
【输入输出样例2】
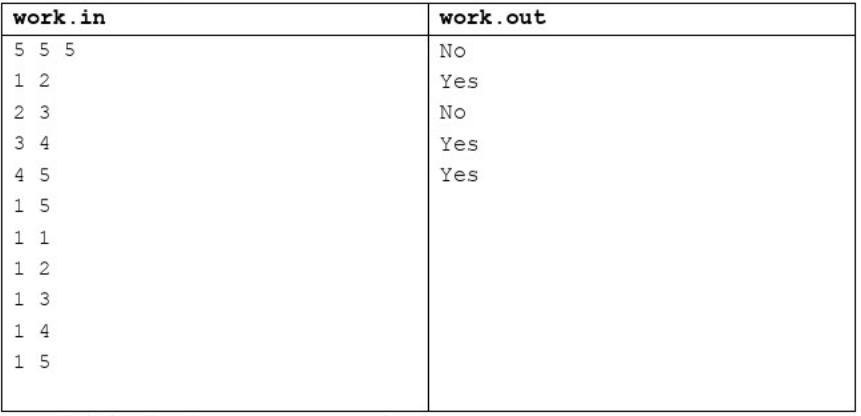
【输入输出样例2说明】
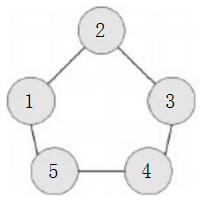
编号为1的工人想生产第1阶段的零件,需要编号为2和5的工人提供原材料。
编号为1的工人想生产第2阶段的零件,需要编号为2和5的工人生产第1阶段 的零件,需要编号为1,3,4 的工人提供原材料。
编号为1的工人想生产第3阶段的零件,需要编号为2和5的工人生产第2阶段的零件,需要编号为1,3,4的工人生产第1阶段的零件,需要编号为2,3,4,5 的工人提供 原材料。
编号为1的工人想生产第4阶段的零件,需要编号为2和5的工人生产第3阶段 的零件,需要编号为1,3,4的工人生产第2阶段的零件,需要编号为2,3,4,5 的工人生产 第1阶段的零件,需要全部工人提供原材料。
编号为1的工人想生产第5阶段的零件,需要编号为2和5的工人生产第4阶段 的零件,需要编号为1,3,4的工人生产第3阶段的零件,需要编号为2,3,4,5 的工人生产 第2阶段的零件,需要全部工人生产第1阶段的零件,需要全部工人提供原材料。
【数据规模与约定】
共20个测试点。
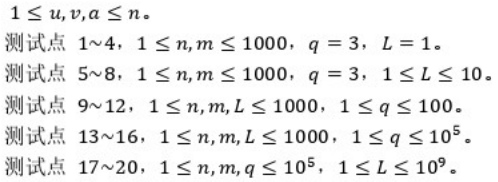
#include<bits/stdc++.h>
using namespace std;
const int N = 2e5+10;
const int M = 2*N;
typedef long long ll;
int n,m,q;
int head[N],edge[M],ver[M],nex[M] ,tot = 1;
void addEdge(int x,int y,int z){
ver[++tot] = y; edge[tot] = z;
nex[tot] = head[x]; head[x] = tot;
}
int getInt(){
int res = 0;
bool neg = false;
char c = getchar();
while(c != '-' && (c < '0' || c > '9')) c = getchar();
if(c == '-') neg = true, c = getchar();
while(c >= '0' && c <= '9') res = res*10+c-'0',c = getchar();
return neg?-res:res;
}
queue<int> que;
int dis[N],vis[N];
bool solve(int a,int l){
if(dis[a] <= l && !((dis[a]&1) ^ (l&1))) return true;
if(dis[a+n] <= l && !((dis[a+n]&1) ^ (l&1))) return true;
return false;
}
void SPFA(int s){
que.push(s);
memset(dis,0x3f,sizeof dis);
dis[s] = 0;
while(que.size()){
int x = que.front(); que.pop();
vis[x] = false;
for(int i = head[x];i ;i = nex[i]){
int y = ver[i], z = edge[i];
if(dis[y] > dis[x]+z){
dis[y] = dis[x]+z;
if(!vis[y]) que.push(y),vis[y] = true;
}
}
}
}
int main(){
n = getInt(); m = getInt(); q = getInt();
for(int i = 1,x,y;i <= m;i++){
x = getInt(); y = getInt();
addEdge(x,y+n,1); addEdge(y+n,x,1);
addEdge(x+n,y,1); addEdge(y,x+n,1);
}
SPFA(1);
//for(int i = 1;i <= n<<1;i++) cout << dis[i] << endl;
for(int i = 1,a,l;i <= q;i++){
a = getInt(); l = getInt();
if(solve(a,l)) puts("Yes");
else puts("No");
}
return 0;
}
回文日期 (date)
【问题描述】
在日常生活中,通过年、月、 日这三个要素可以表示出一个唯一确定的日期。
牛牛习惯用 8 位数字表示一个日期,其中,前 4 位代表年份,接下来 2 位代表月 份,最后 2 位代表日期。 显然:一个日期只有一种表示方法,而两个不同的日期的表 示方法不会相同。
牛牛认为,一个日期是回文的,当且仅当表示这个日期的 8 位数字是回文的。现 在,牛牛想知道:在他指定的两个日期之间 (包含这两个日期本身),有多少个真实存 在的日期是回文的。
【提示】
一个8位数字是回文的,当且仅当对于所有的 i  从左向右数的第 i 个 数字和第 9 - i 个数字 (即从右向左数的第i 个数字) 是相同的。
例如:
● 对于 2016 年 11 月 19 日,用8位数字 20161119 表示,它不是回文的。
● 对于 2010 年 1 月 2 日,用 8 位数字 20100102 表示,它是回文的。
● 对于 2010 年 10 月 2 日,用 8 位数字 20101002 表示,它不是回文的。
每一年中都有 12 个月份:
其中, 1 、 3 、 5 、 7 、 8 、 10 、 12 月每个月有 31 天; 4 、 6 、 9 、 11 月每个 月有30 天;而对于 2 月,闰年时有 29 天,平年时有 28 天。
一个年份是闰年当且仅当它满足下列两种情况其中的一种:
1. 这个年份是 4 的整数倍,但不是 100 的整数倍;
2. 这个年份是 400 的整数倍。 例如:
● 以下几个年份都是闰年: 2000 、 2012 、 2016 。
● 以下几个年份是平年: 1900 、 2011 、 2014 。
【输入格式】
从文件date.in 中读入数据。
输入包括两行,每行包括一个 8 位数字。
第一行表示牛牛指定的起始日期date1 。
第二行表示牛牛指定的终止日期date2 。
保证 date1 和 date2 都是真实存在的日期,且年份部分一定为 4 位数字,且首位数 字不为 0 。
保证 date1 一定不晚于 date2 。
【输出格式】
输出到文件date.out 中。
输出一行,包含一个整数,表示在 date1 和 date2 之间,有多少个日期是回文的。
【样例1输入】
20110101
20111231
【样例1输出】
1
【样例2输入】
20000101
20101231
【样例2输出】
2
【样例说明】
对于样例1 ,符合条件的日期是 20111102 。
对于样例2 ,符合条件的日期是 20011002 和 20100102 。
【子任务】
对于 60% 的数据,满足 date1 = date2 。
#include<iostream>
#include<cstdio>
#include<string>
#include<map>
#include<set>
#include<queue>
#include<vector>
using namespace std;
int i,j,n,m,a,b,c,sum,ans;
int s[13]={0,31,29,31,30,31,30,31,31,30,31,30,31};
int main()
{
scanf("%d%d",&n,&m);
for(i=1;i<=12;i++)
{
for(j=1;j<=s[i];j++)
{
c=(j%10)*1000+(j/10)*100+(i%10)*10+(i/10);
sum=c*10000+i*100+j;
if (sum<n||sum>m)
continue;
ans++;
}
}
printf("%d",ans);
return 0;
}
海港 (port)
【问题描述】
小K是一个海港的海关工作人员,每天都有许多船只到达海港,船上通常有很多来 自不同国家的乘客。
小K对这些到达海港的船只非常感兴趣,他按照时间记录下了到达海港的每一艘船 只情况;对于第 i 艘到达的船,他记录了这艘船到达的时间 ti (单位:秒),船上的乘 客数量 ki ,以及每名乘客的国籍 xi, 1 , xi,2 , . . . , xi,ki 。
小K统计了n 艘船的信息,希望你帮忙计算出以每一艘船到达时间为止的 24 小时 ( 24 小时 = 86400 秒) 内所有乘船到达的乘客来自多少个不同的国家。
形式化地讲,你需要计算 n 条信息。 对于输出的第 i 条信息,你需要统计满足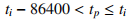 的船只p ,在所有的 xp,j 中,总共有多少个不同的数。
【输入格式】
从文件port.in 中读入数据。
第一行输入一个正整数n ,表示小K统计了n 艘船的信息。
接下来 n 行,每行描述一艘船的信息:前两个整数 ti 和 ki 分别表示这艘船到达海 港的时间和船上的乘客数量,接下来 ki 个整数 xi,j 表示船上乘客的国籍。
保证输入的ti 是递增的,单位是秒;表示从小K第一次上班开始计时,这艘船在第 ti 秒到达海港。
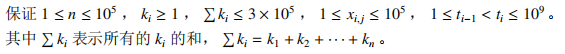
【输出格式】
输出到文件port.out 中。
输出n 行,第 i 行输出一个整数表示第i 艘船到达后的统计信息。
【样例1输入】
3
1 4 4 1 2 2
2 2 2 3
10 1 3
【样例1输出】
3
4
4
【样例1说明】
第一艘船在第 1 秒到达海港,最近 24 小时到达的船是第一艘船,共有 4 个乘客, 分别是来自国家 4, 1, 2, 2 ,共来自 3 个不同的国家;
第二艘船在第 2 秒到达海港,最近 24 小时到达的船是第一艘船和第二艘船,共有 4 + 2 = 6 个乘客,分别是来自国家 4, 1, 2, 2, 2, 3 ,共来自4 个不同的国家;
第三艘船在第 10 秒到达海港,最近 24 小时到达的船是第一艘船、第二艘船和第 三艘船,共有 4 + 2 + 1 = 7 个乘客,分别是来自国家 4, 1, 2, 2, 2, 3, 3 ,共来自4 个不同 的国家。
【样例2输入】
4
1 4 1 2 2 3
3 2 2 3
86401 2 3 4
86402 1 5
【样例2输出】
3
3
3
4
【样例2说明】
第一艘船在第 1 秒到达海港,最近 24 小时到达的船是第一艘船,共有 4 个乘客, 分别是来自国家 1, 2, 2, 3 ,共来自 3 个不同的国家;
第二艘船在第 3 秒到达海港,最近 24 小时到达的船是第一艘船和第二艘船,共有 4 + 2 = 6 个乘客,分别是来自国家 1, 2, 2, 3, 2, 3 ,共来自 3 个不同的国家;
第三艘船在第 86401 秒到达海港,最近 24 小时到达的船是第二艘船和第三艘船, 共有 2 + 2 = 4 个乘客,分别是来自国家 2, 3, 3, 4 ,共来自 3 个不同的国家;
第四艘船在第 86403 秒到达海港,最近 24 小时到达的船是第二艘船、第三艘船和 第四艘船,共有 2 + 2 + 1 = 5 个乘客,分别是来自国家 2, 3, 3, 4, 5 ,共来自4 个不同的 国家。
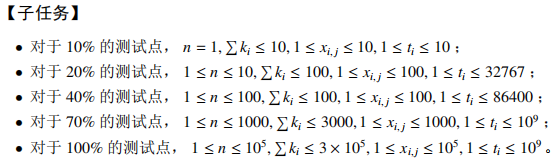
#include<iostream>
#include<queue>
using namespace std;
struct node
{
int t,c;
};
queue<node> q;
int a[100005];
int main()
{
int i,n,t,j,k,c,cnt=0;
cin>>n;
for(i=1;i<=n;i++)
{
cin>>t>>k;
for(j=1;j<=k;j++)
{
cin>>c;
q.push(node({t,c}));
if(a[c]==0)
cnt++;
a[c]++;
}
while(q.back().t- q.front() .t>=86400)
{
if((--a[q.front().c ])==0)
cnt--;
q.pop();
}
cout<<cnt<<endl;
}
return 0;
}
魔法阵 (magic)
【问题描述】
六十年一次的魔法战争就要开始了,大魔法师准备从附近的魔法场中汲取魔法能 量。
大魔法师有 m 个魔法物品,编号分别为 1, 2, . . . , m 。每个物品具有一个魔法值,我 们用xi 表示编号为 i 的物品的魔法值。每个魔法值xi 是不超过n 的正整数,可能有多 个物品的魔法值相同。
大魔法师认为,当且仅当四个编号为a, b, c, d 的魔法物品满足 xa < xb < xc < xd , xb - xa = 2(xd - xc ) ,并且 xb - xa < (xc - xb ) ÷ 3 时,这四个魔法物品形成了一个魔法阵, 他称这四个魔法物品分别为这个魔法阵的A 物品,B 物品,C 物品,D 物品。
现在,大魔法师想要知道,对于每个魔法物品,作为某个魔法阵的A 物品出现的 次数,作为B物品的次数,作为C 物品的次数,和作为D 物品的次数。
【输入格式】
从文件magic.in 中读入数据。
输入文件的第一行包含两个空格隔开的正整数 n 和m 。
接下来 m 行,每行一个正整数,第 i + 1 行的正整数表示xi ,即编号为 i 的物品的 魔法值。
保证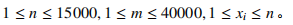 每个 xi 是分别在合法范围内等概率 随机生成的。
【输出格式】
输出到文件magic.out 中。
共输出 m 行,每行四个整数。 第 i 行的四个整数依次表示编号为 i 的物品作 为A,B,C,D 物品分别出现的次数。
保证标准输出中的每个数都不会超过
每行相邻的两个数之间用恰好一个空格隔开。
【样例1输入】
30 8
1
24
7
28
5
29
26
24
【样例1输出】
4 0 0 0
0 0 1 0
0 2 0 0
0 0 1 1
1 3 0 0
0 0 0 2
0 0 2 2
0 0 1 0
【样例1说明】
共有 5 个魔法阵,分别为:
物品 1, 3, 7, 6 ,其魔法值分别为 1, 7, 26, 29 ;
物品 1, 5, 2, 7 ,其魔法值分别为 1, 5, 24, 26 ;
物品 1, 5, 7, 4 ,其魔法值分别为 1, 5, 26, 28 ;
物品 1, 5, 8, 7 ,其魔法值分别为 1, 5, 24, 26 ;
物品 5, 3, 4, 6 ,其魔法值分别为 5, 7, 28, 29 。
以物品 5 为例,它作为A 物品出现了 1 次,作为B物品出现了 3 次,没有作为C 物 品或者D 物品出现,所以这一行输出的四个数依次为 1, 3, 0, 0 。
此外,如果我们将输出看作一个 m 行 4 列的矩阵,那么每一列上的 m 个数之和都 应等于魔法阵的总数。所以,如果你的输出不满足这个性质,那么这个输出一定不正 确。你可以通过这个性质在一定程度上检查你的输出的正确性。
【样例2输入】
15 15
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
【样例2输出】
5 0 0 0
4 0 0 0
3 5 0 0
2 4 0 0
1 3 0 0
0 2 0 0
0 1 0 0
0 0 0 0
0 0 0 0
0 0 1 0
0 0 2 1
0 0 3 2
0 0 4 3
0 0 5 4
0 0 0 5
【子任务】
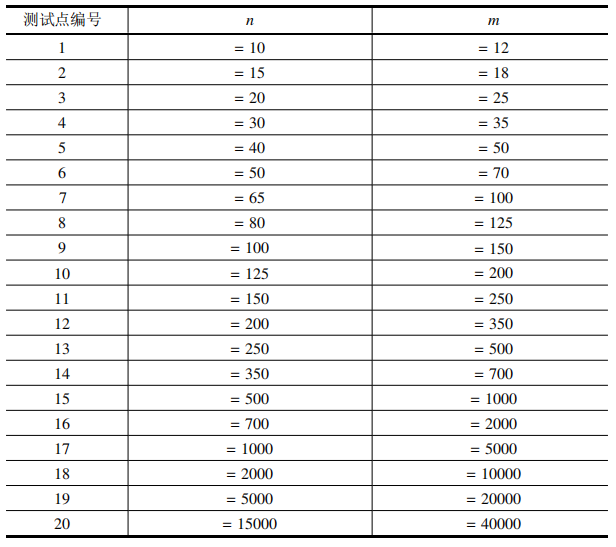
每个测试点的详细数据范围见下表。
#include <bits/stdc++.h>
using namespace std;
int n,m;
int a[40001];
int f[5][15001]/*作为第i个物品时,魔法值为j的次数*/;
int d[15001]/*魔法值为i的物品个数*/;
int sum=0,cnt=0;
int main(){
memset(f,0,sizeof(f));
scanf("%d%d",&n,&m);
for(int i=1;i<=m;i++){
scanf("%d",&a[i]);
d[a[i]]++;
}
for(int t=1;t*9+2<=n;t++){
sum=0;cnt=0;
for(int dd=9*t+2;dd<=n;dd++){
int cc=dd-t;//第三个物品
int bb=cc-6*t-1;//第二个物品
int aa=bb-2*t;//第一个物品
sum+=d[aa]*d[bb];//递推计算前缀和
f[3][cc]+=sum*d[dd];//魔法值为d的个数可能不是/不止1个
f[4][dd]+=sum*d[cc];//同理
}
for(int aa=n-9*t-1;aa>=1;aa--){
int bb=aa+2*t;//第二个物品
int cc=bb+6*t+1;//第三个物品
int dd=cc+t;//第四个物品
cnt+=d[cc]*d[dd];
f[1][aa]+=cnt*d[bb];
f[2][bb]+=cnt*d[aa];
}
}
for(int i=1;i<=m;i++){
for(int j=1;j<=4;j++){
printf("%d ",f[j][a[i]]);
}
printf("\n");
}
return 0;
}
数字反转
【问题描述】
给定一个整数,请将该数各个位上数字反转得到一个新数。新数也应满足整数的常见形 式,即除非给定的原数为零,否则反转后得到的新数的最高位数字不应为零(参见样例2)。
【输入】
输入文件名为reverse.in。
输入共1行, 一个整数N。
【输出】
输出文件名为reverse.out。
输出共1行, 一个整数,表示反转后的新数。
【输入输出样例1】
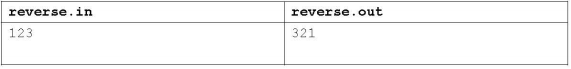
【输入输出样例2】
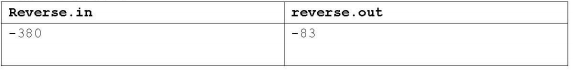
【数据范围】
-1,000,000,000≤ N≤1,000,000,000。
#include<stdio.h>
int main(){
int m,i;
scanf("%d",&m);
if(m==0) printf("0");
if(m<0) {
m=-m;
printf("-");
}
do{
i=m%10;
m=m/10;
if(i!=0)printf("%d",i);
}while(i==0);
while(m!=0){
i=m%10;
m=m/10;
printf("%d",i);
}
return 0;
}
统计单词数
【问题描述】
一般的文本编辑器都有查找单词的功能,该功能可以快速定位特定单词在文章中的位 置,有的还能统计出特定单词在文章中出现的次数。
现在,请你编程实现这一功能,具体要求是:给定一个单词,请你输出它在给定的文章 中出现的次数和第一次出现的位置。 注意:匹配单词时,不区分大小写,但要求完全匹配, 即给定单词必须与文章中的某一独立单词在不区分大小写的情况下完全相同(参见样例1), 如果给定单词仅是文章中某一单词的一部分则不算匹配(参见样例2)。
【输入】
输入文件名为stat.in,2行。
第1行为一个字符串,其中只含字母,表示给定单词;
第2行为一个字符串,其中只可能包含字母和空格,表示给定的文章。
【输出】
输出文件名为stat .out。
只有一行,如果在文章中找到给定单词则输出两个整数,两个整数之间用一个空格隔开, 分别是单词在文章中出现的次数和第一次出现的位置(即在文章中第一次出现时,单词首字 母在文章中的位置,位置从0开始);如果单词在文章中没有出现,则直接输出一个整数- 1。
【输入输出样例1】
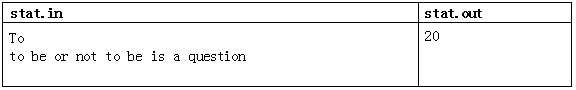
【输入输出样例1说明】
输出结果表示给定的单词To在文章中出现两次,第一 次出现的位置为0。
【输入输出样例2】
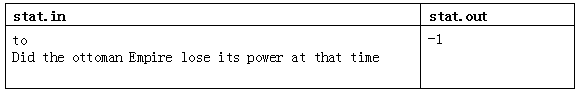
【输入输出样例2说明】
表示给定的单词to在文章中没有出现,输出整数- 1。
【 数据范围】
1≤单词长度≤10。
1≤文章长度≤1,000,000。
#include<cstdio>
#include<cstring>
#include<iostream>
using namespace std;
int main()
{
char w[11],s[1000001]; //w为输入的单词,s为输入的文章
int j=0,x=0; //j用来遍历单词,x是表示状态的变量
//x为-1时,表示目前检测道德单词不是要输入的单词
//x为0时,表示遇到文章中的空格,准备开始下一个单词的检测
//x为1时,就是找到啦!
int oc,count=0,h=0; //oc用来储存第一个找到的位置
//count记录出现的次数,h用来确保oc只存储第一次找到的位置
gets(w);
gets(s); //最适合新手的输入方式
int a1,a2;
a1=strlen(w);
a2=strlen(s); //a1,a2分别是w,s的长度,strlen是系统自带函数
//注意,strlen函数很慢,务必事先把值存储到a1,a2中
//否则后几个测试点会出现TLE错误
for(int i=0;i<a1;i++) //遍历单词和文章,将其统一转换为小写
w[i]=tolower(w[i]);
for(int i=0;i<a2;i++) //tolower是系统自带函数
s[i]=tolower(s[i]); //相应变成大写的函数是toupper
for(int i=0;i<a2;i++) //遍历文章
{
j=0; //确保每次检测单词从第一个字母开始
if(w[j]==s[i]&&x==0) //x=0表示为空格状态,开始新单词的检测
//若第一个字母相同则进入下述判断流程
{
for(;j<a1;j++) //遍历单词
{
if(w[j]!=s[i+j]) //如果出现不同,x赋值为-1,退出循环
{
x=-1;
break;
}
x=-1; //如果一直一样,但后面还有单词,x赋值为-1
if(s[i+j+1]==' '||i+j+1==a2) //如果下一个是空格或者文章结束,则找到啦!
x=1;
}
if(x==1) //找到了后,要简单的储存一下
{
count++;
if(h==0)
oc=i;
h=1;
i=i+a1-1; //因为遍历的是单词,i没有变化,因此给i加上单词的长度
//注意,for循环有i++,因此要事先-1!
}
}
else if(s[i]==' ') //空格情况
x=0;
else //其他情况则为非相同的单词
x=-1;
}
if(count!=0) //如果找到了,按要求输出
cout << count << " " << oc;
else //没找到就输出-1
cout << "-1";
return 0;
}
瑞士轮
【背景】
在双人对决的竞技性比赛,如乒乓球、羽毛球、国际象棋中,最常见的赛制是淘汰赛和 循环赛。前者的特点是比赛场数少,每场都紧张刺激,但偶然性较高。后者的特点是较为公 平,偶然性较低,但比赛过程往往十分冗长。
本题中介绍的瑞士轮赛制,因最早使用于1895年在瑞士举办的国际象棋比赛而得名。 它可以看作是淘汰赛与循环赛的折衷,既保证了比赛的稳定性,又能使赛程不至于过长。
【问题描述】
2*N名编号为1~2N的选手共进行R轮比赛。每轮比赛开始前,以及所有比赛结束后, 都会按照总分从高到低对选手进行一次排名。选手的总分为第一轮开始前的初始分数加上已 参加过的所有比赛的得分和。总分相同的,约定编号较小的选手排名靠前。
每轮比赛的对阵安排与该轮比赛开始前的排名有关:第1 名 和 第 2 名 、 第 3 名 和 第 4 名、 … … 、第2K - 1名和第2K名、 … … 、第2N - 1名和第2N名,各进行 一 场比赛。每 场比赛胜者得1分,负者得0分。也就是说除了首轮以外,其它轮比赛的安排均不能事先确 定,而是要取决于选手在之前比赛中的表现。
现给定每个选手的初始分数及其实力值,试计算在R轮比赛过后,排名第Q的选手编号是多少。我们假设选手的实力值两两不同,且每场比赛中实力值较高的总能获胜。
【输入】
输入文件名为swiss .in。
输入的第一行是三个正整数N、R、Q,每两个数之间用一个空格隔开,表示有2*N名 选手、R轮比赛,以及我们关心的名次Q。
第二行是2*N个非负整数s1,s2,…,S2N,每两个数之间用一个空格隔开,其中si表示编 号为i的选手的初始分数。
第三行是2*N个正整数w1,w2,…,w2N,每两个数之间用一个空格隔开,其中wi表示编 号为i的选手的实力值。
【输出】
输出文件名为swiss . out。
输出只有一行,包含一个整数,即R轮比赛结束后,排名第Q的选手的编号。
【输入输出样例】
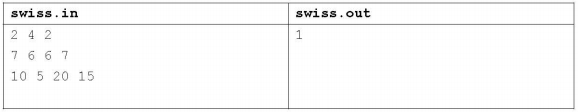
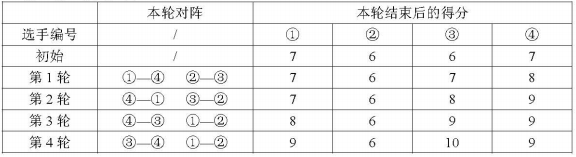
【输入输出样例说明】
【数据范围】
对于30%的数据,1≤N≤100;
对于50%的数据,1≤N≤10,000;
对于100% 的数据,1≤N≤100,000,1≤R≤50,1≤Q≤2N,0≤S1,S2, … ,S2N≤10⁸,l≤wi, w2, …,w2N≤10⁸。
#include<stdio.h>
#include<string.h>
#include<algorithm>
using namespace std;
const int maxm = 2e5 + 10;
struct node
{
int id;
int score;
int power;
}stu[maxm],w[maxm],l[maxm];
bool cmp(node a,node b)
{
if (a.score==b.score)
return a.id < b.id;
return a.score > b.score;
}
bool cmp2(int s1,int s2,int id1,int id2)
{
if (s1==s2)
return id1 < id2;
return s1 > s2;
}
void merge(int ll,int rr)
{
int l1 = ll,l2 = ll,k = ll;
while (l1<=rr && l2<=rr)
if (cmp2(w[l1].score,l[l2].score,w[l1].id,l[l2].id))
stu[k++] = w[l1++];
else stu[k++] = l[l2++];
while (l1<=rr) stu[k++] = w[l1++];
while (l2<=rr) stu[k++] = l[l2++];
}
int main()
{
int n,r,q,i;
scanf("%d %d %d",&n,&r,&q);
for (i=1;i<=2*n;i++)
{
scanf("%d",&stu[i].score);
stu[i].id = i;
}
for (i=1;i<=2*n;i++)
scanf("%d",&stu[i].power);
sort(stu+1,stu+2*n+1,cmp);
while (r--)
{
int lo = 0,wi = 0;
for (i=1;i<=2*n;i+=2)
{
if (stu[i].power>stu[i+1].power)
{
w[++wi] = stu[i];
l[++lo] = stu[i+1];
w[wi].score++;
}
else
{
l[++lo] = stu[i];
w[++wi] = stu[i+1];
w[wi].score++;
}
}
merge(1,n);
}
printf("%d\n",stu[q].id);
return 0;
}
表达式的值
【问题描述】
对于1位二进制变量定义两种运算:
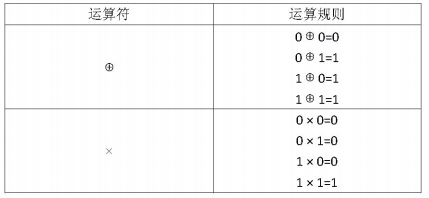
运算的优先级是:
1. 先计算括号内的,再计算括号外的。

现给定一个未完成的表达式,例如 +( * ),请你在横线处填入数字0或者1,请问有多少种填法可以使得表达式的值为0。
【输入】
输入文件名为exp.in,共2行。
第1行为一个整数L,表示给定的表达式中除去横线外{的运算符和括号的个数。
第2行为一个字符串包含L个字符,其中只包含’(’、’)’、²+’、”*这4种字符,其中’ (’、’)’是左右括号,’+’、’*’分别表示前面定义的运算符“田”和“×”。这行字符按顺序 给出了给定表达式中除去变量外的运算符和括号。
【输出】
输出文件exp.out共1行。包含一个整数,即所有的方案数。 注意:这个数可能会很大, 请输出方案数对10007取模后的结果。
【输入输出样例1】
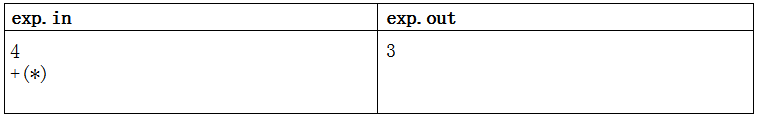
【输入输出样例说明】
给定的表达式包括横线字符之后为: +( * )
在横线位置填入(0、0、0)、(0、1、0)、(0、0、1)时,表达式的值均为0,所以共有3 种填法。
【数据范围】
对于20%的数据有O≤L≤10。
对于50%的数据有O≤L≤1,000。
对于70%的数据有O≤L≤10,000。
对于100%的数据有O≤L≤100,000。
对于50%的数据输入表达式中不含括号。
#include <bits/stdc++.h>
using namespace std;
const int MOD=10007;
int f[2][100005]; //每一位是0的可能性和是1的可能性
int main()
{
int len;
string c,pol=".";
cin>>len>>c;
stack<char> sta;
for(int i=0;i<len;i++)
{
if(c[i]=='(' || c[i]=='*')
sta.push(c[i]);
if(c[i]=='+')
{
while(!sta.empty() && sta.top()=='*')
{
pol+=sta.top();
sta.pop();
}
sta.push('+');
}
if(c[i]==')')
{
while(sta.top()!='(')
{
pol+=sta.top();
sta.pop();
}
sta.pop();
}
if(c[i]!='(' && c[i]!=')')
pol+='.';
}
while(!sta.empty())
{
pol+=sta.top();
sta.pop();
}
int j=0;
for(int i=0;i<(int)pol.length();i++)
{
if(pol[i]=='.')
{
j++;
f[0][j]=1;
f[1][j]=1;
}
if(pol[i]=='*')
{
j--;
f[0][j]=(f[0][j+1]*f[1][j]+f[0][j]*f[1][j+1]+f[0][j]*f[0][j+1])%MOD;
f[1][j]=(f[1][j]*f[1][j+1])%MOD;
}
if(pol[i]=='+')
{
j--;
f[1][j]=(f[0][j]*f[1][j+1]+f[0][j+1]*f[1][j]+f[1][j]*f[1][j+1])%MOD;
f[0][j]=(f[0][j]*f[0][j+1])%MOD;
}
}
cout<<f[0][j]<<endl; //f[0][1]
return 0;
}
扫雷游戏
【问题描述】
扫雷游戏是一款十分经典的单机小游戏。在 n 行 m 列的雷区中有一些格子含有地雷(称之为地雷格),其他格子不含地雷(称之为非地雷格)。玩家翻开一个非地雷格时,该格将会出现一个数字——提示周围格子中有多少个是地雷格。游戏的目标是在不翻出任何地雷格的条件下,找出所有的非地雷格。
现在给出n行m列的雷区中的地雷分布,要求计算出每个非地雷格周围的地雷格数。
注:一个格子的周围格子包括其上、下、左、右、左上、右上、左下、右下八个方向上与之直接相邻的格子。
【输入格式】
输入文件名为 mine.in。
输入文件第一行是用一个空格隔开的两个整数n和m,分别表示雷区的行数和列数。
接下来 n 行,每行 m 个字符,描述了雷区中的地雷分布情况。字符’*’表示相应格子是地雷格,字符’?’表示相应格子是非地雷格。相邻字符之间无分隔符。
【输出格式】
输出文件名为 mine.out。
输出文件包含 n 行,每行 m 个字符,描述整个雷区。用’*’表示地雷格,用周围的地雷个数表示非地雷格。相邻字符之间无分隔符。
【输入输出样例 1】
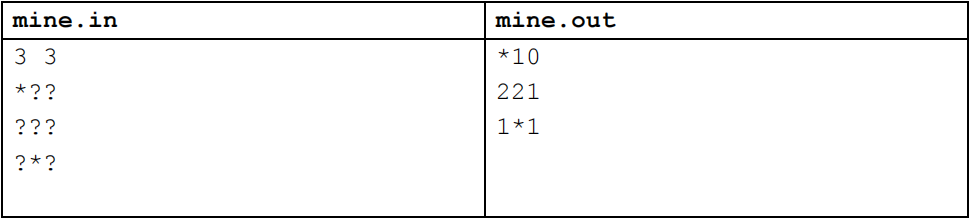
【输入输出样例 2】
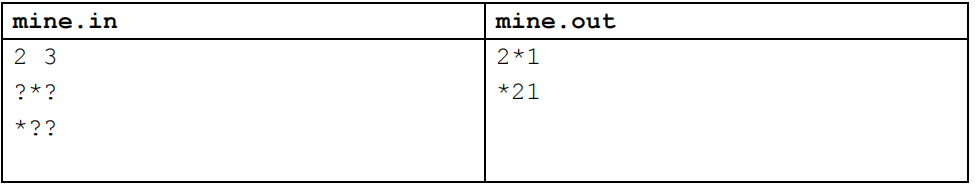
【数据说明】
对于 100%的数据,1≤n≤100,1≤m≤100。
#include <iostream>
using namespace std;
int main(){
int n,m,cnt=0;
char a[102][102];
cin>>n>>m;
for(int i=0;i<n;i++){
for(int j=0;j<m;j++){
cin>>a[i][j];
}
}
for(int i=0;i<n;i++){
for(int j=0;j<m;j++){
if(a[i][j]!='*'){
if(a[i-1][j-1]=='*') cnt++;
if(a[i-1][j]=='*') cnt++;
if(a[i-1][j+1]=='*') cnt++;
if(a[i][j-1]=='*') cnt++;
if(a[i][j+1]=='*') cnt++;
if(a[i+1][j-1]=='*') cnt++;
if(a[i+1][j]=='*') cnt++;
if(a[i+1][j+1]=='*') cnt++;
cout<<cnt;
cnt=0;
}
else{
cout<<"*";
}
}
cout<<" "<<endl;
}
return 0;
}
推销员
【问题描述】
阿明是一名推销员,他奉命到螺丝街推销他们公司的产品。螺丝街是一条死胡同,出口与入口是同一个,街道的一侧是围墙,另一侧是住户。螺丝街一共有 N 家住户,第 i 家住户到入口的距离为 Si 米。由于同一栋房子里可以有多家住户,所以可能有多家住户与入口的距离相等。阿明会从入口进入,依次向螺丝街的 X 家住户推销产品,然后再原路走出去。
阿明每走 1 米就会积累 1 点疲劳值,向第 i 家住户推销产品会积累 Ai点疲劳值。阿明是工作狂,他想知道,对于不同的 X,在不走多余的路的前提下,他最多可以积累多少点疲劳值。
【输入格式】
输入文件名为 salesman.in。
第一行有一个正整数 N,表示螺丝街住户的数量。
接下来的一行有 N 个正整数,其中第 i 个整数 Si表示第 i 家住户到入口的距离。数据保证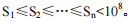
接下来的一行有 N 个正整数,其中第 i 个整数 Ai表示向第 i 户住户推销产品会积累的疲劳值。数据保证
【输出格式】
输出文件名为 salesman.out。
输出 N 行,每行一个正整数,第 i 行整数表示当 X=i 时,阿明最多积累的疲劳值。
【输入输出样例 1】
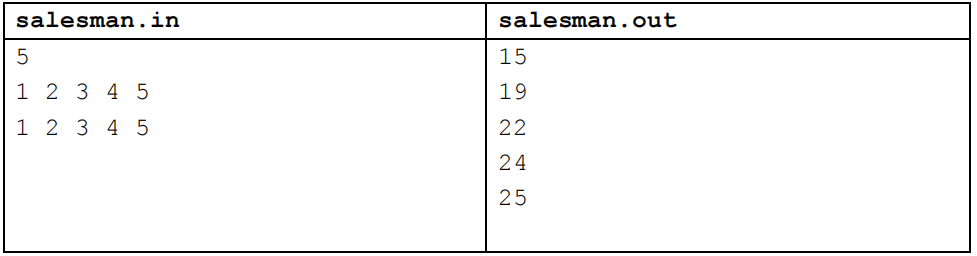
【输入输出样例 1 说明】
X=1: 向住户 5 推销,往返走路的疲劳值为 5+5,推销的疲劳值为 5,总疲劳值为15。
X=2: 向住户 4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值为 4+5,总疲劳值为 5+5+4+5=19。
X=3: 向住户 3、4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值 3+4+5,总疲劳值为 5+5+3+4+5=22。
X=4: 向住户 2、3、4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值 2+3+4+5,总疲劳值 5+5+2+3+4+5=24。
X=5: 向住户 1、2、3、4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值 1+2+3+4+5,总疲劳值 5+5+1+2+3+4+5=25。
【输入输出样例 2】
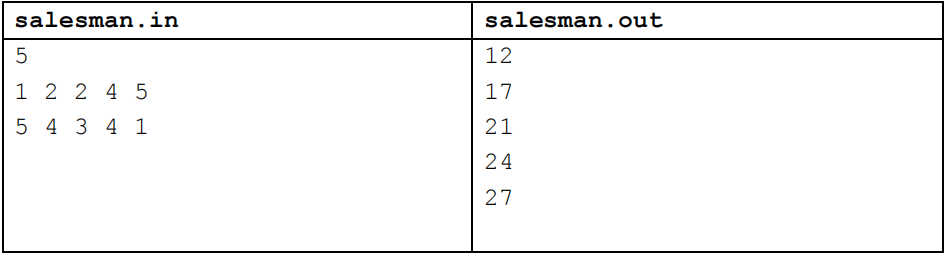
【输入输出样例 2 说明】
X=1:向住户 4 推销,往返走路的疲劳值为 4+4,推销的疲劳值为 4,总疲劳值 4+4+4=12。
X=2:向住户 1、4 推销,往返走路的疲劳值为 4+4,推销的疲劳值为 5+4,总疲劳值4+4+5+4=17。
X=3:向住户 1、2、4 推销,往返走路的疲劳值为 4+4,推销的疲劳值为 5+4+4,总疲劳值 4+4+5+4+4=21。
X=4:向住户 1、2、3、4 推销,往返走路的疲劳值为 4+4,推销的疲劳值为 5+4+3+4,总疲劳值 4+4+5+4+3+4=24。或者向住户 1、2、4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值为 5+4+4+1,总疲劳值 5+5+5+4+4+1=24。
X=5:向住户 1、2、3、4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值为 5+4+3+4+1,总疲劳值 5+5+5+4+3+4+1=27。
【数据说明】
对于 20%的数据,1≤N≤20;
对于 40%的数据,1≤N≤100;
对于 60%的数据,1≤N≤1000;
对于 100%的数据,1≤N≤100000。
#include<bits/stdc++.h>
struct pl{
int s,val;
}a[100005];
int maxx,j,k,ans;
using namespace std;
bool cmp(pl x,pl y)
{
return x.val>y.val;
}
int main()
{
int n;
scanf("%d",&n);
for (int i=1;i<=n;i++)
{
scanf("%d",&a[i].s);
}
for (int i=1;i<=n;i++)
{
scanf("%d",&a[i].val);
}
sort(a+1,a+n+1,cmp);
for (int i=1;i<=n;i++)
if (2*a[i].s+a[i].val>maxx)
{
maxx=2*a[i].s+a[i].val;
j=k=i;
}
ans+=maxx;
printf("%d\n",ans);
for (int i=1;i<=n;i++)
{
if (i==k)
{
continue;
}
if (a[j].s<a[i].s)
{
ans=ans-2*a[j].s+2*a[i].s+a[i].val;
j=i;
printf("%d\n",ans);
}
else
{
ans+=a[i].val;
printf("%d\n",ans);
}
}
return 0;
}
螺旋矩阵
【问题描述】
一个 n 行 n 列的螺旋矩阵可由如下方法生成:
从矩阵的左上角(第 1 行第 1 列)出发,初始时向右移动;如果前方是未曾经过的格子,则继续前进,否则右转;重复上述操作直至经过矩阵中所有格子。根据经过顺序,在格子中依次填入 1, 2, 3, ... , ,便构成了一个螺旋矩阵。
下图是一个 n = 4 时的螺旋矩阵。
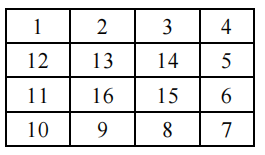
现给出矩阵大小 n 以及 i 和 j,请你求出该矩阵中第 i 行第 j 列的数是多少。
【输入】
输入文件名为 matrix.in。
输入共一行,包含三个整数 n,i,j,每两个整数之间用一个空格隔开,分别表示矩阵大小、待求的数所在的行号和列号。
【输出】
输出文件名为 matrix.out。
输出共一行,包含一个整数,表示相应矩阵中第 i 行第 j 列的数。
【输入输出样例】
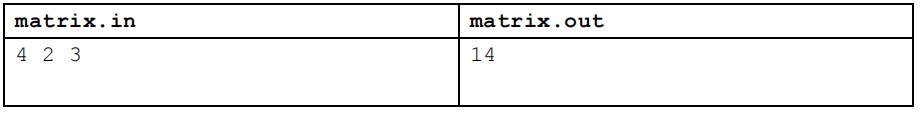
【数据说明】
对于 50%的数据,1 ≤ n ≤ 100;
对于 100%的数据,1 ≤ n ≤ 30,000,1 ≤ i ≤ n,1 ≤ j ≤ n。
#include<stdio.h>
#include<stdlib.h>
#include<string.h>
#include<algorithm>
int main()
{
freopen("matrix.in","r",stdin);
freopen("matrix.out","w",stdout);
int n,i,j;
scanf("%d %d %d",&n,&i,&j);
int x=j,y=i;
int a=n/2;
if(n%2==0)//判断该数属于第几行
{
if(x>a)
x=1+(n-x);
if(y>a)
y=1+(n-y);
}
else
{
if(x>a+1)
x=1+(n-x);
if(y>a+1)
y=1+(n-y);
}
int ceng=x<y?x:y;
x=1;y=1;
int p=1;
for(int m=1;m<ceng;m++)
{
p+=4*(n-1);
n-=2;
x++;
y++;
}
if(y==i)
{
p+=j-x;
printf("%d",p);
return 0;
}
p+=n-1;
x+=n-1;
if(x==j)
{
p+=i-y;
printf("%d",p);
return 0;
}
p+=n-1;
y+=n-1;
if(y==i)
{
p+=x-j;
printf("%d",p);
return 0;
}
p+=n-1;
x-=n-1;
if(x==j)
{
p+=y-i;
printf("%d",p);
return 0;
}
return 0;
}
子矩阵
【问题描述】
给出如下定义:
1. 子矩阵:从一个矩阵当中选取某些行和某些列交叉位置所组成的新矩阵(保持行与列的相对顺序)被称为原矩阵的一个子矩阵。
例如,下面左图中选取第 2、4 行和第 2、4、5 列交叉位置的元素得到一个 2*3 的子矩阵如右图所示。
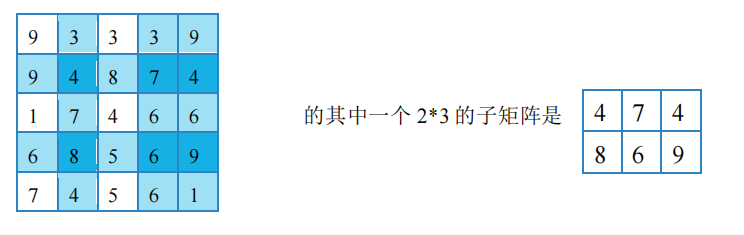
2. 相邻的元素:矩阵中的某个元素与其上下左右四个元素(如果存在的话)是相邻的。
3. 矩阵的分值:矩阵中每一对相邻元素之差的绝对值之和。
本题任务:给定一个 n 行 m 列的正整数矩阵,请你从这个矩阵中选出一个 r 行 c 列的子矩阵,使得这个子矩阵的分值最小,并输出这个分值。
【输入】
输入文件名为 submatrix.in。
第一行包含用空格隔开的四个整数 n,m,r,c,意义如问题᧿述中所述,每两个整数之间用一个空格隔开。
接下来的 n 行,每行包含 m 个用空格隔开的整数,用来表示问题᧿述中那个 n 行 m 列的矩阵。
【输出】
输出文件名为 submatrix.out。
输出共 1 行,包含 1 个整数,表示满足题目描述的子矩阵的最小分值。
【输入输出样例 1】
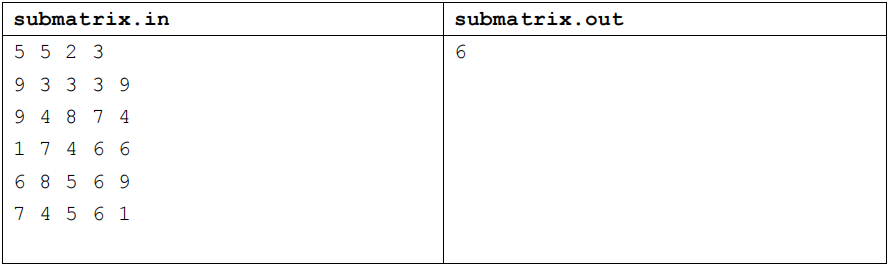
【输入输出样例 1 说明】
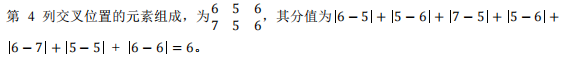
该矩阵中分值最小的 2 行 3 列的子矩阵由原矩阵的第 4 行、第 5 行与第 1 列、第 3 列、
【输入输出样例 2】
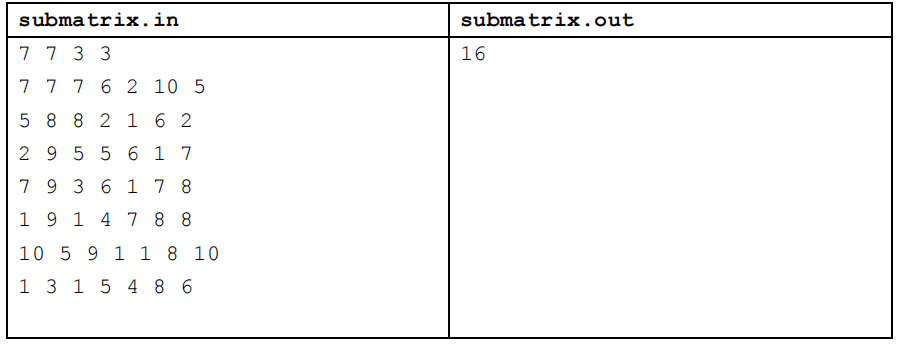
【输入输出样例 2 说明】
该矩阵中分值最小的 3 行 3 列的子矩阵由原矩阵的第 4 行、第 5 行、第 6 行与第 2 列、第 6 列、第 7 列交叉位置的元素组成,选取的分值最小的子矩阵为
【数据说明】
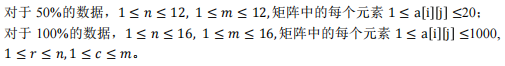
#include<bits/stdc++.h>
using namespace std;
const int N = 20;
int n, m, r, c;
int num[N][N], ch[N], gs = 1;
int lc[N], hc[N][N];
int f[N][N];
/*
具体思路:
首先想到暴力方法
枚举每个rc大小的矩阵,然后计算差值和,但复杂度过高
需要优化:
首先枚举n行中的r行
利用dfs()枚举每种可能,当dfs()进行到已经不能完成r行时停止
预处理选出来的r行每一列之间的行与行的差值和即lc[i]
在预处理c列中任意两列之间的差值和即hc[i][j] 第i列和第j列的差值和
利用线性dp处理即可
f[i][j]表示前i列中选j列的最小值(选第j列)
f[i][j] = min(f[i][j], f[k][j - 1] + lc[i] + hc[i][k])
*/
void Init()
{
for(int i = 1; i <= m; i++)
{
lc[i] = 0;
for(int j = 1; j < r; j++)
{
lc[i] += abs(num[ch[j]][i] - num[ch[j + 1]][i]);//
}
}
for(int i = 2; i <= m; i++)
{
for(int j = 1; j < i; j++)
{
hc[i][j] = 0; //第i列减第j列的中r行的差值差值
for(int k = 1; k <= r; k++)
{
hc[i][j] += abs(num[ch[k]][i] - num[ch[k]][j]);
}
}
}
}
int minn = 2e9;
int cmin;
void dp()
{
for(int i = 1; i <= m; i++) //前i行
{
cmin = min(i, c);
for(int j = 1; j <= cmin; j++)//选j行
{
if(j == 1)
f[i][j] = lc[i];
else
{
if(i == j)
{
f[i][j] = f[i - 1][j - 1] + lc[i] + hc[i][j - 1];
}
else
{
f[i][j] = 2e8;
for(int k = j - 1; k < i; k++)
{
f[i][j] = min(f[i][j], f[k][j - 1] + lc[i] + hc[i][k]);
}
}
}
if(j == c) minn = min(minn, f[i][c]);//前i列选c列
}
}
}
void dfs(int node)
{
if(node > n)
{
Init();
dp();
return;
}
if(r - gs + 1 == n - node + 1)//已经取地行数还没取得行数 优化剪枝
{
ch[gs ++] = node;
dfs(node + 1);
ch[gs --] = 0;
return;
}
dfs(node + 1);
if(gs <= r)
{
ch[gs ++] = node;
dfs(node + 1);
ch[gs --];
}
}
int main()
{
cout << 2<<20 << e
scanf("%d%d%d%d", &n, &m, &r, &c);
for(int i = 1; i <= n; i++)
for(int j = 1; j <= m; j++)
scanf("%d", &num[i][j]);
dfs(1);
printf("%d", minn);
return 0;
}
记数问题
【问题描述】
试计算在区间 1 到 n 的所有整数中,数字 x(0 ≤ x ≤ 9)共出现了多少次?例如,在 1到 11 中,即在 1、2、3、4、5、6、7、8、9、10、11 中,数字 1 出现了 4 次。
【输入】
输入文件名为 count.in。
输入共 1 行,包含 2 个整数 n、x,之间用一个空格隔开。
【输出】
输出文件名为 count.out。
输出共 1 行,包含一个整数,表示 x 出现的次数。
【输入输出样例】
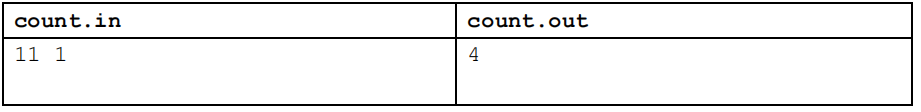
【数据说明】
对于 100%的数据,1≤ n ≤ 1,000,000,0 ≤ x ≤ 9。
#include<iostream>
using namespace std;
int main()
{
long long n,i,x,b,c,t=0;
cin>>n>>x;//输入范围与要查的数字;
for(i=1;i<=n;i++)//一到n进行循环;
{
b=i;//为了不改变i的值,就把i赋值给一个数;
while(b!=0)//如果b不等于0,继续循环;
{
c=b%10;//求是否是x,是的话计数器加一;
b=b/10;//求下一个数字是否为x;
if(c==x) t++;计数器加一;
}
}
cout<<t<<endl;//输出计数器的数字;
return 0;//结束
}
表达式求值
【问题描述】
给定一个只包含加法和乘法的算术表达式,请你编程计算表达式的值。
【输入】
输入文件为 expr.in。
输入仅有一行,为需要你计算的表达式,表达式中只包含数字、加法运算符“+”和乘法运算符“*”,且没有括号,所有参与运算的数字均为 0 到 之间的整数。输入数据保证这一行只有 0~ 9、+、*这 12 种字符。
【输出】
输出文件名为 expr.out。
输出只有一行,包含一个整数,表示这个表达式的值。注意:当答案长度多于 4 位时,请只输出最后 4 位,前导 0 不输出。
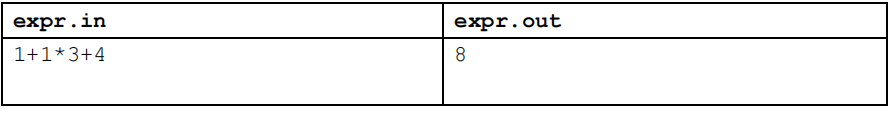
【输入输出样例 1】
【输入输出样例 2】
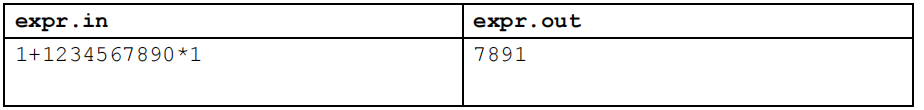
【输入输出样例 3】
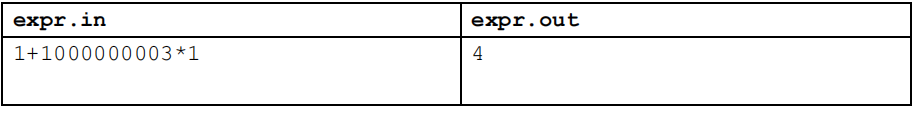
【输入输出样例说明】
样例 1 计算的结果为 8,直接输出 8。
样例 2 计算的结果为 1234567891,输出后 4 位,即 7891。
样例 3 计算的结果为 1000000004,输出后 4 位,即 4。
【数据范围】
对于 30%的数据,0≤表达式中加法运算符和乘法运算符的总数≤100;
对于 80%的数据,0≤表达式中加法运算符和乘法运算符的总数≤1000;
对于 100%的数据,0≤表达式中加法运算符和乘法运算符的总数≤100000。
#include<cstdio>
#include<iostream>
using namespace std;
int sum=0,num,tmp; //定义和,要操作的数,临时数
int main()
{
char op; //定义操作符
scanf("%d",&num); //首先读入一个数字,之后就是一个符号和一个数字的格式
while(scanf("%c",&op) && op !='\n') //没有遇到回车符就继续读入
{
scanf("%d",&tmp); //读入第二个数,根据上面的符号进行下面的操作
if(op == '+')
{
sum=(sum+num)%10000; //遇到加号就加上上一段的值,
num=tmp; //将每次读入的数 赋值给num
}
else //除了加号就是乘号
{
num=(num*tmp)%10000; //遇到乘号先把两个数乘起来
}
}
sum=(sum+num)%10000; //因为我们每次都是先读取符号再操作上一步的值,所以要加上最后一步操作的值。
printf("%d",sum);
return 0;
}