信息学奥赛-入门级 题库
推销员
【问题描述】
阿明是一名推销员,他奉命到螺丝街推销他们公司的产品。螺丝街是一条死胡同,出口与入口是同一个,街道的一侧是围墙,另一侧是住户。螺丝街一共有 N 家住户,第 i 家住户到入口的距离为 Si 米。由于同一栋房子里可以有多家住户,所以可能有多家住户与入口的距离相等。阿明会从入口进入,依次向螺丝街的 X 家住户推销产品,然后再原路走出去。
阿明每走 1 米就会积累 1 点疲劳值,向第 i 家住户推销产品会积累 Ai点疲劳值。阿明是工作狂,他想知道,对于不同的 X,在不走多余的路的前提下,他最多可以积累多少点疲劳值。
【输入格式】
输入文件名为 salesman.in。
第一行有一个正整数 N,表示螺丝街住户的数量。
接下来的一行有 N 个正整数,其中第 i 个整数 Si表示第 i 家住户到入口的距离。数据保证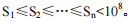
接下来的一行有 N 个正整数,其中第 i 个整数 Ai表示向第 i 户住户推销产品会积累的疲劳值。数据保证
【输出格式】
输出文件名为 salesman.out。
输出 N 行,每行一个正整数,第 i 行整数表示当 X=i 时,阿明最多积累的疲劳值。
【输入输出样例 1】
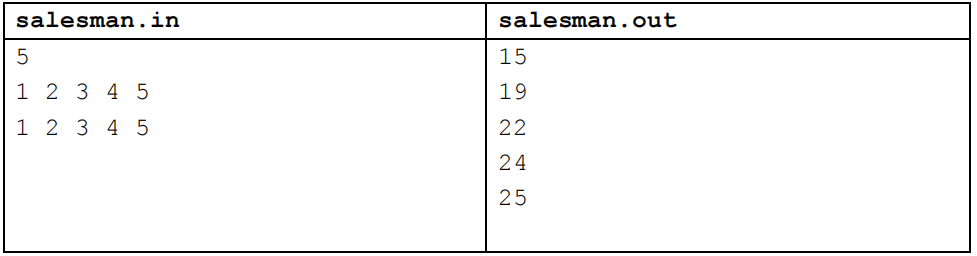
【输入输出样例 1 说明】
X=1: 向住户 5 推销,往返走路的疲劳值为 5+5,推销的疲劳值为 5,总疲劳值为15。
X=2: 向住户 4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值为 4+5,总疲劳值为 5+5+4+5=19。
X=3: 向住户 3、4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值 3+4+5,总疲劳值为 5+5+3+4+5=22。
X=4: 向住户 2、3、4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值 2+3+4+5,总疲劳值 5+5+2+3+4+5=24。
X=5: 向住户 1、2、3、4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值 1+2+3+4+5,总疲劳值 5+5+1+2+3+4+5=25。
【输入输出样例 2】
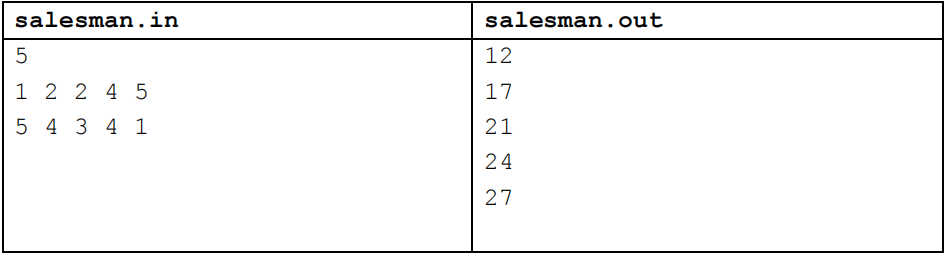
【输入输出样例 2 说明】
X=1:向住户 4 推销,往返走路的疲劳值为 4+4,推销的疲劳值为 4,总疲劳值 4+4+4=12。
X=2:向住户 1、4 推销,往返走路的疲劳值为 4+4,推销的疲劳值为 5+4,总疲劳值4+4+5+4=17。
X=3:向住户 1、2、4 推销,往返走路的疲劳值为 4+4,推销的疲劳值为 5+4+4,总疲劳值 4+4+5+4+4=21。
X=4:向住户 1、2、3、4 推销,往返走路的疲劳值为 4+4,推销的疲劳值为 5+4+3+4,总疲劳值 4+4+5+4+3+4=24。或者向住户 1、2、4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值为 5+4+4+1,总疲劳值 5+5+5+4+4+1=24。
X=5:向住户 1、2、3、4、5 推销,往返走路的疲劳值为 5+5,推销的疲劳值为 5+4+3+4+1,总疲劳值 5+5+5+4+3+4+1=27。
【数据说明】
对于 20%的数据,1≤N≤20;
对于 40%的数据,1≤N≤100;
对于 60%的数据,1≤N≤1000;
对于 100%的数据,1≤N≤100000。
#include<bits/stdc++.h>
struct pl{
int s,val;
}a[100005];
int maxx,j,k,ans;
using namespace std;
bool cmp(pl x,pl y)
{
return x.val>y.val;
}
int main()
{
int n;
scanf("%d",&n);
for (int i=1;i<=n;i++)
{
scanf("%d",&a[i].s);
}
for (int i=1;i<=n;i++)
{
scanf("%d",&a[i].val);
}
sort(a+1,a+n+1,cmp);
for (int i=1;i<=n;i++)
if (2*a[i].s+a[i].val>maxx)
{
maxx=2*a[i].s+a[i].val;
j=k=i;
}
ans+=maxx;
printf("%d\n",ans);
for (int i=1;i<=n;i++)
{
if (i==k)
{
continue;
}
if (a[j].s<a[i].s)
{
ans=ans-2*a[j].s+2*a[i].s+a[i].val;
j=i;
printf("%d\n",ans);
}
else
{
ans+=a[i].val;
printf("%d\n",ans);
}
}
return 0;
}
珠心算测验
【问题描述】
珠心算是一种通过在脑中模拟算盘变化来完成快速运算的一种计算技术。珠心算训练,既能够开发智力,又能够为日常生活带来很多便利,因而在很多学校得到普及。
某学校的珠心算老师采用一种快速考察珠心算加法能力的测验方法。他随机生成一个正整数集合,集合中的数各不相同,然后要求学生回答:其中有多少个数,恰好等于集合中另外两个(不同的)数之和?
最近老师出了一些测验题,请你帮忙求出答案。
【输入】
输入文件名为 count.in。
输入共两行,第一行包含一个整数 n,表示测试题中给出的正整数个数。
第二行有 n 个正整数,每两个正整数之间用一个空格隔开,表示测试题中给出的正整数。
【输出】
输出文件名为 count.out。
输出共一行,包含一个整数,表示测验题答案。
【输入输出样例】
【样例说明】
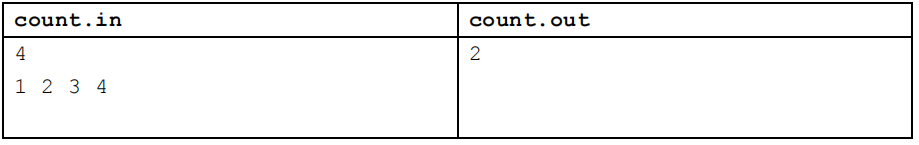
由 1+2=3,1+3=4,故满足测试要求的答案为 2。注意,加数和被加数必须是集合中的两个不同的数。
【数据说明】
对于 100%的数据,3 ≤ n ≤ 100,测验题给出的正整数大小不超过 10,000。
#include <bits/stdc++.h>
#define MAXN 1e6+2
#define inf 0x3f3f3f3f
#define rep(x, a, b) for(int x=a; x<=b; x++)
#define per(x, a, b) for(int x=a; x>=b; x--)
using namespace std;
const int NC = 1e5+2;
//queue<int> que;
int num[200];
int cot;
int n;
bool visit[200];
int main()
{
cin>>n;
rep(i, 1, n)
{
cin>>num[i];
}
sort(num+1, num+1+n);
rep(i, 1, n)
{
rep(j, i+1, n)
{
if(num[i] != num[j])
{
rep(k, j+1, n)
{
if(num[i]+num[j] == num[k] && !visit[k])
{
cot++;
visit[k] = true;
}
}
}
}
}
cout<<cot;
return 0;
}
比例简化
【问题描述】
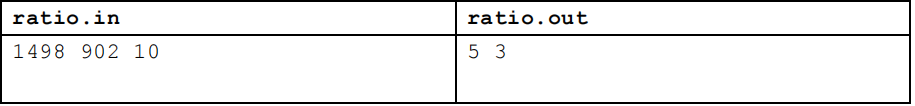
在社交媒体上,经常会看到针对某一个观点同意与否的民意调查以及结果。例如,对某一观点表示支持的有 1498 人,反对的有 902 人,那么赞同与反对的比例可以简单的记为1498:902。
不过,如果把调查结果就以这种方式呈现出来,大多数人肯定不会满意。因为这个比例的数值太大,难以一眼看出它们的关系。对于上面这个例子,如果把比例记为 5:3,虽然与真实结果有一定的误差,但依然能够较为准确地反映调查结果,同时也显得比较直观。
现给出支持人数 A,反对人数 B,以及一个上限 L,请你将 A 比 B 化简为 A’比 B’,要求在 A’和 B’均不大于 L 且 A’和 B’互质(两个整数的最大公约数是 1)的前ᨀ下,A’/B’ ≥ A/B且 A’/B’ - A/B 的值尽可能小。
【输入】
输入文件名为 ratio.in。
输入共一行,包含三个整数 A,B,L,每两个整数之间用一个空格隔开,分别表示支持人数、反对人数以及上限。
【输出】
输出文件名为 ratio.out。
输出共一行,包含两个整数 A’,B’,中间用一个空格隔开,表示化简后的比例。
【输入输出样例】
【数据说明】
对于 100%的数据,1 ≤ A ≤ 1,000,000,1 ≤ B ≤ 1,000,000,1 ≤ L ≤ 100,A/B ≤ L。
#include <iostream>
#include <cstdio>
#include <string>
#include <queue>
#include <cstring>
#include <cmath>
#include <cctype>
#include <vector>
#include <algorithm>
#include <map>
#include <stack>
using namespace std;
typedef long long ll;
typedef pair<int,int> pa;
const int N=100005;
const int mod=99999997;
int x,y,l;
int a,b;
int gcd(int x,int y)
{
if(x<y) return gcd(y,x);
if(y==0) return x;
return gcd(y,x%y);
}
int main()
{
scanf("%d%d%d",&x,&y,&l);
double t1,t2,t3;
t1=x*1.0/y;
t3=l*1.0;
for(int i=1;i<=l;i++)
{
for(int k=1;k<=l;k++)
{
t2=i*1.0/k;
if(t2>=t1 &&gcd(i,k)==1 && t2-t1<t3)
{
a=i;
b=k;
t3=t2-t1;
}
}
}
printf("%d %d\n",a,b);
return 0;
}
螺旋矩阵
【问题描述】
一个 n 行 n 列的螺旋矩阵可由如下方法生成:
从矩阵的左上角(第 1 行第 1 列)出发,初始时向右移动;如果前方是未曾经过的格子,则继续前进,否则右转;重复上述操作直至经过矩阵中所有格子。根据经过顺序,在格子中依次填入 1, 2, 3, ... , ,便构成了一个螺旋矩阵。
下图是一个 n = 4 时的螺旋矩阵。
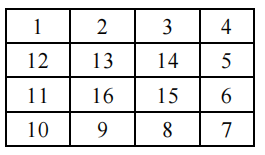
现给出矩阵大小 n 以及 i 和 j,请你求出该矩阵中第 i 行第 j 列的数是多少。
【输入】
输入文件名为 matrix.in。
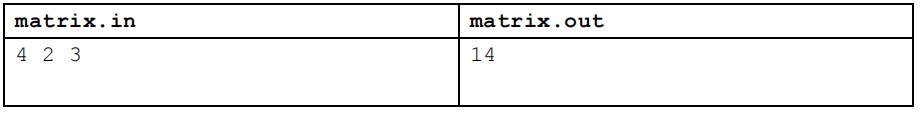
输入共一行,包含三个整数 n,i,j,每两个整数之间用一个空格隔开,分别表示矩阵大小、待求的数所在的行号和列号。
【输出】
输出文件名为 matrix.out。
输出共一行,包含一个整数,表示相应矩阵中第 i 行第 j 列的数。
【输入输出样例】
【数据说明】
对于 50%的数据,1 ≤ n ≤ 100;
对于 100%的数据,1 ≤ n ≤ 30,000,1 ≤ i ≤ n,1 ≤ j ≤ n。
#include<stdio.h>
#include<stdlib.h>
#include<string.h>
#include<algorithm>
int main()
{
freopen("matrix.in","r",stdin);
freopen("matrix.out","w",stdout);
int n,i,j;
scanf("%d %d %d",&n,&i,&j);
int x=j,y=i;
int a=n/2;
if(n%2==0)//判断该数属于第几行
{
if(x>a)
x=1+(n-x);
if(y>a)
y=1+(n-y);
}
else
{
if(x>a+1)
x=1+(n-x);
if(y>a+1)
y=1+(n-y);
}
int ceng=x<y?x:y;
x=1;y=1;
int p=1;
for(int m=1;m<ceng;m++)
{
p+=4*(n-1);
n-=2;
x++;
y++;
}
if(y==i)
{
p+=j-x;
printf("%d",p);
return 0;
}
p+=n-1;
x+=n-1;
if(x==j)
{
p+=i-y;
printf("%d",p);
return 0;
}
p+=n-1;
y+=n-1;
if(y==i)
{
p+=x-j;
printf("%d",p);
return 0;
}
p+=n-1;
x-=n-1;
if(x==j)
{
p+=y-i;
printf("%d",p);
return 0;
}
return 0;
}
子矩阵
【问题描述】
给出如下定义:
1. 子矩阵:从一个矩阵当中选取某些行和某些列交叉位置所组成的新矩阵(保持行与列的相对顺序)被称为原矩阵的一个子矩阵。
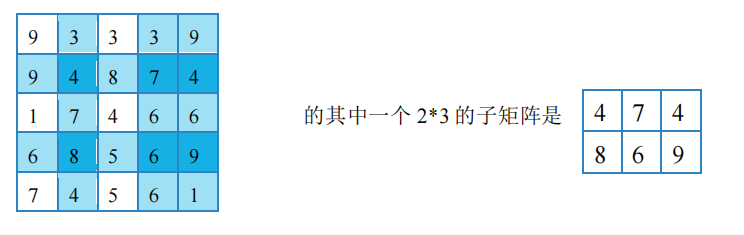
例如,下面左图中选取第 2、4 行和第 2、4、5 列交叉位置的元素得到一个 2*3 的子矩阵如右图所示。
2. 相邻的元素:矩阵中的某个元素与其上下左右四个元素(如果存在的话)是相邻的。
3. 矩阵的分值:矩阵中每一对相邻元素之差的绝对值之和。
本题任务:给定一个 n 行 m 列的正整数矩阵,请你从这个矩阵中选出一个 r 行 c 列的子矩阵,使得这个子矩阵的分值最小,并输出这个分值。
【输入】
输入文件名为 submatrix.in。
第一行包含用空格隔开的四个整数 n,m,r,c,意义如问题᧿述中所述,每两个整数之间用一个空格隔开。
接下来的 n 行,每行包含 m 个用空格隔开的整数,用来表示问题᧿述中那个 n 行 m 列的矩阵。
【输出】
输出文件名为 submatrix.out。
输出共 1 行,包含 1 个整数,表示满足题目描述的子矩阵的最小分值。
【输入输出样例 1】
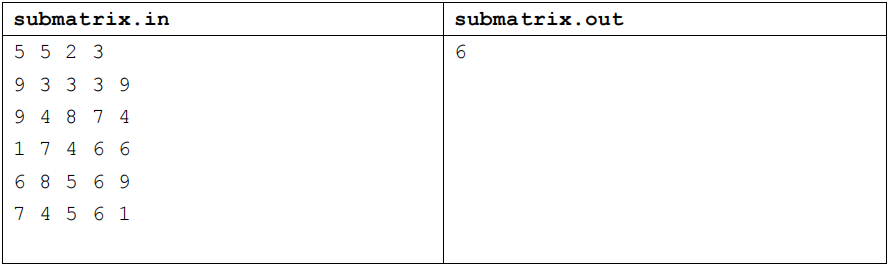
【输入输出样例 1 说明】
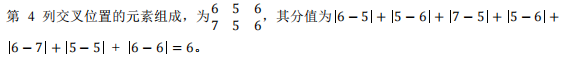
该矩阵中分值最小的 2 行 3 列的子矩阵由原矩阵的第 4 行、第 5 行与第 1 列、第 3 列、
【输入输出样例 2】
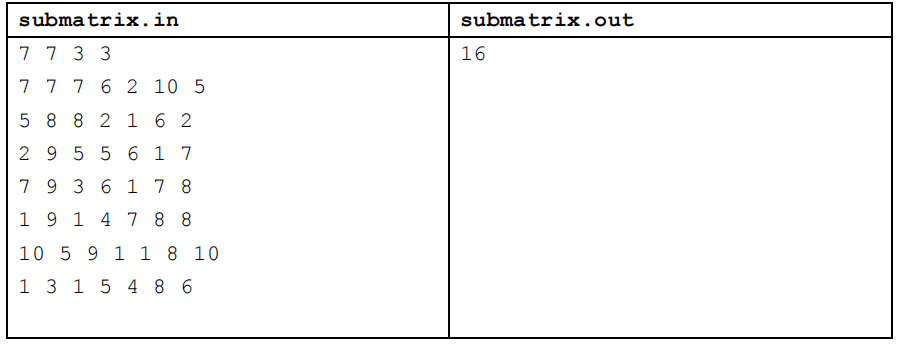
【输入输出样例 2 说明】
该矩阵中分值最小的 3 行 3 列的子矩阵由原矩阵的第 4 行、第 5 行、第 6 行与第 2 列、第 6 列、第 7 列交叉位置的元素组成,选取的分值最小的子矩阵为
【数据说明】
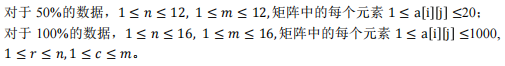
#include<bits/stdc++.h>
using namespace std;
const int N = 20;
int n, m, r, c;
int num[N][N], ch[N], gs = 1;
int lc[N], hc[N][N];
int f[N][N];
/*
具体思路:
首先想到暴力方法
枚举每个rc大小的矩阵,然后计算差值和,但复杂度过高
需要优化:
首先枚举n行中的r行
利用dfs()枚举每种可能,当dfs()进行到已经不能完成r行时停止
预处理选出来的r行每一列之间的行与行的差值和即lc[i]
在预处理c列中任意两列之间的差值和即hc[i][j] 第i列和第j列的差值和
利用线性dp处理即可
f[i][j]表示前i列中选j列的最小值(选第j列)
f[i][j] = min(f[i][j], f[k][j - 1] + lc[i] + hc[i][k])
*/
void Init()
{
for(int i = 1; i <= m; i++)
{
lc[i] = 0;
for(int j = 1; j < r; j++)
{
lc[i] += abs(num[ch[j]][i] - num[ch[j + 1]][i]);//
}
}
for(int i = 2; i <= m; i++)
{
for(int j = 1; j < i; j++)
{
hc[i][j] = 0; //第i列减第j列的中r行的差值差值
for(int k = 1; k <= r; k++)
{
hc[i][j] += abs(num[ch[k]][i] - num[ch[k]][j]);
}
}
}
}
int minn = 2e9;
int cmin;
void dp()
{
for(int i = 1; i <= m; i++) //前i行
{
cmin = min(i, c);
for(int j = 1; j <= cmin; j++)//选j行
{
if(j == 1)
f[i][j] = lc[i];
else
{
if(i == j)
{
f[i][j] = f[i - 1][j - 1] + lc[i] + hc[i][j - 1];
}
else
{
f[i][j] = 2e8;
for(int k = j - 1; k < i; k++)
{
f[i][j] = min(f[i][j], f[k][j - 1] + lc[i] + hc[i][k]);
}
}
}
if(j == c) minn = min(minn, f[i][c]);//前i列选c列
}
}
}
void dfs(int node)
{
if(node > n)
{
Init();
dp();
return;
}
if(r - gs + 1 == n - node + 1)//已经取地行数还没取得行数 优化剪枝
{
ch[gs ++] = node;
dfs(node + 1);
ch[gs --] = 0;
return;
}
dfs(node + 1);
if(gs <= r)
{
ch[gs ++] = node;
dfs(node + 1);
ch[gs --];
}
}
int main()
{
cout << 2<<20 << e
scanf("%d%d%d%d", &n, &m, &r, &c);
for(int i = 1; i <= n; i++)
for(int j = 1; j <= m; j++)
scanf("%d", &num[i][j]);
dfs(1);
printf("%d", minn);
return 0;
}
记数问题
【问题描述】
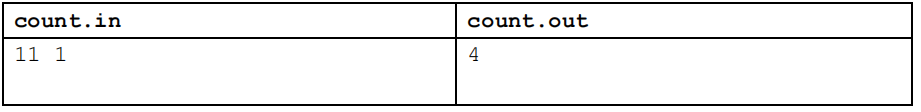
试计算在区间 1 到 n 的所有整数中,数字 x(0 ≤ x ≤ 9)共出现了多少次?例如,在 1到 11 中,即在 1、2、3、4、5、6、7、8、9、10、11 中,数字 1 出现了 4 次。
【输入】
输入文件名为 count.in。
输入共 1 行,包含 2 个整数 n、x,之间用一个空格隔开。
【输出】
输出文件名为 count.out。
输出共 1 行,包含一个整数,表示 x 出现的次数。
【输入输出样例】
【数据说明】
对于 100%的数据,1≤ n ≤ 1,000,000,0 ≤ x ≤ 9。
#include<iostream>
using namespace std;
int main()
{
long long n,i,x,b,c,t=0;
cin>>n>>x;//输入范围与要查的数字;
for(i=1;i<=n;i++)//一到n进行循环;
{
b=i;//为了不改变i的值,就把i赋值给一个数;
while(b!=0)//如果b不等于0,继续循环;
{
c=b%10;//求是否是x,是的话计数器加一;
b=b/10;//求下一个数字是否为x;
if(c==x) t++;计数器加一;
}
}
cout<<t<<endl;//输出计数器的数字;
return 0;//结束
}
表达式求值
【问题描述】
给定一个只包含加法和乘法的算术表达式,请你编程计算表达式的值。
【输入】
输入文件为 expr.in。
输入仅有一行,为需要你计算的表达式,表达式中只包含数字、加法运算符“+”和乘法运算符“*”,且没有括号,所有参与运算的数字均为 0 到 之间的整数。输入数据保证这一行只有 0~ 9、+、*这 12 种字符。
【输出】
输出文件名为 expr.out。
输出只有一行,包含一个整数,表示这个表达式的值。注意:当答案长度多于 4 位时,请只输出最后 4 位,前导 0 不输出。
【输入输出样例 1】
【输入输出样例 2】
【输入输出样例 3】
【输入输出样例说明】
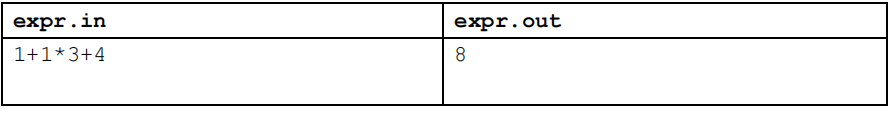
样例 1 计算的结果为 8,直接输出 8。
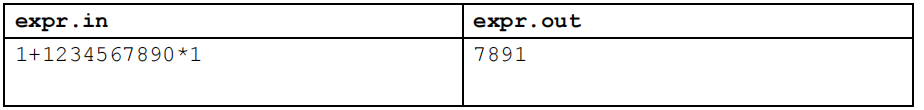
样例 2 计算的结果为 1234567891,输出后 4 位,即 7891。
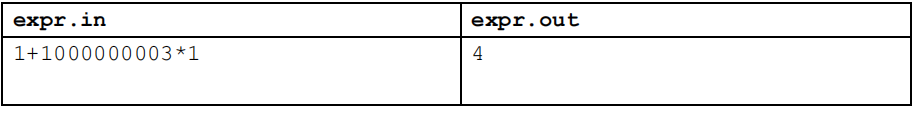
样例 3 计算的结果为 1000000004,输出后 4 位,即 4。
【数据范围】
对于 30%的数据,0≤表达式中加法运算符和乘法运算符的总数≤100;
对于 80%的数据,0≤表达式中加法运算符和乘法运算符的总数≤1000;
对于 100%的数据,0≤表达式中加法运算符和乘法运算符的总数≤100000。
#include<cstdio>
#include<iostream>
using namespace std;
int sum=0,num,tmp; //定义和,要操作的数,临时数
int main()
{
char op; //定义操作符
scanf("%d",&num); //首先读入一个数字,之后就是一个符号和一个数字的格式
while(scanf("%c",&op) && op !='\n') //没有遇到回车符就继续读入
{
scanf("%d",&tmp); //读入第二个数,根据上面的符号进行下面的操作
if(op == '+')
{
sum=(sum+num)%10000; //遇到加号就加上上一段的值,
num=tmp; //将每次读入的数 赋值给num
}
else //除了加号就是乘号
{
num=(num*tmp)%10000; //遇到乘号先把两个数乘起来
}
}
sum=(sum+num)%10000; //因为我们每次都是先读取符号再操作上一步的值,所以要加上最后一步操作的值。
printf("%d",sum);
return 0;
}
小朋友的数字
【问题描述】
有 n 个小朋友排成一列。每个小朋友手上都有一个数字,这个数字可正可负。规定每个小朋友的特征值等于排在他前面(包括他本人)的小朋友中连续若干个(最少有一个)小朋友手上的数字之和的最大值。
作为这些小朋友的老师,你需要给每个小朋友一个分数,分数是这样规定的:第一个小朋友的分数是他的特征值,其它小朋友的分数为排在他前面的所有小朋友中(不包括他本人),小朋友分数加上其特征值的最大值。
请计算所有小朋友分数的最大值,输出时保持最大值的符号,将其绝对值对 p 取模后
输出。
【输入】
输入文件为 number.in。
第一行包含两个正整数 n、p,之间用一个空格隔开。
第二行包含 n 个数,每两个整数之间用一个空格隔开,表示每个小朋友手上的数字。
【输出】
输出文件名为 number.out。
输出只有一行,包含一个整数,表示最大分数对 p 取模的结果。
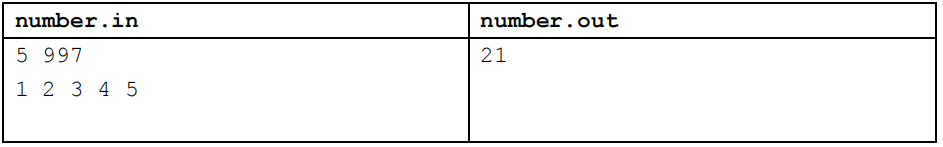
【输入输出样例 1】
【输入输出样例说明】
小朋友的特征值分别为 1、3、6、10、15,分数分别为 1、2、5、11、21,最大值 21对 997 的模是 21。
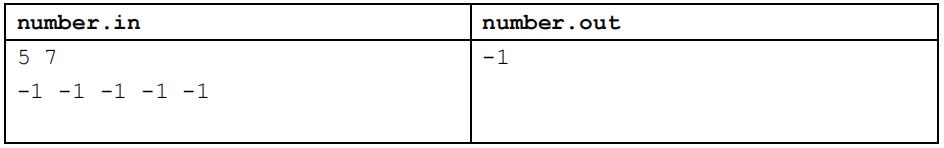
【输入输出样例 2】
【输入输出样例说明】
小朋友的特征值分别为-1、-1、-1、-1、-1,分数分别为-1、-2、-2、-2、-2,最大值
-1 对 7 的模为-1,输出-1。
【数据范围】
对于 50%的数据,1 ≤ n ≤ 1,000,1 ≤ p ≤ 1,000所有数字的绝对值不超过 1000;
对于 100%的数据,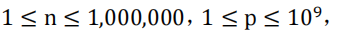 其他数字的绝对值均不超过

#include<bits/stdc++.h>
using namespace std;
#define int __int128
int read(){
int x=0,f=1;
char c=getchar();
while(c>'9'||c<'0'){
if(c=='-'){
f=-1;
}
c=getchar();
}
while(c<='9'&&c>='0'){
x=x*10+c-'0';
c=getchar();
}
return x*f;
}
void write(int x){
if(x<0) putchar('-'),x=-x;
if(x>9) write(x/10);
putchar(x%10+'0');
}
int n,p,f[1000006],ca,te[1000006],score[1000006],ans;
signed main(){
// freopen("number.in","r",stdin);
// freopen("number.out","w",stdout);
n=read();
p=read();
ca=read();
te[1]=f[1]=ca;
for(int i=2;i<=n;i++){
ca=read();
f[i]=max(ca,f[i-1]+ca);
}
int maxx=f[1];
for(int i=2;i<=n;i++){
te[i]=max(f[i],maxx);
if(f[i]>maxx){
maxx=f[i];
}
}
score[1]=te[1];
int temp=score[1]+te[1];
ans=score[1];
for(int i=2;i<=n;i++){
score[i]=temp;
temp=max(temp,score[i]+te[i]);
ans=max(ans,score[i]);
}
write(ans%p);
return 0;
}
车站分级
【问题描述】
一条单向的铁路线上,依次有编号为 1, 2, …, n 的 n 个火车站。每个火车站都有一个级别,最低为 1 级。现有若干趟车次在这条线路上行驶,每一趟都满足如下要求:如果这趟车次停靠了火车站 x,则始发站、终点站之间所有级别大于等于火车站 x 的都必须停靠。(注意:起始站和终点站自然也算作事先已知需要停靠的站点)
例如,下表是 5 趟车次的运行情况。其中,前 4 趟车次均满足要求,而第 5 趟车次由于停靠了 3 号火车站(2 级)却未停靠途经的 6 号火车站(亦为 2 级)而不满足要求。
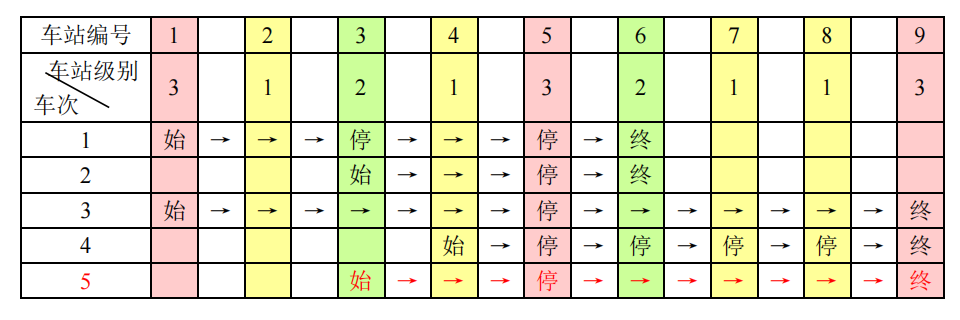
现有 m 趟车次的运行情况(全部满足要求),试推算这 n 个火车站至少分为几个不同的级别。
【输入】
输入文件为 level.in。
第一行包含 2 个正整数 n, m,用一个空格隔开。
第 i + 1 行(1 ≤ i ≤ m)中,首先是一个正整数 si(2 ≤ si ≤ n),表示第 i 趟车次有 si 个停靠站;接下来有 si个正整数,表示所有停靠站的编号,从小到大排列。每两个数之间用一个空格隔开。输入保证所有的车次都满足要求。
【输出】
输出文件为 level.out。
输出只有一行,包含一个正整数,即 n 个火车站最少划分的级别数。
【输入输出样例】
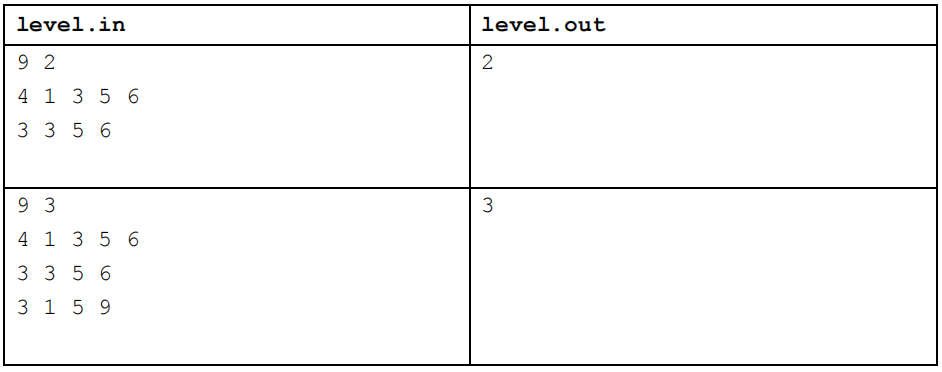
【数据范围】
对于 20%的数据,1 ≤ n, m ≤ 10;
对于 50%的数据,1 ≤ n, m ≤ 100;
对于 100%的数据,1 ≤ n, m ≤ 1000。
#include<bits/stdc++.h>
#define in read()
#define N 10009
#define M 9000009
using namespace std;
inline char nc(){
static char buf[100000],*p1=buf,*p2=buf;
return p1==p2&&(p2=(p1=buf)+fread(buf,1,100000,stdin),p1==p2)?EOF:*p1++;
}
inline int read(){
char ch=nc();int sum=0;
while(!(ch>='0'&&ch<='9'))ch=nc();
while(ch>='0'&&ch<='9')sum=sum*10+ch-48,ch=nc();
return sum;
}
int n,m,du[N],chu[N];
int nxt[M],to[M],head[N],cnt=0;
void add(int x,int y){nxt[++cnt]=head[x];head[x]=cnt;to[cnt]=y;}
int s[N],g[1009][1009],dis[N];
bool vis[1009];
int main(){
n=in;m=in;
int i,j,k;
for(i=1;i<=m;++i){
k=in;
memset(vis,0,sizeof(vis));
for(j=1;j<=k;++j){
int hh=in;
s[j]=hh;vis[hh]=1;
}
for(j=s[1];j<=s[k];++j){
if(!vis[j]){
for(int p=1;p<=k;++p){
if(!g[s[p]][j]){
g[s[p]][j]=1;
add(s[p],j);
du[j]++;
}
}
}
}
}
queue<int> q;
for(i=1;i<=n;++i)
if(!du[i]) dis[i]=1,q.push(i);
int ans=-1;
while(!q.empty()){
int u=q.front();q.pop();
for(int e=head[u];e;e=nxt[e]){
int v=to[e];
dis[v]=dis[u]+1;
ans=max(ans,dis[v]);
du[v]--;
if(!du[v]) q.push(v);
}
}
cout<<ans;
return 0;
}
质因数分解
【问题描述】
已知正整数 n 是两个不同的质数的乘积,试求出较大的那个质数。
【输入】
输入文件名为 prime.in。
输入只有一行,包含一个正整数 n。
【输出】
输出文件名为 prime.out。
输出只有一行,包含一个正整数 p,即较大的那个质数。
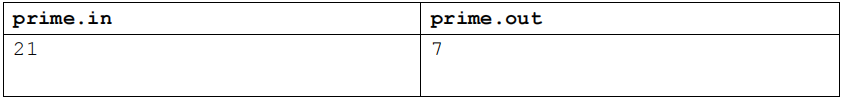
【输入输出样例】
【数据范围】
对于 60%的数据,6 ≤ n ≤ 1000。
对于 100%的数据,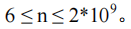
#include<bits/stdc++.h>
using namespace std;
int main()
{
int t;
scanf("%d",&t);
int i,j;
for(i=2;i<=sqrt(t);i++)
{
if(t%i==0)
{
cout<<t/i<<endl;
break;
}
}
return 0;
}
寻宝
【问题描述】 传说很遥远的藏宝楼顶层藏着诱人的宝藏。小明历尽千辛万苦终于找到传说中的这个藏 宝楼,藏宝楼的门口竖着一个木板,上面写有几个大字:寻宝说明书。说明书的内容如下:
藏宝楼共有 N+1 层,最上面一层是顶层,顶层有一个房间里面藏着宝藏。除了顶层外,藏宝楼另有 N 层,每层 M 个房间,这 M 个房间围成一圈并按逆时针方向依次编号为 0,…,M-1。其中一些房间有通往上一层的楼梯,每层楼的楼梯设计可能不同。每个房间里有一个指示牌,指示牌上有一个数字 x,表示从这个房间开始按逆时针方向选择第 x 个有楼梯的房间(假定该房间的编号为 k),从该房间上楼,上楼后到达上一层的 k 号房间。比如当前房间的指示牌上写着 2,则按逆时针方向开始尝试,找到第 2 个有楼梯的房间,从该房间上楼。如果当前房间本身就有楼梯通向上层,该房间作为第一个有楼梯的房间。
寻宝说明书的最后用红色大号字体写着:“寻宝须知:帮助你找到每层上楼房间的指示牌上的数字(即每层第一个进入的房间内指示牌上的数字)总和为打开宝箱的密钥”。
请帮助小明算出这个打开宝箱的密钥。
【输入】
输入文件为 treasure.in。
第一行 2 个整数 N 和 M,之间用一个空格隔开。N 表示除了顶层外藏宝楼共 N 层楼,M 表示除顶层外每层楼有 M 个房间。
接下来 N*M 行,每行两个整数,之间用一个空格隔开,每行描述一个房间内的情况,其中第(i-1)*M+j 行表示第 i 层 j-1 号房间的情况(i=1, 2, …, N;j=1, 2, … ,M)。第一个整数表示该房间是否有楼梯通往上一层(0 表示没有,1 表示有),第二个整数表示指示牌上的数字。注意,从 j 号房间的楼梯爬到上一层到达的房间一定也是 j 号房间。
最后一行,一个整数,表示小明从藏宝楼底层的几号房间进入开始寻宝(注:房间编号从 0 开始)。
【输出】
输出文件名为 treasure.out。
输出只有一行,一个整数,表示打开宝箱的密钥,这个数可能会很大,请输出对 20123取模的结果即可。
【输入输出样例】
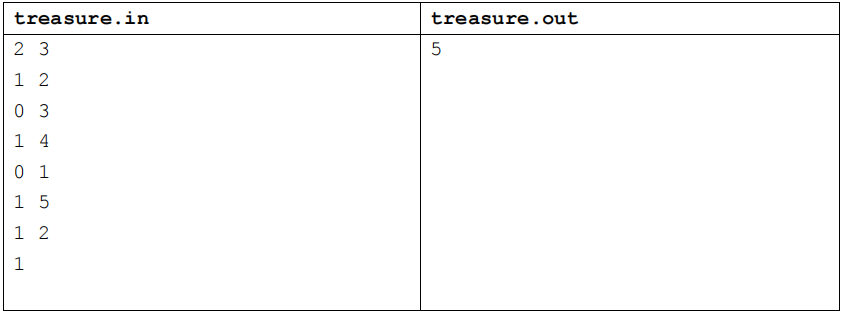
【输入输出样例说明】
第一层:
0 号房间,有楼梯通往上层,指示牌上的数字是 2;
1 号房间,无楼梯通往上层,指示牌上的数字是 3;
2 号房间,有楼梯通往上层,指示牌上的数字是 4;
第二层:
0 号房间,无楼梯通往上层,指示牌上的数字是 1;
1 号房间,有楼梯通往上层,指示牌上的数字是 5;
2 号房间,有楼梯通往上层,指示牌上的数字是 2;
小明首先进入第一层(底层)的 1 号房间,记下指示牌上的数字为 3,然后从这个房间开始,沿逆时针方向选择第3 个有楼梯的房间 2 号房间进入,上楼后到达第二层的2 号房间,记下指示牌上的数字为 2,由于当前房间本身有楼梯通向上层,该房间作为第一个有楼梯的房间。因此,此时沿逆时针方向选择第 2 个有楼梯的房间即为 1 号房间,进入后上楼梯到达顶层。这时把上述记下的指示牌上的数字加起来,即 3+2=5,所以打开宝箱的密钥就是 5。
【数据范围】
对于 50%数据,有 0<N≤1000,0<x≤10000;
对于 100%数据,有 0<N≤10000,0<M≤100,0<x≤1,000,000。
#include<iostream>
#include<cstdio>
using namespace std;
const int N(10008),M(108),MODN=20123;
int a[N][M],f[N][M],sum[N]={0};
int main()
{
//freopen("treasure.in","r",stdin);
//freopen("treasure.out","w",stdout);
int n,m,i,j,k;
scanf("%d%d",&n,&m);
for (i=1;i<=n;i++)
for (j=0;j<m;j++)
{
scanf("%d%d",&f[i][j],&a[i][j]);
if (f[i][j]) sum[i]++;
}
int ans=0;
scanf("%d",&j);
for (i=1;i<=n;i++)
{
ans=(ans+a[i][j])%MODN;
a[i][j]%=sum[i];
if (a[i][j]==0) a[i][j]=sum[i];
for (k=a[i][j];k>0;)
{
if (f[i][j])
k--;
if (k>0) j=(j+1)%m;
}
}
printf("%d\n",ans);
return 0;
}
摆花
【问题描述】
小明的花店新开张,为了吸引顾客,他想在花店的门口摆上一排花,共 m 盆。通过调查顾客的喜好,小明列出了顾客最喜欢的 n 种花,从 1 到 n 标号。为了在门口展出更多种花,规定第 i 种花不能超过 ai盆,摆花时同一种花放在一起,且不同种类的花需按标号的从小到大的顺序依次摆列。
试编程计算,一共有多少种不同的摆花方案。
【输入】
输入文件 flower.in,共 2 行。
第一行包含两个正整数 n 和 m,中间用一个空格隔开。
第二行有 n 个整数,每两个整数之间用一个空格隔开,依次表示 a1、a2、……an。
【输出】
输出文件名为 flower.out。
输出只有一行,一个整数,表示有多少种方案。注意:因为方案数可能很多,请输出方案数对 1000007 取模的结果。
【输入输出样例 1】
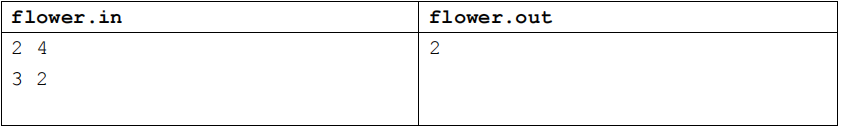
【输入输出样例说明】
有 2 种摆花的方案,分别是(1,1,1,2), (1,1,2,2)。括号里的 1 和 2 表示两种花, 比如第一个方案是前三个位置摆第一种花,第四个位置摆第二种花。
【数据范围】
对于 20%数据,有 0<n≤8,0<m≤8,0≤ai≤8;
对于 50%数据,有 0<n≤20,0<m≤20,0≤ai≤20;
对于 100%数据,有 0<n≤100,0<m≤100,0≤ ai≤100。
#include <algorithm>
#include<iostream>
using namespace std;
int A[105][105];
int a[105];
int main()
{
int n,m;
cin>>n>>m;
for(int i=1;i<=n;i++)
{
cin>>a[i];
}
A[0][0]=1; //不摆放花也是一种方案
for(int i=1;i<=n;i++)//花的种类
{
for(int j=0;j<=m;j++)//花的朵数
{
for(int k=0;k<=min(a[i],j);k++)//k从0开始表示不一定所有种类的花都要摆上,选择min(a[i],j)是因为第i种花一共只有a[i]盆,要够放
{
A[i][j]=(A[i][j]+A[i-1][j-k])%1000007;
}
}
}
cout<<A[n][m]%1000007<<endl;
return 0;
}
文化之旅
【问题描述】
有一位使者要游历各国,他每到一个国家,都能学到一种文化,但他不愿意学习任何一种文化超过一次(即如果他学习了某种文化,则他就不能到达其他有这种文化的国家)。不同的国家可能有相同的文化。不同文化的国家对其他文化的看法不同,有些文化会排斥外来文化(即如果他学习了某种文化,则他不能到达排斥这种文化的其他国家)。
现给定各个国家间的地理关系,各个国家的文化,每种文化对其他文化的看法,以及这位使者游历的起点和终点(在起点和终点也会学习当地的文化),国家间的道路距离,试求从起点到终点最少需走多少路。
【输入】
输入文件 culture.in。
第一行为五个整数 N,K,M,S,T,每两个整数之间用一个空格隔开,依次代表国家个数(国家编号为 1 到 N),文化种数(文化编号为 1 到 K),道路的条数,以及起点和终点的编号(保证 S 不等于 T);
第二行为 N 个整数,每两个整数之间用一个空格隔开,其中第 i 个数 Ci,表示国家 i的文化为 Ci。
接下来的 K 行,每行 K 个整数,每两个整数之间用一个空格隔开,记第 i 行的第 j 个数为 aij,aij= 1 表示文化 i 排斥外来文化 j(i 等于 j 时表示排斥相同文化的外来人),aij= 0 表示不排斥(注意 i 排斥 j 并不保证 j 一定也排斥 i)。
接下来的 M 行,每行三个整数 u,v,d,每两个整数之间用一个空格隔开,表示国家 u与国家 v 有一条距离为 d 的可双向通行的道路(保证 u 不等于 v,两个国家之间可能有多条道路)。
【输出】
输出文件名为 culture.out。
输出只有一行,一个整数,表示使者从起点国家到达终点国家最少需要走的距离数(如果无解则输出-1)。
【输入输出样例 1】
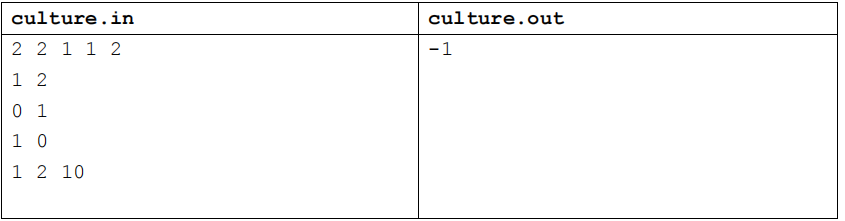
【输入输出样例说明】
由于到国家 2 必须要经过国家 1,而国家 2 的文明却排斥国家 1 的文明,所以不可能到达国家 2。
【输入输出样例 2】
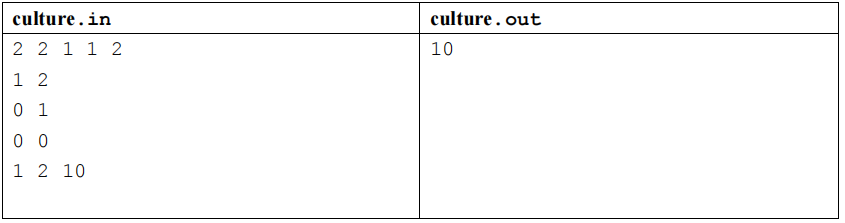
【输入输出样例说明】
路线为 1 -> 2。
【数据范围】
对于 20%的数据,有 2≤N≤8,K≤5;
对于 30%的数据,有 2≤N≤10,K≤5;
对于 50%的数据,有 2≤N≤20,K≤8;
对于 70%的数据,有 2≤N≤100,K≤10;
对于 100%的数据,有
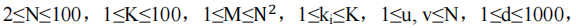
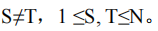
#include<bits/stdc++.h>
using namespace std;
int n,k,m,s,t;
int c[101];
int a[101][101],road[101][101];
int main()
{
scanf("%d%d%d%d%d",&n,&k,&m,&s,&t);
for(int i=1;i<=n;i++)
scanf("%d",&c[i]);
for(int i=1;i<=k;i++)
for(int j=1;j<=k;j++)
{
scanf("%d",&a[i][j]);
a[j][i]=a[i][j];
}
memset(road,0x3f3f3f3f,sizeof(road));
for(int i=1;i<=m;i++)
{
int u,v,w;
scanf("%d%d%d",&u,&v,&w);
road[u][v]=road[v][u]=w;
if(a[c[u]][c[v]]==1)
road[u][v]=road[v][u]=0x3f3f3f3f;
}
for(int k=1;k<=n;k++)
for(int i=1;i<=n;i++)
for(int j=1;j<=n;j++)
{
if(i!=j&&i!=k&&j!=k)
{
if(a[i][j]!=1&&a[i][k]!=1&&a[j][k]!=1)
road[i][j]=min(road[i][j],road[i][k]+road[k][j]);
}
}
if(road[s][t]<1001)
cout<<road[s][t]<<endl;
else
cout<<-1<<endl;
}
数字统计
【问题描述】
请统计某个给定范围[L, R]的所有整数中,数字 2 出现的次数。
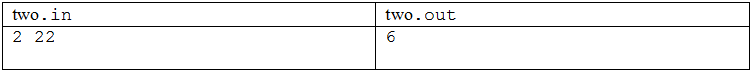
比如给定范围[2, 22],数字 2 在数2中出现了 1次,在数 12中出现 1 次,在数 20 中出现 1 次,在数 21 中出现 1 次,在数 22 中出现 2 次,所以数字 2 在该范围内一共出现了 6次。
【输入】
输入文件名为 two.in。
输入共 1 行,为两个正整数 L 和 R,之间用一个空格隔开。
【输出】
输出文件名为 two.out。
输出共 1 行,表示数字 2 出现的次数。
【输入输出样例1】
【输入输出样例2】

【数据范围】
1 ≤ L ≤R≤ 10000。
#include<cstdio>
int main()
{
int l,r,i,k,ans=0;
scanf("%d%d",&l,&r);
for(i=l;i<=r;i++)
for(k=i;k>0;k/=10)
if(k%10==2)ans++;
printf("%d\n",ans);
return 0;
}
接水问题
【问题描述】
学校里有一个水房,水房里一共装有 m 个龙头可供同学们打开水,每个龙头每秒钟的供水量相等,均为 1。
现在有 n 名同学准备接水,他们的初始接水顺序已经确定。将这些同学按接水顺序从 1到 n 编号,i号同学的接水量为 wi。接水开始时,1 到 m号同学各占一个水龙头,并同时打开水龙头接水。当其中某名同学 j 完成其接水量要求 wj 后,下一名排队等候接水的同学 k马上接替 j 同学的位置开始接水。这个换人的过程是瞬间完成的,且没有任何水的浪费。即j 同学第x 秒结束时完成接水, 则 k 同学第 x+1 秒立刻开始接水。 若当前接水人数 n’不足 m,则只有 n’个龙头供水,其它 m−n’个龙头关闭。
现在给出 n名同学的接水量,按照上述接水规则,问所有同学都接完水需要多少秒。
【输入】
输入文件名为 water.in。
第 1 行2 个整数 n 和 m,用一个空格隔开,分别表示接水人数和龙头个数。
第 2 行 n 个整数 w1、w2、……、wn,每两个整数之间用一个空格隔开,wi表示 i 号同学的接水量。
【输出】
输出文件名为 water.out。
输出只有一行,1 个整数,表示接水所需的总时间。
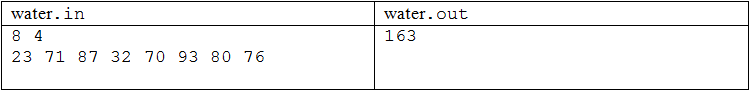
【输入输出样例1】

【输入输出样例1解释】
第 1 秒,3 人接水。第 1秒结束时,1、2、3 号同学每人的已接水量为 1,3 号同学接完水,4 号同学接替 3 号同学开始接水。
第 2 秒,3 人接水。第 2 秒结束时,1、2 号同学每人的已接水量为 2,4 号同学的已接水量为 1。
第 3 秒,3 人接水。第 3 秒结束时,1、2 号同学每人的已接水量为 3,4 号同学的已接水量为 2。4号同学接完水,5 号同学接替 4 号同学开始接水。
第 4 秒,3 人接水。第 4 秒结束时,1、2 号同学每人的已接水量为 4,5 号同学的已接水量为 1。1、2、5 号同学接完水,即所有人完成接水。
总接水时间为 4 秒。
【输入输出样例2】
【数据范围】
1 ≤ n ≤ 10000,1 ≤m≤ 100 且 m≤ n;
1 ≤wi ≤ 100。
#include <bits/stdc++.h>
using namespace std;
int s[11000],ans;
int main(){
int n,m;
cin >> n >> m;
for(int i = 1;i <= n;i ++){
cin >> s[i];
}
int t = m + 1;
while(t <= n + m){
for(int i = 1;i <= m;i ++){
s[i]--;
if(s[i] == 0){
s[i] = s[t];
t ++;
}
}
ans ++;
}
cout << ans;
return 0;
}
导弹拦截
【问题描述】
经过 11 年的韬光养晦,某国研发出了一种新的导弹拦截系统,凡是与它的距离不超过其工作半径的导弹都能够被它成功拦截。当工作半径为 0 时,则能够拦截与它位置恰好相同的导弹。但该导弹拦截系统也存在这样的缺陷:每套系统每天只能设定一次工作半径。而当天的使用代价,就是所有系统工作半径的平方和。
某天,雷达捕捉到敌国的导弹来袭。由于该系统尚处于试验阶段,所以只有两套系统投入工作。如果现在的要求是拦截所有的导弹,请计算这一天的最小使用代价。
【输入】
输入文件名 missile.in。
第一行包含 4 个整数x1、y1、x2、y2,每两个整数之间用一个空格隔开,表示这两套导弹拦截系统的坐标分别为(x1, y1)、(x2, y2)。
第二行包含 1 个整数 N,表示有 N颗导弹。接下来 N行,每行两个整数 x、y,中间用
一个空格隔开,表示一颗导弹的坐标(x, y)。不同导弹的坐标可能相同。
【输出】
输出文件名 missile.out。
输出只有一行,包含一个整数,即当天的最小使用代价。
【提示】
两个点(x1, y1)、(x2, y2)之间距离的平方是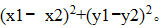
两套系统工作半径 r1、r2的平方和,是指 r1、r2 分别取平方后再求和,即 
【输入输出样例1】
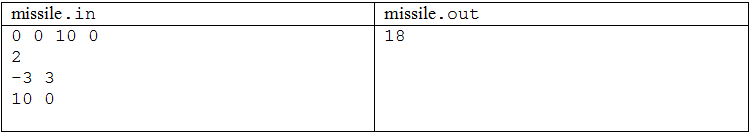
【样例 1 说明】
样例1中要拦截所有导弹,在满足最小使用代价的前提下,两套系统工作半径的平方分别为 18 和 0。
【输入输出样例2】
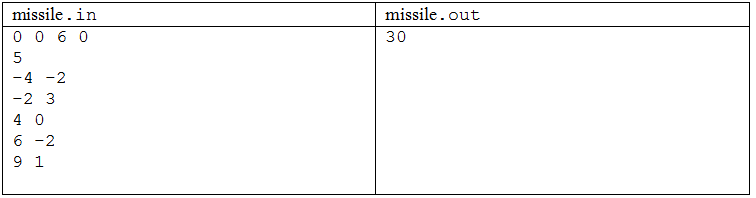
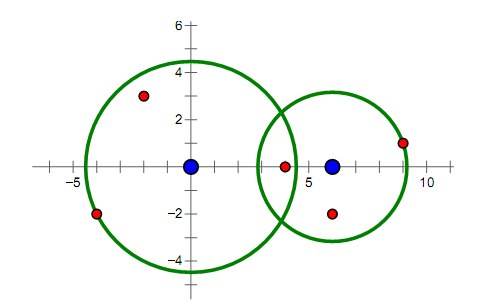
【样例 2 说明】
样例中的导弹拦截系统和导弹所在的位置如下图所示。要拦截所有导弹,在满足最小使用代价的前提下,两套系统工作半径的平方分别为 20 和 10。
【数据范围】
对于 10%的数据,N = 1
对于 20%的数据,1 ≤ N ≤ 2
对于 40%的数据,1 ≤ N ≤ 100
对于 70%的数据,1 ≤ N ≤ 1000
对于 100%的数据,1 ≤ N ≤ 100000,且所有坐标分量的绝对值都不超过 1000。
#include<bits/stdc++.h>
using namespace std;
const int N=100002;
struct fire
{
int x,y;
}a[N];
int f[N];
bool cmp(fire x,fire y)
{
return x.x<y.x;
}
int main()
{
int x1,y1,x2,y2,n,ans=1e9;
scanf("%d%d%d%d%d",&x1,&y1,&x2,&y2,&n);
for(int i=1;i<=n;i++)
{
int x,y;
scanf("%d%d",&x,&y);
a[i].x=(x1-x)*(x1-x)+(y1-y)*(y1-y);//不需要考虑坐标为负
a[i].y=(x2-x)*(x2-x)+(y2-y)*(y2-y);
}
sort(a+1,a+n+1,cmp);
for(int i=n;i>=1;i--)
f[i]=max(f[i+1],a[i].y);//其实顺推逆推无所谓
for(int i=1;i<=n;i++)
ans=min(f[i+1]+a[i].x,ans);
printf("%d",ans);
}
三国游戏
【问题描述】
小涵很喜欢电脑游戏,这些天他正在玩一个叫做《三国》的游戏。
在游戏中, 小涵和计算机各执一方, 组建各自的军队进行对战。 游戏中共有 N位武将 (N为偶数且不小于 4) ,任意两个武将之间有一个“默契值” ,表示若此两位武将作为一对组合作战时,该组合的威力有多大。游戏开始前,所有武将都是自由的(称为自由武将,一旦某个自由武将被选中作为某方军队的一员,那么他就不再是自由武将了) ,换句话说,所谓的自由武将不属于任何一方。游戏开始,小涵和计算机要从自由武将中挑选武将组成自己的军队,规则如下:小涵先从自由武将中选出一个加入自己的军队,然后计算机也从自由武将中选出一个加入计算机方的军队。接下来一直按照“小涵→计算机→小涵→……”的顺序选择武将,直到所有的武将被双方均分完。然后,程序自动从双方军队中各挑出一对默契值最高的武将组合代表自己的军队进行二对二比武,拥有更高默契值的一对武将组合获胜,表示两军交战,拥有获胜武将组合的一方获胜。
已知计算机一方选择武将的原则是尽量破坏对手下一步将形成的最强组合,它采取的具体策略如下:任何时刻,轮到计算机挑选时,它会尝试将对手军队中的每个武将与当前每个自由武将进行一一配对,找出所有配对中默契值最高的那对武将组合,并将该组合中的自由武将选入自己的军队。
下面举例说明计算机的选将策略,例如,游戏中一共有 6个武将,他们相互之间的默契值如下表所示
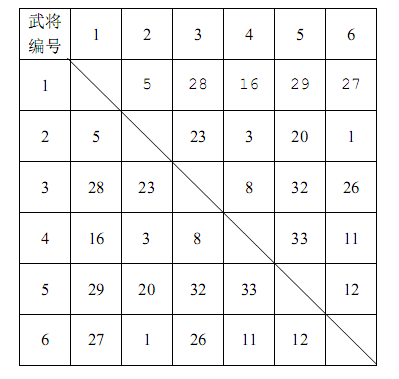
双方选将过程如下所示:
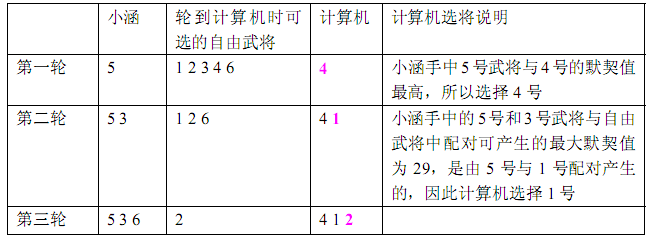
小涵想知道,如果计算机在一局游戏中始终坚持上面这个策略,那么自己有没有可能必胜?如果有,在所有可能的胜利结局中,自己那对用于比武的武将组合的默契值最大是多少?
假设整个游戏过程中,对战双方任何时候均能看到自由武将队中的武将和对方军队的武将。为了简化问题,保证对于不同的武将组合,其默契值均不相同。
【输入】
输入文件名为 sanguo.in,共 N行。
第一行为一个偶数 N,表示武将的个数。
第 2 行到第 N 行里,第(i+1)行有(N−i)个非负整数,每两个数之间用一个空格隔开,表示 i 号武将和 i+1,i+2,……,N号武将之间的默契值(0 ≤默契值≤ 1,000,000,000)。
【输出】
输出文件 sanguo.out 共 1或 2 行。
若对于给定的游戏输入,存在可以让小涵获胜的选将顺序,则输出 1,并另起一行输出所有获胜的情况中,小涵最终选出的武将组合的最大默契值。
如果不存在可以让小涵获胜的选将顺序,则输出 0。
【输入输出样例1】
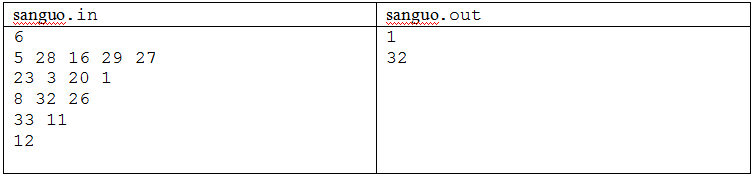
【输入输出样例说明1】
首先小涵拿走 5 号武将;计算机发现 5 号武将和剩下武将中的 4 号默契值最高,于是拿走 4 号;小涵接着拿走 3 号;计算机发现 3、5 号武将之一和剩下的武将配对的所有组合中,5 号和1 号默契值最高,于是拿走 1号;小涵接着拿走 2 号;计算机最后拿走 6 号。在小涵手里的 2,3,5 号武将中,3 号和 5 号配合最好,默契值为 32,而计算机能推出的最好组合为 1 号和 6 号,默契值为 27。结果为小涵胜,并且这个组合是小涵用尽所有方法能取到的最好组合。
【输入输出样例2】
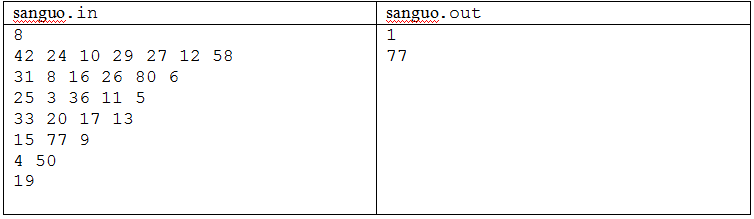
【数据范围】
对于 40%的数据有 N ≤ 10。
对于 70%的数据有 N ≤ 18。
对于 100%的数据有 N ≤ 500。
#include <iostream>
#include <iomanip>
#include <cstring>
#include <cstdio>
#include <cmath>
using namespace std;
const int N = 5005; //定义大一点
long long a[N][N];
long long n, i, j, mx, cx, mx1;
int main()
{
freopen ("sanguo.in" , "r" , stdin);
freopen ("sanguo.out" , "w" , stdout);
scanf ("%lld", &n);
for (i = 1;i <= n - 1;i ++) {
for (j = i + 1;j <= n;j ++) {
scanf ("%lld", &a[i][j]); //输入
a[j][i] = a[i][j]; //构建一个邻接矩阵
}
}
for (i = 1;i <= n;i ++) {
cx = mx = 0; //赋初值
for (j = 1;j <= n;j ++) {
if (mx < a[i][j]) { //如果当前默契值比mx大
cx = mx; //将mx赋给cx,cx为次大值,这样下来,就可以找到最大和次大值了
mx = a[i][j]; //更新mx
}
else cx = max (a[i][j] , cx); //否则取最大值
mx1 = max (mx1 , cx); //有一个变量存将哟输出的值
}
}
printf ("1\n%lld", mx1); //输出(一定会赢)
fclose (stdin);
fclose (stdout);
return 0;
}
多项式输出
【问题描述】
一元 n 次多项式可用如下的表达式表示:
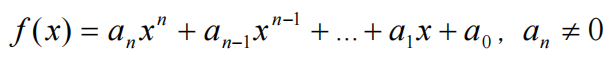
其中, 称为 i 次项,
 称为 i 次项的系数。给出一个一元多项式各项的次数和系数,请按照如下规定的格式要求输出该多项式:
1. 多项式中自变量为 x,从左到右按照次数递减顺序给出多项式。
2. 多项式中只包含系数不为 0 的项。
3. 如果多项式 n 次项系数为正,则多项式开头不出现“+”号,如果多项式 n 次项系数为负,则多项式以“-”号开头。
4. 对于不是最高次的项,以“+”号或者“-”号连接此项与前一项,分别表示此项系数为正或者系数为负。紧跟一个正整数,表示此项系数的绝对值(如果一个高于 0 次的项,其系数的绝对值为 1,则无需输出 1)。如果 x 的指数大于 1,则接下来紧跟的指数部分的形式为“x^b”,其中 b 为 x 的指数;如果 x 的指数为 1,则接下来紧跟的指数部分形式为“x”;如果 x 的指数为 0,则仅需输出系数即可。
5. 多项式中,多项式的开头、结尾不含多余的空格。
【输入】
输入文件名为 poly.in,共有 2 行
第一行 1 个整数,n,表示一元多项式的次数。
第二行有 n+1 个整数,其中第 i 个整数表示第 n-i+1 次项的系数,每两个整数之间用空格隔开。
【输出】
输出文件 poly.out 共 1 行,按题目所述格式输出多项式。
【输入输出样例 1】
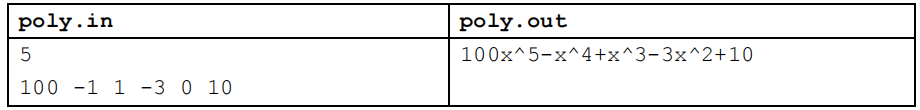
【输入输出样例 2】
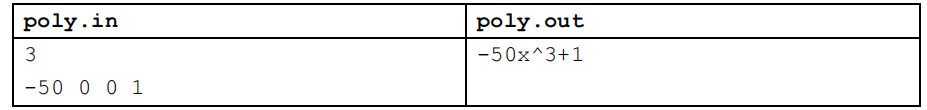
【数据范围】
1≤ n≤ 100,多项式各次项系数的绝对值均不超过 100。
#include<bits/stdc++.h>
using namespace std;
int a[101];
int main() {
int n;
cin>>n;
for(int i=1; i<=n+1; i++)
scanf("%d",&a[i]);
if(a[1]<0)
cout<<'-';
if(abs(a[1])>1)
cout<<abs(a[1]);
cout<<"x^"<<n;
int nn=n-1;
for(int i=2; i<=n+1; i++) {
if(a[i]==0) {
nn--;
continue;
}
if(a[i]>0)
cout<<'+';
else
cout<<'-';
if(abs(a[i])!=1||i==n+1)
cout<<abs(a[i]);
if(nn==1)
cout<<'x';
else if(nn==0)
continue;
else
cout<<"x^"<<nn;
nn--;
}
return 0;
}
分数线划定
【问题描述】
世博会志愿者的选拔工作正在 A 市如火如荼的进行。为了选拔最合适的人才,A 市对所有报名的选手进行了笔试,笔试分数达到面试分数线的选手方可进入面试。面试分数线根据计划录取人数的150%划定,即如果计划录取m名志愿者,则面试分数线为排名第m*150%(向下取整)名的选手的分数,而最终进入面试的选手为笔试成绩不低于面试分数线的所有选手。
现在就请你编写程序划定面试分数线,并输出所有进入面试的选手的报名号和笔试成绩。
【输入】
输入文件名为 score.in。
第一行,两个整数 n,m(5 ≤ n ≤ 5000,3 ≤ m ≤ n),中间用一个空格隔开,其中 n 表示报名参加笔试的选手总数,m 表示计划录取的志愿者人数。输入数据保证 m*150%向下取整后小于等于 n。第二行到第 n+1 行,每行包括两个整数,中间用一个空格隔开,分别是选手的报名号 k(1000 ≤ k ≤ 9999)和该选手的笔试成绩 s(1 ≤ s ≤ 100)。数据保证选手的报名号各不相同。
【输出】
输出文件 score.out。
第一行,有两个整数,用一个空格隔开,第一个整数表示面试分数线;第二个整数为进入面试的选手的实际人数。从第二行开始,每行包含两个整数,中间用一个空格隔开,分别表示进入面试的选手的报名号和笔试成绩,按照笔试成绩从高到低输出,如果成绩相同,则按报名号由小到大的顺序输出。
【输入输出样例】
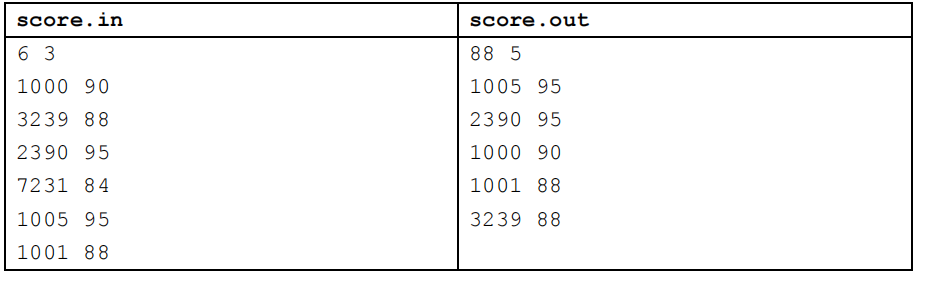
【样例说明】
m*150% = 3*150% = 4.5,向下取整后为 4。保证 4 个人进入面试的分数线为 88,但因为 88
有重分,所以所有成绩大于等于 88 的选手都可以进入面试,故最终有 5 个人进入面试。
#include <iostream>
#include <algorithm>
using namespace std;
const int N=5000;
struct people{
int k; //报名号
int s; //笔试成绩
};
int cmp(const people &a, const people &b){
if(a.s != b.s)
return a.s > b.s;
else
return a.k < b.k;
}
int main()
{
int n, m, pass_number;
cin >> n >> m;
people p[n];
pass_number = m * 1.5;
for(int i=0; i<n; i++)
cin >> p[i].k >> p[i].s ;
sort(p, p+n, cmp); //按要求排序
for(int i=pass_number; i<n; i++){
if(p[i].s == p[pass_number-1].s)
pass_number ++;
else
break;
} //考虑分数在及格线的选手有多名的情况
cout << p[pass_number-1].s << " " << pass_number << endl;
for(int i=0; i<pass_number; i++){
cout << p[i].k << " " << p[i].s << endl;
}
return 0;
}
细胞分裂
【问题描述】
Hanks 博士是 BT (Bio-Tech,生物技术) 领域的知名专家。现在,他正在为一个细胞实验做准备工作:培养细胞样本。
Hanks 博士手里现在有 N 种细胞,编号从 1~N,一个第 i 种细胞经过 1 秒钟可以分裂为Si 个同种细胞(Si 为正整数)。现在他需要选取某种细胞的一个放进培养皿,让其自由分裂,进行培养。一段时间以后,再把培养皿中的所有细胞平均分入 M 个试管,形成 M 份样本,用于实验。Hanks 博士的试管数 M 很大,普通的计算机的基本数据类型无法存储这样大的M 值,但万幸的是,M 总可以表示为 m1的 m2 次方,即 M =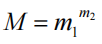 ,其中 m1,m2 均为基本数据类型可以存储的正整数。
注意,整个实验过程中不允许分割单个细胞,比如某个时刻若培养皿中有 4 个细胞,Hanks 博士可以把它们分入 2 个试管,每试管内 2 个,然后开始实验。但如果培养皿中有 5
个细胞,博士就无法将它们均分入 2 个试管。此时,博士就只能等待一段时间,让细胞们继续分裂,使得其个数可以均分,或是干脆改换另一种细胞培养。
为了能让实验尽早开始,Hanks 博士在选定一种细胞开始培养后,总是在得到的细胞“刚好可以平均分入 M 个试管”时停止细胞培养并开始实验。现在博士希望知道,选择哪种细胞培养,可以使得实验的开始时间最早。
【输入】
输入文件名为 cell.in,共有三行。
第一行有一个正整数 N,代表细胞种数。
第二行有两个正整数 m1,m2,以一个空格隔开, m1
m2 即表示试管的总数 M。
第三行有 N 个正整数,第 i 个数 Si 表示第 i 种细胞经过 1 秒钟可以分裂成同种细胞的个
数。
【输出】
输出文件 cell.out 共一行,为一个整数,表示从开始培养细胞到实验能够开始所经过的
最少时间(单位为秒)。
如果无论 Hanks 博士选择哪种细胞都不能满足要求,则输出整数-1。
【输入输出样例 1】
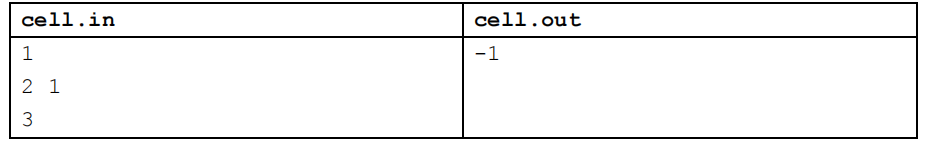
【输入输出样例 1 说明】
经过 1 秒钟,细胞分裂成 3 个,经过 2 秒钟,细胞分裂成 9 个,……,可以看出无论怎么分
裂,细胞的个数都是奇数,因此永远不能分入 2 个试管。
【输入输出样例 2】
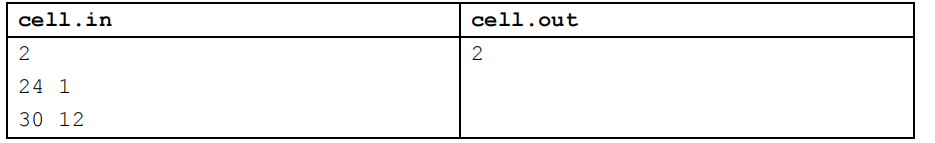
【输入输出样例 2 说明】
第 1 种细胞最早在 3 秒后才能均分入 24 个试管,而第 2 种最早在 2 秒后就可以均分(每
试管 144/(241
)=6 个)。故实验最早可以在 2 秒后开始。
【数据范围】
对于 50%的数据,有 m1
m2 ≤ 30000。
对于所有的数据,有 1≤ N ≤ 10000,1≤ m1 ≤ 30000,1≤ m2 ≤ 10000,1≤ Si≤ 2,000,000,000。
#include <bits/stdc++.h>
using namespace std;
int n,xb[10010],m1,m2,last=0;
int fj[30010]={0};
int max(int a,int b)
{
return a>b?a:b;
}
int main()
{
freopen("cell.in","r",stdin);
freopen("cell.out","w",stdout);
scanf("%d",&n);
scanf("%d%d",&m1,&m2);
while(m1)
{
int sqr = sqrt(m1);
bool bflag = 1;
for(int i=2;i<=sqr&&bflag;i++)
{
while(m1%i==0)
{
fj[i]+=m2;
bflag=0;
m1 /= i;
last=max(last,i);
}
}
if(bflag) {
if(m1) fj[m1]+=m2;
last = max(last,m1);
break;
}
}
int minn = 99999999;
for(int i=1;i<=n;i++)
{
int x;
scanf("%d",&x);
int maxx = 0;
for(int j = 2;j <= last;j++)
{
if(fj[j])
{
int p = 0;
while(x%j==0&&x){
p++;
x/=j;
}
if(!p) {
maxx = 99999999;
break;
}
maxx = max(maxx,ceil(1.0*fj[j]/p));
}
}
if(minn > maxx) minn = maxx;
}
if(minn==99999999)
printf("-1\n");
else printf("%d\n",minn);
return 0;
}