GESP-Python四级 题库
在Python程序中,自定义函数可以定义在主程序代码的前面,也可以定义在主程序代码的后面,都不会发生错误。( )
在Python中,函数必须在调用之前定义。如果你在调用一个函数之前没有定义它,程序会抛出NameError异常。因此,自定义函数必须在主程序代码中被调用之前进行定义,否则会发生错误
在Python程序中,如果自定义函数内没有return语句或者return语句不带任何返回值,那么该函数的返回值为False。
在Python中,如果自定义函数没有return 语句或者return 语句不带任何返回值,函数的返回值是None,而不是False。None是一个特殊的值,表示“无值”或“空”。只有在函数中显式返回False 时,返回值才会是False
下面这段程序的时间复杂度为线性阶O(n)。( )
在while 循环中,条件是i^2 < n。这意味着循环会继续,直到i 的平方达到或超过n。因此,循环的次数是O(√n)而不是O(n)
执行下面Python代码,调用函数fun可以得到一个元组类型的数据。
fun(8, 5)返回(1, 3),类型为元组,所以type(fun(8, 5))输出<class ‘tuple’>。
Python的内置函数 sorted() 支持对 list 、 tuple 、 str 排序,但不支持 dict 和 set 。( )
Python内置函数 sorted() 可以将 list 、 str 、 tuple 、 set 以及其他很多支持 for-in 类型的数据排序,不管被排序类型如何,其排序结果均为 list 类型,且对被排序数据没有影响。( )
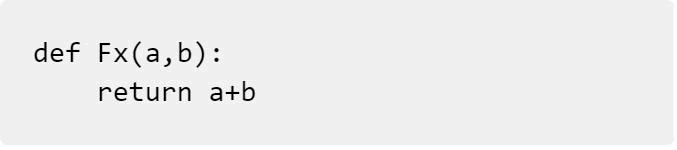
根据下面 Python 函数定义,调用 Fx()函数时如果两个参数同为 int、float、tuple、list、str 都不会报错。
小杨的字典
时间限制:1.0 s
内存限制:128.0 MB
问题描述
在遥远的星球,有两个国家 A 国和 B 国,他们使用着不同的语言:A 语言和 B 语言。小杨是 B 国的翻译官,他的工作是将 A 语言的文章翻译成 B 语言的文章。
为了顺利完成工作,小杨制作了一本字典,里面记录了N个 A 语言单词对应的 B 语言单词,巧合的是,这些单词都由地球上的 26 个小写英文字母组成。
小杨希望你写一个程序,帮助他根据这本字典翻译一段 A 语言文章。这段文章由标点符号 !()-[]{}\|;:'",./?<> 和一些 A 语言单词构成,每个单词之间必定由至少一个标点符号分割,你的程序需要把这段话中的所有 A 语言单词替换成它的 B 语言翻译。特别地,如果遇到不在字典中的单词,请使用大写 UNK 来替换它。
例如,小杨的字典中包含 2 个 A 语言单词 abc 和 d ,它们的 B 语言翻译分别为 a 和 def ,那么我们可以把 A语言文章 abc.d.d.abc.abcd. 翻译成 B 语言文章 a.def.def.a.UNK. ,其中,单词 abcd 不在词典内,因此我们需要使用 UNK 来替换它。
输入描述
第一行一个整数N,表示词典中的条目数。保证N≤100。
接下来N行,每行两个用单个空格隔开的字符串A,B,分别表示字典中的一个 A 语言单词以及它对应的 B 语言翻译。保证所有A不重复;保证A和B的长度不超过10。
最后一行一个字符串S,表示需要翻译的 A 语言文章。保证字符串S的长度不超过1000,保证字符串S只包含小写字母以及标点符号 !()-[]{}\|;:'",./?<> 。
输出描述
输出一行,表示翻译后的结果。
特别提醒
在常规程序中,输入、输出时提供提示是好习惯。但在本场考试中,由于系统限定,请不要在输入、输出中附带任何提示信息。
样例输入 1
样例输出 1
样例输入 2
样例输出 2
样例输入 3
样例输出 3
n = int(input())
d = {}
for i in range(n):
	k, v = input().split(' ')
	assert k not in d
	d[k] = v

punc = '!()-[]{}\|;:\'",./?<>'
UNK = "UNK"
st = input()
curr_token = ""
ans = ""
for ch in st:
	if ch in punc:
		if curr_token in d:
			ans += d[curr_token]
		elif curr_token:
			ans += UNK
		curr_token = ""
		ans += ch
	else:
		assert ch.islower()
		curr_token += ch
if curr_token in d:
	ans += d[curr_token]
elif curr_token:
	ans += UNK
print(ans)幸运数
【问题描述】
1. 变化正整数的各个奇数位(从右到左,个位为第 1 位,奇数,16347),变化的规则是乘以 7,如果该奇数位与 7 相乘的结果大于 9 则各位数相加,如相加结果仍然大于 9 则继续各位数相加,直到结果不大于 9;如果该奇数位与 7 相乘的结果不大于 9 则该数为该奇数位变化结果。偶数位不发生变化。各个奇数位变化完毕后,将新数的各位数相加,如果相加之和是 8 的整数倍,则为幸运数;
2. 例如 16347,第 1 位 7 奇数位,乘以 7 结果为 49,大于 9 各位数相加为 13 大于 9继续各位数相加最后结果为 4;然后变化第 3 位 3,第 5 位 1。最后变化结果为 76344,对于结果 76344 其各位数之和为 24,是 8 的倍数,为幸运数;
3. 首先输入 N,随后输入 N 行正整数。输出 N 行,对应 N 个正整数是否为幸运数,如是则输出 T 否则 F。
【输入描述】
1. 首先输入正整数 N 随后输入 N 行正整数,每个一个数。不考虑输入不合规情形,负数、负整数、非数字构成的字符串等。
2. 特别提示:常规程序中,输入时好习惯是有提示。考试时由于系统限定,输入时所有 input()函数不可有提示信息。
【输出描述】
1. 输出 N 行,对应 N 个正整数是否为幸运数,如是则输出 T 否则 F。;
2. 特别提示:注意输出字母为英文大写,小写或其他将判为错误。
【样例输入 1】
2
16347
76344
【样例输出 1】
T
F
#幸运数
N = int(input()) #确定将输入 N 个数
for i in range(N):
	M = int(input()) #输入的数存入 M
	tnt = 0 #各位数相加之和
	loc = 0 #位置
	while M != 0:
		loc += 1
		if loc % 2 == 1:
			tmp = M % 10 * 7
			while tmp > 9:
				tmp = tmp // 10 + tmp % 10
			tnt += tmp
			#print(loc, tmp, tnt)
		else:
			tnt += M % 10
			#print(loc, M%10, tnt)
		M //= 10
	if tnt % 8 ==0:
		print("T")
	else:
print("F")图像压缩
【问题描述】
1. 灰度图像有 256 级灰阶,编码 00-FF,对应 0-255,即图像有很多点,每个点取值是 00 到 FF。编程压缩到 16 级灰阶,对应 0-F。
2. 压缩规则:统计出每种灰阶的数量,取数量最多的前 16 种灰阶(如某种灰阶的数量与另外一种灰阶的数量相同,则以灰阶值从小到大为序),分别编号 0-F。其他灰阶转换到最近的 16 种灰阶之一,将某个点灰阶数与 16 种灰阶种的一种相减,绝对值最小即为最近。
3. 输入:多行数据,每行数据等长,每两个字符构成一个点,十六进制;输出:首先连续最多输出 16 种灰阶编码,不足 16 种灰阶就按实际输出;然后各行输出压缩后的编码,每行等长。
【输入描述】
1. 第 1 次输入正整数 n,表示有多少行数据。
2. 随后输入 n 行数据。
3. 特别提示:常规程序中,输入时好习惯是有提示。考试时由于系统限定,输入时所有 input()函数不可有提示信息。
【输出描述】
1. 首先输出 16 种灰阶编码,共计 32 个字符。不足 16 种按实际输出。输出数量最多的 16 种灰阶,从多到少;如某种灰阶的数量与另外一种灰阶的数量相同,则以灰阶值从小到大为序;
2. 特别提示:注意输出字母为大写,小写将判为错误,数本身与字母 T 和 F 之前没有空格。
【样例输入 1】
【样例输出 1】
#图像压缩
def composePixel(topDict,srcVal):
	if srcVal in topDict:
		return hex(topDict[srcVal])[2:].upper()
	else:#不在列表中,计算最近距离
		nearest = 255
		nearestKey = "FF"
		for k,v in topDict.items():
			tmpDistance = abs(int(srcVal,16)-int(k,16))
			if tmpDistance < nearest:
				nearest = tmpDistance
				nearestKey = v
		return hex(nearestKey)[2:].upper()
N = int(input())
dictDot = {}
rawData = []
newData = []
for i in range(N):
	dataLine = input()
	rawData.append(dataLine)
	charCount = len(dataLine)
	groupCount = charCount //2
	for i in range(groupCount):
		twoHex = dataLine[i*2:i*2+2] #两个十六进制字符
		dictDot[twoHex] = dictDot.get(twoHex,0) + 1
top16 = sorted(dictDot.items(), key = lambda x: (x[1],-int(x[0],16)), reverse = True)[:16]
top16Dict = {k:x for x,(k,v) in enumerate(top16)}
for dataLine in rawData:
	groupCount = len(dataLine) // 2
	tmp = ""
	for i in range(groupCount):
		tmp += composePixel(top16Dict,dataLine[i*2:i*2+2])
	newData.append(tmp)
for top in top16:
	print(top[0],end="")
print()
for everyLine in newData:
	print(everyLine)