GESP-Python四级 题库
域名是由一串用点分隔的名字来标识互联网上一个计算机或计算机组的名称,CCF 编程能力等级认证官方网站的域名是 gesp.ccf.org.cn,其中顶级域名是 gesp。(2023-6-py四级))
山之谷
时间限制:1.0 s
内存限制:512.0 MB
题目描述
现有一片山地,可以视为一个N行M列的网格图,第i行j列的海拔为hi,j。
如果一个单元格的海拔不高于其所有相邻单元格(相邻包括上、下、左、右、左上、右上、左下、右下,最多8个方向)的海拔,则称该单元格为山谷。
请你数一数该片山地中有多少山谷。
输入格式
第一行包含2个整数N,M,表示山地的大小。
之后N行,每行包含M个整数hi,1,hi,2,...,hi,M,表示海拔。
输出格式
输出 1 行,包含 1 个整数C,表示山谷的数量。
输入样例
输出样例
样例解释
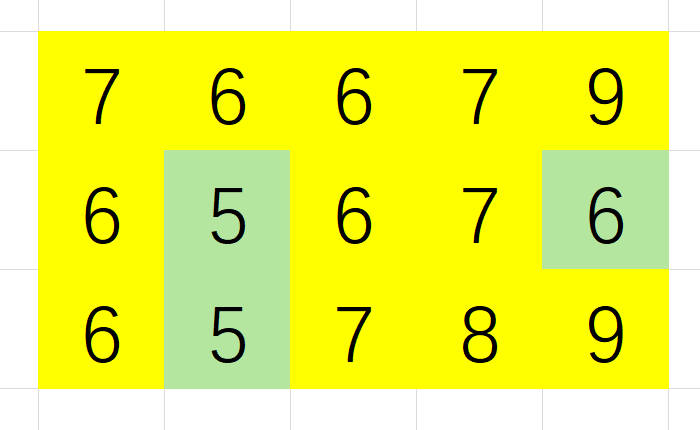
样例 1 如图所示,绿色单元格代表山谷:
数据范围
保证1≤N,M≤100,1≤hi,j≤105。
# 输入行列数
n, m = map(int, input().split())
# 输入每一行的海拔
h = []
for i in range(n):
	row = list(map(int, input().split()))
	h.append(row)
ans = 0
# 先遍历行
for i in range(n):
	# 再遍历列
	for j in range(m):
		ok = True
		# 遍历周边8个格子
		for k in range(-1, 2):
			for l in range(-1, 2):
				# 边界判定,不能超列表边界
				if 0 <= i + k < n and 0 <= j + l < m and h[i + k][j + l] < h[i][j]:
					ok = False
		if(ok):
			ans += 1
print(ans)
礼盒排序
时间限制:1.0 s
内存限制:512.0 MB
题目描述
商店推出了许多礼盒,每个礼盒中包含k件商品,每件商品都有一个价格。
现在需要对这些礼盒进行排序,排序规则如下:
1. 先按礼盒总价格从小到大排序;
2. 如果总价格相同,按礼盒中最贵商品的价格从小到大排序;
3. 如果仍然相同,按礼盒中最便宜商品的价格从小到大排序;
4. 如果仍然相同,按礼盒编号从小到大排序。
请输出排序后的礼盒编号。
输入格式
第一行包含两个整数n和k,分别表示礼盒数量和每个礼盒中商品的数量。
接下来n行,每行包含k个整数,第i行表示第i个礼盒中各商品的价格。
输出格式
输出一行,包含排序后的礼盒编号(编号从1开始),用空格分隔。
输入样例
输出样例
样例解释
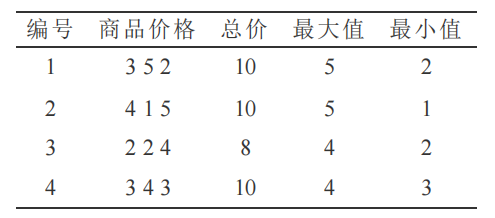
4 个礼盒分别为:
排序过程:
1. 按总价排序,3号礼盒总价最小;
2. 其余总价均为 10,再按最大值排序,4号最大值更小;
3. 1号和2号最大值相同,再按最小值排序,2号更小。
最终顺序为:3 4 2 1
数据范围
保证1≤n≤103,1≤k≤10,商品价格≤104。
n, k = map(int, input().split())
v = []
for i in range(n):
	nums = list(map(int, input().split()))
	s = sum(nums)
	mx = max(nums)
	mn = min(nums)
	v.append((s, mx, mn, i + 1))
v.sort()
for i in range(n):
	print(v[i][3], end="" if i == n - 1 else " ")
print()
建造
题目描述
小 A 有一张 M 行 N 列的地形图,其中第 i 行第j 列的数字 aij 代表坐标 (i, j) 的海拔高度。停机坪为一个 3 x 3 的区域且内部所有 9 个点的最大高度和最小高度之差不超过 H。
小 A 想请你计算出,在所有适合建造停机坪的区域中,区域内部9个点海拔之和最大是多少。
输入格式
第一行三个正整数 M, N, H ,含义如题面所示。
之后 M 行,第 i 行包含 N 个整数 ai1, ai2, · · · , aiN ,代表坐标 (i, j) 的高度。数据保证总存在一个适合建造停机坪的区域。
输出格式
输出一行,代表最大的海拔之和。
数据范围
对于所有测试点,保证 1 ≤ M, N ≤ 10³ , 1 ≤ H, aij ≤ 10⁵。
# 读取数据
M, N, H = map(int, input().split())
grid = []
for _ in range(M):
    row = list(map(int, input().split()))
    grid.append(row)

max_sum = 0

# 遍历所有可以放置3*3区域的左上角坐标
for i in range(M - 2):
    for j in range(N - 2):
        # 提取3*3区域所有数值
        area = []
        total = 0
        for x in range(3):
            for y in range(3):
                val = grid[i+x][j+y]
                area.append(val)
                total += val
        # 判断是否符合条件
        if max(area) - min(area) <= H:
            if total > max_sum:
                max_sum = total

print(max_sum)
优先购买
题目描述
小 A 有 M 元预算。商店有 N 个商品,每个商品有商品名 S、价格 P 和优先级 V 三种属性,其中 V 为正整数,且越小代表商品的优先级越高。
小 A 的购物策略为:
1. 总是优先买优先级最高的东西;
2. 如果有多个最高优先级商品,购买价格最低的;
3. 如果有多个优先级最高且价格最低的商品,购买商品名字典序最小的。
小 A 想知道能购买哪些商品。
输入格式
第一行两个正整数 M, N ,代表预算和商品数。
之后 N 行,每行一个商品,依次为 si pi vi ,代表第 i 个商品的商品名、价格、优先级。
数据保证不存在两个名字相同的商品。
输出格式
按照字典序从小到大的顺序,输出所有购买商品的商品名。
输入样例
输出样例
数据范围
对于所有测试点,保证 1 ≤ len(S) ≤ 10, 1 ≤ M, P ≤ 10⁵ , 1 ≤ N ≤ 10³ , 1 ≤ vi ≤ 10 。商品名仅由小写字母组成且不存在两个相同的商品名。
# 读取预算和商品数量
M, N = map(int, input().split())
items = []
# 读取所有商品信息
for _ in range(N):
    name, price, priority = input().split()
    items.append((name, int(price), int(priority)))

# 排序规则:优先级升序(越高越前)、价格升序、名字字典序升序
items.sort(key=lambda x: (x[2], x[1], x[0]))

res = []
# 依次购买商品,消耗预算
for name, p, _ in items:
    if p <= M:
        M -= p
        res.append(name)

# 按商品名字典序排序输出
res.sort()
for name in res:
    print(name)
试题名称:排兵布阵
时间限制:1.0 s
内存限制:512.0 MB


def largest_rect_area(heights):
    stack = []
    max_area = 0
    # 末尾补0,强制弹出栈内所有元素
    h = heights + [0]
    for i in range(len(h)):
        while stack and h[i] < h[stack[-1]]:
            idx = stack.pop()
            height = h[idx]
            # 计算宽度
            if not stack:
                width = i
            else:
                width = i - stack[-1] - 1
            area = height * width
            if area > max_area:
                max_area = area
        stack.append(i)
    return max_area

# 读取输入
n, m = map(int, input().split())
matrix = []
for _ in range(n):
    row = list(map(int, input().split()))
    matrix.append(row)

h = [0] * m
res = 0

for i in range(n):
    # 更新高度数组
    for j in range(m):
        if matrix[i][j] != 0:
            h[j] += 1
        else:
            h[j] = 0
    # 求当前行柱状图最大矩形
    current_max = largest_rect_area(h)
    if current_max > res:
        res = current_max

print(res)
试题名称:最长连续段
时间限制:1.0 s
内存限制:512.0 MB


n = int(input())
a = sorted(list(map(int, input().split())))

last, cnt, mx = a[0], 1, 1
for i in a[1:]:  # 从第二个数开始遍历
    if last == i:
        cnt += 1
        mx = max(mx, cnt)
    else:
        last = i
        cnt = 1
print(mx)
画布裁剪


# 读取矩阵行数n、列数m
n, m = map(int, input().split())
# 读取截取区域的上下左右边界坐标
x1, x2, y1, y2 = map(int, input().split())
# 逐行读取整个字符矩阵
s = [input().strip() for _ in range(n)]

# 遍历目标行范围(转程序下标,起始x1-1,终止x2不包含)
for i in range(x1 - 1, x2):
    # 截取该行指定列区间并打印
    print(s[i][y1 - 1 : y2])
排序


n = int(input().strip())
a = []

# 录入每组高、宽数据
for _ in range(n):
    h, w = map(int, input().split())
    a.append((h, w))

ans = 0    # 统计交换次数
flag = True # 标记本轮是否发生交换

# 冒泡排序降序
while flag:
    flag = False
    i = 0
    while i < n - 1:
        # 前一个小于后一个,需要交换(降序)
        if a[i] < a[i + 1]:
            flag = True
            a[i], a[i + 1] = a[i + 1], a[i]
            ans += 1
        i += 1

print(ans)
荒地开垦
时间限制:3.0 s
内存限制:512.0 MB
题面描述
小杨有一大片荒地,可以表示为一个 n行 m列的网格图。
小杨想要开垦这块荒地,但荒地中一些位置存在杂物,对于一块不存在杂物的荒地,该荒地可以开垦当且仅当其上下左右四个方向相邻的格子均不存在杂物。
小杨可以选择至多一个位置,清除该位置的杂物,移除杂物后该位置变为荒地。小杨想知道在清除至多一个位置的杂物的情况下,最多能够开垦多少块荒地。
输入格式
第一行包含两个正整数n,m ,含义如题面所示。
之后 n行,每行包含一个长度为m 且仅包含字符 . 和 # 的字符串。如果为 . ,代表该位置为荒地,如果为 # ,代表该位置为杂物。
输出格式
输出一个整数,代表在清除至多一个位置的杂物的情况下,最多能够开垦的荒地块数。
输入样例
输出样例
样例解释
移除第二行从左数第二块空地的杂物后:
第一行从左数前 4块荒地,第二行从左数前3 块荒地,第三行从左数前4 块荒地,均可开垦,4+3+4=11。
数据范围
对于全部数据,保证有 1≤n,m≤1000。
N = 1005
mat = [[''] * N for _ in range(N)]
a = [[0] * N for _ in range(N)]
d = [(-1, 0), (1, 0), (0, -1), (0, 1)]


n, m = map(int, input().split())

for i in range(1, n + 1):
	line = input().strip()
	for j in range(1, m + 1):
		mat[i][j] = line[j - 1]

ans = 0

for i in range(1, n + 1):
	for j in range(1, m + 1):
		num = 0
		p = -1

	for k in range(4):
		ni, nj = i + d[k][0], j + d[k][1]
		if mat[ni][nj] == '#':
			num += 1
			p = k

	if mat[i][j] == '.' and num == 1:
		ni, nj = i + d[p][0], j + d[p][1]
		a[ni][nj] += 1
	elif mat[i][j] == '.' and num == 0:
		ans += 1
	elif mat[i][j] == '#' and num == 0:
		a[i][j] += 1

mx = 0
for i in range(1, n + 1):
	for j in range(1, m + 1):
		mx = max(mx, a[i][j])

print(ans + mx)
二阶矩阵
题目描述
小 A 有一个n 行m 列的矩阵 A。
小 A 认为一个2*2 的矩阵D 是好的,当且仅当D1,1*D2,2=D1,2*D2,1。其中 Di,j表示矩阵 D的第 i行第 j列的元素。
小 A 想知道 A中有多少个好的子矩阵。
输入格式
第一行,两个正整数n,m 。
接下来 n行,每行 m个整数 Ai,1 , Ai,2 …… , Ai,m。
输出格式
一行,一个整数,表示A 中好的子矩阵的数量。
输入样例
3 4
1 2 1 0
2 4 2 1
0 3 3 0
输出样例
2
样例解释
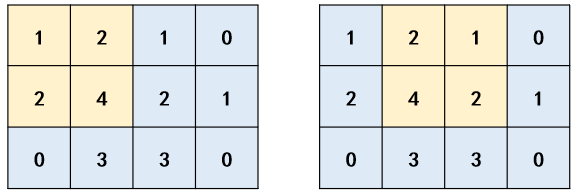
样例中的好的子矩阵如下:
数据范围
对于所有测试点,保证 1≤n≤5 ,1≤m≤500, 100≤ Ai,j≤100 。
n, m = map(int, input().split())
a = [list(map(int, input().split())) for _ in range(n)]
print(sum(1 for i in range(n - 1) for j in range(m - 1) if a[i][j] * a[i + 1][j + 1]
== a[i][j + 1] * a[i + 1][j]))
Recamán
时间限制:2.0 s
内存限制:512.0 MB
题目描述
小杨最近发现了有趣的 Recamán 数列,这个数列是这样生成的:
数列的第一项a1是 1;
如果ak−1−k 是正整数并且没有在数列中出现过,那么数列的第 k 项ak为ak−1−k,否则为ak−1+k。
小杨想知道 Recamán 数列的前 n 项从小到大排序后的结果。手动计算非常困难,小杨希望你能帮他解决这个问题。
输入格式
第一行,一个正整数 n 。
输出格式
一行,n 个空格分隔的整数,表示 Recamán 数列的前 n 项从小到大排序后的结果。
输入样例 1
输出样例 1
输入样例 2
输出样例 2
样例解释
对于样例 1,n=5;
a1−2=−1,不是正整数,因a2=a1+2=3;
a2−3=0,不是正整数,因此a3=a2+3=6;
a3−4=2,是正整数,且没有在数列中出现过,因此a4=2;
a4−5=−3,不是正整数,因此a5=a4+5=7;
a1,a2,a3,a4,a5从小到大排序后的结果为 1 2 3 6 7 。
数据范围
对于所有数据点,保证1≤n≤3000。
n = int(input())
a = [1]
for i in range(2, n + 1):
	a.append(a[-1] - i if a[-1] - i > 0 and a[-1] - i not in a else a[-1] + i)

def bubble_sort(a):
	n, flag = len(a), True
	while flag:
		flag = False
		for i in range(n - 1):
			if a[i] > a[i + 1]:
				flag = True
				a[i], a[i + 1] = a[i + 1], a[i]

bubble_sort(a)
for i in range(n):
	a[i] = str(a[i])
print(' '.join(a))字符排序
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨有 n 个仅包含小写字母的字符串s1,s2,...,sn,小杨想将这些字符串按一定顺序排列后拼接到一起构成字符串 t 。小杨希望最后构成的字符串 t 满足:
假设ti为字符串 t 的第 i 个字符,对于所有的j<i 均有tj≤ti。两个字符的大小关系与其在字母表中的顺序一致,例如e<g<p<s。
小杨想知道是否存在满足条件的字符串排列顺序。
输入格式
第一行包含一个正整数 T ,代表测试数据组数。
对于每组测试数据,第一行包含一个正整数 n ,含义如题面所示。
之后 n 行,每行包含一个字符串si。
输出格式
对于每组测试数据,如果存在满足条件的排列顺序,输出 1,否则输出 0。
输入样例
输出样例
样例解释
对于第一组测试数据,一种可行的排列顺序为 aa+ac+de,构成的字符串 t 为 aaacde,满足条件。
对于全部数据,保证有1≤t,n≤100,每个字符串的长度不超过 10。
def bubble_sort(a):
	n, flag = len(a), True
	while flag:
		flag = False
		for i in range(n - 1):
			if a[i] > a[i + 1]:
				flag = True
				a[i], a[i + 1] = a[i + 1], a[i]

t = int(input())
for _ in range(t):
	n = int(input())
	s = []
	for _ in range(n):
		s.append(input())
	bubble_sort(s)
	t = ''.join(s)
	fl = 1
	for i in range(1, len(t)):
		if t[i] < t[i - 1]:
			fl = 0
				break
	print(fl)
黑白方块
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨有一个n行m列的网格图,其中每个格子要么是白色,要么是黑色。
小杨想知道网格图中是否存在一个满足如下条件的子矩形:
子矩形由 4 行 4 列组成;
子矩形的第 1 行 和第 4 行只包含白色格子;
对于子矩形的第 2 行 和第 3 行,只有第 1 个和第 4 个格子是白色的,其余格子都是黑色的;
请你编写程序帮助小杨判断。
输入格式
第一行包含一个正整数t,代表测试用例组数。
接下来是t组测试用例。对于每组测试用例,一共n+1 行。
第一行包含两个正整数n,m,含义如题面所示。
之后n行,每行一个长度为m的01串,代表网格图第i行格子的颜色,如果为0,则对应格子为白色,否则为黑色。
输出格式
对于每组测试用例,如果存在,输出 Yes,否则输出 No。
输入样例
输出样例
满足条件的子矩形形如:
对于全部数据,保证有1≤t≤10,1≤n,m≤100。
N = 110
w = [[0] * N for _ in range(N)]
match = [[0] * 4 for _ in range(4)]
n, m = 0, 0

def check(xa, ya):
	for i in range(4):
		for j in range(4):
			if w[xa + i][ya + j] != match[i][j]:
				return False
return True

def main():
	for i in range(1, 3):
		match[1][i] = match[2][i] = 1

	t = int(input())
	for _ in range(t):
		global n, m
		n, m = map(int, input().split())

		for i in range(1, n + 1):
			s = input()
			for j in range(1, m + 1):
				w[i][j] = int(s[j - 1])

		fl = False
		for i in range(1, n - 2):
			for j in range(1, m - 2):
				if check(i, j):
					fl = True
					break
			if fl:
				break

		if fl:
			print("Yes")
		else:
			print("No")

if __name__ == "__main__":
	main()
定义二维列表,存储将要输入的网格数据;
将要匹配的模版矩形初始化,4X4的二维列表;
使用循环遍历网格数据中每一个可能的4X4子矩形,检查从位置(i,j)开始的子矩形是否与之前定义好的模版匹配
进行判断,输出结果
区间排序
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨有一个包含n个正整数的序列a。
小杨计划对序列进行多次升序排序,每次升序排序小杨会选择一个区间[l,r](l≤r) 并对区间内所有数字,即al,al+1,...,ar进行升序排序。每次升序排序会在上一次升序排序的结果上进行。
小杨想请你计算出多次升序排序后的序列。
输入格式
第一行包含一个正整数n,含义如题面所示。
第二行包含n个正整数a1,a2,...,an,代表序列。
第三行包含一个正整数q,代表排序次数。
之后q行,每行包含两个正整数li,ri,代表将区间[li,ri] 内所有数字进行升序排序。
输出格式
输出一行包含n个正整数,代表多次升序排序后的序列。
输入样例
输出样例
第一次升序排序后,序列为[3,4,5,1,2];
第二次升序排序后,序列为[3,4,1,5,2];
第三次升序排序后,序列为[1,3,4,5,2];
对于全部数据,保证有1≤n≤100,1≤ai≤100,1≤q≤100,1≤li≤ri≤n。
N = 1010
a = [0] * N
n = 0

def bubbleSort(l, r):
	flag = True
	while flag:
		flag = False
		for i in range(l, r):
			if a[i] > a[i + 1]:
				flag = True
				a[i], a[i + 1] = a[i + 1], a[i]

n = int(input())
s = input().split()
for i in range(1, n + 1):
	a[i] = int(s[i-1])

q = int(input())
while q:
	q -= 1
	l, r = map(int, input().split())
	bubbleSort(l, r)

for i in range(1, n + 1):
	print(a[i], end=" " if i != n else "\n")
将要排序的数据存储在列表中,初始化定义一个长度为1010的列表,尽可能大的数据,确保在输入规模较大的情况下不会越界
定义排序方法对数据进行排序
处理部分:
存储输入数据
处理需要进行排序的区间操作数q
对选定的l,r区间范围内数据进行排序操作,调用之前定义好的排序方法
输出结果(注意每个元素用空格分割,且最后一个元素没有空格)
黑白方块
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨有一个n行m列的网格图,其中每个格子要么是白色,要么是黑色。
对于网格图中的一个子矩形,小杨认为它是平衡的当且仅当其中黑色格子与白色格子数量相同。
小杨想知道最大的平衡子矩形包含了多少个格子。
输入格式
第一行包含两个正整数n,m,含义如题面所示。
之后n行,每行一个长度为m的01串,代表网格图第i行格子的颜色,如果为0,则对应格子为白色,否则为黑色。
输出格式
输出一个整数,代表最大的平衡子矩形包含格子的数量,如果不存在则输出0。
输入样例
输出样例
样例解释
对于样例1,假设 (i,j) 代表第i行第j列,最大的平衡子矩形的四个顶点分别为 (1,2),(1,5),(4,2),(4,5)。
数据范围
对于全部数据,保证有 1 ≤ n , m ≤ 10。
N = 55
w = [[0] * N for _ in range(N)]

def check(xa, ya, xb, yb):
	a = [0, 0]
	for i in range(xa, xb + 1):
		for j in range(ya, yb + 1):
			a[w[i][j]] += 1
	return a[0] == a[1]

def main():
	n, m = map(int, input().split())
	for i in range(1, n + 1):
		s = input()
		for j in range(1, m + 1):
			w[i][j] = int(s[j - 1])
	ans = 0
	for i in range(1, n + 1):
		for j in range(1, m + 1):
			for ii in range(i, n + 1):
				for jj in range(j, m + 1):
					if check(i, j, ii, jj):
						ans = max(ans, (ii - i + 1) * (jj - j + 1))
	print(ans)

if __name__ == "__main__":
main()
首先解决 “如何判断一个矩阵 a是一个平衡矩阵”这个问题:枚举矩阵中的每一个元素,用两个计数器a[0]、a[1]分别记录0和1的数量,如果最终a[0]==a[1],那么就是平衡矩阵,复杂度是O(n^2)。
然后解决“如何枚举一个矩阵中的所有子矩阵”这个问题:对于任意一个子矩阵,它都有一个起始行、一个终止行、一个起始列和一个终止列,我们可以用4个for循环来分别枚举它们,这样就应该把每个子矩阵确定下来,复杂度是O(n^4)。
如此一来,我们便可以用O(n^4) 的复杂度枚举每一个子矩阵,然后再花O(n^2) 的复杂度判断是否是平衡矩阵,总体时间复杂度为O(n^6)。
宝箱
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨发现了n个宝箱,其中第i个宝箱的价值是ai。
小杨可以选择一些宝箱放入背包并带走,但是小杨的背包比较特殊,假设小杨选择的宝箱中最大价值为x,最小价值为y,小杨需要保证x−y≤k,否则小杨的背包会损坏。
小杨想知道背包不损坏的情况下,自己能够带走宝箱的总价值最大是多少。
输入格式
第一行包含两个正整数n,k,含义如题面所示。
第二行包含n个正整数a1,a2 , . . . , an,代表宝箱的价值。
输出格式
输出一个整数,代表带走宝箱的最大总价值。
输入样例
输出样例
样例解释
在背包不损坏的情况下,小杨可以拿走两个价值为 2 22 的宝箱和一个价值为 3 33 的宝箱。
数据范围
对于全部数据,保证有 1 ≤ n ≤ 1000 , 0 ≤ k ≤ 1000 , 1 ≤ ai ≤ 1000
N = 1010
a = [0] * N

def main():
	n, k = map(int, input().split())
	aa = input().split()
	for i in range(1, n + 1):
		a[i] = int(aa[i-1])
	a[1:n + 1] = sorted(a[1:n + 1])
	ans = 0
	for i in range(1, n + 1):
		sum = 0
		for j in range(i, 0, -1):
			if a[i] - a[j] <= k:
				sum += a[j]
			else:
				break
		ans = max(ans, sum)
	print(ans)

if __name__ == "__main__":
	main()
比较容易想到的做法是用O(n)的复杂度枚举一个a[i]作为最大值x,然后用O(n)的复杂度枚举另一个值a[j]作为最小值y,最后用O(n)的复杂度枚举数组,计算一下值处于[x,y]的元素总和sum,算出来的总和与ans取最大值即可,但是这样的做法是O(n^3)的,没有办法拿到满分;
我们发现,之所以我们最后需要O(n)的复杂度枚举数组的元素计算总和,是因为我们不知道数值处在[x,y]范围内的元素总和是多少,所以需要枚举计算。
为了解决这个问题,我们可以先将数组从小到大排序,这样一来,数组中的每个子区间[j,i]的左右端点的值a[j]、a[i]分别就对应了我们枚举的最小值x,和最大值y,又因为数组是有序的,因此,数值处于[x,y]范围内的元素正好就是区间[j,i]内的所有元素,这样一来,我们就可以在向前枚举a[j](也就是最小值y)的同时,顺便计算区间[j,i]内的元素总和sum,时间复杂度降为了O(n^2)。
相似字符串
问题描述
对于两个字符串A和B,如果A可以通过删除一个字符,或插入一个字符,或修改一个字符变成B,那么我们说A和B是相似的。
比如 apple 可以通过插入一个字符变成 applee ,可以通过删除一个字符变成 appe ,也可以通过修改一个字符变成 bpple ,因此 apple 和 applee 、 appe 、 bpple 都是相似的。但 applee 并不能通过任意一个操作变成bpple ,因此它们并不相似。
特别地,完全相同的两个字符串也是相似的。
给定T组A,B,请你分别判断他们是否相似。
输入描述
第一行一个正整数T。
接下来T行,每行两个用空格隔开的字符串A和B。
保证T≤100,A,B的长度不超过50。保证A和B只包含小写字母。
输出描述
输出T行,对于每组A,B,如果它们相似,则输出 similar ,否则输出 not similar 。
特别提醒
在常规程序中,输入、输出时提供提示是好习惯。但在本场考试中,由于系统限定,请不要在输入、输出中附带任何提示信息。(python)
样例输入 1
样例输出 1
def is_similar(A, B):
	m, n = len(A), len(B)
	if abs(m - n) > 1:
		return False
	if m == n:
		diff = sum(1 for i in range(m) if A[i] != B[i])
		return diff <= 1
	else:
		shorter = A if m < n else B
		longer = B if m < n else A
		i, j = 0, 0
		diff = 0
		while i < len(shorter) and j < len(longer):
			if shorter[i] != longer[j]:
				diff += 1
				if diff > 1:
					return False
				j += 1
			else:
				i += 1
				j += 1
		return True
T = int(input())
for _ in range(T):
	A, B = input().split()
	if is_similar(A, B):
		print("similar")
	else:
print("not similar")做题
题目描述
小杨同学为了提高自己的实力制定了做题计划,在第k天时,他必须要完成k道题,否则他就会偷懒。
小杨同学现在找到了一个题库,一共有n套题单,每一套题单中有一定数量的题目。但是他十分挑剔,每套题单他只会使用一次,每一天也只能使用一套题单里的题目,之后那套题单就会被弃之不用。对于每套题单,他不必完成题单内所有的题。
那么问题来了,小杨同学最多会做题几天才偷懒呢?
输入格式
第一行,1个数为n,表示有多少套题单。
第二行,n个整数a1,a2,...,an,分别表示每套题单有多少道题。
输出格式
输出一行,小杨同学偷懒前最多做题天数。
样例输入
样例输出
对于全部数据,保证有1≤n≤106,1≤ai≤109。
(python)
n = int(input())
A = list(map(int, input().split()))
A = sorted(A)
day, idx = 1, 0
while idx < n:
	if A[idx] >= day:
		day += 1
	idx += 1
print(day - 1)