Python编程六级 题库
在 Python 中,使用open()函数打开文件进行读取时,文件路径必须是绝对路径。( )
在 Python 中,使用open()函数打开文件进行读取时,文件路径既可以是绝对路径,也可以是相对路径。相对路径是相对于当前工作目录来确定文件位置,使用相对路径可以使代码在不同环境下更灵活地运行。
一个学生成绩管理系统需要从SQLite数据库中查询学生信息。在执行查询操作时,fetchmany(size=2)会返回结果中的前两行。( )
fetchmany(size=2)返回当前游标位置开始的2行,而非“前两行”。
JSON数据是纯文本格式,因此它可以很容易地被机器解析和生成。( )
JSON(JavaScript Object Notation)数据是一种纯文本格式。它使用易于阅读和编写的键值对结构来表示数据。这种格式使得JSON非常适合用于数据交换和存储。
绘制图形如图所示,画线处的的语句填写是否正确 ?( )
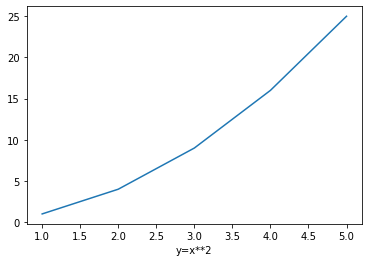
import matplotlib.pyplot as plt
x = [1, 2, 3, 4, 5]
y = [1, 4, 9, 16, 25]
plt.plot(x, y)
plt.xlabel('y=x**2')
plt.show()Matplotlib中设置x轴的标签为plt.xlabel()。
使用matplotlib的 plt.text() 函数可以在图表的任意位置添加文本注释,但是无法控制文本的对齐方式。( )
plt.text() 函数不仅允许你指定文本的具体位置,还可以通过参数如 horizontalalignment, verticalalignment 等来控制文本的对齐方式。
readline()函数读取文本文件内容,返回的是一个列表,其中每一行的数据为一个元素。( )
readlines()函数读取文本文件内容,返回的是一个列表,其中每一行的数据为一个元素。
小明编写一个类实现设置马的品种、年龄、性别及速度,输出相应的语句,请补全代码。
如下代码输出结果为“一匹阿拉伯12岁的公马,在草原上奔跑的速度为50km/h”。
class ① :
def __init__(self, category, gender, age):
self.category = category
②
self.age = age
self.speed = 0
def get_descriptive(self):
self.info = "一匹" + self.category + ③ + "岁的" +self.gender + "马"
def write_speed(self, new_speed):
self.speed = new_speed
addr = "在草原上奔跑的速度为"
print( ④ + "," + addr + str(self.speed) + "km/h。")
horse = Horse("阿拉伯","公",12)
horse.get_descriptive()
horse.write_speed(50)
# 样例代码
class Horse :
    def __init__(self, category, gender, age):
        self.category = category
        self.gender = gender
        self.age = age
        self.speed = 0
    def get_descriptive(self):
        self.info = "一匹" + self.category + str(self.age) + "岁的" +self.gender + "马"
    def write_speed(self, new_speed):
        self.speed = new_speed
        addr = "在草原上奔跑的速度为"
        print(self.info + "," + addr + str(self.speed) + "km/h。")
horse = Horse("阿拉伯","公",12)
horse.get_descriptive()
horse.write_speed(5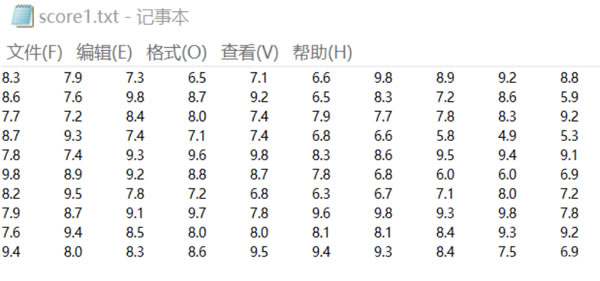
# 样例代码
with open("/data/score1.txt", encoding="UTF-8") as f:
    data = f.readline().strip()
    i = 0
    m = 0
    while data:
        i+=1
        score = list(map(float, data.split()))
        result = (sum(score) - min(score) - max(score)) / (len(score) - 2)
        if result>m :
            m = result
            pos = i
    data =f.readline().strip()
print("成绩最佳的选手是:" +str(pos)+ "号,得分:" + str(m) + "分"# 样例代码
import sqlite3
conn=sqlite3.connect('data.db')
cur = conn.cursor()
cur.execute("CREATE TABLE IF NOT EXISTS student(num INTEGER PRIMARY KEY ,name text,grade int,rank int)")
cur.execute("insert into student(num,name,grade,rank) values(1,'lilei',100,50)")
conn.commit()
cur.close()
conn.close()当前,我国正在开展新型冠状病毒疫苗接种,自今年 2 月份以来,许多学校的教职员工积极利用空余时间,到当地卫健部门指定的接种点去接种,为了帮助政教员小叶排摸全校教职员工接种情况,根据每天汇总的接种登记表(包含全校教职员工的姓名、组别、年龄、是否接种等信息,已转换为csv格式,见图1”),小徐利用 Python 编写了一个统计程序,方便向校领导汇报各教研组接种情况及全校接种比例等。该程序运行的部分界面如图2所示,请在程序划线处填入合适的代码。
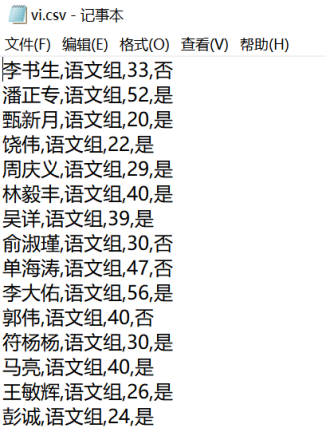
图1
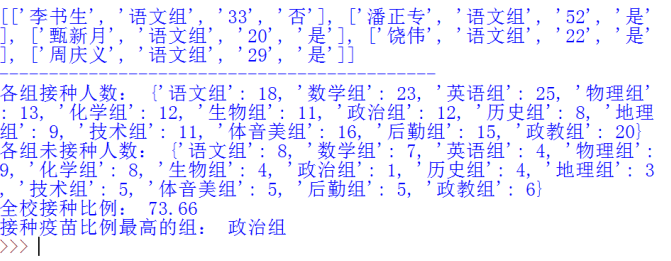
图2
import csv
f = open("/data/vi.csv", "r")
Vac_T = {"语文组": 0, "数学组": 0, "英语组": 0, "物理组": 0, "化学组": 0, "生物组": 0, "政治组":0,"历史组":0,"地理组":0,"技术组":0,"体音美组":0,"后勤组":0,"政教组": 0}
Vac_F = {"语文组": 0, "数学组": 0, "英语组": 0, "物理组": 0, "化学组": 0, "生物组": 0, "政治组":0,"历史组":0,"地理组":0,"技术组":0,"体音美组":0,"后勤组":0,"政教组": 0}
list1 =[]
zrs = 0
zu_max = 0
line = f.readline()
while line:
line = line.strip('\n')
data = line.split(",")
list1.append(data)
①
print(list1[:5])
print("--------------------------------------------")
f.close()
num = len(list1)
for i in range(num):
line_list = list1[i]
if ② :
Vac_T[line_list[1]] += 1
else:
Vac_F[line_list[1]] += 1
for i in Vac_T:
zu_per = Vac_T[i]/(Vac_T[i]+Vac_F[i])
if zu_per > zu_max:
zu_max = zu_per
zu = i
③
tot_per = int(zrs/num*10000+0.5)/100
print("各组接种人数:", Vac_T)
print("各组未接种人数:", Vac_F)
print("全校接种比例:", tot_per)
print("接种疫苗比例最高的组:", zu)
参考程序:
import csv
f = open("/data/vi.csv", "r")
Vac_T = {"语文组": 0, "数学组": 0, "英语组": 0, "物理组": 0, "化学组": 0, "生物组": 0, "政治组":0,"历史组":0,"地理组":0,"技术组":0,"体音美组":0,"后勤组":0,"政教组": 0}
Vac_F = {"语文组": 0, "数学组": 0, "英语组": 0, "物理组": 0, "化学组": 0, "生物组": 0, "政治组":0,"历史组":0,"地理组":0,"技术组":0,"体音美组":0,"后勤组":0,"政教组": 0}
list1 =[]
zrs = 0
zu_max = 0
line = f.readline()
while line:
    line = line.strip('\n')
    data = line.split(",")
    list1.append(data)
    line = f.readline()
print(list1[:5])
print("--------------------------------------------")
f.close()
num = len(list1)
for i in range(num):
    line_list = list1[i]
    if line_list[3] == "是":
        Vac_T[line_list[1]] += 1
    else:
        Vac_F[line_list[1]] += 1
for i in Vac_T:
    zu_per = Vac_T[i]/(Vac_T[i]+Vac_F[i])
    if zu_per > zu_max:
        zu_max = zu_per
        zu = i
    zrs += Vac_T[i]
tot_per = int(zrs/num*10000+0.5)/100
print("各组接种人数:", Vac_T)
print("各组未接种人数:", Vac_F)
print("全校接种比例:", tot_per)
print("接种疫苗比例最高的组:", zu)
评分标准:
(1)line = f.readline() ; (3分)
(2)line_list[3] == "是" ; (4分)
(3)zrs += Vac_T[i] 。 (3分)
编程定义一个类,实现求长方体体积,并输出当长方体的长度、宽度和高度分别为10、20和30时的体积,请保留小数点后两位数字。
请补全代码:
class Box():
def __init__( ① ):
② =length1
③ =width1
④ =height1
def volume(self):
return ⑤
my_box=Box(10,20,30)
print("长方体体积是%.2f"%my_box.volume())
参考程序:
class Box():
    def __init__(self,length1,width1,height1):
        self.length=length1
        self.width=width1
        self.height=height1
    def volume(self):
        return self.length*self.width*self.height
my_box=Box(10,20,30)
print("长方体体积是%.2f"%my_box.volume())
评分标准:
(1)self,length1,width1,height1;(2分)
(2)self.length;(2分)
(3)self.width; (2分)
(4)self.height;(2分)
(5)self.length*self.width*self.height。(2分)
马和骆驼都是哺乳动物,它们都有四只脚,体型也差不多大,我们将在这里为它们编写属于它们各自的类,输出相关语句。
例如:一匹阿拉伯12岁的公马,在草原上奔跑的速度为50km/h。
一匹双峰驼20岁的母骆驼,在沙漠上奔跑的速度为40kmh。
class Horse():
    def __init__(self, category, gender, age):
        self.category = category
        self.gender = gender
        self.age = age
        self.speed = 0
    def get_descriptive(self):
        self.info = "一匹" + self.category + str(self.age) + "岁的" + self.gender + "马"
    def write_speed(self, new_speed):
        self.speed= new_speed
        addr = "在草原上奔跑的速度为"
        print(self.info + "," + addr + str(self.speed) + "km/h。")
class Came1(Horse):
    def __init__(self, category, gender, age):
        super().__init__(category, gender, age)
    def write_speed(self,new_speed):
        self.speed= new_speed
        addr = "在沙漠上奔跑的速度为"
        print(self.info.replace("马","骆驼") + "," + addr + str(self.speed) + "km/h。")

horse = Horse("阿拉伯","公",12)
horse.get_descriptive()
horse.write_speed(50)
came1 = Came1("双峰驼","母",20)
came1.get_descriptive()
came1. write_speed(40)
评分标准:
(1)Horse;(2分)
(2)self.speed= new_speed;(2分)
(3)self.info.replace;(4分)
(4)str(self.speed)。(2分)
随机列表问题
随机生成一个长度为 100 的整数列表,其元素范围为 1~100,将该列表以每10 个一行(元素之间以空格分隔)写入一个文本文件("record.txt"),将文本文件("record.txt")中的数字读入一个列表,并按数字的升序输出该列表。
注:enumerate()取出的两个值,一个为数的索引,一个为数的值
from random import randint
lis=[]
for i in range(100):
lis.append(randint(1,100))
with open("record.txt","①")as f:
str=""
for i,v in enumerate(lis):
str=str+"{}".format(v)
if②==0:
b=③(str+"\n")
str=""
lis_date=[]
with open("record.txt")as f:
for line in④:
line=line.strip()
data=line.split()
for v in data:
lis_date.append(eval(v))
last_date=⑤(lis_date)
print(last_date)
from random import randint
lis=[]
for i in range(100):
    lis.append(randint(1,100))
with open("record.txt","w")as f:
    str=""
    for i,v in enumerate(lis):
        str=str+"{}".format(v)
        if(i+1)%10==0:
            b=f.write(str+"\n")
            str=""
lis_date=[]
with open("record.txt")as f:
    for line in f.readlines():
        line=line.strip()
        data=line.split()
        for v in data:
            lis_date.append(eval(v))
last_date=sorted(lis_date)
print(last_date)
(1)w 或等效答案;(2 分)
(2)(i+1)%10 或等效答案;(2 分)
(3)f.write 或等效答案;(2 分)
(4)f.readlines()或等效答案;(2 分)
(5)sorted 或等效答案。(2 分)
运动时长统计
汪龙对不同年龄段的人群进行运动时长的调研,数据存储在文件“sport_240622.csv”中,数据内容如下图显示:
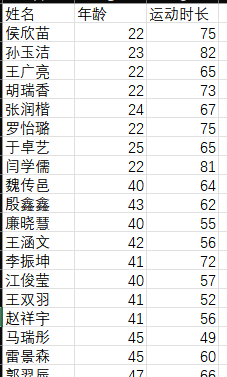
用Python编写一段代码帮他完成本次调用的运动时长的统计。具体要求如下:
(1)读取文件sport_240622.csv中的姓名、年龄、运动时长;
(2)输出年龄在40岁以上(含40岁)人群的平均运动时长(保留2位小数);
请根据要求,补全代码。
import csv
with open("/data/sport_240622.csv") as f:
    rows = list(csv.reader(f))
    s=0
    c=0
    pj=0
    for row in rows[1:]:
        if(int(row[1])>=40):
            s=s+int(row[2])
            c=c+1
    pj=s/c
    print(round(pj,2))
评分标准:
(1)csv.reader(f) 或等效答案;(2分)
(2)int(row[1])>40 或等效答案;(2分)
(3)int(row[2]) 或等效答案;(2分)
(4)c=c+1 或等效答案;(2分)
(5)round(pj,2) 或等效答案。(2分)
士兵瑞恩
按照需求填空:
1)士兵瑞恩有一把AK47
2)士兵有枪就可以开火
3)枪能够把子弹发射出去,每射击一次,子弹减少一个
4)枪能够装填子弹 --增加子弹的数量
class Gun():
def ① (self,model):
self.model = model
self.bullet_count = 0
def add_bullet(self,count):
self.bullet_count += count
def shoot( ② ):
if self.bullet_count <= 0:
print('%s没有子弹' %(self.model))
else:
self.bullet_count ③ 1
print('%s的子弹数量为%s' %( ④ ,self.bullet_count))
class Soldier():
def __init__(self,name):
self.name =name
self.gun = None
def fire(self):
if self.gun == None:
print('%s没有枪' %(self.name))
else:
self.gun.add_bullet(5)
⑤
ak47 = Gun('AK47')
ak47.add_bullet(10)
ak47.shoot()
ruien = Soldier('RE')
ruien.gun = ak47
ruien.fire()
class Gun():
   def __init__(self,model):
       self.model = model
       self.bullet_count = 0
   def add_bullet(self,count):
       self.bullet_count += count
   def shoot(self):
       if self.bullet_count <= 0 :
           print('%s没有子弹' %(self.model))
       else:
           self.bullet_count -= 1
           print('%s的子弹数量为%s' %(self.model,self.bullet_count))
class Soldier():
   def __init__(self,name):
       self.name =name
       self.gun = None
   def fire(self):
       if self.gun == None:
           print('%s没有枪' %(self.name))
       else:
           self.gun.add_bullet(5)
           self.gun.shoot()
ak47 = Gun('AK47')
ak47.add_bullet(10)
ak47.shoot()
ruien = Soldier('RE')
ruien.gun = ak47
ruien.fire()
评分标准:
(1)__init__ 或等效答案;(2分)
(2)self 或等效答案;(2分)
(3)-= 或等效答案;(2分)
(4)self.model 或等效答案;(2分)
(5)self.gun.shoot() 或等效答案。(2分)
家庭记录
假设有一个任务是帮助你的家庭记录每日的支出。每天结束时,你会记录下今天的日期、购买的物品以及花费的金额。这个信息将被保存在一个名为ledger.txt的文本文件中。编写一段Python代码来完成以下的操作:
(1)在文件末尾追加新的消费记录;
(2)需要查看当前所有的消费记录。
为了简化问题,假设每条记录只包含日期、物品和金额,使用逗号分隔。
def append_record(date, item, amount):
with open("ledger.txt", " ① ") as file:
file.write(f"{date},{item},{amount}\n")
def read_records():
with open(" ② ", "r") as file:
records = file. ③ ()
for record in records:
print(record, end="")
# 示例操作
append_record("2023-04-05", "Groceries", 35.20)
append_record("2023-04-06", "Internet Bill", 50)
④ ()
def append_record(date, item, amount):
    with open("ledger.txt", "a") as file:
        file.write(f"{date},{item},{amount}\n")
def read_records():
    with open("ledger.txt", "r") as file:
        records = file.readlines()
        for record in records:
            print(record, end="")
# 示例操作
append_record("2023-04-05", "Groceries", 35.20)
append_record("2023-04-06", "Internet Bill", 50)
read_records()
评分标准:
(1)a 或等效答案;(2分)
(2)ledger.txt 或等效答案; (2分)
(3)readlines 或等效答案; (3分)
(4)read_records 或等效答案。(3分)
说明:1. "a" (2分) 使用模式"a"(追加模式)打开文件,这样可以在文件末尾追加内容而不是覆盖现有内容。 2."ledger.txt" (2分) 这里需要打开的文件名是ledger.txt,以只读模式打开。 3. readlines (3分) readlines()方法读取文件的每一行作为一个字符串对象,并返回一个包含这些字符串的列表。 4.read_records() (3分) 调用read_records()函数来打印出所有已保存的消费记录。这显示了函数定义和函数调用之间的关系。
登陆情况
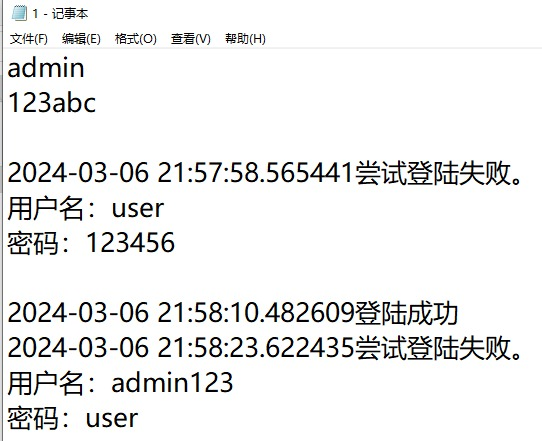
编写一段程序,记录用户的登陆情况。已知程序目录下建立了文件1.txt,第一行内容为:admin,第二行内容为:123abc。运行以下程序几次后,打开1.txt,其内容如图所示,请补全代码。
import datetime
import shutil
# /data 目录为共享目录,只读
# ./目录为用户沙盒目录可写
shutil.copyfile('/data/1.txt', "./1.txt")
with open('1.txt','r+') as f:
a=f.readline()
b=f.readline()
c= ①
d= ②
if ③ :
now = datetime.datetime.now()
f.write('\n')
f.write(str(now))
f.write('登陆成功')
print('登陆成功')
else:
now = datetime.datetime.now()
f.write('\n')
f.write(str(now))
f.write('尝试登陆失败。')
f.write('\n用户名:')
f.write(str(c))
f.write('密码:')
f.write(str(d))
print('登陆失败')
f.close()
import datetime
import shutil

# /data 目录为共享目录,只读
# ./目录为用户沙盒目录可写
shutil.copyfile('/data/1.txt', "./1.txt")

with open('1.txt','r+') as f:
    a=f.readline()
    b=f.readline()
    c=input('用户名:')+'\n'
    d=input('密码:')+'\n'
    if c==a and d==b:
       now = datetime.datetime.now()
       f.write('\n')
       f.write(str(now))
       f.write('登陆成功')
       print('登陆成功')
    else:
       now = datetime.datetime.now()
       f.write('\n')
       f.write(str(now))
       f.write('尝试登陆失败。')
       f.write('\n用户名:')
       f.write(str(c))
       f.write('密码:')
       f.write(str(d))
       print('登陆失败')
    f.close()
评分标准:
(1)input('用户名:')+'\n' 或等效答案;(3分)
(2)input('密码:')+'\n' 或等效答案; (3分)
(3)c==a and d==b 或等效答案。 (4分)
说明:f.readline()读取的结果包含'\n',所以输入的用户名中要加入'\n',没有加'\n'的答案得1分。
纸灯笼
小明想设计一个程序,用于计算制作长方体灯笼所需要的材料。用铁丝制作长方体的框架(棱长),用A4纸制作长方体的各个面。A4纸尺寸为20cm x 30cm。请补全程序。
class Box():
def __init__(self,l,w,h):
self.l=l
self.w=w
self.h=h
def a4(self):
return float((self.l*self.w*2+self.l*self.h*2+ ① )/600)
def chang(self):
return (self.l+self.w)*4+ ②
a,b,c=input('输入箱子的长宽高(cm):').split()
a=float(a)
b=float(b)
c=float(c)
d=Box(a,b,c)
print("共需要铁丝:%dcm,A4纸:%0.2f张。"%( ③ , ④ ))
class Box():
    def __init__(self,l,w,h):
        self.l=l
        self.w=w
        self.h=h
    def a4(self):
        return float((self.l*self.w*2+self.l*self.h*2+self.w*self.h*2)/600)
    def chang(self):
        return (self.l+self.w)*4+self.h*4
a,b,c=input('输入箱子的长宽高(cm):').split()
a=float(a)
b=float(b)
c=float(c)
d=Box(a,b,c)
print("共需要铁丝:%dcm,A4纸:%0.2f张。"%(d.chang(),d.a4()))销售记录
在一家便利店中,有一个记录零食销售情况的文件 snack_sales.txt。文件里每一行都代表了一次零食的销售记录,格式为:零食名称,销售数量,示例如下:
读取这个文件,统计出每种零食的总销售数量的Python程序段如下,请补全代码。
snack_sales = {}
with open('/data/ ① ', 'r', encoding='utf-8') as file:
for line in file:
snack, quantity = line.strip().split(',')
quantity = ②
if snack in snack_sales:
snack_sales[snack] += quantity
else:
③
for snack in snack_sales:
print(f"{snack}总数量:", ④ )
snack_sales = {}
with open('/data/snack_sales.txt', 'r', encoding='utf-8') as file:
   for line in file:
       snack, quantity = line.strip().split(',')
       quantity = int(quantity)
       if snack in snack_sales:
           snack_sales[snack] += quantity
       else:
           snack_sales[snack] = quantity
for snack in snack_sales:
   print(f"{snack}总数量:",snack_sales[snack])
(1)snack_sales.txt(或等效答案);(2分)
(2)int(quantity)(或等效答案);(3分)
(3)snack_sales[snack] = quantity(或等效答案);(2分)
(4)snack_sales[snack](或等效答案)。(3分)
工资系统
某学校需要开发一个教师工资计算系统,该系统需要根据教师的职称、基本工资和课时工资自动计算每位教师的月工资。教师的工资由两部分组成:
结构工资 = 基本工资 × 职称系数
总工资 = 结构工资 + 课时工资
学校制定了不同职称对应的配置标准:
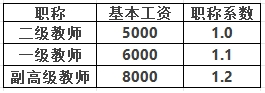
对于未列出的职称,使用默认值:基本工资5000,职称系数1.0。
输入输出示例
输入数据格式为元组:(姓名, 职称, 课时工资)
test_cases = [ ("张老师", "一级教师", 1200), ("李老师", "副高级教师", 1500),("王老师", "特级教师", 2000) ]
预期输出:
张老师(一级教师)总工资:7800.0
李老师(副高级教师)总工资:11100.0
王老师(特级教师)总工资:7000.0
相关Python程序如下,请补全代码完成功能实现。
TITLE_CONFIG = {
    "二级教师": {"coeff": 1.0, "base": 5000},
    "一级教师": {"coeff": 1.1, "base": 6000},
    "副高级教师": {"coeff": 1.2, "base": 8000}
}
class Teacher:
    def __init__(self, name, title, hourly_wage):
        self.name = name
        self.title = title
        self.hourly_wage = hourly_wage
        self.config = TITLE_CONFIG.get(title, {"coeff": 1.0, "base": 5000})
    def calculate_structural_salary(self):
        return self.config["base"] *         ①
    def total_salary(self):
        return self.calculate_structural_salary() +         ②
test_cases = [("张老师", "一级教师", 1200), ("李老师", "副高级教师", 1500), ("王老师", "特级教师", 2000)]
for case in test_cases:
             ③        = Teacher(*case)
print(f"{teacher.name}({teacher.title})总工资:{ ④ :.1f}")TITLE_CONFIG = {
"二级教师": {"coeff": 1.0, "base": 5000},
"一级教师": {"coeff": 1.1, "base": 6000},
"副高级教师": {"coeff": 1.2, "base": 8000}
}
class Teacher:
def __init__(self, name, title, hourly_wage):
self.name = name
self.title = title
self.hourly_wage = hourly_wage
self.config = TITLE_CONFIG.get(title, {"coeff": 1.0, "base": 5000})
def calculate_structural_salary(self):
return self.config["base"] * self.config["coeff"]
def total_salary(self):
return self.calculate_structural_salary() + self.hourly_wage
test_cases = [("张老师", "一级教师", 1200), ("李老师", "副高级教师", 1500), ("王老师", "特级教师", 2000)]
for case in test_cases:
teacher = Teacher(*case)
print(f"{teacher.name}({teacher.title})总工资:{teacher.total_salary():.1f}")评分标准:
(1)self.config["coeff"] (或等效答案);(3分)
(2)self.hourly_wage(或等效答案);(3分)
(3)teacher(或等效答案) ;(2分)
(4)teacher.total_salary()(或等效答案) 。(2分)