Python编程五级 题库
已知有一些学生数据,每名学生的信息是一个字典。所有学生信息放在列表中。
(1)计算每个学生的平均分(语文+数学+英语)/3,并对平均分取整,追加到其字典;
(2)根据学生的平均分从低到高排列;
(3)输出每位学生的学号和平均分。
输出格式如下:
20230103:72
20230102:82
20230101:92
程序模板如下:
students= [{'学号':'20230101','语文': 90,'数学':95,'英语':92},{'学号':'20230102','语文': 80,'数学':85,'英语':82},{'学号':'20230103','语文': 70,'数学':75,'英语':72}]
for student in students:
①
students.sort(key = lambda x:x['平均分'],reverse = False)
for student in students:
print('{}:{}'.format( ② , ③ ))
#参考程序:
students= [{'学号':'20230101','语文': 90,'数学':95,'英语':92},
{'学号':'20230102','语文': 80,'数学':85,'英语':82},
{'学号':'20230103','语文': 70,'数学':75,'英语':72}]
for student in students:
    student['平均分']=(student['语文']+student['数学']+student['英语'])//3

students.sort(key = lambda x:x['平均分'],reverse = False)
for student in students:
    print('{}:{}'.format(student['学号'],student['平均分']))
评分标准:
(1)student['平均分']=(student['语文']+student['数学']+student['英语'])//3 或等效答案;(4分)
(2)student['学号'] 或等效答案;(3分)
(3)student['平均分'] 或等效答案。(3分)
信息科技社团正在进行一种字符串扩展的实验,实验操作方法如下:
(1)给定一个初始字符串s,筛选出其中的大小写字母,生成新的字符串x;
(2)将字符串x最后一个字符删除,生成一个新的字符串y;
(3)将字符串x的右边最后一个字符拼接到字符串x的末尾;
(4)将字符串y拼接到字符串x的末尾。
按照(2)-(4)步骤重复操作,每一步将当前字符串的长度加倍,直到字符串x长度达到n。
给定初始字符串和n,请帮助社团同学们计算扩展的字符串中第n个位置的字符。
以s=“c1ar23”,n=8 为例
c1ar23 --> car --> carrca --> carrcaacarrc
第8个位置上的字符'c',则输出为c
输入格式:
第一行,一个字符串s(长度不超过20)
第二行,一个整数n(1<=n<=100)
输入样例:
c1ar23
8
输出格式:
一个字符,表示扩展的字符串中的第n个字符。
输出样例:
c
s=input()
n=int(input())
x=""
for i in s:
if ((i>='A' and i<='Z') ① ):
x=x+i
xn=len(x)
while xn<n:
y=x.replace( ② , '')
x=x+x[-1]
x=x+y
xn= ③
print( ④ )
#参考程序:
s=input()
n=int(input())
x=""
for i in s:
   if ((i>='A' and i<='Z')or(i>='a' and i<='z')):
      x=x+i
xn=len(x)
while xn<n:
   y=x.replace(x[-1], '')
   x=x+x[-1]
   x=x+y
   xn=len(x)
print(x[n-1])
评分标准:
(1)or(i>='a' and i<='z')或等效答案;(2分)
(2)x[-1]或等效答案;(2分)
(3)len(x)或等效答案;(3分)
(4)x[n-1]或等效答案。(3分)
火柴棍游戏
用火柴棍拼成数字 0~9,具体拼法如图所示:
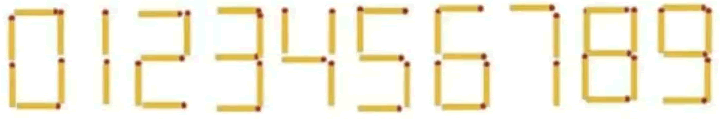
编写 Python 程序,实现输入火柴棍的数量,输出符合该火柴棍数的三位数组合,若找不到,则输出“没有符合要求的数”,见样例,程序如下:
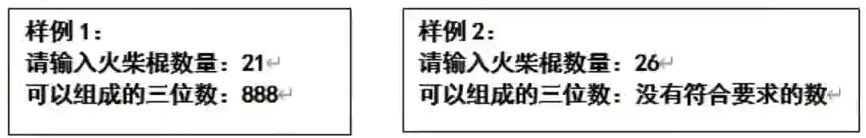
请在划线处填入合适代码。
code={0:6,1:2,2:5,3:5,4:4,5:5,6:6,7:3,8:7,9:6}
num=int(input("请输入火柴棍数量:"))
flag=False
for i in range( ① ):
if ② +code[i//10%10]+ ③ ==num:
print("可以组成的三位数:",i,sep="")
flag=True
if ④ :
print("可以组成的三位数:","没有符合要求的数",sep="")
code={0:6,1:2,2:5,3:5,4:4,5:5,6:6,7:3,8:7,9:6}
num=int(input("请输入火柴棍数量:"))
flag=False
for i in range(100,1000):
    if code[i//100]+code[i//10%10]+code[i%10]==num:
        print("可以组成的三位数:",i,sep="")
        flag=True
if flag==False:
print("可以组成的三位数:","没有符合要求的数",sep="")知识竞赛活动
学校开展“学宪法"知识竞赛活动,其中有一项任务为完成“学宪法”答卷记得分。答卷含有 5 个客观题和 5 个主观题,其中客观题 1-4 题为单选题,第 5题为多选题,单选题每题分值为 2 分;多选题全对得 2 分,漏选、少选得 1 分, 多选错选不得分。为了提高改卷效率,学校信息技术组的老师设计并编写了一个 Python 小程序,输入客观题正确答案和答卷上的答案,即可计算得分。
实现上述功能的 Python 程序如下,运行界面如图所示。
请输入客观题(5 道)标准答案:AABDACD
请输入客观题(5 道)题学生答案:ABBDAC
该学生客观题得分为:7 分
实现上述功能的 Python 程序如下,请在划线处填入合适的代码。
def judge(x,y):
f=True
i=0
while i<len(y):
if y[i] not in x:
①
break
i+=1
return f
num=0
key=input("请输入客观题(5 道)标准答案:")
s=input("请输入客观题(5 道)题学生答案:")
for j in range(5):
if j==4:
if key[j:len(key)]==s[j:len(s)]:
num+=2
elif ② :
num+=1
else:
if s[j]==key[j]:
③
print("该学生客观题得分为:"+ ④ +"分")
def judge(x,y):
    f=True
    i=0
    while i<len(y):
        if y[i] not in x:
            f=False
            break
        i+=1
    return f
num=0
key=input("请输入客观题(5 道)标准答案:")
s=input("请输入客观题(5 道)题学生答案:")
for j in range(5):
    if j==4:
        if key[j:len(key)]==s[j:len(s)]:
            num+=2
        elif judge(key[j:len(key)],s[j:len(s)]):
            num+=1
    else:
        if s[j]==key[j]:
            num+=2
print("该学生客观题得分为:"+str(num) +"分")
(1)f=False 或等效答案;(3 分)
(2)judge(key[j:len(key)],s[j:len(s)]) 或等效答案;(3 分)
(3)num+=2 或等效答案;(2 分)
(4)str(num) 或等效答案。(2 分)
说明:
①judge 函数判断多选题的漏选情况,y[i] not in x:说明错选,直接返回 false。同时可以判断,x 是标准答案,y 是学生答案。
②j==4 说明该分支处理多选题,key[j:len(key)]==s[j:len(s)]说明多选题全队得 2分,所以②处分支表示漏选的情况,得 1 分,将标准答案和学生答案作为参数传给自定义函数 judge 进行判断。
③该分支下,j<=4,说明在处理单选题,标准答案 key[j]与学生答案 s[j]一致说明正确,得两分。
④得分是 num,与字符串拼接,因此答案是 str(num) 。
单词表问题
小明是一名学生,他正在学习英语单词的拼写。他想要创建一个单词表,用于存储他学习过的单词,并统计每个单词出现的次数。请你帮助他补全代码完成以下任务:
(1)创建一个空的字典 word_dict,用于存储单词和对应的出现次数;
(2)使用 input() 函数,提示小明输入一个单词,并将其存储到变量 word 中;
(3)检查字典 word_dict 中是否已经存在该单词。如果存在,则将该单词的出现次数加一;如果不存在,则将该单词添加到字典中,并将其出现次数设置为一;
(4)重复步骤 2 和步骤 3,直到小明输入字符串's'为止;
(5)创建一个空的集合 unique_words,用于存储所有不重复的单词;
(6)遍历字典 word_dict 的键(即单词),将每个键添加到集合 unique_words 中;
(6)打印出字典 word_dict 中每个单词和对应的出现次数;
(8)打印出集合 unique_words 中的所有不重复的单词。
样例:
输入
请输入一个单词:hello
请输入一个单词:world
请输入一个单词:hello
请输入一个单词:python
请输入一个单词:s
输出
单词和出现次数:
hello : 2
world : 1
python : 1
不重复的单词:
world
hello
python
程序:
word_dict = {}
while True:
word = input("请输入一个单词:")
if word == "s":
break
if word in word_dict:
①
else:
word_dict[word] = 1
unique_words = ②
for word in word_dict:
unique_words.add(word)
print("单词和出现次数:")
for word in word_dict:
③
print("不重复的单词:")
for word in unique_words:
④
参考程序:
# 创建空的字典存储单词和出现次数
word_dict = {}
# 使用input()函数获取单词并更新字典
while True:
	word = input("请输入一个单词:")
	if word == "s":
		break
	if word in word_dict:
		word_dict[word] += 1
	else:
		word_dict[word] = 1
# 创建空的集合存储不重复的单词
unique_words = set()
# 遍历字典的键并添加到集合中
for word in word_dict:
	unique_words.add(word)
# 打印字典中每个单词和对应的出现次数
print("单词和出现次数:")
for word in word_dict:
print(word, ":", word_dict[word])
# 打印集合中的不重复单词
print("不重复的单词:")
for word in unique_words:
print(word)
评分标准:
(1)word_dict[word] += 1或等效答案;(3分)
(2)set()或等效答案;(2分)
(3)print(word, ":", word_dict[word])或等效答案;(4分)
(4)print(word)或等效答案。(1分)
打字正确率问题
设计一个判断打字正确率程序。
如样板字符串为“我爱你中国”,如果输入的字符串长度与样板字符串长度相同,则调用编程模板中Percentage函数去计算这两个字符串对应位置相同的字符个数占字符总长度的百分比,按照示例的格式输出;
例如:
如果样板字符串为“我爱你中国”
输入字符串“我爱你中国”
输出:
匹配率:100%
输入字符串"我爱你中华"
输出:
匹配率:80%
输入字符串“我爱你”
输出:
输入字符串长度不一致,请重新运行本程序!
样板程序:
def Percentage(source,target):
s_list= ①
t_list= ②
c_list= ③
return len(c_list)/len(s_list)
s1 = "我爱你中国"
print("请输入以下内容:\n"+s1)
s2 = input()
if ④ :
print("输入字符串长度不一致,请重新运行本程序!")
else:
print( ⑤ )
参考程序:
def Percentage(source,target):
	s_list=list(source)
	t_list=list(target)
	c_list=[i for i in range(len(s_list)) if s_list[i]==t_list[i]]
	return len(c_list)/len(s_list)
s1 = "我爱你中国"
print("请输入以下内容:\n"+s1)
s2 = input()
if len(s1)!=len(s2):
	print("输入字符串长度不一致,请重新运行本程序!")
else:
	print("匹配率:{:.0%}".format(Percentage(s1,s2)))
评分标准:
(1)list(source)或等效答案;(1分)
(2)list(target)或等效答案;(1分)
(3)[i for i in range(len(s_list)) if s_list[i]==t_list[i]]或等效答案;(3分)
(4)len(s1)!=len(s2)或等效答案;(2分)
(5)"匹配率:{:.0%}".format(Percentage(s1,s2))或等效答案。(3分)
Base64 编码
小王在学习信息技术时,对编码产生了浓厚的兴趣,她听老师说Base64 编码是计算机常见的一种编码方式,于是她决定尝试自己编写一个简单的Base64 编码工具。经过她的研究,发现Base64 编码规则是把 3 个字节(24 位)的数据按 6 位一组分成4组(24÷6=4),然后将每组数据分别转换为十进制,根据图 1 将这些十进制数所对应的字符连接,即为Base64编码。
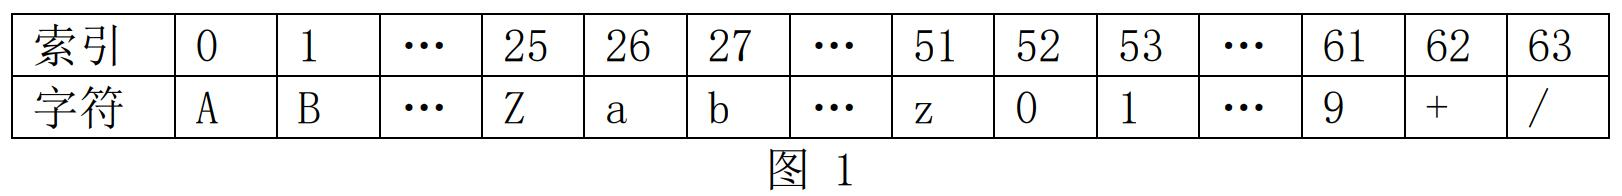
以编码字符“Win”为例,如图 2 所示,字符“Win”对应的 ASCII 编码分别是 87,105,110,分别转换为8位二进制数,按 6 位二进制数分组后再转换成十进制,查找它们对应的字符,得到 “Win”的 Base64编码为“V2lu”。
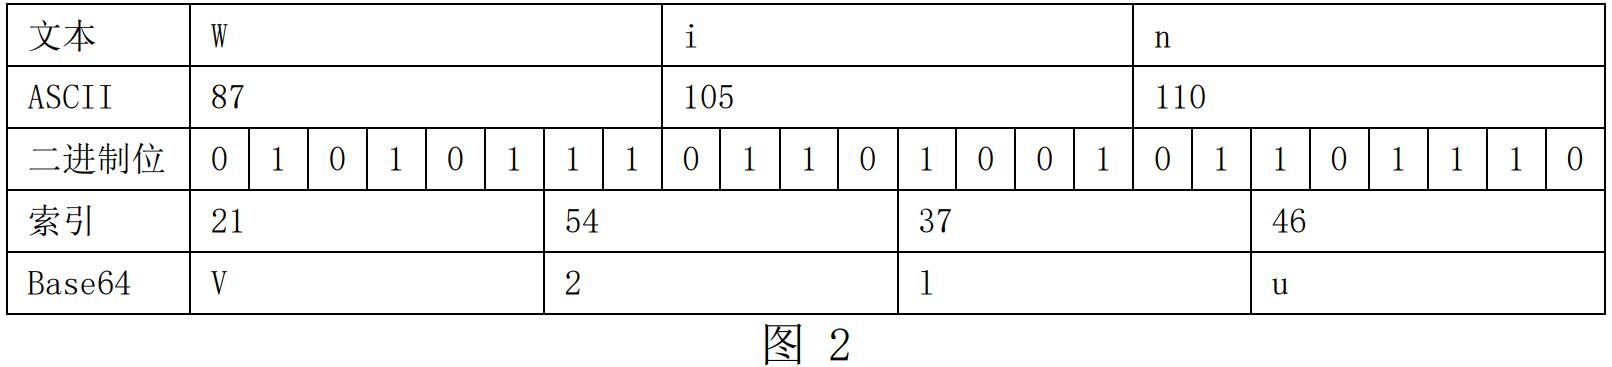
编写一个 Python 程序,实现上述功能。程序运行时,输入若干个字符(个数必须是 3 的倍数),输出 Base64 编码。实现上述功能的 Python 代码如下,请在划线处填入合适的代码。
s1=input("请输入编码字符:")
tmp=0
s=""
ans=""
Base64="ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789+/"
for x in s1:
            ①
    t=""
    for i in range(8): #将十进制数 n 转换为 8 位二进制
        r=n%2
                ②
        n=n//2
    s=s+t
for i in range(len(s)): #6位二进制一组转换成十进制,查找 Base64 对应字符
            ③
    if i%6==5:
        ans=ans+Base64[tmp]
                ④
print("Base64编码:",ans)s1=input("请输入编码字符:")
tmp=0
s=""
ans=""
Base64="ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz0123456789+/"
for x in s1:
n=ord(x)
t=""
for i in range(8): #将十进制数 n 转换为 8 位二进制
r=n%2
t=str(r)+t
n=n//2
s=s+t
for i in range(len(s)): #6位二进制一组转换成十进制,查找 Base64 对应字符
tmp=tmp*2+int(s[i])
if i%6==5:
ans=ans+Base64[tmp]
tmp=0
print("Base64编码:",ans)评分标准:
(1)n=ord(x) 或等效答案;(2分)
(2)t=str(r)+t 或等效答案;(2分)
(3)tmp=tmp*2+int(s[i]) 或 tmp=tmp*2+ord(s[i])-ord('0') 或等效答案;(3分)
(4)tmp=0 或等效答案。(3分)
说明:①处应逐个获取编码字符的ASCII编码,再接下来的for循环中转换为8位二进制,除基取余逆序排列,因此②处应是逆序排列,答案是str(r)+t。每次循环将每个编码字符转换为八位二进制。③处应该将②处转换的所有二进制六位一组转换为十进制,所以③处应该是按权相加转换为十进制即可。④处,实现6位一组的功能,将得到的十进制转换为相应的Base64编码,之后转换下一个6位一组,临时变量tmp清0。
注册用户
一个网站在注册新用户时,对用户名和密码的要求如下:
(1)用户名必须是以数字1开头的11位纯数字;例如:12345678912
(2)密码长度6——20,必须包含英文字母、数字。例如:python123
(3)输入一个QQ邮箱,以备找回密码。例如147258369@qq.com,qq号为纯数字,以qq.com结尾。
小华编写一个程序,首先验证一下准备使用的账号密码是否符合该网站的要求。
请补全下列程序,实现此功能。
name=input('请输入准备使用的账号:')
password=input('请输入准备使用的密码:')
mail=input('请输入准备使用的邮箱:')
name_check=False
password_check=False
mail_check=False
if name.isdigit() and len(name)==11 and ① :
name_check=True
if password.isalnum() and ( ② ):
password_check=True
if mail.endswith("@qq.com"):
mail_name= ③
if mail_name.isdigit():
mail_check=True
if name_check and password_check and mail_check:
print('账号、密码、邮箱均符合要求,可以注册!')
elif name_check==False:
print('账号不符合要求,请重新填写!')
elif ④ :
print('密码不符合要求,请重新填写!')
elif mail_check==False:
print('邮箱不符合要求,请重新填写!')
else:
print('未知情况,请重新填写!')
———————分割线,以下为程序输入输出结果—————————
请输入准备使用的账号:12345678912
请输入准备使用的密码:python123
请输入准备使用的邮箱:147258369@qq.com
账号、密码、邮箱均符合要求,可以注册!
name=input('请输入准备使用的账号:')
password=input('请输入准备使用的密码:')
mail=input('请输入准备使用的邮箱:')
name_check=False
password_check=False
mail_check=False
if name.isdigit() and len(name)==11 and name[0]=='1':
    name_check=True
if password.isalnum() and (6<=len(password)<=20):
    password_check=True
if mail.endswith("@qq.com"):
    mail_name=mail[:-7]
    if mail_name.isdigit():
        mail_check=True
if name_check and password_check and mail_check:
    print('账号、密码、邮箱均符合要求,可以注册!')
elif name_check==False:
    print('账号不符合要求,请重新填写!')
elif password_check==False:
    print('密码不符合要求,请重新填写!')
elif nmail_check==False:
    print('邮箱不符合要求,请重新填写!')
else:
    print('未知情况,请重新填写!')
评分标准:
(1)name[0]=='1' 或name.startswith('1') 或等效答案;(3分)
(2)6<=len(password)<=20 或6<=len(password) and len(password)<=20 或等效答案;(2分)
(3)mail[:-7] 或等效答案;(3分)
(4)password_check==False或 not password_check 或 password_check!=True 或等效答案。(2分)
密码问题:
根据密码本和电子钥匙,破解笔记本电脑的密码。
密码本是一个非降的整数序列,电子钥匙是一个整数,得到密码的方法是在密码本中找到最接近电子钥匙的整数(如果多个符合条件,输出最小的一个)。
例如:
密码本为下面的列表
a=[1,22,43,45,45,55,60,70,89]
电子钥匙为整数44
满足条件的整数为43和45,最终的密码为43
补全下面的代码:
a=[1,22,43,45,45,55,60,70,89] #密码本
k=int(input()) #k为电子钥匙
l=0
r=8
while l+1!=r:
mid=int ( ① )
if a[mid]<k:
②
else:
r=mid
if a[r]==k:
③
if k-a[l] <= ④ :
print(a[l])
else:
print(⑤)
① (l+r)/2(2分)
② l=mid(2分)
③ break(2分)
④ a[r]-k(2分)
⑤ a[r](2分)
a = [1,22,43,45,45,55,60,70,89]
k = int(input())
l = 0
r = 8
while l+1 != r:
    mid = int((l+r)/2)
    if a[mid] < k:
        l = mid
    else:
        r = mid
    if a[r] == k:
        break
if k-a[l] <= a[r]-k:
    print(a[l])
else:
    print(a[r])
罗马数字问题:
罗马数字包含以下七种字符: I, V, X, L,C,D 和 M。
27写做 XXVII,即为 XX + V + II 。通常情况下,罗马数字中小的数字在大的数字的右边。但也存在特例,例如 4 不写做 IIII而是 IV。数字 1 在数字 5 的左边,所表示的数等于大数 5 减去数 1 得到的数值 4。同样地,数字 9 表示为 IX。
这个特殊的规则只适用于以下六种情况:
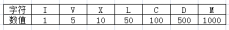
I 可以放在 V (5) 和 X (10) 的左边,来表示 4 和 9。
X 可以放在 L (50) 和 C (100) 的左边,来表示 40 和 90。
C 可以放在 D (500) 和 M (1000) 的左边,来表示 400 和 900。
现编写输入一个罗马数字,输出其整数结果,请编程实现上述功能,或补全代码。
例如,当输入XXII时,输出22;当输入MCMXC时,输出1990.
rmdict = {'I':1,'V':5,'X':10,'L':50,'C':100,'D':500,'M':1000}
rm = list(input("请输入正确的罗马数字:"))
num, prew = 0, 1
for ch in rm[::-1]:
w = ①
if prew > w:
num = num - w
else :
num = num + w
prew = ②
print( ③ )
① rmdict[ch] (4分)
② w (3分)
③ num (3分)
rmdict = {'I':1,'V':5,'X':10,'L':50,'C':100,'D':500,'M':1000}
rm = list(input("请输入正确的罗马数字:"))
num, prew = 0, 1
for ch in rm[::-1]:
   w = rmdict[ch]
   if prew > w:
      num = num - w
   else :
      num = num + w
   prew = w
print(num)输入年月日,计算这一天是这一年的第几天。编写自定义函数完成程序功能,完善程序代码。
"""
根据年月日,计算这一天是这一年的第几天
函数名 def getDays(year)
参数 year:表示日期;字符串类型如20211201
返回值 :整数。表示这一天是这年的第几天
"""
def getDays(year):
s = 0
y = int(year[:4])
m = int(year[4:6])
d = int(year[6:8])
monthdays = (31,28,31,30,31,30,31,31,30,31,30,31)
for i in range( ① ):
s = s + ②
if (y % 4 ==0 and y % 100 !=0 or y % 400 ==0) and ③ :
s = s + 1
s = s + d
return s
year = "20211201"
theday = ④
print(theday)
标准答案及评分标准:
①m-1 (3分)
②monthdays[i] (3分)
③m > 2 (3分)
④getDays(year) (1分)
参考程序:
def getDays(year):
    s = 0
    y = int(year[:4])
    m = int(year[4:6])
    d = int(year[6:8])
    monthdays = (31,28,31,30,31,30,31,31,30,31,30,31)
    for i in range(m-1):
        s = s + monthdays[i]
    if (y % 4 ==0 and y % 100 !=0 or y % 400 ==0) and m > 2:
        s = s + 1
    s = s + d
    return s
year = "20211201"
theday = getDays(year)
print(theday)
设计一个算法,汉诺塔(又称河内塔)问题是源于印度一个古老传说的益智玩具。大梵天创造世界的时候做了三根金刚石柱子,在一根柱子上从下往上按照大小顺序摞着64片黄金圆盘。大梵天命令婆罗门把圆盘从下面开始按大小顺序重新摆放在另一根柱子上。并且规定,在小圆盘上不能放大圆盘,在三根柱子之间一次只能移动一个圆盘。有三个单字符字符串和一个整数。三个字符表示三个杆子的编号,整数为盘子的数目。
根据上述计算规则,补全下列代码。
函数名:hannota(n,a,b,c)
参数表:n -- 正整数表示盘子数,a --a杆子,b --b杆子,c --c杆子。
返回值:移动路径。
示例:n=3,返回:
A --> C
A --> B
C --> B
A --> C
B --> A
B --> C
A --> C
def hannota(n,a,b,c):
if n == 1:
print(a ,"-->", c)
return None
if n == 2:
print(a,"-->",b)
Print( ① )
print(b,"-->",c)
return None
Hannota( ② )
print(a,"-->",c)
Hannota( ③ )
a = "A"
b = "B"
c = "C"
n =int(input('请输入黄金圆盘数量n:'))
hannota(n,a,b,c)
标准答案及评分标准:
①a, "-->" ,c 或等效答案;(3分)
② n-1,a,c,b 或等效答案;(3分)
③ n-1,b,a,c 或等效答案;(4分)
参考程序:
def hannota(n,a,b,c):
    if n == 1:
        print(a ,"-->", c)
        return None
    if n == 2:
        print(a,"-->",b)
        print(a,"-->",c)
        print(b,"-->",c)
        return None
    hannota(n-1,a,c,b)
    print(a,"-->",c)
    hannota(n-1,b,a,c)
a = "A"
b = "B"
c = "C"
n =eval(input('请输入黄金圆盘数量n:'))
hannota(n,a,b,c)阅读积分分享
社团组织开展阅读积分分享活动。每位成员都准备了一些积分赠送其他成员,这些积分平均分给对应的受赠予的人。给出社团成员姓名以及对应的现有积分、准备赠送的积分、接收赠送的社团成员信息,请计算每位社团成员的当前积分。
输入格式:
第1行:人数n,2≤ n≤10
第2到n+1行:每行包含一个字符串,表示每个人的姓名;一个整数,表示现有的积分。互相之间用空格隔开。
第n+2到最后,描述某个人赠送积分的信息:
某个人的第(1)行是赠送积分的同学姓名。
某个人的第(2)行包含2个数字:分别表示准备赠送积分数值v(0<=v<=2000),接受赠予的同学人数x ,互相之间用空格隔开。
如果x是非零的, 在接下来x行,列出每位接受赠予的同学姓名,一个姓名一行。
输入样例:
3
alien 5267
mars 3098
moon 2761
mars
1500 2
alien
moon
alien
500 1
mars
moon
0 0
输出格式:
输出共n行,
每行包含一个字符串表示社团成员的姓名,和现有的积分值。互相之间用空格隔开。
输出样例:
alien 5517
mars 2098
moon 3511
#代码如下:
n=int(input())
name=[];score=        ①
for i in range(1,n+1):
    a,b = input().split(' ',1)
    score[a]=int(b)
for i in range(1,n+1):
    s=input()
    v,x= map(int, input().split())
    if (x>0):
       w=        ②
       score[s]-=w*x
    for j in range(1,x+1):
       t=input()
       score[t]+=         ③
for i in score.keys():
print(i, ④ )n=int(input())
name=[];score={}
for i in range(1,n+1):
a,b = input().split(' ',1)
score[a]=int(b)
for i in range(1,n+1):
s=input()
v,x= map(int, input().split())
if (x>0):
w=v//x
score[s]-=w*x
for j in range(1,x+1):
t=input()
score[t]+=w
for i in score.keys():
print(i,score.get(i))评分标准:
(1){}(或等效答案);(2分)
(2)v//x(或等效答案);(2分)
(3)w(或等效答案);(3分)
(4)score.get(i)(或等效答案)。(3分)
合并有序列表
现有两个列表中的数据已经分别升序排好,要求将两个列表合并到一个新列表中,最终结果依旧升序。例如两个有序列表为a=[11,25,64,75,88]和b=[10,33,46,50,90],最终合并到列表c中,结果为:[10, 11, 25, 33, 46, 50, 64, 75, 88, 90]
实现上述功能的Python程序如下,请在划线处填入合适的代码。
a=[11,25,64,75,88]
b=[10,33,46,50,90]
c=[0]*10
i=0
j=0
k=0
while ① : #当列表a或列表b中的数据未合并完,继续循环
if i==len(a): #当列表a中数据已经合并完,只需将列表b中的数据合并
②
j+=1
elif j==len(b): #当列表b中数据已经合并完,只需将列表a中的数据合并
c[k]=a[i]
i+=1
elif ③ : #当列表a和列表b中的数据都未合并完,将较小值合并到列表c中
c[k]=a[i]
i+=1
else:
c[k]=b[j]
j+=1
④ #每合并完一个数据,列表c中的指针k往后走一步
print(c)
a=[11,25,64,75,88]
b=[10,33,46,50,90]
c=[0]*10
i=0
j=0
k=0
while i<len(a) or j<len(b): #当列表a或列表b中的数据未合并完,继续循环
    if i==len(a):      #当列表a中数据已经合并完,只需将列表b中的数据合并
        c[k]=b[j]
        j+=1
    elif j==len(b):    #当列表b中数据已经合并完,只需将列表a中的数据合并
        c[k]=a[i]
        i+=1
    elif a[i]<b[j]:     #当列表a和列表b中数据都未合并完,将较小值合并到列表c中
        c[k]=a[i]
        i+=1
    else:
        c[k]=b[j]
        j+=1
    k+=1      #每合并完一个数据,列表c中的指针k往后走一步
print(c)
验证邮箱
小明用Python语言写了一个验证邮箱地址和密码是否符合要求的程序。邮箱地址,例如1a2b3c4d56@sina.com,“@”前面的字段叫用户名,“@”后面的字段叫域名。小明的验证程序要求邮箱地址长度不小于15位,同时用户名包含字母和数字。邮箱密码的长度不小于8位,要同时包含大写字母、小写字母以及数字。下面是小明写的程序代码,请你补全横线处的代码,实现前面描述的功能。
# 验证邮箱地址
email = input("请输入邮箱地址: ")
DiZhi = False
if ① and '@' in email and '.' in email:
YongHuMing, YuMing = ②
if YongHuMing and YuMing and '.' in YuMing:
if any(char.isdigit() for char in YongHuMing) and any( ③ for char in YongHuMing):
DiZhi = True
# 验证密码
password = input("请输入密码: ")
MiMa = False
if len(password) >= 8:
DaXie = any(char.isupper() for char in password)
XiaoXie = any(char.islower() for char in password)
ShuZi = any(char.isdigit() for char in password)
if DaXie and XiaoXie and ShuZi:
MiMa = True
# 输出结果
if ④ :
print("邮箱地址和密码格式均正确。")
else:
if not DiZhi:
print("邮箱地址格式不正确。")
if not MiMa:
print("密码格式不正确。")
# 验证邮箱地址
email = input("请输入邮箱地址: ")
DiZhi = False
#①字符串的长度,邮箱地址长度不小于15位
if len(email) >= 15 and '@' in email and '.' in email:
    YongHuMing, YuMing = email.split('@') #②分割字符串,把邮箱地址用“@”分割成用户名和域名
    if YongHuMing and YuMing and '.' in YuMing:
        #③字符串的常用方法,判断是否含有字母
        if any(char.isdigit() for char in YongHuMing) and any(char.isalpha() for char in YongHuMing):
            DiZhi = True
# 验证密码
password = input("请输入密码: ")
MiMa = False
if len(password) >= 8:
    DaXie = any(char.isupper() for char in password)
    XiaoXie = any(char.islower() for char in password)
    ShuZi = any(char.isdigit() for char in password)
    if DaXie and XiaoXie and ShuZi:
        MiMa = True
# 输出结果
#④字符串不为空时,逻辑值为True。逻辑运算,两个条件同时满足进入分支语句。
if DiZhi and MiMa:
    print("邮箱地址和密码格式均正确。")
else:
    if not DiZhi:
        print("邮箱地址格式不正确。")
    if not MiMa:
print("密码格式不正确。")字符消消乐
有一个字符消消乐游戏。随机产生一串长度为n只包含数字“456”的字符串,如有连续相同的字符则进行消除,提示:字符“0”的 ASCII码值是十进制48。
如字符串“455655565”,其消除过程如下:
第一步:消除字符“5”后形成新字符串“4655565”;
第二步,消除字符“5”后形成新字符串“4665”;
第三步,消除字符“6”后形成新字符串“45”;
最后消除结束,结果为“45”。
实现上述功能的Python程序如下,请在划线处填入合适的代码。
import random
n=int(input("请输入字符串长度:"))
s=""
for i in range(n):         #生成n个由"456"字符组成的字符串
   m=random.randint(4,6)
   s=s+chr(48+        ①        )
print("字符串为:",s)
i=0
while i<len(s):     #变量i存储连续相同字符的起始位置索引
   r=i    #变量r存储连续相同字符的末尾位置索引
   while r<len(s)-1 and          ②         :   #留意r值的范围,索引不能越界
       r=r+1
   if         ③        :       #当有2个及以上连续相同的字符,需要消除
       s=s[:i]+        ④
               ⑤
   else:
       i=i+1
print("消除后,字符串为:",s)import random
n=int(input("请输入字符串长度:"))
s=""
for i in range(n): #生成n个由“456”字符组成的字符串
m=random.randint(4,6)
s=s+chr(48+m)
print("字符串为:",s)
i=0
while i<len(s): #枚举思想,变量i存储连续相同字符的起始位置索引
r=i #变量r存储连续相同字符的末尾位置索引
while r<len(s)-1 and s[r]==s[r+1]: #留意r值的范围,索引不能越界
r=r+1
if i<r: #当i<r时,说明有2个及以上连续相同的字符,需要消除
s=s[:i]+s[r+1:] #字符串为不可变序列,需要通过切片重组,消除s[i:r+1]部分子串
i=i-1 #消除后返回到前一个字符位置,判断是否与后续字符相同
else:
i=i+1
print("消除后,字符串为:",s)评分标准:
(1)m(或等效答案);(2分)
(2)s[r]==s[r+1] (或等效答案);(2分)
(3)i<r (或等效答案);(2分)
(4)s[r+1:] (或等效答案);(2分)
(5)i=i-1 或i-=1 (或等效答案)。 (2分)
状态关键词
小李将一个月内某平台上每天的状态关键词(美滋滋、忙、疲惫......)保存在了文本文件"state.txt"中,现在他编写了一个Python程序,用来统计一个月内出现次数最多的状态关键词及次数,如果有多个状态关键词并列最多,则输出第一个。
具体思路如下:
(1)将文本文件中的状态关键词通过jieba模块进行分词,并保存在列表中; 分词结果:
['美滋滋', '裂开', '运动', '疲惫', '发呆', '冲', '学习', '学习', '胡思乱想', '忙', '元气', '美滋滋', '美滋滋', '美滋滋', '美滋滋', '美滋滋', '裂开', '运动', '疲惫', '发呆', '冲', '胡思乱想', '元气', '裂开', '运动', '忙', '美滋滋', '美滋滋', '发呆', '摸鱼', '回家'](2)通过字典统计每个状态关键词的出现次数;
(3)通过比较,找出出现次数最多的状态关键词。
输出结果:
出现最多的状态是: 美滋滋 次数为: 8
实现上述功能的Python程序如下,请在划线处填入合适的代码。
"""
import jieba
txt=open("/data/state.txt","r",encoding="utf-8").read()
words=jieba. ① (txt) #jieba模块分词的结果存放在列表中
"""
words=['美滋滋', '裂开', '运动', '疲惫', '发呆', '冲', '学习', '学习', '胡思乱想', '忙', '元气', '美滋滋', '美滋滋', '美滋滋', '美滋滋', '美滋滋', '裂开', '运动', '疲惫', '发呆', '冲', '胡思乱想', '元气', '裂开', '运动', '忙', '美滋滋', '美滋滋', '发呆', '摸鱼', '回家']
maxlen=1 #变量maxlen存放最多出现次数
maxd=0 #变量maxd存放最多出现次数的状态关键词在列表中的位置
dic={} #字典dic存放每个状态关键词及其出现次数
i=0
while i<len(words):
if words[i] not in dic:
②
else:
dic[words[i]]+=1
if ③ :
maxd=i
maxlen=dic[words[i]]
i+=1
print("出现最多的状态是:", ④ ,"次数为:",maxlen)
"""
import jieba
txt=open("/data/state.txt","r",encoding="utf-8").read()
words=jieba.lcut(txt)    #jieba模块分词,lcut方法分词结果存放在列表中
"""
words=['美滋滋', '裂开', '运动', '疲惫', '发呆', '冲', '学习', '学习', '胡思乱想', '忙', '元气', '美滋滋', '美滋滋', '美滋滋', '美滋滋', '美滋滋', '裂开', '运动', '疲惫', '发呆', '冲', '胡思乱想', '元气', '裂开', '运动', '忙', '美滋滋', '美滋滋', '发呆', '摸鱼', '回家']
maxlen=1      #变量maxlen存放最多出现次数
maxd=0     #变量maxd存放最多出现次数的状态关键词在列表中的位置(索引)
dic={}    #创建空字典,用来存放状态关键词和次数
i=0
while i<len(words):    #遍历列表中的关键词,变量i为关键词的索引
   if words[i] not in dic:    #如果关键词未在字典中,增加一个键值对,次数初始值为1
       dic[words[i]]=1
   else:
       dic[words[i]]+=1   #如果关键词已经在字典中,更新次数的值
       if dic[words[i]]>maxlen:   #比大小,更新变量maxd和maxlen
           maxd=i
           maxlen=dic[words[i]]
   i+=1
print("出现最多的状态是:",words[maxd],"次数为:",maxlen)
#出现最多的状态关键词需要去列表中获取
(1)lcut 或等效答案;(2分)
(2)dic[words[i]]=1 或等效答案;(3分)
(3)dic[words[i]]>maxlen 或等效答案;(3分)
(4)words[maxd] 或等效答案。(2分)
知识竞答
小美参加环保知识竞答比赛,回答结果存储在字符串中,其中回答正确用“T"表示,回答错误用“F”表示。回答错误不得分,连续答对k题,则第k题加k分。下面的自定义函数能根据答案字符串计算小美的总分数,它的形式参数ans是一个只包含"F"和"T"两种字符的字符串,函数根据得分规则和答案字符串计算出总分数。例如当ans="FTTTFTTFFT"时,函数返回10;ans="TTTTFFTFTF"时,函数返回12。实现上述功能的程序如下,请在程序划线处填入合适的代码。
def get_score(ans):
k,s=0,0
for c in ans:
if c=="T":
k=k+1
①
else:
②
return s
ans="FFFTTTTTFF"
print( ③ )
def get_score(ans):
    k,s=0,0
    for c in ans:
        if c=="T":
            k=k+1
            s=s+k
        else:
            k=0
    return s
ans="FFFTTTTTFF"
print(get_score(ans))
评分标准:
(1)s=s+k 或等效答案;(3分)
(2)k=0 或等效答案;(3分)
(3)get_score(ans) 或等效答案。(4分)
说明:根据题意可知变量k和s分别用来存储当前答题得分和总分数,它们的初始值均为0。因为连续答对k题,第k题加k分,最终返回总分,故第①空答案为s+k,第②空答错重置为0。调用函数时,只需在函数名后面的圆括号里填写实参ans即可。
球队员
篮球队里有10名同学。训练时,教练会随机抽取同学组成两个队伍进行对抗。
请补全下列程序,实现随机分队的功能。
import random
players=['曹操','夏侯惇','司马懿','刘备','关羽','张飞','周瑜','孙权','甘宁','鲁肃']
A=set() #创建空集合A
while ① : #队员人数够不够
n=random.randint(0,9)
player= ② #获取队员名字
A. ③ #将队员名字添加到A队
P= ④ #创建全体队员的集合
B=P-A
print('A队的队员有:{} \nB队的队员有:{}'.format(A,B))
———————分割线,以下可能为程序输入输出结果—————————
A队的队员有:{'刘备', '司马懿', '张飞', '关羽', '鲁肃'}
B队的队员有:{'曹操', '孙权', '夏侯惇', '周瑜', '甘宁'}
import random
players=['曹操','夏侯惇','司马懿','刘备','关羽','张飞','周瑜','孙权','甘宁','鲁肃']
A=set()    #创建空集合A
while len(A)<5:           #队员人数够不够
    n=random.randint(0,9)
    player=players[n]     #获取队员名字
    A.add(player)         #将队员名字添加到A队
P=set(players)            #创建全体队员的集合
B=P-A
print('A队的队员有:{} \nB队的队员有:{}'.format(A,B))
评分标准:
(1)len(A)<5 或等效答案;(2分)
(2)players[n] 或等效答案;(2分)
(3)add(player) 或等效答案;(3分)
(4)set(players) 或 {'曹操','夏侯惇','司马懿','刘备','关羽','张飞','周瑜','孙权','甘宁','鲁肃'} 或等效答案。(3分)
字符串替换
小明在信息科技课上学习了word的基本操作后,了解到word中替换功能可以将文档中指定内容一次性全部替换成其他文本,于是试着在Python中编程实现相关功能,功能描述如下:
在字符串s中,查找指定的字符c1(可以是单个字符,也可以是多个字符的组合)并替换成其他字符c2。例如:输入s的值为:"A person in need is a person indeed!",输入c1的值为:person,输入c2的值为"friend",则显示的结果是"A friend in need is a friend indeed!"。实现上述功能的python代码如下:运行界面如图所示:
请在划线处填入适当的代码.
s=input("请输入文本字符串:")
c1=input("请输入要替换的字符:")
c2=input("请输入要替换成的新字符:")
n=len(c1)
s1=""
i=0
while i<len(s):
c= ①
if c==c1:
s1=s1+c2
i= ②
else:
s1= ③
④
print("替换后的结果:",s1)
s = input("请输入文本字符串:")
c1 = input("请输入要替换的字符:")
c2 = input("请输入要替换成的新字符:")
n = len(c1)
s1 = ""
i = 0
while i < len(s):
    c =s[i:i+n]
    if c == c1:
        s1 = s1+c2
        i = i+n
    else:
        s1 =s1+s[i]
        i=i+1
print("替换后的结果:",s1)
评分标准:
(1)s[i:i+n] 或等效答案;(3分)
(2)i+n 或等效答案;(3分)
(3)s1+s[i] 或等效答案;(2分)
(4)i=i+1 或等效答案。(2分)