Python编程三级 题库
若要生成一个由若干小写字母组成的互不重复的随机数组,已知小写字母的ASCII码值为97~122整数范围,并将其进行从小到大输出,如图所示,请将相关程序补充完整。
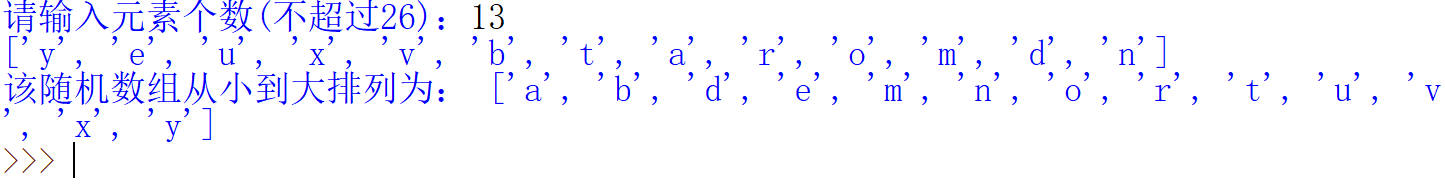
import random #random是随机数模块
n=int(input("请输入元素个数(不超过26):"))
a=[]
#产生不重复的随机数组
for i in range(n):
x=random.randint(97,122) #产生97-122之间的随机整数
while chr(x) in a:
x=random.randint(97,122)
a.append( ① )
print(a)
#将各个元素进行排序输出
for i in range(n-1):
k=i
for j in range( ② ,n):
if a[k]>a[j]:
k= ③
if i!=k:
a[i],a[k]= ④
print("该随机数组从小到大排列为:",a)
#参考程序:
import random #random是随机数模块
n=int(input("请输入元素个数(不超过26):"))
a=[]
#产生不重复的随机数组
for i in range(n):
x=random.randint(97,122) #产生97-122之间的随机整数
while chr(x) in a:
x=random.randint(97,122)
a.append(chr(x))
print(a)
#将各个元素进行排序输出
for i in range(n-1):
k=i
for j in range(i+1,n):
if a[k]>a[j]:
k=j
if i!=k:
a[i],a[k]=a[k],a[i]
print("该随机数组从小到大排列为:",a)
本题主要考查选择排序。程序的第一部分是产生不重复的字母组成的数组。由于x是97~122中的随机整数,故追加到a列表中的元素应在x的基础上将其转化为字符,故①空填写chr(x);在选择排序中,外循环控制排序趟数,内循环控制排序次数,不难看出,i的取值范围为0~n-2,因此j每次从i的下一个位置开始至最后,故②处填写i+1;根据选择排序的原理,在j位置上找到比k位置更小的元素,则k移至该位置,故③处填写为j;在某趟排序过程中,当全部元素比较结束,应在最小元素位置上,需要将其交换到相应的i位置上,故④位置答案应为a[k],a[i]。
评分标准:
(1)chr(x);(4分)
(2)i+1;(4分)
(3)j;(4分)
(4)a[k],a[i]。(4分)
某班级期中考试成绩汇总在文件“score.csv”中,包含了语文、数学、英语三科的分数,数据内容如下图显示:
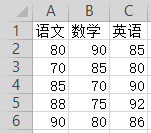
小明编写了如下程序,读取成绩文件中的数据,并分别计算语文、数学、英语三科成绩的平均分,请你补全代码。
import csv
ChineseNum=0
MathNum=0
EnglishNum=0
num=0
with open('/data/score.csv',encoding='utf-8') as csv_file:
row = csv.reader(csv_file, delimiter=',')
next(row) # 读取首行
for r in row:
ChineseNum += float( ① )
MathNum += float( ② )
EnglishNum += float( ③ )
num += ④
print("语文平均成绩是:%.2f"%(ChineseNum/num))
print("数学平均成绩是:%.2f"%(MathNum/num))
print("英语平均成绩是:%.2f"%(EnglishNum/num))
#参考程序:
import csv
ChineseNum=0
MathNum=0
EnglishNum=0
num=0
with open('/data/score.csv',encoding='utf-8') as csv_file:
    row = csv.reader(csv_file, delimiter=',')
    next(row)  # 读取首行
    for r in row:
        ChineseNum += float(r[0])
        MathNum += float(r[1])
        EnglishNum += float(r[2])
        num += 1
print("语文平均成绩是:%.2f"%(ChineseNum/num))
print("数学平均成绩是:%.2f"%(MathNum/num))
print("英语平均成绩是:%.2f"%(EnglishNum/num))
评分标准:
(1)r[0];(1分)
(2)r[1];(1分)
(3)r[2];(1分)
(4)1。(1分)
新学期到了,学校接收了一批捐赠的图书,小明编写了一个简单的程序用来管理图书,并支持借阅功能。为了提高查找图书的效率,小明使用了二分查找法来设计图书借阅功能。以下是小明编写的图书借阅管理程序,请你补全代码。
library=dict() #用字典生成一个图书管理数据结构(字典的键为编号,字典的值为['书名',本数])
#书籍入库
nums=len(library) #先计算图书编号总数
library[nums+1]=['红楼梦',5] #在编号总数的基础上继续添加新书:library[新编号]=['书名',本数]
library[nums+2]=['西游记',10]
library[nums+3]=['水浒传',5]
library[nums+4]=['三国演义',10]
print(library)
blist=list(library.keys())
#按书名借阅:
bookname=input('请输入借阅图书名称:')
min_v = blist[0]
max_v = blist[-1]
turns=0
while min_v <= ① :
turns += 1
cur = (min_v + max_v) ②
print(cur)
if library[cur][0] == ③ :
if library[cur][1] > 0:
library[cur][1] -= ④
print('《%s》借阅成功!'%bookname)
else:
print('抱歉,您选择的书籍已被借完!')
break
elif blist[cur-1] > cur:
min_v = ⑤
else:
max_v = ⑥
print("经过%d轮二分查找,完成图书的搜索。"%turns)
#参考程序:
#学校图书管理系统
library=dict()            #用字典生成一个图书管理数据结构(字典的键为编号,字典的值为['书名',本数])

#书籍入库
nums=len(library)              #先计算图书编号总数
library[nums+1]=['红楼梦',5]     #在编号总数的基础上继续添加新书:library[新编号]=['书名',本数]
library[nums+2]=['西游记',10]
library[nums+3]=['水浒传',5]
library[nums+4]=['三国演义',10]
print(library)

blist=list(library.keys())
#按书名借阅:
bookname=input('请输入借阅图书名称:')

min_v = blist[0]
max_v = blist[-1]
turns=0

while min_v <= max_v:
    turns += 1
    cur = (min_v + max_v) // 2
    print(cur)
    if library[cur][0]==bookname:
        if library[cur][1] > 0:
            library[cur][1] -= 1
            print('《%s》借阅成功!'%bookname)
        else:
            print('抱歉,您选择的书籍已被借完!')
        break
    elif blist[cur -1] > cur:
        min_v = cur +1
    else:
        max_v = cur -1
print("经过%d轮二分查找,完成图书的搜索。"%turns)
评分标准:
(1)max_v;(2分)
(2)// 2;(2分)
(3)bookname;(3分)
(4)1;(3分)
(5)cur +1;(3分)
(6)cur -1。(3分)
某班“天天向上”小组共有6个同学,姓名和身高数据分别存放在列表a中,编写程序实现小组同学按身高从高到低输出名单,运行结果如图所示:
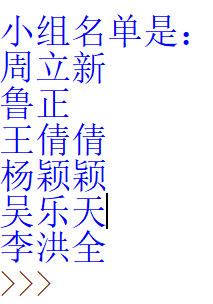
程序代码如下,请在划线处补充完整:
a=[["李洪全",135],["王倩倩",154],["吴乐天",148],["周立新",165],["鲁正",158],["杨颖颖",150]]
for i in range(1,len(a)):
for j in range(0, ① ):
if a[j][1] ② a[j+1][1]:
a[j],a[j+1]=a[j+1],a[j]
print("小组名单是:")
for i in range(len(a)):
print( ③ )
#参考程序:
a=[["李洪全",135],["王倩倩",154],["吴乐天",148],["周立新",165],["鲁正",158],["杨颖颖",150]]
for i in range(1,len(a)):
    for j in range(0, len(a)-i):
        if a[j][1] < a[j+1][1]:
            a[j],a[j+1]=a[j+1],a[j]
print("小组名单是:")
for i in range(len(a)):
print(a[i][0])
评分标准:
(1)len(a)-i;(4分)
(2)<;(3分)
(3)a[i][0]。(3分)
本题考查冒泡排序算法。从外循环看,6个元素排5趟,应该能全部排整齐。内循环每趟主要从第一个元素开始,相邻元素两两相比,i=1时,j最终取到4,i=2时,j最终取到3,i=3时,j最终取到2,i=2时,j最终取到1,i=1时,j最终取到0,由于range()的终值是取不到的,故第一空应填len(a)-i;根据题目从高到低的要求,若前一个数小于后一个数,则应将其往后移,故第二空应为”<”;由输出结果观察可知,只需要输出排序后列表中的姓名部分,故第三空应填a[i][0]。
下面代码,在字典a中查找身高为137的人,请将代码中缺失部分补充完整。
a = {'小赵':136,'小钱':141,'小孙':146,'小李':138,'小周':142,'小吴':134,'小郑':137,'小王':143}
keys = a.keys()
b = 0 # 用于判断查找是否成功
for key in keys:
value = a[ ① ]
if ② == 137:
print('找到身高为137的人是: ', key)
b = b+1 # 有找到的人
③ # 退出循环
if b == 0 :
print('本次查找,未找到有身高为137的同学。 ')
#参考程序:
#本题完整代码与注释如下:
a = {'小赵':136,'小钱':141,'小孙':146,'小李':138,'小周':142,'小吴':134,'小郑':137,'小王':143}
keys = a.keys()    # 取得键名做为列表
b = 0                  # 用于判断查找是否成功
for key in keys:    # 利用键名进行循环,为顺序查找作准备
    value = a[key]       # 利用键名获取键值,便于下面比较
    if value == 137:      # 进行值比较
        print('找到身高为137的人是: ', key)    # 找到身高为137的学生,则打印出其键名
        b = b+1        # 查找成功
        break            # 退出循环

if b == 0 :
    print('本次查找,未找到有身高为137的同学。 ')     # 没找到符合查找条件的人,则也给出提示
评分标准:
(1)key;(3分)
(2)value或者int(value)或者a[key]或者int(a[key]);(4分)
(3)break。(3分)
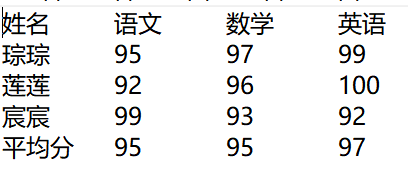
张老师手上有一份学生成绩单(cj.txt),成绩单上只有每位学生的各科成绩,而张老师希望能看到各科成绩的所有学生的平均分,以下代码可以实现平均分的计算,并按示例格式排版,请补充代码。
示例:
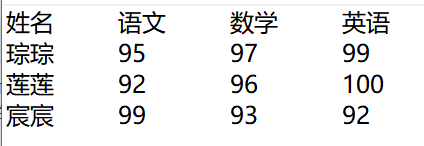
with open('/data/cj.txt', ① ) as f:
string = f.read()
data = string.split('\n')
data.pop(0)
lis = []
for i in data:
new = i.split('\t')
lis.append(new)# 将分割得到的列表追加到空列表中,lis 为二维
lis1 = ['平均分']
for i in range(1,4):# 循环3次,因为需要计算3个科目的平均分
sum_ = ②
average = round(sum_ / 3)
lis1.append(str(average))
s = "\t".join(lis1)
res = string + s
with open('cj1.txt', 'w') as f:
f.write(res)
#参考程序:
with open('/data/cj.txt', 'r') as f: # 以只读的方式打开文件
    string = f.read() # 读取整个文件内容,返回字符串
    data = string.split('\n') # 按换行符分割为列表
    data.pop(0) # 去标题部分
    lis = [] # 空列表
    for i in data: # 遍历被分割的列表
        new = i.split('\t') # 将列表的一个元素按制表符分割
        lis.append(new) # 将分割得到的列表追加到空列表中,lis 变为二维
    lis1 = ['平均分'] # 定义一个列表用于存储平均分
    for i in range(1, 4): # 循环3次,因为需要计算3个科目的平均分
        sum_ = int(lis[0][i]) + int(lis[1][i]) + int(lis[2][i])
        average = round(sum_ / 3) # 平均分,结果保整数
        lis1.append(str(average)) # 转换为字符串并追加到lis1中
    s = "\t".join(lis1) # 将列表连接成字符串
    res = string + s
with open('cj1.txt', 'w') as f: # 以写入的方式打开文件
    f.write(res)
评分标准:
(1)'r';(2分)
(2)int(lis[0][i]) + int(lis[1][i]) + int(lis[2][i])。(2分)(没有int给1分)
工厂有一台检测设备用于检测器件,各个器件在不完全相同时刻送达,且检测时长各有不同。现在要按器件的送达时间(若送达时间相同则按检测时长)进行排序后再送检,送达时间和检测时间都是按升序排序。已知各个器件原始信息存在列表qj中:qj=[[2,1],[1,3],[0,2],[4,3],[12,4],[10,1],[4,1]],其中器件信息[2,1]表示器件送达时间是2,检测时长是1,其他器件信息类推。现在编写Python程序对各个器件进行排序,并重新输出。排序后的器件列表如下,请你在划线处完善程序:
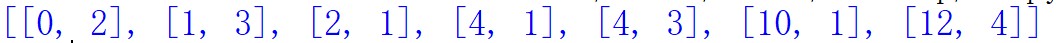
qj=[[2,1],[1,3],[0,2],[4,3],[12,4],[10,1],[4,1]]
for i in range(len(qj)-1):
for j in range(0, ① ):
if ② or (qj[j][0]==qj[j+1][0]and ③ ):
qj[j],qj[j+1]=qj[j+1],qj[j]
print( ④ )
#参考程序:
qj=[[2,1],[1,3],[0,2],[4,3],[12,4],[10,1],[4,1]]
for i in range(len(qj)-1):
    for j in range(0,len(qj)-1-i):
        if qj[j][0]>qj[j+1][0]or qj[j][0]==qj[j+1][0]and qj[j][1]>qj[j+1][1]:
            qj[j],qj[j+1]=qj[j+1],qj[j]
print(qj)
①本题考查的是对二维列表进行冒泡排序。外循环控制排序趟数,内循环控制排序比较的次数以及比较的起止位。外循环变量i从0开始,内循环变量j从0开始,显然终值是len(qj)-1-i,比较过程从前往后两两相比。因此①处填写的步长应为len(qj)-1-i;
②根据题目意思,比较依据先是送达时间(从小到大),若相同则比较检测时长,因此②处表达的应该是相邻两个器件的送达时间相比,从交换语句来看第j项被交换至j+1项,从而判定②处答案为qj[j][0]>qj[j+1][0];
③qj[j][0]表示送达时间,qj[j][1]则表示的是检测时长,从qj[j][0]==qj[j+1][0]可知此处表示送达时间相同的情况下满足何种条件第j项会和第j-1项交换,显然要比的是检测时间,故而③处填写qj[j][1]>qj[j+1][1]。
④根据题意,最后需要输出排序后的器件列表,因此④处填写的器件列表名称qj。
评分标准:
(1)len(qj)-1-i;(4分)
(2)qj[j][0]>qj[j+1][0];(4分)
(3)qj[j][1]>qj[j+1][1];(4分)
(4)qj。(4分)
学校图书馆为了方便查找管理书籍,给每本书编写了号码,[8,9,10,12,13,14,16,17,25,27],输入号码提示这本书号码排第几。
例如:输入12,输出:要查找的书号12排第4 。
请完善程序:
lst=[8,9,10,12,13,14,16,17,25,27]
hm=int(input('请输入书本号码'))
①
i,j=0,n-1
b=-1
while ② :
m=(i+j)//2
if ③ :
b=m
break
elif hm>lst[m]:
④
else:
j=m-1
if b==-1:
print('要查找的书号['+str(hm)+']不在列表lst中。')
else:
print('要查找的书号['+str(hm)+']排第'+ ⑤ )
lst=[8,9,10,12,13,14,16,17,25,27]
hm=int(input('请输入书本号码'))
n=len(lst)
i,j=0,n-1
b=-1
while i<=j:
    m=(i+j)//2
    if hm==lst[m]:
        b=m
        break
    elif hm>lst[m]:
        i=m+1
    else:
        j=m-1
if b==-1:
    print('要查找的书号['+str(hm)+']不在列表lst中。')
else:
print('要查找的书号['+str(hm)+']排第'+str(b+1))书籍价格查询
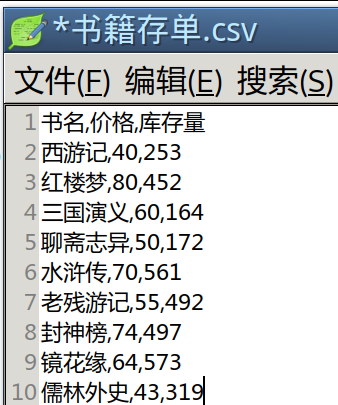
有一个“/data/书籍存单.csv”文件,内容如下图所示。小明编写代码,想查询小说《封神榜》的价格,请补充代码中缺失的部分。
with open('/data/书籍存单.csv', 'r', encoding='utf-8') as f:
for line in f.readlines():
a = ① .split(",")
if a[0] == "封神榜" :
print( ② )
with open('/data/书籍存单.csv', 'r', encoding='utf-8') as f:
    for line in f.readlines():
        a = line.split(",")
        if a[0] == "封神榜" :
print(a[1])当我们过马路的时候,经常会遇到红绿灯,你知道这些信号灯的时长是怎么来的吗?若要用python分析计算人行马路最短绿灯时长,我们需要知道马路的宽度s,行人的步行速度v以及行人的反应时长t0,因为绿灯的最短时长计算公式为t=s/v+t0。
不同的人有不同的行走速度。通常在正常成人、老人、小孩的步行速度中,应选取老人或者小孩的数据进行计算比较合理。
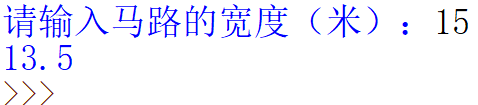
用Python模拟编写绿灯最短时长程序和测试输出结果(测试输入马路宽度为15)分别如下,请补全划线处代码:
v=1.2 #设置行走速度
t0=1 #设置行人反应时长
s=int(input("请输入马路的宽度(米):"))
t= ①
print(t)
#观察发现,在实际生活中,绿灯显示时长不可能为小数,因此若要上述输出结果正常,可以修改print(t)语句,那么你会如何修改?请在下方填入你的代码。
if t>int(t):
print( ② )
elif t==int(t):
print( ③ )
v=1.2    #设置行走速度
t0=1      #设置行人反应时长
s=int(input("请输入马路的宽度(米):"))
t=s/v+t0

if t>int(t):
    print(int(t)+1)
elif t==int(t):
print(int(t))整数问题
给定一个十进制整数 n,求出从 1 到 n 的所有整数中出现“1”的个数。
例如,n=2 时,1,2 出现 1 个“1”。
n=12 时,1,2,3,4,5,6,7,8,9,10,11,12,出现 5 个“1”。
现编写一个程序,实现如下功能:输入整数 n,执行程序后,输出该范围内出现“1”的个数。请完善程序。
n=int(input('请输入整数:'))
①
i=1
while ② :
x=i
while x>0:
if ③ :
count=count+1
x//=10
④
print(n,'范围内 1 的个数有:',count)
n=int(input('请输入整数:'))
count=0
i=1
while i<=n:
    x=i
    while x>0:
        if x%10==1:
            count=count+1
        x//=10
    i=i+1
print(n,'范围内 1 的个数有:',count)
评分标准:
(1)count=0 或等效答案;(2 分)
(2)i<=n 或等效答案;(2 分)
(3)x%10==1 或等效答案;(3 分)
(4)i=i+1 或等效答案。(3 分)
偶数排序
下列程序将数列中的偶数按从小到大顺序输出,请你补全代码。
def even(x):
return x%2==0 #自定义函数 even,判断 x 是否为偶数
c=[3,7,1,18,9,12,5,2,22,10]
n= ①
h=[]
for i in ② :
for j in range(0,n-i-1):
if ③ :
c[j],c[j+1]= ④
for i in range(0,n-1):
h=filter( ⑤ ,c)
ans=list(h)
print(ans)
def even(x):
return x%2==0
c=[3,7,1,18,9,12,5,2,22,10]
n=len(c)
h=[]
for i in range(0,n-1):
    for j in range(0,n-i-1):
        if c[j]>c[j+1]:
            c[j],c[j+1]=c[j+1],c[j]
for i in range(0,n-1):
        h= filter(even,c)
ans=list(h)
print(ans)
(1)len(c) 或等效答案;(3 分)
(2)range(0,n-1) 或等效答案;(3 分)
(3)c[j]>c[j+1] 或等效答案;(3 分)
(4)c[j+1],c[j] 或等效答案;(3 分)
(5)even 或等效答案。(4 分)
食堂问卷调查
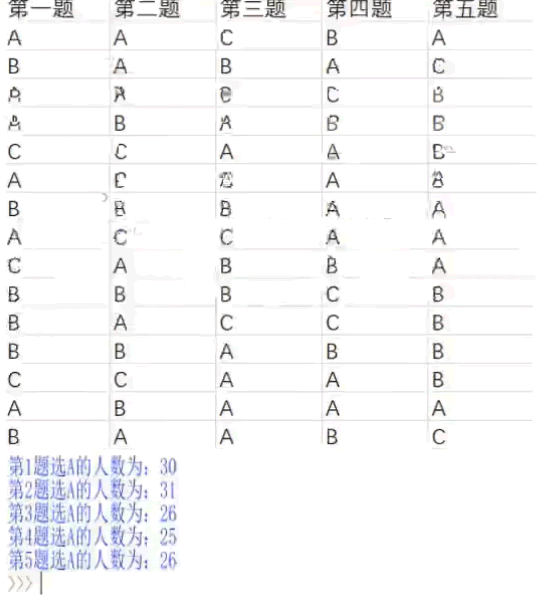
学校食堂为了提高服务质量,让老师和同学们更好地投入工作和学习,对同学们开展了问卷调查,调查项目共 5 项(即 5 个问题),每个项目有 A、B、C 三个选项,同学们每题可选一项,学校后勤管理的李老师对调查结果进行了收集整理,并存放在"myd.csv"文件中(部分数据如图所示),现在需要分析同学们对这 5 个项目的答题情况,统计出每个项目选"A"的情况。李老师用 Python编写了以下代码,输出结果如下图,请你完善划线处。
import csv
with open("/data/ ① ")as f:
cont=list(csv.reader(f))
qk={"第 1 题":0,"第 2 题":0,"第 3 题":0,"第 4 题":0,"第 5 题":0}
for row in cont[ ② ]:
for i in range( len(row)):
if row[i]== ③ :
qk["第"+str(i+1)+"题"]+=1
for i in range(5):
print("第"+str(i+1)+"题选 A 的人数为:"+str(qk["第"+str(i+1)+"题"]))
import csv
with open("/data/myd.csv")as f:
    cont=list(csv.reader(f))
    qk={"第 1 题":0,"第 2 题":0,"第 3 题":0,"第 4 题":0,"第 5 题":0}
    for row in cont[1:]: #或者 1:len(cont)
        for i in range( len(row)):
            if row[i]=='A': #或者"A"
                qk["第"+str(i+1)+"题"]+=1
for i in range(5):
print("第"+str(i+1)+"题选 A 的人数为:"+str(qk["第"+str(i+1)+"题"]))
(1)myd.csv 或等效答案;(1 分)
(2)1:或者 1:len(cont) 或等效答案;(1 分)
(3)'A'或者"A" 或等效答案。(2 分)
本题考查了对 csv 文件的操作和数据处理能力,同时也考查了枚举算法思想。
with 语句打开文件,处理结束后会自动关闭被打开的文件,参数对象为对应的文件名“myd.csv”;由于在 CSV 文件中,第一行为标题行,因此统计从第二行开始也就是索引 1 开始切片,②处应该填写行切片 1:或者 1:len(cont);从外循环来看,row 表示每一行内容,内循环变量 i 则表示每一列的列索引号,即分别取 0~4,那么 row[i]则表示每道题的具体答案,因为要统计 A 选项的人数,因此③处应该是判断是否选“A”,对选 A 的题目,字典中相应的值递增 1。
字母去重排序
在一列表中产生n个大写字母,删除其中重复字母,并按照A到Z顺序排列输出。同时输出删除字母个数。
例如输入 5 随机产生原始字母:[ “D”,“H”,“K”,“E”,“H”] 输出:去重后字母排序:[“D”,“E”,“H”,“K”] 输出:共删除字母个数:1个。
请编写程序实现上述功能,或补全代码。
import random
#导入随机数模块
maxn=int(input("输入生成大写字母个数"))
a=[ ]
for i in range(maxn):
c=random.randint(1,26)#随机产生1-26之间的整数
numb=chr(64+c)
①
print("随机产生原始字母:",a)
m,n=0,maxn
while m<n:
i=n-1
while ② :
i=i-1
if i==m:
③
else:
a.remove(a[i])
n=n-1
for i in range(n):
for j in range(len(a)-1,i,-1):
if a[j]<a[j-1]:
④
print("去重后字母排序:",a)
print("共删除字母个数:", ⑤ ,"个")
import random
maxn=int(input("输入生成大写字母个数"))
a=[ ]
for i in range(maxn):
   c=random.randint(1,26)
   numb=chr(64+c)
   a.append(numb)
print("随机产生原始字母:",a)
m,n=0,maxn
while m<n:
   i=n-1
   while a[i]!=a[m]:
       i=i-1
   if i==m:
       m=m+1
   else:
       a.remove(a[i])
       n=n-1
for i in range(n):
   for j in range(len(a)-1,i,-1):
       if a[j]<a[j-1]:
           a[j],a[j-1]=a[j-1],a[j]
print("去重后字母排序:",a)
print("共删除字母个数:",maxn-n,"个")
(1)a.append(numb) 或等效答案;(3分)
(2)a[i]!=a[m] 或等效答案;(4分)
(3)m=m+1 或等效答案;(3分)
(4)a[j],a[j-1]=a[j-1],a[j] 或等效答案;(3分)
(5)maxn-n 或等效答案。(3分)
植树问题
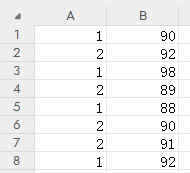
如下图所示,在“植树.csv”中记录着2个班级多次植树的信息(第一列为班级名,第二列为本次植树的数量),输出每个班级植树的总数,请你补全代码。
import csv
with open("/data/植树.csv") as f:
h=list( ① )
s1=0
s2=0
for i in range(len(h)):
if int(h[i][0])==1:
s1=s1+int(h[i][1])
if int(h[i][0])==2:
s2=s2+ ②
print(s1,s2)
输出:
368 362
import csv
with open("/data/植树.csv") as f:
   h=list(csv.reader(f))
s1=0
s2=0
for i in range(len(h)):
   if int(h[i][0])==1:
       s1=s1+int(h[i][1])
   if int(h[i][0])==2:
       s2=s2+int(h[i][1])
print(s1,s2)
(1)csv.reader(f) 或等效答案;(2分)
(2)int(h[i][1]) 或等效答案。(2分)
合作小组
班里有35位同学,新来的王老师想以随机组合的方式给同学们组建合作小组促进学习,已知同学们的学号范围是1~35号,王老师编写了以下程序来生成5个合作小组,如下图所示,请你帮忙补全代码:
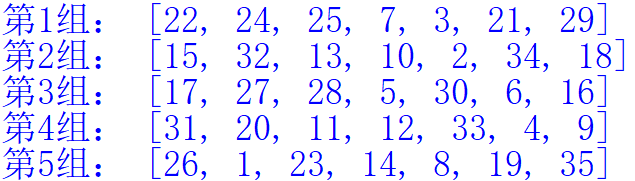
import random#导入随机数模块
numbers=35*[0]#创建35个元素值均为0的列表
flags=35*[False]#创建35个元素值均为False的列表
①
while i<=34:
n=random.randint(1,35)#随机产生1-35之间的整数
if not flags[n-1]:
②
numbers[i]= ③
i+=1
for i in range(5):
print("第"+str( ④ )+"组:",numbers[i*7:7*(i+1)])
import random
numbers=35*[0]
flags=35*[False]
i=0
while i<=34:
   n=random.randint(1,35)
   if not flags[n-1]:
      flags[n-1]=True
      numbers[i]=n
      i+=1
for i in range(5):
   print("第"+str(i+1)+"组人员:",numbers[i*7:7*(i+1)])
(1)i=0 或等效答案;(2分)
(2)flags[n-1]=True 或等效答案;(3分)
(3)n 或等效答案;(3分)
(4)i+1或等效答案;(2分)
某实验小学举行了跳绳比赛,其中四年级1班和2班的比赛数据存储在“ts.csv”中,如图所示,现要求Python读取该比赛数据文件,并统计各班成绩在110(含110)以上的人数。实现代码如下,请你补全划线处代码:
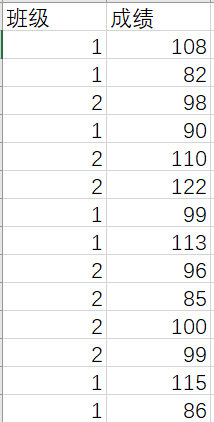
import csv
with open ("/data/ts.csv") as fs:
hs=list(csv.reader( ① ))
c1=0
c2=0
for i in hs[1:]:
if i[0]=="1"and ② >=110:
c1+=1
elif i[0]=="2"and ③ >=110:
c2+=1
print("四(1)班110以上的有:"+str(c1)+"个")
print("四(2)班110以上的有:"+str(c2)+"个")
import csv
with open ("/data/ts.csv") as fs:
    hs=list(csv.reader(fs))
    c1=0
    c2=0
    for i in hs[1:]:
        if i[0]=="1"and int(i[1])>=110:
            c1+=1
        elif i[0]=="2"and int(i[1])>=110:
            c2+=1
    print("四(1)班110以上的有:"+str(c1)+"个")
    print("四(2)班110以上的有:"+str(c2)+"个")
评分标准:
(1)fs 或等效答案;(2分)
(2)int(i[1]) 或等效答案;(1分)
(3)int(i[1]) 或等效答案。(1分)
有一个数字构成的列表 a = [6,2,3,5,4,5,2,6,5,5,4,3,7],小明用冒泡排序算法编写了一段程序,将列表中的数字从小到大排列,运行结果为: [2, 2, 3, 3, 4, 4, 5, 5, 5, 5, 6, 6, 7] ,请将下面程序中红色 ①②③ 处欠缺的代码补充完整。
a = [6,2,3,5,4,5,2,6,5,5,4,3,7]
for i in range(0, ① ) :
for j in range(i+1 , ② ) :
if ③ :
a[i] , a[j] = a[j] , a[i]
print(a)
a = [6,2,3,5,4,5,2,6,5,5,4,3,7]
for i in range(0,len(a)-1) :
     for j in range(i+1 , len(a)) :
         if a[i] > a[j] :
            a[i] , a[j] = a[j] , a[i]
print(a)
评分标准:
(1)len(a)-1 或等效答案;(4分)
(2)len(a) 或等效答案;(2分)
(3)a[i] > a[j] 或等效答案。(4分)
说明:本题考生如果利用双重循环另写一个冒泡排序程序,且运行完全正确,给8分,运行不正确不给分。
小明在解决经典的“鸡兔同笼”问题时,使用“穷举法”编写了以下代码。请将代码中红色①②③④处补充完整:
tou = int(input("请输入笼中鸡与兔脑袋的总数: "))
jiao = int(input("请输入笼中鸡与兔脚的总个数: "))
a = 0
for ji in range( ① ):
tu = ② - ji
if 2 * ji + 4 * tu == ③ :
print("鸡的个数为:", ji, "兔的个数为:", tu)
a = a + 1
if a == ④ :
print("头数与脚数不合理,没有合适的结果。")
tou = int(input("请输入笼中鸡与兔脑袋的总数:  "))
jiao = int(input("请输入笼中鸡与兔脚的总个数:  "))
a = 0
for ji in range(tou+1):
    tu = tou - ji
    if 2*ji + 4*tu == jiao:
        print("鸡的个数为:",ji,"兔的个数为:",tu)
        a = a + 1
if a == 0 :
    print("头数与脚数不合理,没有合适的结果。")
评分标准:
(1)tou+1 或等效答案;(4分)
(2)tou 或等效答案;(4分)
(3)jiao 或等效答案;(4分)
(4)0 或等效答案。(4分)
分解质因数
输入一个整数,分解质因数。例如:输入90,打印出90=2*3*3*5。请完善以下代码,运行程序。
target=int(input('输入一个整数:'))
print(target,'= ',end='')
if target<0:
target= ① (target)
print('-1*',end='')
flag=0
if target<=1:
print(target,end='')
flag= ②
while True:
if flag:
break
for i in range(2,int(target+1)):
if ③ :
print("%d"%i,end='')
if target==i:
flag=1
break
print('*',end='')
④
break
target=int(input('输入一个整数:'))
print(target,'= ',end='')
if target<0:
    target=abs(target)
    print('-1*',end='')
flag=0
if target<=1:
    print(target,end='')
    flag=1
while True:
    if flag:
        break
    for i in range(2,int(target+1)):
        if target%i==0:
            print("%d"%i,end='')
            if target==i:
                flag=1
                break
            print('*',end='')
            target/=i
            break
评分标准:
(1)abs 或等效答案;(2分)
(2)1 或等效答案;(3分)
(3)target%i==0 或等效答案;(3分)
(4)target/=i 或等效答案。(2分)