Python编程三级 题库
以下表达式的值为True的是?( )
A和B选项,False;D选项,报错;C选项,True。
下列代码的运行结果是?( )
将元组转换成浮点型列表。
关于filter()函数的使用,以下哪个选项不正确?( )
filter()可以过滤列表、元组、集合或字符串等。
表达式[1, 2, 3]*3的执行结果为?( )
将列表连续输出3次。
表达式[3] in [1, 2, 3, 4]的结果是?( )
[3]in[1,2,3,4]是后面这个列表是否包含另一个列表,且这个列表里面还有个数字3,显然不包含,所以是False。
表达式list(map(str, [1, 2, 3, 4, 5])) 的值为?( )
将序列中的元素从整型转换为字符串类型。
表达式divmod(6,2)结果为?( )
divmod(6,2)返回一个元组(6//2,6%3),余数为0不能省略。
运行以下代码,输出的结果是?( )
s='abcdefg',min(s)='a',max(s)='g',所以结果为两个字符串相连,正确答案为:ag。
运行程序,下列说法正确的是?( )
将列表对象输出为csv格式文件,如果不存在jieqi.csv文件,将产生一个jieqi.csv文件。参数“a”,为非覆盖,在原有内容之后,继续增加内容。
使用with语句可以读取csv格式文件中的数据,下图所示,有一个名为“jieqi.csv”的文件,小明针对这个文件编写如下代码,请问代码运行后打印在屏幕上的结果是?( )
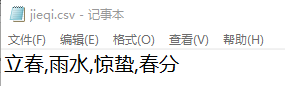
从csv格式文件中读出数据,表示为列表对象。
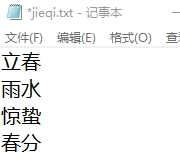
使用 readline()和readlines()函数可以读取txt文件中的数据。D盘“jieqi.txt”文件内容如下图,小明编写了下面代码,运行后打印在屏幕上的结果是?( )
f=open(r"D:\jieqi.txt", "r")
s = f.readline()
s1=f.readlines()
f.close()
print(s1)
readline() 每次读出一行内容,返回一个字符串对象,文件指针下移。readlines()读取下面整个文件所有行,保存在一个列表变量中,每行作为一个元素。
使用open函数打开一个csv格式文件后,如果要将整个文件里的内容读取存放到一个字符串变量中,需要使用以下文件操作的哪个函数?( )
read() 方法用于从文件读取指定的字节数,默认读取整个文件。readline() 每次读出一行内容,返回一个字符串对象。readlines() 方法用于读取所有行并返回列表。write() 用于向文件中写入指定字符串。
将水果价格一维数据['苹果','8元']写入"jiage.csv"文件操作,横线上填写正确的是?( )
f = open("jiage.csv", "w")
ls = ['苹果','8元']
f._____(",".join(ls)+ "\n")
f.close()
write() 用于向文件中写入指定字符串。
下列哪个选项不是 bin() 函数返回值的特点?( )
bin() 函数返回的字符串长度不是固定的,它取决于输入整数的二进制表示所需的位数。例如,bin(2) 返回 '0b10',而 bin(10) 返回 '0b1010'。因此,选项 C(它的长度总是固定的)不是 bin() 函数返回值的特点。
其他选项 A、B 和 D 都是正确的。
对分查找,也称作二分查找,对一个列表中的元素进行对分查找的前提条件是?( )
对分查找是一种基于比较的查找算法,它要求列表元素有序,以便在每次比较时能够缩小搜索范围。
对一组数据[7, 2, 9, 4, 8, 1, 4, 5]进行排序,使用选择排序按从大到小的顺序进行排列,则第1轮排序过后的结果是?( )
选择排序算法的主要思想是每次从未排序部分选择最小(或最大)元素,然后将它放到已排序部分的末尾。
所以选项C正确,第1轮排序找到最大值9,将9和7交换位置;
选项A用的是冒泡排序;
选项B是第2轮排序后的结果;
选项D将9放到了数据的末端,排序后的结果是从小到大排序的。
对于列表[3, 1, 5, 8, 2, 10]按从左往右进行升序的冒泡排序,则第几轮排序后的结果就是有序的?( )
第1轮:1 3 5 2 8 10;第2轮:1 3 2 5 8 10;第3轮:1 2 3 5 8 10。
十六进制数2024转换为二进制数是?( )
2024
10000000100100
11000011100
10000010100
十六进制数转二进制数,从低位起,每1位十六进制数可转换为4位二进制数,最左边的0可以省略,但中间的0不可省略。A为十进制数,C中十六进制2应为0010,D选项将中间的部分0省略了,故选B。