首页 › 试卷 › GESP编程能力等级认证 › GESP-Python五级 › 2024年6月CCF-GESP编程能力等级认证Python编程五级真题

2024年6月CCF-GESP编程能力等级认证Python编程五级真题 VIP

GESP-Python五级 共 26 题 2024 年 含标准答案与解析
返回试卷列表
本页为整卷浏览:先自己做一遍,再展开「查看答案与解析」核对。

一、单选题

1. 单选题

在Python中,print((c for c in “GESP”))的输出是( )。

  • A (‘G’, ‘E’, ‘S’, ‘P’)
  • B [‘G’, ‘E’, ‘S’, ‘P’]
  • C {‘G’, ‘E’, ‘S’, ‘P’}
  • D

    以上选项均不正确

查看答案与解析
答案:D
解析:

在Python中,表达式 print((c for c in “GESP”)) 的输出是一个生成器对象,而不是元组、列表或集合。生成器对象在被打印时会输出其表示形式,即 <generator object>,而不是生成器中的元素。所以,正确的答案是:以上选项均不正确,因为生成器对象本身不会输出其中的元素,而是输出生成器对象的描述信息。
2. 单选题

下面有关快速排序的说法,错误的是( )。

  • A 快速排序算法通常采用递归实现。
  • B 快速排序算法是一种稳定排序算法。
  • C 如果被排序数组或者list已排序或逆序,其时间复杂度是 O(N^2)
  • D 快速排序是一种原地(in-place)排序算法。
查看答案与解析
答案:B
解析:

正确。快速排序通常通过递归将数组分割成子数组来实现。

错误。快速排序是一种不稳定排序算法。在排序过程中,相同元素的相对位置可能会改变。

正确。最坏情况下,如果数组已经有序或者逆序,快速排序的时间复杂度可能达到O(N²),尤其是当选择的基准元素不合适时。

正确。快速排序通过交换数组中的元素来排序,不需要额外的空间,因此是一种原地排序算法。

因此,选项B错误,快速排序算法不是稳定排序算法。

3. 单选题

内排序有不同的类别,从排序算法的实现思路上考虑,下面哪种排序算法和插入排序是同一类?( )

  • A 希尔排序
  • B 快速排序
  • C 堆排序
  • D 冒泡排序
查看答案与解析
答案:A
解析:

从排序算法的实现思路上来看,插入排序与希尔排序属于同一类别,因为它们都是通过逐步构建有序序列来完成排序的。具体解释如下:插入排序:逐步将未排序的元素插入到已排序的部分,直到整个序列有序。希尔排序:是插入排序的改进版本,通过将序列分成若干个子序列进行插入排序,逐步缩小子序列的间隔,最终完成排序。

因此,正确答案是:希尔排序

4. 单选题

下面Python代码用于求斐波那契数列,该数列第1、2项为1,以后各项均是前两项之和。函数Fibo()属于()。

def Fibo(N):
	if N == 1 or N == 2:
		return 1
		
	fiboList = [1, 1]
	for i in range(2, N):
		fiboList.append(fiboList[i - 1] + fiboList[i - 2])
		
	return fiboList[N-1]
  • A 枚举算法
  • B 贪心算法
  • C 迭代算法
  • D 递归算法
查看答案与解析
答案:C
解析:

递归算法:递归算法通常是指函数调用自身来解决问题。虽然斐波那契数列可以使用递归实现,但是该代码中并没有直接使用递归调用,而是使用了迭代循环来计算每一项的值。

迭代算法:迭代算法是通过循环重复计算的方法来解决问题。该函数通过for 循环迭代计算斐波那契数列的各项,因此属于迭代算法。

枚举算法:枚举算法通常是列举所有可能的情况来解决问题,这个概念与斐波那契数列的求解方法不相关。

贪心算法:贪心算法是通过每一步选择最优解来达到整体最优解的方法。斐波那契数列的计算不涉及贪心选择过程。

综上所述,根据代码实现方式,函数 Fibo(N) 属于:迭代算法

5. 单选题

下面Python代码用于将输入金额换成最少币种组合方案,其实现算法是( )。

def findCoins(coins, Money):
	coins_used = []
	for coin in coins:
		while Money >= coin:
			coins_used.append(coin)
			Money -= coin
	return coins_used
	
coins = [100, 50, 20, 10, 5, 2, 1] #货币种类,单位相同
M = int(input()) #输入换算的金额
coins_needed = find_coins(coins, M)

result = [(c,coins_needed.count(c)) for c in coins]
result = [x for x in result if x[1] > 0]
  • A 枚举算法
  • B 贪心算法
  • C 迭代算法
  • D 递归算法
查看答案与解析
答案:B
解析:

枚举算法:枚举算法通常是通过穷举所有可能情况来解决问题。该代码并没有枚举所有可能的解决方案,而是通过一种确定性的方法找出最少币种组合方案。

贪心算法:贪心算法是通过每一步选择当前状态下最优的解决方案来达到整体最优的目标。在该代码中,通过每次选择当前金额能够覆盖的最大面额货币来实现找零,属于贪心算法的思想。

迭代算法:迭代算法是通过重复迭代来逐步逼近问题的解。该代码使用了循环来逐步减少剩余金额并记录所使用的货币,因此也可以称为迭代算法。

递归算法:递归算法是通过函数调用自身来解决问题。虽然找零问题可以使用递归解决,但是该代码并没有使用递归调用的方式。

根据代码实现方式和思想,最符合描述的是:贪心算法

6. 单选题

有关下面Python的代码,错误的是( )。

def count_if(iterData,*,key=None):
	if key == None:
		return len(iterData)
		
	Count = 0
	for i in iterData:
		Count += bool(key(i))
	return Count
  • A 执行 print(count_if(range(100))) 将输出 100
  • B 执行 print(count_if(range(-10,10), key = abs)) 将输出 19
  • C 执行 print(count_if(range(-100,10),key = lambda x:x > 5)) 将输出 4
  • D 代码 Count += bool(key(i)) 存在错误
查看答案与解析
答案:D
解析:

这个函数count_if 的作用是计算满足条件的元素个数。它接受一个可迭代对象iterData 和一个关键字参数key,如果key 为None,则返回iterData 的长度;否则,遍历iterData 中的每个元素,通过key 函数判断是否满足条件(即bool(key(i)) 返回True),然后累加满足条件的个数并返回。

现在来逐个分析选项:

执行print(count_if(range(100))) 将输出100

正确。如果没有提供key 参数,函数会返回 iterData 的长度,即 range(100) 包含 100 个元素,所以输出是 100。

执行print(count_if(range(-10,10), key = abs)) 将输出19

正确。这里使用了key = abs,表示计算绝对值,所以在范围-10 到9 内(不包括10),共有19 个元素的绝对值大于0,因此输出是19。

执行print(count_if(range(-100,10), key = lambda x: x > 5)) 将输出4

正确。这里使用了一个lambda函数作为key,判断元素是否大于5。在范围-100 到9 内,有-99, -98, -97, …, 6 共计4 个元素满足条件大于5。

代码Count += bool(key(i)) 存在错误

错误。这部分代码的逻辑是正确的,它使用bool(key(i)) 来判断元素是否满足条件,并将满足条件的结果转换为True 或False,然后累加到Count 中。

因此,根据以上分析,错误的选项是:代码Count += bool(key(i)) 存在错误

7. 单选题

在下面的Python代码中,最后一行用于输出小于0的list,横线处不能填入的代码是( )。

def LT(a, b):
	return a < b
	
lstData = list(range(-100,100))
print(___________________________)
  • A [x for x in lstData if x < 0 ]
  • B list(filter(lambda x: x < 0, lstData))
  • C list(filter(LT(x,0), lstData))
  • D [x for x in lstData if LT(x, 0)]
查看答案与解析
答案:C
解析:

在给定的代码和选项中,我们需要选择能够正确输出小于0的列表的选项。

首先,我们看一下每个选项的含义和正确性:

[x for x in lstData if x < 0]

正确。这是列表推导式的语法,用于筛选出 lstData 中小于0的元素并生成一个新的列表。

list(filter(lambda x: x < 0, lstData))

正确。使用 filter 函数结合 lambda 表达式,筛选出 lstData 中小于0的元素并生成一个新的列表。

list(filter(LT(x, 0), lstData))

错误。在这里,LT(x, 0) 并不是一个合法的表达式。filter 函数的第一个参数需要是一个函数或者 None,而 LT(x, 0) 表达式没有定义 x,因此这行代码会抛出错误。

[x for x in lstData if LT(x, 0)]

正确。这也是列表推导式的语法,筛选出 lstData 中小于0的元素并生成一个新的列表。LT(x, 0) 是一个函数调用,用于判断 x 是否小于0。

综上所述,正确答案是:

list(filter(LT(x, 0), lstData))

因为这行代码会导致语法错误,无法正确输出小于0的列表。

8. 单选题

汉字的unicode编码界于0x4E00和0x9FA5之间。下面Python的代码用于读取红楼们和水浒传文本。如果要能完整阅读这两本小说,求出需要认识的汉字集合,横线处应填入代码是( )。

shzFile = open("水浒传.txt", "r", encoding = "utf-8")
hlmFile = open("红楼梦.txt", "r", encoding = "utf-8")
sSet = set(shzFile.read())
hSet = set(hlmFile.read())
shzFile.close()
hlmFile.close()

print(________________________________)
  • A {x for x in (sSet + hSet) if 0x4E00 <= ord(x) <= 0x9FA5 }
  • B {x for x in (sSet | hSet) if 0x4E00 <= x <= 0x9FA5 }
  • C {x for x in (sSet + hSet) if 0x4E00 <= x <= 0x9FA5 }
  • D {x for x in (sSet | hSet) if 0x4E00 <= ord(x) <= 0x9FA5 }
查看答案与解析
答案:D
解析:

{x for x in (sSet + hSet) if 0x4E00 <= ord(x) <= 0x9FA5}错误。sSet + hSet 是集合的合并操作,不是按字符拼接,所以这种语法是不正确的。

{x for x in (sSet | hSet) if 0x4E00 <= x <= 0x9FA5}错误。sSet | hSet 是集合的并集操作,它不会按照字符处理,因此无法进行Unicode编码的比较。

{x for x in (sSet + hSet) if 0x4E00 <= x <= 0x9FA5}错误。同样的问题,sSet + hSet 不是合适的操作。

{x for x in (sSet | hSet) if 0x4E00 <= ord(x) <= 0x9FA5}正确。sSet | hSet 是集合的并集操作,生成了包含两本书中所有字符的集合。然后,通过 ord(x) 获取字符 x 的Unicode编码,检查它是否在 0x4E00 到 0x9FA5 的范围内。

因此,正确的答案是:{x for x in (sSet | hSet) if 0x4E00 <= ord(x) <= 0x9FA5}这段代码将打印出两本小说中所有汉字的集合,使得我们能够了解需要认识的汉字范围。

9. 单选题

求回文子字符串,如:在ABCDDCBAXz中,DD、CDDC、BCDDCB、ABCDDCBA均为回文子字符串。下面Python代码是其实现,横线处应填入的代码是( )。

srcStr = input()

symList = [] #保存回文子字符串
for i in range(len(srcStr)):
	for j in range(i + 2, len(srcStr) + 1):
		subStr = ___________
		if subStr == _____________:
			symList.append(subStr)

for i in sorted(symList, key = lambda x: len(x)):
	print(i)
  • A srcStr[i:j] , subStr[::-1]
  • B srcStr[i:j] , subStr[j:i:-1]
  • C srcStr[i+2:j] , subStr[j-1:i:-1]
  • D srcStr[i:j+2] , subStr[j-1:i-1:-1]
查看答案与解析
答案:A
解析:

srcStr[i:j], subStr[::-1]这里 srcStr[i:j] 获取子字符串,subStr[::-1] 是将 subStr 反转。这是正确的填充。

10. 单选题

上面代码的时间复杂度是( )。

  • A O(logN)
  • B O(NlogN)
  • C O(N)
  • D O(N^2)
查看答案与解析
答案:A
解析:

这段代码的主要操作是:

1、两层嵌套循环:外层循环遍历字符串的每个字符作为子字符串的起点,内层循环则从这个起点开始,尝试所有可能的子字符串长度(直到字符串末尾)。

外层循环:for i in range(len(srcStr)),执行次数为n(n 是字符串长度)。

内层循环:for j in range(i + 2, len(srcStr) + 1),对于外层循环的每次迭代,内层循环的次数大致为n - i - 1(因为从i+2 开始到字符串末尾)。

2、内层循环的累加:如果我们把内层循环的每次迭代都加起来,我们会发现这是一个等差数列的和,大致为n + (n-1) + (n-2) + … + 2 + 1,这个和是n(n+1)/2 - 1,但在分析时间复杂度时,我们更关心的是它的阶(order),即O(n^2)。

3、其他操作:虽然代码中还有回文检查和排序操作,但这些操作的时间复杂度相对于内层循环的O(n^2) 来说是可以忽略的(特别是当考虑到平均情况和最坏情况时的实际影响)。

因此,我们可以简单地说,这段代码的时间复杂度是O(n^2),其中n 是输入字符串的长度。这意味着随着输入字符串长度的增加,算法的执行时间将呈平方级增长。

11. 单选题

有关下面Python代码的说法,错误的是( )。

def Sort(lst):
	for i in range(1, len(lst)):
		key = lst[i]
		j = i - 1
		while j >= 0 and key < lst[j]:
			lst[j + 1] = lst[j]
			j -= 1
		lst[j + 1] = key
lst = [4,5,13,2,7,10,1,3,8,11,6,9,12]
lst = Sort(lst)
print("sorted list:", lst)
  • A 该段代码是插入排序算法的实现
  • B 如果lst完全有序,则时间复杂度为
  • C 如果lst完全逆序,则时间复杂度为
  • D 由于Sort()函数没有返回值,没有最终达到排序效果
查看答案与解析
答案:D
解析:

D选项错误,尽管Sort()函数没有显式地返回排序后的列表,但Python中的函数可以修改作为参数传递的可变对象(如列表)。在这个例子中,lst作为参数传递给Sort()函数,并在函数内部被修改。因此,当函数执行完毕后,原始的lst列表已经被排序,并且这种排序效果在函数外部也是可见的。所以,即使没有返回值,排序效果也是达到了的。

12. 单选题

下面Python函数nGram()用于逐一从字符串中截取n个字符,如:nGram(“ABCDEF”,2)将逐一截取为AB、BC、CD、DE、EF,如:nGram(“ABCDEF”,3)将逐一截取为ABC、BCD、CDE、DEF,并统计每种截取的数量,横线处应填入代码是( )。

def nGram(S,n):
	Result = {}#保存截取字符串及其数量
	for i in range(________________):
		nChar = ________________
		Result[nChar] = Result.get(nChar,0) + 1
	return Result
  • A len(S)-n , S[i:n]
  • B len(S)-n+1 , S[i:i+n]
  • C len(S) , S[i:i+n]
  • D len(S)-n , S[i:i+n]
查看答案与解析
答案:B
解析:

range() 函数中的起始索引i 应该是从0 开始,直到足够截取所有长度为n 的子字符串,因此正确的范围应该是len(S) - n + 1。这是因为,如果S 的长度为L,那么从0 到L-n 就能够截取所有长度为n 的子字符串。

nChar 是每次截取的子字符串,应该使用切片操作S[i:i+n] 来获取长度为n 的子字符串。

根据以上分析,正确的选项是:len(S)-n+1 ,S[i:i+n]

13. 单选题

上题代码的时间复杂度是( )。

  • A O(logN)
  • B O(NlogN)
  • C O(N)
  • D O(N^2)
查看答案与解析
答案:C
解析:

整体时间复杂度仍然是主要由循环决定,为C

14. 单选题

下面是埃氏素数筛的Python实现,横线上应填入的代码是( )。

def listPrime(N):
	primeList = list(range(N+1))
	primeList[0] = primeList[1] = False
	for i in range(2,int(N ** 0.5) + 1):
		if primeList[i] != False:
			for j in range(_____________):
				primeList[j] = False
	return [x for x in primeList if x != False]
  • A i + i, N + 1, 2
  • B i * i, N + 1, i
  • C i * i, N, i * i
  • D i, N + 1, i
查看答案与解析
答案:B
解析:

埃氏筛法(埃拉托斯特尼筛法)是一种用于查找一定范围内所有素数的有效算法

我们需要填入的三个空白分别是:

第一个空白:表示从i*i 开始标记非素数。

第二个空白:表示循环范围,即N 之内需要标记非素数。

第三个空白:表示步长,即每次增加i。

i * i, N + 1, i

第一个空白:i * i,从i*i 开始标记非素数。

第二个空白:N + 1,循环范围是正确的。

第三个空白:i,表示每次增加i,符合埃氏筛法的步长要求。

二、判断题

15. 判断题

在程序设计中,i * i的效率通常比i ** 2 更高。( )

  • A对
  • B错
查看答案与解析
答案:对
解析:

性能比较:

i * i 表示将整数 i 乘以自身,这是一种基本的乘法操作,通常比较高效。

i ** 2 表示整数 i 的平方,这是通过幂运算来实现的,可能会涉及更复杂的计算过程,例如考虑负数和奇偶性等。

效率考虑:

在绝大多数编程语言中,乘法运算 i * i 都可以直接使用底层的乘法指令,因此执行速度较快。

幂运算 i ** 2 则可能需要更多的计算步骤和更高级的算法,尤其是在处理大整数时,效率可能会略低于简单的乘法运算。

综上所述,通常情况下,i * i 的效率确实比 i ** 2 更高。

16. 判断题

求解指定正整数范围内所有质数,采用线性筛算法比埃氏筛效率更高。( )

  • A对
  • B错
查看答案与解析
答案:对
解析:

埃氏筛:算法思想,从小到大枚举每个素数,将其所有的倍数标记为非素数。效率,时间复杂度约为O(n log log n),其中n是给定范围内的最大整数。

线性筛法:算法思想,类似于埃氏筛,但是通过线性的方式来标记非素数,而不是简单地使用倍数关系。效率,时间复杂度为O(n),相对于埃氏筛有更好的性能。

17. 判断题

Python没有指针语法,不能实现C++中涉及指针的算法。( )

  • A对
  • B错
查看答案与解析
答案:错
解析:

C++是一种支持指针的编程语言,允许直接操作内存地址,通过指针可以实现复杂的数据结构和算法,如链表、树等。指针在C++中具有强大的灵活性和控制能力。

Python不像C++那样直接提供指针的概念和语法。Python的变量存储的是对象的引用,而不是直接的内存地址。Python中有类似指针的概念,但称为引用(reference),它们是动态类型的,不需要显式声明,也不需要进行内存管理。虽然Python没有像C++那样的指针语法和直接的内存地址操作能力,但通过引用、对象和高级数据结构,Python可以实现各种算法。因此,Python虽然不是指针操作的首选语言,但在高级算法和应用开发中仍然能够提供非常强大和高效的解决方案。

18. 判断题

如果将双向链表的最后一个元素指向第一个元素,则构成环状链表。( )

  • A对
  • B错
查看答案与解析
答案:对
解析:

当在Python中将双向链表的最后一个元素的 next 指针指向第一个元素时,链表就形成了一个环状链表。这意味着从最后一个节点开始,可以沿着 next 指针一直遍历到第一个节点,然后再次回到最后一个节点,形成一个闭环结构

19. 判断题

链表不能采用快速排序或堆排序,但可以采用插入排序。( )

  • A对
  • B错
查看答案与解析
答案:对
解析:

对于链表数据结构而言:

快速排序和堆排序的实现在链表上相对复杂,不是首选,因为它们依赖于对节点的随机访问,而链表的访问是顺序的,不支持常数时间内的随机访问。

插入排序对于链表来说是一种非常合适和直接的排序算法。它可以通过在链表上移动节点来进行排序,不需要额外的空间,而且操作简单。

链表可以采用插入排序,但不适合使用快速排序或堆排序。这是因为插入排序可以通过链表的顺序访问来有效地实现,而快速排序和堆排序则需要随机访问,这在链表上不容易实现或效率不高。

20. 判断题

在Python中,set或dict因为存储时即自动排序,因此可以用二分法查找,时间复杂度为 O(logN)。( )

  • A对
  • B错
查看答案与解析
答案:错
解析:

在 Python 中,set 和 dict 并不是自动排序的。它们分别用于存储唯一元素(set)和键值对(dict),但都不保证元素的顺序。set 的元素是无序的,而 dict 的元素(即键值对)虽然在 Python 3.7+ 中是按照插入顺序排序的(这被称为插入顺序保留),但这并不意味着它们是“自动排序”以支持二分查找等高效查找算法。

二分查找是一种在有序数组中查找特定元素的快速算法,其时间复杂度为 O(log n)。由于 set 和 dict 都不是基于有序数组实现的,因此不能使用二分查找来在这些数据结构上查找元素。

21. 判断题

如果自定义class已经定义了 __lt__() 魔术方法,则包含该类实例的数据结构,则将自动支持内置函数sorted()。

  • A对
  • B错
查看答案与解析
答案:对
解析:

在Python中,如果自定义的类(即用户自定义的类)定义了特殊方法 __lt__()(用于实现小于运算符 <),则该类的实例可以被传递给内置函数 sorted() 进行排序。

22. 判断题

归并排序和快速排序都采用递归实现,也都是不稳定排序。( )

  • A对
  • B错
查看答案与解析
答案:错
解析:

归并排序

递归实现:归并排序通常使用递归来实现。它将数组(或链表)分成两半,分别对左右两半部分进行排序,然后再将排好序的两个部分合并起来

稳定性:归并排序是一种稳定的排序算法。稳定性指的是当有两个相等的元素在排序后的序列中的相对位置保持不变。

快速排序

递归实现:快速排序也通常采用递归来实现。它选择一个基准元素,将小于基准的元素放在基准的左边,大于基准的元素放在基准的右边,然后递归地对左右两个部分进行排序。

稳定性:快速排序是一种不稳定的排序算法。不稳定性指的是排序后相等元素的相对位置可能发生变化。

23. 判断题

下面的Python代码能实现十进制正整数N转换为2、8、10、16,可适用于16进制以内进制。其中n和ds分别表示将转换的数以及目标进制。( )

n,ds = map(int,input().split())
rst = "" #保存转换结果

digDict = {i:c for i,c in enumerate("0123456789ABCDEF")}
while n != 0:
	rst = digDict[n % ds] + rst
	n //= ds
print(rst)
  • A对
  • B错
查看答案与解析
答案:对
解析:

这段Python代码实现了将十进制正整数n 转换为指定的目标进制ds 的功能。它适用于目标进制在16进制以内的情况。具体步骤如下:

输入处理:从标准输入读取两个整数n 和ds,分别表示要转换的数和目标进制。

字符映射:使用 digDict 字典将十进制数的每一位数映射为对应的目标进制字符(0-9对应’0’-‘9’,10-15对应’A’-‘F’)。

转换过程:通过循环,将十进制数n 除以目标进制ds,并将得到的余数对应的字符插入到结果字符串rst的开头,直到n 变为0。

输出结果:最后打印出转换后的结果字符串rst,即为目标进制下n 的表示。

24. 判断题

Python代码 print(sorted(range(10),key=lambda x:x%5)) 执行时将报错。( )

  • A对
  • B错
查看答案与解析
答案:错
解析:

print(sorted(range(10), key=lambda x: x % 5)) 在执行时不会报错。

range(10) 生成了一个包含0到9的整数序列。

sorted() 函数对这个序列进行排序,排序的依据是 key=lambda x: x % 5,即按照每个元素对5取余的结果来排序。因为对于0到9的数字,它们对5取余的结果是 [0, 1, 2, 3, 4, 0, 1, 2, 3, 4],所以排序后的结果是 [0, 5, 1, 6, 2, 7, 3, 8, 4, 9]。print() 函数会输出这个排序后的列表。

三、简答题

25. 简答题

黑白格

时间限制:1.0 s

内存限制:512.0 MB

题面描述

小杨有一个n行m列的网格图,其中每个格子要么是白色,要么是黑色。

小杨想知道至少包含k个黑色格子的最小子矩形包含了多少个格子。

输入格式

第一行包含三个正整数n,m,k,含义如题面所示。

之后n行,每行一个长度为m的01串,代表网格图第i行格子的颜色,如果为0,则对应格子为白色,否则为黑色。

输出格式

输出一个整数,代表至少包含k个黑色格子的最小子矩形包含格子的数量,如果不存在则输出0。


输入样例

4 5 5
00000
01111
00011
00011

输出样例

6

样例解释

对于样例1,假设 (i,j) 代表第i行第j列,至少包含5个黑色格子的最小子矩形的四个顶点为 (2,4),(2,5),(4,4),(4,5),共包含6个格子。

数据范围

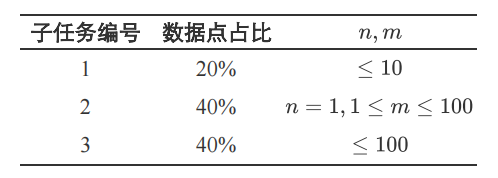
对于全部数据,保证有 1 ≤ n , m ≤ 100 , 1 ≤ k ≤ n × m 

查看答案与解析
答案:<pre class="brush:python;toolbar:false">N = 110 w = [[0] * N for _ in range(N)] sum_w = [[0] * N for _ in range(N)] def main(): n, m, k = map(int, input().split()) for i in range(1, n+1): s = input() for j in range(1, m+1): w[i][j] = int(s[j-1]) sum_w[i][j] = sum_w[i][j-1] + w[i][j] ans = 0 for i in range(1, m+1): for j in range(i, m+1): num = [] now = 0 for l in range(1, n+1): tmp = sum_w[l][j] - sum_w[l][i-1] now += tmp num.append(now) if now &gt;= k: if ans == 0: ans = (j-i+1) * l else: ans = min(ans, (j-i+1) * l) L, R = 1, l while L &lt; R: mid = (L + R + 1) // 2 if now - num[mid-1] &gt;= k: L = mid else: R = mid - 1 if now - num[L-1] &gt;= k: if ans == 0: ans = (j-i+1) * (l-L) else: ans = min(ans, (j-i+1) * (l-L)) print(ans) if __name__ == "__main__": main()</pre>
解析:

1.二维数组存储对应格子颜色的值

2.使用前缀和的技巧来快速计算任意子矩形内的格子数量。这样一来,不需要重复遍历每个可能的子矩形来计算其中的黑色格子数,从而节省时间

3.通过检查每个可能的子矩形,计算其中的黑色格子数量。找到一个最小的子矩形,使得其中至少有k个黑色格子。

4.使用二分查找的技巧,在内部循环中快速定位满足条件的子矩形大小

5.最后,我们输出这个最小子矩形的面积。如果不存在满足条件的子矩形,则输出0

26. 简答题

小杨的幸运数字

时间限制:1.0 s

内存限制:512.0 MB

题面描述

小杨认为他的幸运数字应该恰好有两种不同的质因子,例如,12=2×2×3 的质因子有2,3,恰好为两种不同的质因子,因此12是幸运数字,而30=2×3×5 的质因子有2,3,5,不符合要求,不为幸运数字。

小杨现在有n个正整数,他想知道每个正整数是否是他的幸运数字。

输入格式

第一行包含一个正整数n,代表正整数个数。

之后n行,每行一个正整数。

输出格式

输出n行,对于每个正整数,如果是幸运数字,输出1,否则输出0。


输入样例

3
7
12
30

输出样例

0
1
0

样例解释

7的质因子有7,只有一种。

12的质因子有2,3 ,恰好有两种。 

30的质因子有2,3,5,有三种。 

数据范围

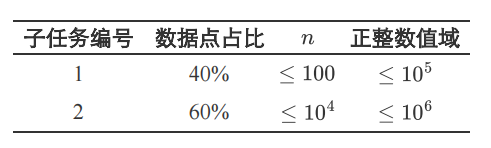
对于全部数据,保证有1≤n≤104,每个正整数ai满足 2≤ai≤106。

查看答案与解析
答案:<pre class="brush:python;toolbar:false">N = 10**5 + 10 a = [0] * N def calc(x): i = 2 mp = {} while i * i &lt;= x: if x % i == 0: mp[i]=1 while x % i == 0: x //= i i += 1 if x != 1: mp[x]=1 return int(len(mp.items())) def main(): n = int(input()) for i in range(1, n + 1): a[i] = int(input()) x = calc(a[i]) if x == 2: print("1") else: print("0") if __name__ == "__main__": main()</pre>
解析:

1.计算输入数据的质因子的个数。具体实现中,可以从最小的质数开始试除,统计不重复的质因子个数。

2.当质因子个数为2时,返回1表示是幸运数字,否则返回0。