首页 › 试卷 › GESP编程能力等级认证 › GESP-Python六级 › 2025年12月CCF-GESP编程能力等级认证Python编程六级真题

2025年12月CCF-GESP编程能力等级认证Python编程六级真题 VIP

GESP-Python六级 共 27 题 2025 年 含标准答案与解析
返回试卷列表
本页为整卷浏览:先自己做一遍,再展开「查看答案与解析」核对。

一、单选题

1. 单选题

在Python的面向对象编程中,下列关于“动态绑定(等效于虚函数)”的描述中,错误的是( )。

  • A

    动态绑定用于支持运行时多态。

  • B

    通过基类变量调用方法时,会根据对象实际类型决定调用版本。

  • C

    构造函数( __init__ )可以通过动态绑定实现多态以支持灵活初始化。

  • D

    基类析构函数( __del__ )常保证子类调用其实现,以避免资源泄漏析构函数常声明为虚函数以避免资源泄漏。

查看答案与解析
答案:C
解析: 分析动态绑定在Python中的实现机制,重点考察方法调用时的运行时类型识别。理解基类引用指向子类实例时,方法查找遵循MRO规则,自动选择对应类中定义的方法版本。构造函数__init__在实例创建时由系统直接调用,不参与常规的方法解析流程。析构函数__del__在对象生命周期结束时由垃圾回收器触发,其调用链条依赖于Python的清理机制,不会强制要求基类显式声明为虚函数以确保派生类的清理代码执行。多态性体现在方法调用阶段,而非对象构造与销毁的隐式过程。
2. 单选题

执行如下代码,将输出 钢琴:叮咚叮咚 和 吉他:咚咚当当 而不是两行 乐器在演奏声音 ,这体现了面向对象编程的( )特性。

class Instrument:
    """基类:乐器"""
    def play(self):
        print("乐器在演奏声音")

    def __del__(self):
        pass


class Piano(Instrument):
    """子类:钢琴"""
    def play(self):
        print("钢琴:叮咚叮咚")


class Guitar(Instrument):
    def play(self):
        print("吉他:咚咚当当")


if __name__ == "__main__":
    instruments = [Piano(), Guitar()]
    for inst in instruments:
        inst.play()
  • A

    继承

  • B

    封装

  • C

    多态

  • D

    链接

查看答案与解析
答案:C
解析: 分析类之间的关系,观察基类定义的通用方法在子类中被重新实现的方式。确认对象调用同一方法时,根据实际类型执行不同行为的过程。关注程序运行时方法调用的动态绑定机制,即相同接口在不同实例上产生不同响应的现象。识别这种通过继承实现但体现为运行时行为差异的特征。
3. 单选题

执行下面代码,将输出( )。

class Instrument:
    def play(self):
        print("乐器在演奏声音")

    def __del__(self):
        pass


class Piano(Instrument):
    def play(self):
        print("钢琴:叮咚叮咚")


class Guitar(Instrument):
    def play(self):
        print("吉他:咚咚当当")


if __name__ == "__main__":
    instruments = [Piano(), Guitar()]
    for inst in instruments:
        Instrument.play(inst)
  • A
    钢琴:叮咚叮咚 吉他:咚咚当当
  • B
    乐器在演奏声音 乐器在演奏声音
  • C

    编译错误

  • D

    运行错误

查看答案与解析
答案:B
解析: 分析类的继承关系和方法重写机制。确定Instrument类中play方法被Piano和Guitar类各自重写。观察列表instruments中存储的是子类实例。遍历该列表时,通过inst获取每个对象,但调用的是父类Instrument的play方法,并将inst作为参数传入。该调用方式绕过子类的play方法,直接执行父类版本。需理解显式使用类名调用实例方法时,不会触发动态绑定,而是执行指定类中的方法实现。
4. 单选题

某文本编辑器把用户输入的字符依次压入栈 S。用户依次输入 A , B , C , D 后,用户按了两次撤销(每次撤销,弹出栈顶一个字符)。此时栈从栈底到栈顶的内容是:( )。

  • A

    A B

  • B

    A B C

  • C

    A B D

  • D

    B C

查看答案与解析
答案:A
解析: 字符按输入顺序依次压入栈,每压入一个字符,栈顶元素更新为当前输入字符。当执行撤销操作时,每次弹出当前栈顶的一个字符,栈的大小减一,栈顶位置下移至前一个元素。连续两次撤销操作会连续移除最后两个入栈的字符。原输入序列为 A、B、C、D,表示这四个字符已按顺序完成入栈。在未发生任何弹出操作前,栈中自栈底到栈顶的元素依次为 A、B、C、D。每次弹出操作从栈顶移除一个元素,不改变剩余元素的相对顺序。连续执行两次弹出后,需确定此时栈中剩余的元素及其从栈底到栈顶的排列。
5. 单选题

假设循环队列数组长度为 N ,其中队空判断条件为: front == rear ,队满判断条件为: (rear + 1) %N == front ,出队对应的操作为: front = (front + 1) % N ,入队对于的操作为: rear = (rear + 1) %N 。循环队列长度 N = 6 ,初始 front = 1 , rear = 1 ,执行操作序列为:入队, 入队, 入队, 出队, 入队, 入队,则最终 (front, rear) 的值是( )。

  • A

    (2, 5)

  • B

    (2, 0)

  • C

    (3, 5)

  • D

    (3, 0)

查看答案与解析
答案:B
解析: 初始化时,front 和 rear 均为 1。每次入队操作执行 rear = (rear + 1) % N,每次出队操作执行 front = (front + 1) % N。根据给定的判断条件,队空为 front == rear,队满为 (rear + 1) % N == front。操作序列依次为:三次入队,一次出队,两次入队。每一步均依据当前 front 和 rear 的值,按对应公式更新其位置。所有计算在模 N 下进行,N 为数组长度 6。更新过程中需严格遵循操作顺序和取模规则。
6. 单选题

以下函数check()用于判断一棵二叉树是否为( )。

from collections import deque

class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right

def check(root):
    if not root:
        return True
    q = deque()
    q.append(root)
    has_null = False
    while q:
        cur = q.popleft()
        if not cur:
            has_null = True
        else:
            if has_null:
                return False
            q.append(cur.left)
            q.append(cur.right)
    return True
  • A

    满二叉树

  • B

    完全二叉树

  • C

    二叉搜索树

  • D

    平衡二叉树

查看答案与解析
答案:B
解析: 函数通过层序遍历处理二叉树节点。初始化队列并将根节点入队。遍历过程中,从队列取出节点,若当前节点为空,设置标志表示已遇到空节点。若当前节点非空且空节点标志已设置,则后续逻辑基于节点存在性与队列操作继续推进。将当前节点的左右子节点依次加入队列,无论其是否为空。遍历持续直至队列为空。整个过程依据节点出队顺序、空节点出现时机及子节点入队规则进行。
7. 单选题

以下代码实现了二叉树的( )。

class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right


def traverse(root):
    if not root:
        return
    traverse(root.left)
    traverse(root.right)
    print(root.val, end=" ")


if __name__ == "__main__":
    root = TreeNode(1)
    root.right = TreeNode(2)
    root.right.left = TreeNode(3)
    print("后序遍历结果:", end="")
    traverse(root)
  • A

    前序遍历

  • B

    中序遍历

  • C

    后序遍历

  • D

    层序遍历

查看答案与解析
答案:C
解析: 分析函数traverse的执行顺序:首先判断根节点是否存在,若不存在则直接返回;接着递归调用左子树,然后递归调用右子树,最后打印当前节点的值。该过程遵循先处理左子树、再处理右子树、最后访问根节点的顺序。观察函数中对左右子树的调用位置与根节点值输出的时间关系,可推断其遍历次序的特点。结合二叉树遍历定义,此种调用结构对应特定的遍历方式。
8. 单选题

下面代码实现了哈夫曼编码,则横线处应填写的代码是( )。

class Symbol:
    def __init__(self, ch='', freq=0, code=''):
        self.ch = ch
        self.freq = freq
        self.code = code


class Node:
    def __init__(self, w=0, l=-1, r=-1, sym=-1):
        self.w = w
        self.l = l
        self.r = r
        self.sym = sym


def pop_min_node(nodes, leaf_idx, n, pA, internal_idx, pB):
    if pA[0] < n and (pB[0] >= len(internal_idx) or nodes[leaf_idx[pA[0]]].w <= nodes[internal_idx[pB[0]]].w):
        res = leaf_idx[pA[0]]
        pA[0] += 1
        return res
    else:
        res = internal_idx[pB[0]]
        pB[0] += 1
        return res


def dfs_build_codes(u, nodes, sym_list, path):
    if u == -1:
        return
    if nodes[u].sym != -1:
        sym_list[nodes[u].sym].code = ''.join(path)
        return
    path.append('0')
    dfs_build_codes(nodes[u].l, nodes, sym_list, path)
    path.pop()
    path.append('1')
    dfs_build_codes(nodes[u].r, nodes, sym_list, path)
    path.pop()


def build_huffman_codes(sym_list):
    n = len(sym_list)
    for sym in sym_list:
        sym.code = ''
    if n <= 0:
        return -1
    if n == 1:
        sym_list[0].code = '0'
        return 0

    nodes = []
    leaf_idx = []
    for i in range(n):
        leaf_idx.append(len(nodes))
        nodes.append(Node(sym_list[i].freq, -1, -1, i))
    leaf_idx.sort(key=lambda x: (nodes[x].w, nodes[x].sym))

    internal_idx = []
    pA = [0]
    pB = [0]
    for k in range(1, n):
        x = pop_min_node(nodes, leaf_idx, n, pA, internal_idx, pB)
        y = pop_min_node(nodes, leaf_idx, n, pA, internal_idx, pB)
        z = len(nodes)
        # 补全缺失的构建内部节点代码(原代码空白处)
        nodes.append(Node(w=nodes[x].w + nodes[y].w, l=x, r=y, sym=-1))
        internal_idx.append(z)

    root = internal_idx[-1] if internal_idx else -1
    path = []
    dfs_build_codes(root, nodes, sym_list, path)
    return root


if __name__ == "__main__":
    syms = [
        Symbol('A', 5),
        Symbol('B', 9),
        Symbol('C', 12),
        Symbol('D', 13),
        Symbol('E', 16),
        Symbol('F', 45)
    ]
    root = build_huffman_codes(syms)
    print(f"哈夫曼树根节点下标:{root}")
    for sym in syms:
        print(f"字符 '{sym.ch}' (频率 {sym.freq}):编码 {sym.code}")
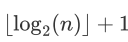
  • A
    nodes.append(Node(nodes[x].w + nodes[y].w, x, y, -1)) 
    internal_idx.append(z)
  • B
    nodes.append(Node(nodes[x].w + nodes[y].w, x, y, 1)) 
    internal_idx.append(z)
  • C
    nodes.append(Node(nodes[x-1].w + nodes[y].w, x, y, 1)) 
    internal_idx.append(z)
  • D
    nodes.append(Node(nodes[x+1].w + nodes[y].w, x, y, 1)) 
    internal_idx.append(z)
查看答案与解析
答案:A
解析: 分析符号频率并构建叶子节点,将所有叶子节点按权重加入待处理队列。每次从队列中选取权重最小的两个节点合并为新内部节点,新节点权重为其子节点权重之和,左右子节点分别指向被合并的两个节点,且该内部节点不关联具体字符。将新生成的内部节点加入节点集合,并记录其索引。重复此过程直至队列中仅剩一个节点,即哈夫曼树的根节点。在合并过程中需维护叶节点和内部节点的索引列表,确保每次取最小权重节点时能正确访问对应节点。
9. 单选题

以下关于哈夫曼编码的说法,正确的是( )。

  • A

    哈夫曼编码是定长编码

  • B

    哈夫曼编码中,没有任何一个字符的编码是另一个字符编码的前缀

  • C

    哈夫曼编码一定唯一

  • D

    哈夫曼编码不能用于数据压缩

查看答案与解析
答案:B
解析: 哈夫曼编码基于字符出现频率构建二叉树,频率越低的字符位于更深的叶节点。编码通过从根到叶路径生成,左分支标记0,右分支标记1,或反之。每个字符对应唯一路径,路径序列即为其编码。由于编码由叶节点决定,任意编码均无法通过另一条完整路径延伸得到,故一个字符的编码不会是另一个字符编码的前缀。构建过程中,不同合并顺序可能产生不同结构的二叉树,导致编码方案不唯一。编码长度随字符频率动态变化,非固定长度。该机制将高频字符映射为短码,低频字符映射为长码,整体编码长度趋于最小化。
10. 单选题
以下函数实现了二叉排序树(BST)的( )操作。
class TreeNode: 
    def __init__(self, val=0, left=None, right=None): 
        self.val = val 
        self.left = left 
        self.right = right 
def op(root, x): 
    if not root: 
        return TreeNode(x) 
    if x &lt; root.val: 
        root.left = op(root.left, x) 
    else: 
        root.right = op(root.right, x) 
    return root
  • A

    查找

  • B

    插入

  • C

    删除

  • D

    遍历

查看答案与解析
答案:B
解析: 分析函数参数,识别递归结构与节点创建行为。观察函数在空节点时返回新节点,表明涉及结构修改。比较输入值与根节点值决定递归方向,左子树处理较小值,右子树处理较大值,符合二叉排序树的组织规则。递归调用嵌入赋值语句,更新左或右子树引用,体现自底向上传播的结构调整过程。无中序前驱或后继节点查找逻辑,未处理双子树非空的复杂情况,排除删除操作的可能性。函数未返回布尔类型或节点值,排除纯查找行为。遍历操作通常不改变树结构且会访问所有节点,与此函数仅沿单一路径深入的行为不符。
11. 单选题

下列代码实现了树的深度优先遍历,则横线处应填入( )。

class TreeNode: 
    def __init__(self, x): 
        self.val = x 
        self.left = None 
        self.right = None 
def dfs1(root): 
    if not root: 
        return 
    temp = [] 
    temp.append(root) 
    while temp: 
        node = temp[-1] 
        temp.pop() 
        print(node.val, end=" ") 
        if node.right: 
            temp.append(node.right) 
        if node.left: 
            temp.append(node.left) 
def dfs2(root): 
    if not root: 
        return 
    st = [] 
    st.append(root) 
    while st: 
        node = st[-1] 
        st.pop() 
        print(node.val, end=" ") 
        if node.right: 
            st.append(node.right) 
        ——————————————————


  • A
    if node.left: 
        st.append(node.left)
  • B
    if node.right: 
        st.append(node.left)
  • C
    if node.left: 
        st.append(node.right)
  • D
    if node.right: 
        st.append(node.right)
查看答案与解析
答案:A
解析: 分析代码逻辑,观察遍历过程中栈的使用方式。dfs1函数中先将右子节点压栈,再将左子节点压栈,导致左子节点先被弹出处理,实现的是根-左-右的访问顺序。dfs2函数结构与dfs1一致,已存在对右子节点的判断和压栈操作。为保持相同的遍历顺序,需在右子节点之后处理左子节点。栈为后进先出结构,因此后续入栈的左子节点将在下一轮循环中优先被访问。需补全对左子节点的条件判断及入栈操作,以维持与dfs1一致的处理流程。
12. 单选题

给定一棵普通二叉树(节点值没有大小规律),下面代码判断是否存在值为 x 的结点,则横线处应填入( )。

class TreeNode: 
    def __init__(self, x): 
        self.val = x 
        self.left = None 
        self.right = None 
from collections import deque 
def bfs_find(root, x): 
    if not root: 
        return None 
    q = deque() 
    q.append(root) 
    while q: 
        cur = q.popleft() 
        if cur.val == x: 
            return cur 
        ______________________ 
    return None
  • A
    q.append(cur.left)
  • B
    q.append(cur.right)
  • C
    if cur.left: 
        q.append(cur.left) 
    if cur.right: 
        q.append(cur.right)
  • D
    if cur.right: 
        q.append(cur.left) 
    if cur.left: 
        q.append(cur.right)
查看答案与解析
答案:C
解析: 使用队列实现广度优先搜索,从根节点开始逐层遍历。每次从队列头部取出一个节点,检查其值是否为目标值。若匹配,则返回该节点。否则,将其存在的左子节点和右子节点依次加入队列尾部,确保后续节点能按层次顺序被访问。遍历持续到队列为空,期间未找到目标值则最终返回None。需保证每个节点的左右子树在存在前提下被加入队列,以避免空引用错误并维持遍历完整性。
13. 单选题

在二叉排序树(Binary Search Tree, BST)中,假设节点值互不相同。给定如下搜索函数,以下说法 一定正确的是( )。

class Node: 
    def __init__(self, val=0, left=None, right=None): 
        self.val = val 
        self.left = left 
        self.right = right 
def find(root, x): 
    while root: 
        if root.val == x: 
            return True 
        if x &lt; root.val: 
            root = root.left 
        else: 
            root = root.right 
    return False
  • A

    最坏情况下,访问结点数是 O(log n)

  • B

    最坏情况下 ,访问结点数是O(n)

  • C

    无论如何 ,访问结点数都不超过树高的一半

  • D

    一定比在普通二叉树中搜索快

查看答案与解析
答案:B
解析: 分析二叉排序树的结构特性,搜索过程从根节点开始,根据目标值与当前节点值的大小关系决定向左子树或右子树移动。每一步比较后仅进入一个子树,路径唯一。访问的节点数等于搜索路径上的节点总数。树的高度由节点插入顺序决定,可能为平衡状态下的O(log n),也可能退化为链状结构时的O(n)。搜索过程中不进行回溯,也不访问无关分支。访问节点数取决于树的实际形态和目标值所在位置。
14. 单选题

0/1 背包(每件物品最多选一次) 问题通常可用一维动态规划求解 ,核心代码如下 。遍历的方向无所谓 ,则下面说法正确的是(  )。

def zero_one_knapsack(items, W): 
    dp = [0] * (W + 1) 
    for w, v in items: 
        for j in range(W, w - 1, -1): 
            dp[j] = max(dp[j], dp[j - w] + v) 
    return dp[W]
  • A

    内层 j 必须从小到大,否则会漏解

  • B

    内层 j 必须从大到小,否则同一件物品会被用多次

  • C

    j 从大到小或从小到大都一样

  • D

    只要 dp 初始为 0 ,方向无所谓

查看答案与解析
答案:B
解析: 动态规划数组 dp 表示容量为 j 时能获得的最大价值。每件物品仅可选择一次,更新状态时需确保当前物品的重量和价值不会基于本轮已更新的状态进行计算。内层循环遍历容量从 W 到 w,采用逆序确保每次状态转移依赖的是前一轮物品的 dp 值。若采用正序,则较小容量的状态先被更新,后续较大容量可能重复引用同一物品,导致物品被多次使用。逆序避免了当前轮次的状态覆盖对后续状态转移的影响。
15. 单选题

以下关于动态规划的说法中,错误的是( )。

  • A

    动态规划方法通常能够列出递推公式。

  • B

    动态规划方法的时间复杂度通常为状态的个数。

  • C

    动态规划方法有递推和递归两种实现形式。

  • D

    在使用动态规划思想(即避免重复子问题)的前提下,递推实现与递归实现(记忆化搜索)的时间复杂度通常是相当的。

查看答案与解析
答案:B
解析: 动态规划通过定义状态描述问题的子结构,建立状态之间的转移关系形成递推公式。状态数量决定计算过程中需要处理的子问题总数。实现时可采用自底向上的递推方式,按顺序求解每个状态;也可采用自顶向下的递归方式配合记忆化存储,避免重复计算相同状态。两种实现方式均覆盖全部必要子问题,访问的状态集合一致,执行的操作规模由状态空间和转移成本共同决定。算法的时间开销取决于状态总数与单个状态转移所需时间的乘积。

二、判断题

16. 判断题

以下代码中,构造函数被调用的次数是1次。

class Test: 
    init_count = 0 
    def __init__(self): 
        Test.init_count += 1 
        print("T ", end="") 
    def __copy__(self): 
        print("(拷贝构造,不触发__init__)", end="") 
        new_obj = Test.__new__(Test) 
        return new_obj 
if __name__ == "__main__": 
    a = Test() 
    import copy 
    b = copy.copy(a)
  • A对
  • B错
查看答案与解析
答案:错
解析: 分析类Test中__init__方法的调用时机;考察实例创建时__init__是否执行;识别copy.copy调用触发的是__copy__方法而非__init__;确认通过__new__直接创建对象时不自动调用__init__;统计整个程序运行过程中__init__的实际执行次数。
17. 判断题

面向对象编程中,封装是指将数据和操作数据的方法绑定在一起,并对外隐藏实现细节。

  • A对
  • B错
查看答案与解析
答案:对
解析: 分析封装的定义,确认其是否包含将数据与方法组合为一个单元的机制,并检查是否存在对内部实现细节的访问限制机制。观察该机制是否通过类或类似结构实现信息隐藏,同时允许通过接口与外部交互。识别绑定行为与隐藏行为在概念上的并列关系,判断二者是否共同构成封装的核心特征。
18. 判断题

以下代码能够正确统计二叉树中叶子结点的数量。

class TreeNode: 
    def __init__(self, val=0, left=None, right=None): 
        self.val = val 
        self.left = left 
        self.right = right 
def count_leaf(root): 
    if not root: 
        return 0 
    if not root.left and not root.right: 
        return 1 
    return count_leaf(root.left) + count_leaf(root.right) 
if __name__ == "__main__": 
    root1 = TreeNode(1) 
    root1.left = TreeNode(2) 
    root1.right = TreeNode(3) 
    root1.left.left = TreeNode(4) 
    root1.left.right = TreeNode(5) 
    root1.right.right = TreeNode(6) 
    print(f"二叉树1的叶子节点数:{count_leaf(root1)}") 
    root2 = TreeNode(1) 
    print(f"二叉树2的叶子节点数:{count_leaf(root2)}") 1 
    root3 = None 
    print(f"空树的叶子节点数:{count_leaf(root3)}")


  • A对
  • B错
查看答案与解析
答案:对
解析: 分析二叉树结构,识别叶子结点的定义为左右子树均为空的结点。通过递归遍历根结点,判断当前结点是否为空,若为空则返回0;若当前结点为叶子结点则返回1;否则递归计算左子树和右子树的叶子结点数量并求和。对每个测试用例,分别构建对应的二叉树或空树,调用统计函数处理不同形态的树结构,包括单结点树、多层树及空树的情况。
19. 判断题

广度优先遍历二叉树可用栈来实现。

  • A对
  • B错
查看答案与解析
答案:错
解析: 广度优先遍历要求按层级顺序访问节点,先访问根节点,再依次访问各层子节点。实现时需在访问当前节点后,将其子节点暂存以便后续处理。栈的特点是后进先出,会导致最后存入的子节点最先被取出,从而打破层级访问顺序。若使用栈存储待访问节点,则节点的处理顺序受压入顺序影响,无法保证同一层节点在下一层节点之前被统一处理。为维持层级遍历特性,需采用先进先出的数据结构管理待访问节点序列。
20. 判断题

函数调用管理可用栈来管理。

  • A对
  • B错
查看答案与解析
答案:对
解析: 函数调用过程中,每次调用新函数时,系统会将该函数的局部变量、参数、返回地址等信息封装为栈帧;栈帧按调用顺序依次压入调用栈;当函数执行结束,对应的栈帧从调用栈顶部弹出;栈的后进先出特性与函数调用和返回的顺序一致;通过栈的操作机制可实现嵌套调用和递归调用的正确执行流程管理。
21. 判断题

在二叉排序树(BST)中,若某结点的左子树为空,则该结点一定是整棵树中的最小值结点。

  • A对
  • B错
查看答案与解析
答案:错
解析: 分析二叉排序树的性质,其中每个结点的左子树所有结点值均小于该结点值,右子树所有结点值均大于该结点值。若某结点左子树为空,则不存在比该结点值更小的左后代结点。根据二叉排序树的中序遍历特性,最小值结点位于最左侧路径的末端。判断该结点是否处于从根开始的最左路径的终点,需考察其祖先结点及路径上的比较过程。结合树的整体结构与结点位置关系,推导该结点在全局中的相对大小位置。
22. 判断题

下面的函数能正确判断一棵树是不是二叉排序树(左边的数字要比当前数字小,右边的数字要比当前数字大)。

class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right
def is_bst(root, min_val=float('-inf'), max_val=float('inf')):
    if not root:
        return True
    if root.val <= min_val or root.val >= max_val:
        return False
    return is_bst(root.left, min_val, root.val) and is_bst(root.right, root.val, max_val)
  • A对
  • B错
查看答案与解析
答案:对
解析:

1. 检查当前节点是否为空,若为空则返回True。
2. 判断当前节点的值是否满足大于最小值且小于最大值的约束条件。
3. 递归检查左子树,更新最大值约束为当前节点的值。
4. 递归检查右子树,更新最小值约束为当前节点的值。
5. 所有递归调用均需同时满足约束条件和子树的判断结果。

23. 判断题

格雷编码相邻两个编码之间必须有多位不同,以避免数据传输错误。

  • A对
  • B错
查看答案与解析
答案:错
解析: 分析格雷编码的定义与特性,明确其相邻两个编码之间仅允许有一位二进制位不同;考察相邻编码间多位不同的情况是否符合该编码规则;根据格雷编码的构造机制,如反射性质与递归生成方式,验证任意相邻编码之间的位变化数量;比较题干所述‘必须有多位不同’与实际编码规则中‘仅一位不同’的差异。
24. 判断题

小杨在玩一个闯关游戏,从第 1 关走到第 4 关。每一关的体力消耗如下(下标表示关卡编号): cost = [0, 3, 5, 2, 4 ] ,其中 cost[i] 表示到达第 i 关需要消耗的体力, cost[0]=0 表示在开始状态,体力消耗为0。小杨每次可以从当前关卡 前进 1 步或 2 步。按照上述规则,从第 1 关到第 4 关所需消耗的最小体力为 7。

  • A对
  • B错
查看答案与解析
答案:错
解析: 将问题建模为动态规划问题,定义状态数组 dp,其中 dp[i] 表示到达第 i 关所需的最小体力消耗。初始化 dp[0] = 0,dp[1] = cost[1]。从第 2 关开始,每关的状态由前一关或前两关转移而来,状态转移方程为 dp[i] = min(dp[i-1], dp[i-2]) + cost[i]。遍历关卡编号从 2 到 4,依次计算 dp 数组的值。最终结果为 dp[4]。过程中仅依据给定的 cost 数组和移动规则进行状态更新,不涉及额外假设或外部信息。
25. 判断题

假定只有一个根节点的树的深度为1 ,则一棵有 n 个节点的完全二叉树 ,则树的深度为

  • A对
  • B错
查看答案与解析
答案:对
这道题暂未补解析。

三、简答题

26. 简答题

路径覆盖

时间限制:3.0 s

内存限制:512.0 MB

题目描述

给定一棵有 n 个结点的有根树 T ,结点依次以 1 , 2, . , n 编号 ,根结点编号为 1 。方便起见 ,编号为 i 的结点称为结点 i。

初始时 T 中的结点均为白色。你需要将 T 中的若干个结点染为黑色,使得所有叶子到根的路径上至少有一个黑色结

点。将结点 i 染为黑色需要代价 c,你需要在满足以上条件的情况下,最小化染色代价之和。

叶子是指 T 中没有子结点的结点。

 输入格式

第一行,一个正整数 n,表示结点数量。

输出格式

一行,一个整数,表示在满足所有叶子到根的路径上至少有一个黑色结点的前提下,染色代价之和的最小值。

输入样例 1

4
1 2 3
5 6 2 3

输出样例 1

2

 输入样例 2

7
1 1 2 2 3 3
64 16 15 4 3 2 1

输出样例 2

10

数据范围

查看答案与解析
答案:<pre class="brush:python;toolbar:false">getint = lambda: map(int, input().split()) getints = lambda: list(getint()) # 获取节点数 n = int(input()) # 各个节点的根节点 f = [0, 0] + getints() # 各个节点涂黑的成本 c = [0] + getints() # cnt[i]表示节点i有多少子节点 cnt = [0] * (n + 1) # ans[i]表示以节点i为根节点的子树,需要多少成本才能让所有叶子结点到根节点都有涂黑的节点 ans = [0] * (n + 1) # 统计一个节点有多少子节点 for i in range(2, n + 1): cnt[f[i]] += 1 # 遍历每一个节点,因为一个节点的父节点编号肯定这个节点,所以大编号的一定更深 for i in range(n, 0, -1): # 如果一个节点没有子节点,那么显然ans[i]=c[i]就是把自己涂黑 if cnt[i] == 0: ans[i] = c[i] # 一个节点当前已经找到的答案等于 ans[i] = min(ans[i], c[i]) ans[f[i]] += ans[i] print(ans[1])</pre>
这道题暂未补解析。
27. 简答题

道具商店

题目描述

道具商店里有n件道具可供挑选 。第 i 件道具可为玩家提升 ai 点攻击力 ,需要 ci 枚金币才能购买 ,每件道具只能购买一次 。现在你有k枚金币 ,请问你最多可以提升多少点攻击力?

输入格式

第一行 ,两个正整数 n, k ,表示道具数量以及你所拥有的金币数量。

接下来 n行 ,每行两个正整数 ai , ci ,表⽰道具所提升的攻击力点数, 以及购买所需的金币数量。

输出格式

输出一行,一个整数 ,表示最多可以提升的攻击力点数。

输入样例 1

3  5

99  1

33  2

11  3

输出样例 1

132

输入样例 2

1  4  100

2  10  1

3  20  11

4  40  33

5  100  99

输出样例 2

110

数据范围

对于 60 的测试点,保证 1 ≤ k ≤ 500,1  ≤ ci ≤ 500 。

对于所有测试点,保证 1 ≤ n ≤ 500,1≤ k ≤ 109 ,1≤ ai ≤ 500, 1≤ ci ≤ 109。

查看答案与解析
答案:<pre class="brush:python;toolbar:false">getint = lambda: map(int, input().split()) getints = lambda: list(getint()) # 得到物品数量和预算 n, k = getint() # 这里进行了滚动优化,dp[j]表示攻击力为j的情况下的最小预算 # 最大攻击力为500*500,所以初始化这么大的数组,并且所有值都是1e10表示无穷大预算 f = [0] + [int(1e10)] * 500 * 500 # 能够达到的最大攻击力,用来缩小遍历的范围 s = 0 for i in range(n): # 输入当前物品的攻击力和价格 a, c = getint() s += a # 计算题解中的转移公式,因为j是从高到低遍历的,f[j-a]和f[j]此时尚未被更新,相当于是f[i-1][j-a]与 f[i-1][j] for j in range(s, a - 1, -1): f[j] = min(f[j], f[j - a] + c) # 遍历f[i]得到符合预算条件的最高攻击力 ans = 0 for i in range(s + 1): if f[i] &lt;= k: ans = i print(ans)</pre>
这道题暂未补解析。