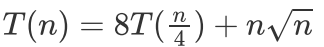首页 › 试卷 › GESP编程能力等级认证 › GESP-Python七级 › 2025年12月CCF-GESP编程能力等级认证Python编程七级真题

2025年12月CCF-GESP编程能力等级认证Python编程七级真题 VIP

GESP-Python七级 共 27 题 2025 年 含标准答案与解析
返回试卷列表
本页为整卷浏览:先自己做一遍,再展开「查看答案与解析」核对。

一、单选题

1. 单选题

下面关于Python中形参、实参和作用域的说法中,错误的一项是( )。

  • A

    形参是函数定义时声明的参数,仅在函数内部的作用域中有效

  • B

    实参是调用函数时传递给函数的实际值,会按对应关系绑定到形参

  • C

    函数内部修改形参的值,一定会影响外部实参的取值(无论实参类型)

  • D

    若函数内要修改全局作用域的变量,需通过 global 关键字声明

查看答案与解析
答案:C
解析: 函数定义时声明的参数称为形参,仅在函数内部作用域中存在。调用函数时传入的值为实参,其值被绑定到对应形参。形参接收实参的值后,形成局部变量,存在于函数作用域内。基本数据类型通过值传递,对象类型通过引用传递,但参数传递机制不直接决定外部变量是否被修改。函数内部默认只能访问局部作用域和嵌套作用域中的变量。若需在函数内重新绑定全局变量,必须使用 global 关键字声明该变量名。作用域的查找遵循 LEGB 规则,即局部、嵌套、全局、内置四个层级。
2. 单选题

已知三个序列: s1 = {3, 1, 8, 2, 5, 6, 7, 4} , s2 = {1, 5, 1, 8, 6, 4, 7, 5, 6} , s3 ={1, 8, 3, 5, 7, 6, 2, 4} 。以下哪个序列是它们的最长公共子序列( )。

  • A

    {1, 8, 5, 6}

  • B

    {1, 5, 6, 7}

  • C

    {1, 8, 6}

  • D

    {1, 5, 7, 4}

查看答案与解析
答案:A
解析: 确定三个序列的最长公共子序列需逐元素比对,找出在所有序列中按相同顺序出现的最长元素序列。首先枚举可能的公共子序列,筛选出仅包含同时存在于s1、s2和s3中的元素且保持各自原有顺序的候选序列。对每个候选序列验证其是否能在三个序列中分别找到对应的递增下标序列,使得元素顺序一致。比较所有合法公共子序列的长度,选择长度最大者作为结果。若多个序列长度相同,则任取其一作为最长公共子序列。
3. 单选题

现有一个地址区间为0~10 的哈希表,当出现冲突情况,会往后找第一个空的地址存储(到 10 冲突了就从 0开始往后),现在要依次存储(1,3,5,7,9) ,哈希函数为h(x)=(x²+x)mod 11 。其中 9 存储在哈希表哪个地址中( )。

  • A

    1

  • B

    2

  • C

    3

  • D

    4

查看答案与解析
答案:D
解析: 计算每个元素通过哈希函数 h(x) = (x² + x) mod 11 得到的初始地址。按输入顺序依次处理元素,若该地址为空,则存储;若已被占用,则从该地址后一个位置开始线性探测,逐位检查下一个地址是否为空,直到找到第一个空地址进行存储。探测过程在到达地址 10 后若仍需继续,则回绕至地址 0 继续查找。重复此过程直至所有元素存储完毕。关注元素 9 在该机制下的最终存储位置。
4. 单选题

在0/1背包问题中,给定一组物品,每个物品有一个重量和价值,背包的容量有限。假设背包的最大容量为 W,物品的数量为 n,其中第 i个物品的重量为 w[i],价值为 v[i]。以下关于0/1背包问题的描述,正确的是( )。

  • A

    在解决0/1背包问题时,使用贪心算法可以保证找到最优解,因为物品只能放入一次。

  • B

    0/1背包是P问题(多项式时间可解问题),它可以在 O(nW)的时间复杂度内解决。

  • C

    0/1背包问题中,动态规划解法的空间复杂度为O(nW),但可以通过滚动数组技巧将空间复复杂优化到 O(W)。

  • D

    0/1背包问题中,每个物品只能选择一次,并且子问题之间是独立的,无法重用计算结果。

查看答案与解析
答案:C
解析: 分析0/1背包问题的求解机制。该问题涉及在容量限制下选择物品以最大化总价值,每个物品仅可选一次。动态规划通过构建状态表记录前i个物品在不同重量限制下的最优价值,状态转移基于是否放入第i个物品。状态表的行对应物品数量,列对应重量范围,时间复杂度由物品数和容量决定。空间优化可通过滚动数组实现,利用当前状态仅依赖前一状态的特性,压缩存储维度。贪心策略无法保证最优解,因局部最优选择不必然导向全局最优。子问题具有重叠性,计算结果可被多次引用。问题不属于P类,因其多项式时间算法依赖数值输入而非输入长度。
5. 单选题

一棵深度为 6(根节点深度为1)的完全二叉树,节点总数最少有( )。

  • A

    31

  • B

    32

  • C

    63

  • D

    64

查看答案与解析
答案:B
解析: 完全二叉树的深度由根节点开始计算,深度为k时,前k-1层是满二叉树结构。第k层至少存在一个节点。前k-1层的节点总数为2^(k-1)-1。将深度k=6代入,前5层节点总数为2^5 - 1 = 31。第6层至少有1个节点,因此总节点数为前5层节点数与第6层最小节点数之和。
6. 单选题

对于如下二叉树,下面关于访问的顺序说法错误的是( )。

  • A

    D E B F H J I G C A 是它的后序遍历序列。

  • B

    A B C D E F G H I J 是它的广度优先遍历序列。

  • C

    A B D E C F G H I J 是它的先序遍历序列。

  • D

    D B E A F C H G J I 是它的中序遍历序列。

查看答案与解析
答案:D
这道题暂未补解析。
7. 单选题

下面程序的运行结果为( )。

def query(n, a, x): 
    left = 0 
    right = n 
    while left < right: 
        mid = left + (right - left) // 2 
        if a[mid] >= x: 
            right = mid 
        else: 
            left = mid + left 
    if left == n: 
        return -1 
    return left 
if __name__ == "__main__": 
    n = 10 
    x = 3 
    num = [1, 2, 2, 3, 3, 4, 5, 5, 6, 7] 
    result = query(n, num, x) 
    print(result)
  • A

    2

  • B

    3

  • C

    4

  • D

    5

查看答案与解析
答案:B
解析: 函数query接收三个参数n、a、x,其中n表示数组长度,a为已排序的列表,x为目标值。使用二分查找策略,初始化左边界left为0,右边界right为n。进入循环,计算中点mid,若a[mid]大于等于x,则将右边界更新为mid,否则将左边界更新为mid+1。循环结束条件为left >= right。最终判断left是否等于n,若是则返回-1,表示未找到;否则返回left作为第一个不小于x的元素位置。主程序中传入n=10,x=3,num为有序数组,调用query函数并打印结果。
8. 单选题

下面程序中,函数 query 的时间复杂度是( )。

def query(n, a, x): 
    left = 0 
    right = n 
    while left < right: 
        mid = left + (right - left) // 2 
        if a[mid] >= x: 
            right = mid 
        else: 
            left = mid + 1 
    if left == n: 
        return -1 
    return left 
if __name__ == "__main__": 
    n = 10 
    x = 3 
    num = [1, 2, 2, 3, 3, 4, 5, 5, 6, 7] 
    print(query(n, num, x))
  • A

    O(1)

  • B

    O(log n)

  • C

    O(n)

  • D

    O(n log n)

查看答案与解析
答案:B
解析: 函数 query 使用 while 循环控制 left 和 right 的范围,每次迭代将搜索区间缩小一半。循环条件依赖 left 和 right 的关系,且每次更新 mid 为 (left + right) // 2。当 mid 满足特定条件时,right 被赋值为 mid,否则 left 被更新为 mid + 1。循环持续直到 left 不小于 right。过程中仅进行常数时间的操作,无嵌套循环或递归。元素比较和指针移动均在固定时间内完成。整个执行路径由区间长度决定,每次将问题规模近似减半。
9. 单选题

有5个字符,它们出现的次数分别为2次、2次、3次、3次、5次。现在要用哈夫曼编码的方式来为这些字符进行编码,最小加权路径长度WPL(每个字符的出现次数 它的编码长度,再把每个字符结果加起来)的值为( )。

  • A

    30

  • B

    34

  • C

    43

  • D

    47

查看答案与解析
答案:B
解析: 将每个字符的出现次数作为叶子节点的权值,构建哈夫曼树。每次选择权值最小的两个节点合并为一个新节点,新节点的权值为两者之和,直至所有节点合并成一棵树。每个字符的编码长度等于其对应叶子节点在树中的深度。最小加权路径长度WPL为各叶子节点的权值与其深度乘积的总和。计算过程基于贪心策略,优先合并较小权值节点,以确保高频字符拥有较短编码路径。
10. 单选题

下面程序的运行结果为( )。

def f(n): 
    if n &lt;= 2: 
        return n * 2 
    return f(n - 1) + f(n - 2) 
if __name__ == "__main__": 
        print(f(5))
  • A

    10

  • B

    16

  • C

    26

  • D

    30

查看答案与解析
答案:B
解析: 分析函数f的定义,观察其参数n的使用方式。检查函数体内是否存在条件判断,根据条件分支确定执行路径。若存在递归调用,需明确递归的终止条件及每次调用时参数的变化规律。结合函数外部的调用语句,确定传入的实际参数值。按照函数执行流程,逐步展开每一步的计算过程,追踪变量状态的演变。最终得出函数返回值的推导路径。
11. 单选题

一个简单无向图 G 有36条边,且每个顶点的度数都为4,则图 G 的顶点个数为( )。

  • A

    9

  • B

    12

  • C

    18

  • D

    36

查看答案与解析
答案:C
解析: 利用图论中边数与顶点度数的关系,所有顶点的度数之和等于边数的两倍。设顶点个数为 n,每个顶点的度数为 4,则总度数为 4n。根据握手定理,总度数等于 2 倍边数,即 4n = 2 × 36。通过代数运算可得 n 的值。
12. 单选题

下面关于二叉树的说法正确的是( )。

  • A

    任意二叉树的中序遍历与后序遍历必定不相同。

  • B

    对任意二叉树,若已知先序遍历与后序遍历,则该二叉树唯一确定。

  • C

    若二叉树有 n个结点,根节点高度为 1,则其高度满足: 。

  • D

    在二叉树的先序遍历中,根后紧跟的结点一定是根的左孩子。

查看答案与解析
答案:C
这道题暂未补解析。
13. 单选题

假设一个算法时间复杂度的递推式是(n为正整数),和T(0)=1,那么这个算法的时间复杂度是( )。
  • A

  • B

  • C

  • D

查看答案与解析
答案:B
这道题暂未补解析。
14. 单选题

下面哪一个可能是下图的深度优先遍历序列( )。

  • A

    1, 5, 6, 3, 2, 8, 9, 4, 7

  • B

    1, 5, 8, 9, 7, 4, 6, 3, 2

  • C

    3, 2, 1, 4, 7, 6, 9, 5, 8

  • D

    2, 5, 6, 3, 8, 7, 9, 4, 1

查看答案与解析
答案:B
这道题暂未补解析。
15. 单选题

下面这个有向图的强连通分量的个数是(  )。

  • A

    3

  • B

    4

  • C

    5

  • D

    6

查看答案与解析
答案:C
这道题暂未补解析。

二、判断题

16. 判断题

Python语言中,表达式 3 ^ 2 的结果类型为 int ,值为 1 。

  • A对
  • B错
查看答案与解析
答案:对
解析: 分析表达式中运算符的语义,确定其在Python中的具体行为;识别参与运算的操作数类型;根据运算规则推导结果值;依据Python类型系统判断结果的数据类型。
17. 判断题

使用 math 模块中的正弦函数,表达式 math.sin(90) 的结果类型为 double ,值约为 1 。

  • A对
  • B错
查看答案与解析
答案:错
解析: 导入 math 模块后,math.sin() 函数接收弧度制角度作为参数。该函数返回一个浮点数类型的结果,表示对应角度的正弦值。输入数值 90 直接传入 math.sin() 时,会被视为弧度而非度数。数学上,sin(π/2) 等于 1,而 π/2 弧度约等于 1.5708。计算 sin(90) 实际求解的是 90 弧度角的正弦值,其结果不等于 1。浮点数运算结果遵循 IEEE 754 标准,具有有限精度。
18. 判断题

使用Python的字符串比较方式对比 "10" 和 "9" ,表达式 "10" > "9" 的结果为 True

  • A对
  • B错
查看答案与解析
答案:错
解析: 字符串比较基于字符的Unicode码点值逐位进行。当两个字符串长度不同且较短字符串的所有字符都与较长字符串前缀匹配时,较长字符串被视为更大。比较过程从左至右依次对比每个位置上的字符,一旦出现差异则立即决定结果;若所有对应位置字符均相同,则以长度较长者为大。
19. 判断题

选择排序是一种不稳定的排序算法,而冒泡排序是一种稳定的排序算法。

  • A对
  • B错
查看答案与解析
答案:对
解析: 分析排序算法的稳定性时,考察相同元素在排序前后相对位置是否发生变化。选择排序在每轮选取最小(或最大)元素与当前位置交换的过程中,可能改变相同元素的相对顺序。冒泡排序通过相邻元素比较和交换,仅在严格大于(或小于)时进行交换,相同元素不会发生位置交换,因此能保持相对顺序不变。根据算法执行过程中元素交换的触发条件和位置变化机制,可推导出各自对相同元素相对位置的影响方式。
20. 判断题

求两个长度为 n 序列的最长公共子序列(LCS)长度时,可以使用滚动数组将空间复杂度从 O(n²)优化到 O(n)。

  • A对
  • B错
查看答案与解析
答案:对
解析: 使用动态规划求解最长公共子序列时,状态转移依赖于前一行和当前行的值。通过滚动数组技术,仅保留当前行和前一行的状态,将二维状态表压缩为两个一维数组交替更新。每次遍历时根据索引奇偶性或模运算决定当前使用哪一行,从而实现空间复用。该方法使存储空间由O(n²)降至O(n),同时保持时间复杂度不变。
21. 判断题

在无向图中,所有顶点的度数之和等于边数的两倍。

  • A对
  • B错
查看答案与解析
答案:对
解析: 分析无向图中每个边连接两个顶点,每条边对两个顶点的度数各贡献1。统计所有顶点的度数时,每条边被计算两次。将所有顶点的度数相加,总和来源于每条边的两次贡献。通过累加顶点度数的方式,可推导出总和与边数之间的数量关系。该关系由边与顶点连接方式的结构性决定。
22. 判断题

使用邻接矩阵存储一个有 V 个顶点、E 条边的图,对该图进行一次完整的BFS遍历,时间复杂度为 O(V+E)。

  • A对
  • B错
查看答案与解析
答案:错
解析: BFS遍历从起始顶点开始,使用队列管理待访问顶点。邻接矩阵为V×V二维数组,每行对应一个顶点,元素表示顶点间是否存在边。算法首先初始化所有顶点为未访问状态。将起始顶点标记为已访问并入队。当队列非空时,出队一个顶点,遍历其在邻接矩阵中的对应行,查找所有与其相邻且未访问的顶点,将它们标记为已访问并入队。每个顶点被访问一次,每条边在矩阵中被检查一次。由于需扫描整个矩阵以检测邻接关系,总时间开销由顶点数V和边的检查次数决定。
23. 判断题

在图像处理或游戏开发中,泛洪(flood fill)算法既可以用BFS实现,也可以用DFS实现。

  • A对
  • B错
查看答案与解析
答案:对
解析: 泛洪算法通过访问连通区域内的所有可达节点实现填充操作。BFS使用队列结构逐层遍历相邻像素,按距离起始点的远近顺序处理节点。DFS使用栈结构(或递归调用)沿路径深入访问,直到无法继续后再回溯处理其他分支。两种遍历方式均可覆盖相同连通区域,只要访问条件和边界判断一致,就能达到相同的填充效果。实现时需记录已访问节点以避免重复处理。
24. 判断题

使用链地址法处理冲突的哈希表,当所有元素都映射到同一个槽位时,查找操作的最坏时间复杂度为O(n),其中 n 为元素个数。

  • A对
  • B错
查看答案与解析
答案:对
解析: 链地址法中,哈希表每个槽位对应一个链表存储映射到该位置的元素。当所有元素经哈希函数计算后均落入同一槽位时,该槽位的链表长度为n。查找操作需遍历该链表直至找到目标元素或遍历完毕。遍历长度为n的链表所需时间与n成正比。时间复杂度由链表遍历过程中的比较次数决定。
25. 判断题

一个包含 V 个顶点的连通无向图,其任何一棵生成树都恰好包含 V-1 条边。

  • A对
  • B错
查看答案与解析
答案:对
解析: 分析连通无向图的生成树定义,明确生成树是极小连通子图且包含所有顶点。根据图论基本性质,生成树中不存在环,且任意两个顶点间有唯一路径。考虑构建生成树的过程:从单个顶点开始,每加入一个新顶点需添加一条边以保持连通性,新增顶点数为V-1时,对应新增边数即为V-1。验证该边数与顶点数的关系是否在所有可能构造方式下均成立,不依赖具体算法或实例。考察是否存在其他边数配置仍满足生成树条件的可能性。

三、简答题

26. 简答题

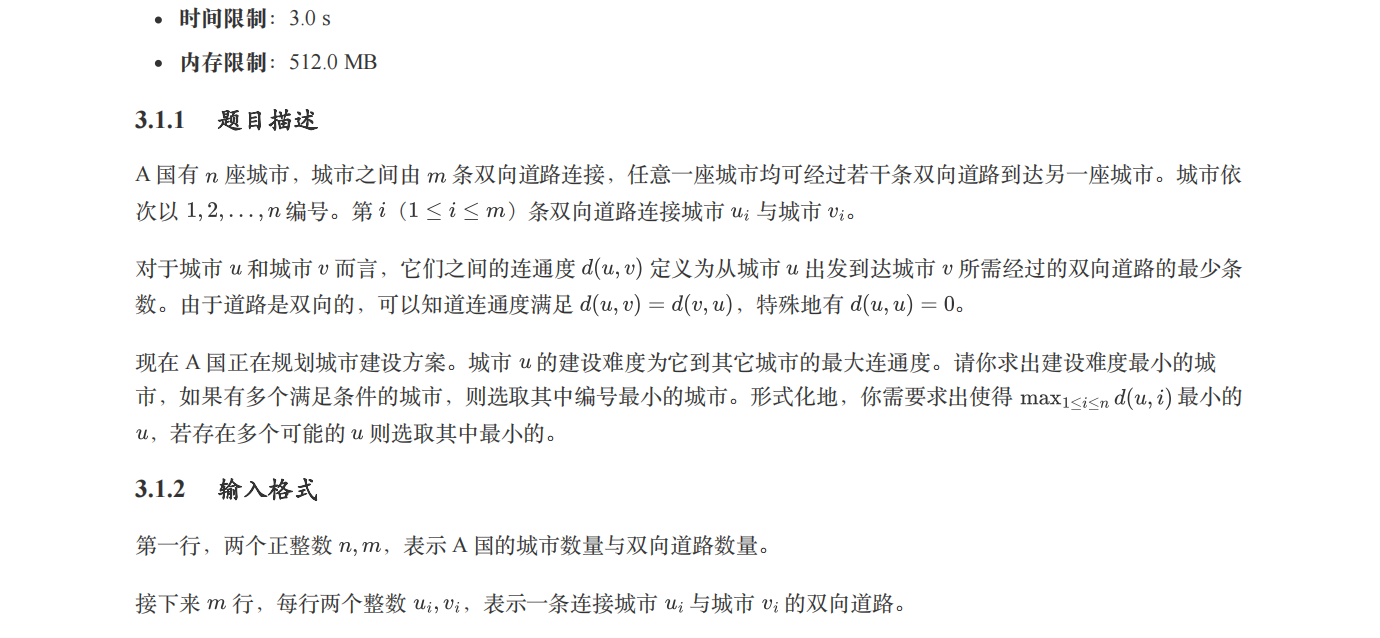
城市规划

查看答案与解析
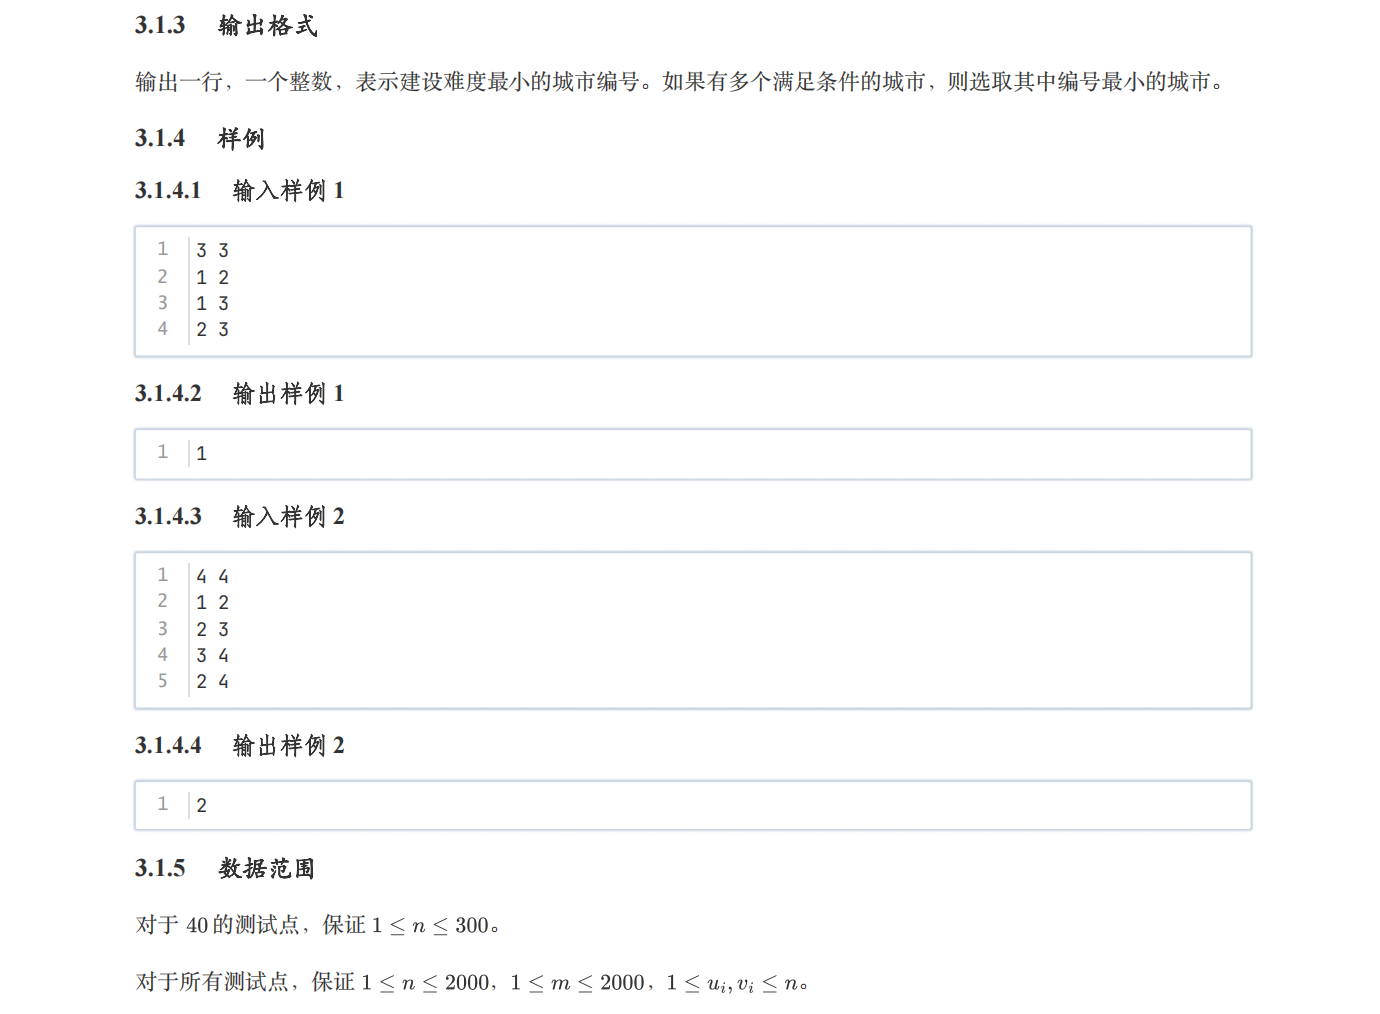
答案:<pre class="brush:python;toolbar:false"># tokens里面缓存了输入 tokens = [] # 这个函数将输入的内容放到tokens里面,随后再读取tokens里的第一条内容作为输入 def get_val():     while not tokens:         tokens.extend(input().split())     return int(tokens.pop(0)) # 得到城市和边的数量 n = get_val() m = get_val() # 邻接表,每一个节点后面的列表表示这个节点到列表里面的节点有边 e = [[] for _ in range(n + 1)] for _ in range(m):     u = get_val()     v = get_val()     e[u].append(v)     e[v].append(u) # 假设当前在遍历节点i,则d[j]表示节点i目前发现的到j的最短距离。如果这个值为n+1则表明我们还没遍历到j,否则表示我们已经遍历到了j d = [0] * (n + 1) # 这个列表其实是队列,用在以i为中心的广度优先搜索中,记录即将被bfs遍历到的节点 q = [0] * (n + 2) # 这个数组缓存了各个城市的建设成本 mx = [0] * (n + 1) def bfs(u):     # 初始化d数组,表明所有节点都还没被遍历到     for i in range(1, n + 1):         d[i] = n + 1     # 初始节点已经被遍历到了     d[u] = 0     # 将初始节点入队     q[1] = u     # 广度优先的队列左右边界,初始化为1,表明还没开始遍历。这个队列的长度是n+2,而一共只有n个节点,所以这个队列肯定不会被装满,一个节点只会入队不超过1次     ql, qr = 1, 1     # 只要队列还不空就继续遍历     while ql &lt;= qr:         # 将队首的元素出栈,将队首元素称为x         x = q[ql]         ql += 1         # 遍历从x出发能够直接到达的节点         for y in e[x]:             # 如果当前找到的最短路径不如从初始节点到x再多走一步,那么就将y节点入队             if d[x] + 1 &lt; d[y]:                 d[y] = d[x] + 1                 # 理论上来讲,使用数组一样的数据结构存储队列元素,这里需要取模。但是这道题里面,每一个节点只会入队一次,所以qr最大就到n+1,因此不需要取模                 qr += 1                 q[qr] = y     # 队列中最后一个弹出的元素一定是最后入队的,这个元素一定离初始节点最远,所以他的距离就是建设难度     mx[u] = d[q[qr]] ans = 1 for i in range(1, n + 1):     bfs(i)     # 判断当前的建设难度是否小于之前找到的最小的,如果是则更新答案     if mx[i] &lt; mx[ans]:         ans = i print(ans)</pre>
这道题暂未补解析。
27. 简答题

学习小组

3.2.3 输出格式

输出一行,一个整数,表示所有划分方案中,学习小组综合讨论积极度之和的最大值。

3.2.4.1 输入样例 1

4
2 1 3 2
1 5 6 3

3.2.4.2 输出样例 1

12

3.2.4.3 输入样例 2

8
1 3 2 4 3 5 4 6
0 2 5 6 4 3 3 4

3.2.4.4 输出样例 2

21

查看答案与解析
答案:<pre class="brush:python;toolbar:false">getint = lambda: map(int, input().split()) getints = lambda: list(getint()) # 同学数量 n = int(input()) # 按照讨论积极程度从小到大排序,方便后面计算转移方程 c = sorted(getints()) # 不同分组的基础讨论度 a = [0] + getints() # 用来进行动态规划的数组 # f[j][k]表示在当前已经用掉k个学生,且包含了j个人数不为1的组的情况下的最大积极度 # 我们在这里使用了滚动数组优化,所以没有题解中的i维度 f = [[0] * (n + 1) for _ in range(n + 1)] # 考虑人数最少的组不少于i个人的情况 for i in range(n, 0, -1):     # j表示分成了多少个组     # 一共就n个人,所以组的数量绝对不大于n//i+1     for j in range(1, n // i + 1):         # 如果最后一个小组刚刚好有i个人,因为之前的组都有至少i个人,所以新加入的组应该选择第j大和第j小的元素作为极大极小值         diff = c[n - j] - c[j - 1] if i &gt; 1 else 0         if diff &lt; 0:             break         # 假设我们考虑用掉了k个学生,只需要考虑k&gt;=i的情况即可         for k in range(i, n + 1):             # 判断最后一个小组如果刚刚好有i个人能否比             f[j][k] = max(f[j][k], f[j - 1][k - i] + a[i] + diff) print(max(f[i][n] for i in range(n + 1)))</pre><p><br/></p>
这道题暂未补解析。