首页 › 试卷 › GESP编程能力等级认证 › GESP-Python四级 › 2026年3月CCF-GESP编程能力等级认证Python编程四级真题

2026年3月CCF-GESP编程能力等级认证Python编程四级真题 VIP

GESP-Python四级 共 27 题 2026 年 含标准答案与解析
返回试卷列表
本页为整卷浏览:先自己做一遍,再展开「查看答案与解析」核对。

一、单选题

1. 单选题

2026年春节联欢晚会上一个武术表演节目《武BOT》。节目中多个人形机器人会表演空翻,它们落地可能会有微微踉跄,但都会迅速调整姿态站稳,并适当移动来和前后左右的其他机器人保持原来队列。如果将机器人视作一个计算机系统,那么在该计算机系统中下面哪一项不能作为输入设备( )。

  • A 用于检测重心的重力传感器
  • B 预装的AI算法程序
  • C 接收动作指令的遥控器
  • D 拍摄其他机器人的摄像头
查看答案与解析
答案:B
解析: 分析计算机系统中输入设备的定义:输入设备用于采集外部环境或用户的数据并传入系统。重力传感器采集机器人自身姿态数据,属于内部状态感知,可作为输入;遥控器接收外部指令,提供控制信号,属于输入;摄像头捕获周围机器人图像信息,用于位置调整,属于环境输入。AI算法程序是系统内部预设的处理逻辑,不采集数据,也不引入外部信息,其运行依赖输入但本身不具备输入功能,不满足输入设备机制。
2. 单选题

下面代码用来找出输入的N 个正整数中最大的一个。如果将代码段用流程图来表示,则L1 标记的代码行应该使用的图形是()。

Max = 0
N = int(input())

while(N):
    val = int(input())
    if val > Max: #L1
        Max = val
    N -= 1

print(Max)
  • A 圆形框
  • B 椭圆形框
  • C 平行四边形框
  • D 菱形框
查看答案与解析
答案:D
解析: 分析代码中L1所在位置的语句性质。L1位于条件判断内部,执行的是变量赋值操作。流程图中用于表示数据处理或赋值操作的图形具有特定形状。条件判断分支后的执行路径中的操作属于顺序执行的动作,不涉及输入输出、判定或流程起止。根据流程图标准符号定义,该位置应使用对应动作处理的图形符号。菱形框用于条件判断,椭圆形框用于开始结束,平行四边形框用于输入输出,圆形框不常用于标准流程图结构。
3. 单选题

执行以下Python 代码后,输出的结果是?()

matrix = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
total = 0
for row in matrix:
    for element in row:
        if element % 2 == 0:
            total += element
print(total)
  • A 4
  • B 10
  • C 20
  • D 25
查看答案与解析
答案:C
解析: 首先定义一个二维列表matrix,包含三个子列表,每个子列表包含三个整数。初始化变量total为0。通过外层循环遍历matrix中的每一个子列表row。内层循环遍历当前row中的每一个元素element。使用条件判断element是否为偶数,即element对2取余的结果等于0。若条件成立,则将element的值累加到total中。所有循环结束后,输出total的值。整个过程依次检查matrix中每个元素,仅将偶数相加至total。
4. 单选题

执行以下Python 代码,说法正确的是?()

tup = (1 , [2 , 3], 4) 
tup [1] = [5 , 6]
  • A 元组被成功修改为(1 , [5 , 6], 4)
  • B 代码可以执行,但元组内容未改变
  • C 抛出TypeError 异常
  • D 元组被修改为(1 , 2 , 3 , 4 , 5 , 6)
查看答案与解析
答案:C
解析: 元组在Python中是不可变序列,其元素绑定关系不可更改。创建后,每个索引位置对应的对象引用无法被重新赋值。尝试对元组的某个索引进行赋值操作时,会触发对该容器类型是否支持项赋值的检查。由于元组不支持__setitem__操作,此类语法会直接导致解释器抛出异常。但元组中的元素若为可变对象(如列表),该对象内部状态可以被修改,前提是未发生对元组本身的赋值操作。本题涉及的是直接对元组索引位置重新赋值,此行为不受元组内容可变性影响,仅取决于元组类型自身的可变性定义。
5. 单选题

执行以下Python代码后,输出的结果是?()

words = ["hello ", "world ", "python"]
result = [char for word in words for char in word if char in 'aeiou '] 
print(len(result))
  • A 3
  • B 4
  • C 5
  • D 6
查看答案与解析
答案:B
解析: 首先遍历words列表中的每个字符串元素。对每个字符串,再逐个遍历其字符。在内层遍历中,判断当前字符是否属于集合'aeiou '(即元音字母和空格)。若条件成立,则将该字符加入生成的列表result中。最终result包含所有满足条件的字符。len(result)计算该列表中元素的总数。
6. 单选题

函数定义def func(*args): pass 中的*args 会将传入的参数打包成什么类型?

  • A 列表
  • B 字典
  • C 元组
  • D 集合
查看答案与解析
答案:C
解析: 在函数定义中,*args用于接收任意数量的位置参数。当调用函数时,所有传入的位置参数会被自动收集并组织成一个不可变的序列结构,该结构按传入参数的顺序保存元素,且不包含重复的键名映射。此机制不涉及键值对的存储,也不允许后续通过索引以外的方式修改内容。传入参数的原始顺序在此结构中被保留,且每个参数均按位置对应到结构中的相应位置。
7. 单选题

在嵌套函数中,需要修改外层函数(非全局作用域)的变量,应使用哪个关键字?()

  • A global
  • B nonlocal
  • C local
  • D outer
查看答案与解析
答案:B
解析: 在嵌套函数中,当内层函数需要修改外层函数的变量时,必须通过关键字声明该变量的查找不遵循局部作用域。该机制允许解释器确定变量绑定的作用域层级。若未使用正确关键字,变量将被视为定义在当前局部作用域中。存在特定关键字用于指向非全局但外层函数中的变量名绑定,而非创建新的局部变量。另一个关键字专门用于声明全局作用域中的变量,其行为不适用于非全局的外层函数作用域。不存在名为local或outer的关键字用于实现此功能。
8. 单选题

执行以下Python 代码后,输出的结果是?()

def process_data(data):
    result = []
    for item in data:
        if item > 0:
            result.append(item * 2)
        elif item < 0:
            result.append(abs(item))
        else:
            result.append(0)
    return result

output = process_data([-2, 0, 3, -1])
print(sum(output))
  • A 12
  • B 6
  • C 88
  • D 9
查看答案与解析
答案:D
解析: 分析函数定义:函数process_data接收参数data,初始化空列表result。遍历data中的每个元素item,若item大于0,则将其两倍追加到result;若item小于0,则将其绝对值追加到result;否则(即item等于0),不做任何操作。遍历结束后返回result。调用时传入的data内容决定最终输出结果。执行过程严格依据输入序列中各元素的符号和数值进行条件判断与处理。
9. 单选题

关于lambda 匿名函数,以下描述正确的是?()

  • A lambda 匿名函数可以包含多个表达式,用分号分隔
  • B lambda 匿名函数必须有参数
  • C lambda 匿名函数可以接受多个参数,但只能有一个表达式
  • D lambda 匿名函数必须有return 语句
查看答案与解析
答案:C
解析: lambda匿名函数的语法结构限制其只能包含一个表达式,该表达式的结果自动作为返回值,无需return语句。表达式中不能包含复杂语句或多个操作,如赋值、循环、条件分支等。参数部分可为空或接受多个参数,通过逗号分隔。lambda函数体不允许使用分号分隔多个表达式,也不要求必须存在参数。return语句仅用于常规函数中显式返回值,在lambda中不可出现。
10. 单选题

文件text .txt 的内容如下:

Python is a programming language.
Python is easy to learn.

以下程序统计单词 "Python" 在文件中出现的次数。Python 后面是空格或行尾,且不跟标点。请补全代码。( )

count = 0
with open("text.txt", "r") as f:
	content = f.________ # 补全代码
	words = content.split()
	for word in words:
		if word == "Python":
			count += 1
print("Python出现次数:", count)
  • A readlines()
  • B read()
  • C readline()
  • D readlines
查看答案与解析
答案:B
这道题暂未补解析。
11. 单选题

执行以下Python 代码后,输出的结果是?()

try:
    print(1, end="")
    raise ValueError("x")
except ValueError as e:
    print(2, end="")
else:
    print(3, end="")
finally:
    print(4, end="")
  • A 14
  • B 124
  • C 1234
  • D 程序报错
查看答案与解析
答案:B
解析: 执行流程依次判断:try子句中先执行print(1, end=""),输出字符1;随后raise抛出ValueError异常,立即中断try内后续代码;抛出的异常被except ValueError捕获,进入该分支执行print(2, end=""),输出字符2;else子句仅在无异常时执行,因已发生异常,故跳过;finally子句无论是否发生异常均执行,因此执行print(4, end=""),输出字符4;最终输出内容由各print调用按执行顺序拼接而成。
12. 单选题

以下代码使用插入排序对列表进行升序排序。空白处应填入?()

def insertion_sort_optimized(arr):
    n = len(arr)
    for i in range(1, n):
        key = arr[i]  # 当前待插入元素
        j = i - 1
        while j >= 0 and arr[j] > key:
            arr[j + 1] = arr[j]  # 元素后移
            j -= 1
        arr[j + 1] = key  # 插入元素到正确位置
  • A arr [j + 1] = key
  • B arr [j - 1] = key
  • C key = arr [j]
  • D arr [i] = key
查看答案与解析
答案:A
解析: 从索引1开始遍历数组,将当前元素作为待插入的键值。通过逆向比较已排序部分的元素,若前一个元素大于键值,则将其后移一位。重复此过程直到找到键值应插入的位置,即第一个不大于键值的元素之后。最终将键值放入该位置,保持已排序段的正确顺序。整个过程利用原地移动实现排序。
13. 单选题

阅读以下Python 代码,下列说法正确的是?()

n = int(input())

def is_palindrome(s):
    return s == s[::-1]

max_palindrome = 0
for i in range(10 ** (n - 1), 10 ** n):
    for j in range(i, 10 ** n):
        product = i * j
        if is_palindrome(str(product)) and product > max_palindrome:
            max_palindrome = product
print(max_palindrome)


  • A 找出所有n 位数
  • B 找出由两个n 位数相乘得到的最大回文数
  • C 找出所有回文数
  • D 计算两个n 位数乘积的最大值
查看答案与解析
答案:B
解析: 读取输入整数n;定义函数判断字符串是否为回文;初始化最大回文数为0;遍历从10^(n-1)到10^n - 1的所有n位数i;内层遍历从i到10^n - 1的所有n位数j;计算i与j的乘积;将乘积转为字符串,检查是否为回文且大于当前最大回文数;若满足条件则更新最大回文数;循环结束后输出记录的最大回文数。
14. 单选题

以下代码实现了根据分数返回等级(A: 90-100, B: 80-89, C: 70-79, D: 60-69, F: 0-59)的功能,请选择正确的选项填入①②处。()

grade_map = {90: "A", 80: "B", 70: "C", 60: "D", 0: "F"}

def get_grade(score):
	if score < 0 or score > 100:
		return "无效分数"
	for key in sorted(grade_map.keys(), reverse=True):
		if score >= key:
			return _____①_____
score = int(input())
grade = get_grade(score)
print(f"分数 {score} 的等级是 {_____②_____}")
  • A ①grade_map[score] ②grade
  • B ①key ②get_grade(score)
  • C ①grade_map[key] ②score
  • D ①grade_map[key] ②grade
查看答案与解析
答案:D
解析: 分析函数get_grade的逻辑:首先判断score是否超过100,若是则返回'无效分数'。随后遍历按降序排列的grade_map键(即90,80,70,60,0),找到第一个不大于score的键,返回对应等级。循环中使用key访问grade_map,因此返回值应为grade_map[key]。主程序部分需调用get_grade函数获取等级并输出,变量grade存储返回结果,最终打印该变量。输入通过int(input())获取,赋给score变量。
15. 单选题

以下代码的时间复杂度是?()2026.3-4

def func(n):
	sum = 0
	for i in range(n):
		for j in range(i):
			sum += j
  • A O(1)
  • B O(n)
  • C O(n2)
  • D O(logn)
查看答案与解析
答案:C
这道题暂未补解析。

二、判断题

16. 判断题

在Python 语言中,一个集合可以作为另一个集合的元素。

  • A对
  • B错
查看答案与解析
答案:错
解析: 集合的元素需满足可哈希(hashable)条件。Python中集合本身是不可哈希的,因其是可变类型。不可哈希对象不能作为另一集合的元素。尝试将集合直接作为另一集合的元素会引发TypeError。若对象为不可变类型且支持哈希,才可成为集合元素。
17. 判断题

执行以下Python 代码后,输出的结果是。

my_set = {i : j for i , j in zip([1 , 2], [3 , 4])}
print(type(my_set))
  • A对
  • B错
查看答案与解析
答案:错
解析: 分析代码结构:{i : j for i , j in zip([1 , 2], [3 , 4])} 是字典推导式语法,使用冒号分隔键值对;zip([1, 2], [3, 4]) 生成两个元组 (1, 3) 和 (2, 4);遍历该zip对象时,i依次取1、2,j依次取3、4;每轮迭代将i作为键、j作为值构建键值对;最终生成的对象为字典类型;type()函数接收该对象并返回其类型。
18. 判断题

执行以下Python 代码后,输出的结果是20 10。

def func(a, b):
    a = a ^ b
    b = a ^ b
    a = a ^ b
    return a, b

a, b = func(10, 20)
print(a, b)
  • A对
  • B错
查看答案与解析
答案:对
解析: 分析函数func的执行过程:传入参数a和b,通过三次异或运算交换两个变量的值。异或运算满足交换律和结合律,且相同数值异或结果为0,任何数与0异或保持不变。第一次将a更新为a^b,第二次将b更新为(a^b)^b即原a的值,第三次将a更新为(a^b)^原a即原b的值。函数返回更新后的a和b。接收返回值时,将函数结果赋值给外部变量a和b。最后执行print语句输出两个变量。
19. 判断题

执行以下Python 代码后,输出的结果是[6 , 7]。

print(list(filter(lambda x: x > 5 , [3 , 6 , 7 , 2])))
  • A对
  • B错
查看答案与解析
答案:对
解析: 分析filter函数的行为:该函数接收一个lambda表达式和一个列表作为参数。lambda表达式定义了一个条件,对输入值x返回x > 5的布尔结果。filter根据此条件逐个测试列表中的元素,仅保留使条件为True的元素。随后,list()将filter对象转换为列表。整个过程依次检查[3, 6, 7, 2]中每个元素是否大于5,并按原顺序收集满足条件的元素。
20. 判断题

执行以下Python代码后,输出的结果是'789\n456 '。

with open('test.txt', 'w') as f:
    f.write('123\n456')

with open('test.txt', 'r+') as f:
    f.seek(0, 2)
    f.write('789')
    f.seek(0)
    print(repr(f.read()))
  • A对
  • B错
查看答案与解析
答案:错
解析: 首先以写模式打开文件并写入'123\n456',该内容被保存至文件中。随后以读写模式打开同一文件,文件指针初始位于文件末尾,通过seek(0, 2)确认定位在末尾位置。在此位置调用write('789')将新内容追加到原内容之后,文件此时包含'123\n456789'。接着调用seek(0)将文件指针移动至文件起始处。最后执行read()操作,从头开始读取整个文件内容,直至末尾。repr()函数作用于读取的字符串,将其表示为可打印的字符串形式,保留内部转义字符。
21. 判断题

下面这段程序的时间复杂度为平方阶O(n)。

def func(n):
	for i in range(n):
		for j in range(n):
			if i % 2 == 0:
				break
  • A对
  • B错
查看答案与解析
答案:错
这道题暂未补解析。
22. 判断题

执行以下Python 代码后,会抛出异常ZeroDivisionError 。

data = {'a': 1}
index = int(input())
print(data['b'] / index)
  • A对
  • B错
查看答案与解析
答案:错
解析: 分析代码执行流程:首先从标准输入读取字符串并转换为整数,该操作可能引发ValueError;字典data中不存在键'b',访问data['b']将引发KeyError;若index为0,则除法运算会触发ZeroDivisionError;异常是否抛出取决于输入值及字典内容的匹配情况;每一步操作的异常类型由具体运行时状态决定。
23. 判断题

在对列表进行排序时,sorted()函数会返回一个新的排序后的列表,不修改原列表,而sort()方法会直接修改原列表,返回值为None 。

  • A对
  • B错
查看答案与解析
答案:对
解析: sorted()函数接收可迭代对象作为输入,生成新的列表实例存储排序结果,原列表对象内存地址不变。sort()方法作用于列表对象自身,通过就地修改方式调整元素顺序,不创建新列表,其返回值为None。两者在操作对象状态和返回值设计上遵循不同协议:前者符合纯函数特征,后者体现可变对象的方法行为。
24. 判断题

阅读以下递推算法的Python 代码,执行后的输出结果是13 。

a, b = 1, 2
for i in range(3):
    a, b = b, a + b
print(b)
  • A对
  • B错
查看答案与解析
答案:错
解析: 初始化a为1,b为2。进入循环,循环执行3次,每次更新a和b的值:新a等于原b,新b等于原a加原b。每次迭代使用前一次的a和b计算新的b。循环结束后输出b的值。变量赋值在同一行时,右侧表达式基于当前轮次的旧值计算,赋值同时生效。
25. 判断题

小明的妈妈最近刚刚给他买了一块电话手表,除了可以看时间,小明也可以用它和妈妈打电话、收发信息,那么可以推测这块手表中装有一款特定操作系统。()2026.3-4

  • A对
  • B错
查看答案与解析
答案:对
解析: 分析设备功能与操作系统的关系。电话手表具备通话、收发信息功能,说明其具备通信模块和应用交互能力。实现多任务处理、硬件驱动管理及用户界面操作需要系统级软件支持。具备此类功能的设备依赖特定操作系统调度硬件资源、运行应用程序并提供服务接口。功能的存在反映底层系统具备相应设计目标与架构特征。

三、简答题

26. 简答题

山之谷

时间限制:1.0 s

内存限制:512.0 MB

题目描述

现有一片山地,可以视为一个N行M列的网格图,第i行j列的海拔为hi,j。

如果一个单元格的海拔不高于其所有相邻单元格(相邻包括上、下、左、右、左上、右上、左下、右下,最多8个方向)的海拔,则称该单元格为山谷。

请你数一数该片山地中有多少山谷。

输入格式

第一行包含2个整数N,M,表示山地的大小。

之后N行,每行包含M个整数hi,1,hi,2,...,hi,M,表示海拔。

输出格式

输出 1 行,包含 1 个整数C,表示山谷的数量。

输入样例

3 5
7 6 6 7 9
6 5 6 7 6
6 5 7 8 9

输出样例

3

样例解释

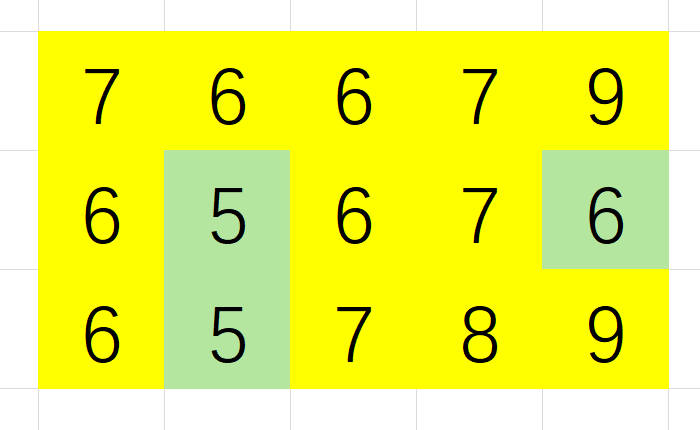
样例 1 如图所示,绿色单元格代表山谷:

数据范围

保证1≤N,M≤100,1≤hi,j≤105。

查看答案与解析
答案:<pre class="brush:python;toolbar:false;"># 输入行列数 n, m = map(int, input().split()) # 输入每一行的海拔 h = [] for i in range(n): row = list(map(int, input().split())) h.append(row) ans = 0 # 先遍历行 for i in range(n): # 再遍历列 for j in range(m): ok = True # 遍历周边8个格子 for k in range(-1, 2): for l in range(-1, 2): # 边界判定,不能超列表边界 if 0 &lt;= i + k &lt; n and 0 &lt;= j + l &lt; m and h[i + k][j + l] &lt; h[i][j]: ok = False if(ok): ans += 1 print(ans)</pre>
这道题暂未补解析。
27. 简答题

礼盒排序

时间限制:1.0 s

内存限制:512.0 MB

题目描述

商店推出了许多礼盒,每个礼盒中包含k件商品,每件商品都有一个价格。

现在需要对这些礼盒进行排序,排序规则如下:

1. 先按礼盒总价格从小到大排序;

2. 如果总价格相同,按礼盒中最贵商品的价格从小到大排序;

3. 如果仍然相同,按礼盒中最便宜商品的价格从小到大排序;

4. 如果仍然相同,按礼盒编号从小到大排序。

请输出排序后的礼盒编号。

输入格式

第一行包含两个整数n和k,分别表示礼盒数量和每个礼盒中商品的数量。

接下来n行,每行包含k个整数,第i行表示第i个礼盒中各商品的价格。

输出格式

输出一行,包含排序后的礼盒编号(编号从1开始),用空格分隔。

输入样例

4 3
3 5 2
4 1 5
2 2 4
3 4 3

输出样例

3 4 2 1

样例解释

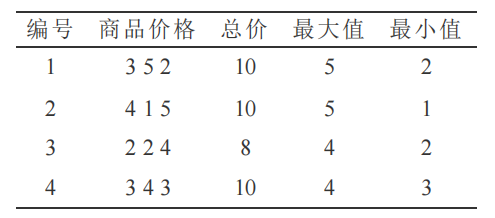
4 个礼盒分别为:

排序过程:

1. 按总价排序,3号礼盒总价最小;

2. 其余总价均为 10,再按最大值排序,4号最大值更小;

3. 1号和2号最大值相同,再按最小值排序,2号更小。

最终顺序为:3 4 2 1

 数据范围

保证1≤n≤103,1≤k≤10,商品价格≤104。

查看答案与解析
答案:<pre class="brush:python;toolbar:false;">n, k = map(int, input().split()) v = [] for i in range(n): nums = list(map(int, input().split())) s = sum(nums) mx = max(nums) mn = min(nums) v.append((s, mx, mn, i + 1)) v.sort() for i in range(n): print(v[i][3], end="" if i == n - 1 else " ") print()</pre>
这道题暂未补解析。