首页 › 试卷 › GESP编程能力等级认证 › GESP-Python六级 › 2026年3月CCF-GESP编程能力等级认证Python编程六级真题

2026年3月CCF-GESP编程能力等级认证Python编程六级真题 VIP

GESP-Python六级 共 27 题 2026 年 含标准答案与解析
返回试卷列表
本页为整卷浏览:先自己做一遍,再展开「查看答案与解析」核对。

一、单选题

1. 单选题

以下关于Python 类继承的代码,执行后输出结果是?()

class Animal:
    def __init__(self, name):
        self.name = name

    def speak(self):
        return "动物叫声"

class Dog(Animal):
    def speak(self):
        return f"{self.name}: 汪汪汪"

class Cat(Animal):
    def __init__(self, name, color):
        super().__init__(name)  # 调用父类构造方法
        self.color = color

    def speak(self):
        return f"{self.name} ({self.color}): 喵喵喵"

dog = Dog("旺财")
cat = Cat("咪宝", "橘色")
print(dog.speak(), cat.speak())


  • A 动物叫声动物叫声
  • B 旺财:汪汪汪咪宝:喵喵喵
  • C 旺财:汪汪汪咪宝(橘色):喵喵喵
  • D 动物叫声咪宝(橘色):喵喵喵
查看答案与解析
答案:C
解析: 分析类继承结构:Animal为基类,定义__init__初始化name属性和speak方法。Dog继承Animal,重写speak方法,使用父类的name属性生成字符串。Cat继承Animal,重写__init__方法,通过super()调用父类构造函数初始化name,并新增color属性,同时重写speak方法,结合name和color生成字符串。实例化Dog时传入名称,触发父类__init__赋值name。实例化Cat时传入名称和颜色,先调用父类__init__设置name,再设置color。调用speak方法时,根据实际对象类型动态绑定对应类的speak实现。
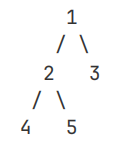
2. 单选题

下列代码中,s1 .draw() 和s2 .draw() 能正确运行并输出不同结果的主要原因是()。

class Shape:
    def draw(self):
        print("绘制图形")

class Circle(Shape):
    def draw(self):
        print("绘制圆形")

class Rectangle(Shape):
    def draw(self):
        print("绘制矩形")

if __name__ == "__main__":
    s1 = Circle()
    s2 = Rectangle()

    s1.draw()
    s2.draw()


  • A draw() 是普通成员函数
  • B Shape 中的draw() 被声明为虚函数
  • C Circle 和Rectangle 中使用了公有继承
  • D 对象变量名不同
查看答案与解析
答案:C
解析: 分析类之间的继承关系,确认父类Shape中定义了draw方法,子类Circle和Rectangle各自重写了该方法。通过实例化不同子类得到s1和s2对象,调用draw方法时,实际执行的是各自子类中重写后的版本。此行为基于动态分派机制,根据对象的实际类型确定调用哪个类的实现。检查继承方式是否支持方法重写,确认调用语句访问的是同名但不同实现的方法。
3. 单选题

下面的代码在主程序if name == " main ": 中有没有一行会导致运行错误,如果有请找出错误行()

class Pet:
    def __init__(self, n, a):
        self._name = n
        self._age = a
    def get_name(self):
        return self._name
    def birthday(self):
        self._age += 1

if __name__ == "__main__":
    cat = Pet("奶茶", 2)
    print(cat.get_name())       # ①
    cat.birthday()              # ②
    cat._name = "大橘"          # ③
    print(cat.get_name())       # ④


  • A 第①行
  • B 第②行
  • C 第③行
  • D 无错误行
查看答案与解析
答案:D
解析: 分析代码结构,确认类Pet的定义是否完整,包括__init__方法是否正确初始化实例属性。检查get_name和birthday方法的逻辑是否合法。逐行审查主程序中的语句:①调用get_name方法,验证该方法是否存在且可访问;②调用birthday方法,验证其是否能正确修改_age属性;③直接访问并赋值_name属性,判断该属性是否在语法上允许被外部修改;④再次调用get_name方法,验证属性变更后是否仍可正常读取。确认Python中无访问控制关键字,下划线前缀仅表示约定的私有性,不影响实际访问。判断每一行语句在语法和运行时是否引发异常。
4. 单选题

游乐园的过山车每次限坐4 人,用循环队列管理排队(容量MAX=5,空一格判满)。下面代码执行后,循环队列是否已满?rear 的值是多少?

MAX = 5
queue = [None] * MAX
front = 0
rear = 0

def enqueue(x):
    global rear, queue
    queue[rear] = x
    rear = (rear + 1) % MAX

def dequeue():
    global front
    front = (front + 1) % MAX

if __name__ == "__main__":
    enqueue(1)
    enqueue(2)
    enqueue(3)
    enqueue(4)

    dequeue()
    dequeue()

    enqueue(5)
    enqueue(6)

    print("队列数组: ", queue)
    print("front下标位置: ", front)
    print("rear下标位置: ", rear)


  • A 已满,rear = 1
  • B 未满,rear = 1
  • C 已满,rear = 2
  • D 未满,rear = 4
查看答案与解析
答案:A
解析: 初始化队列容量为5,front和rear起始均为0。每执行enqueue操作,元素存入rear位置,rear按模5递增;每执行dequeue操作,front按模5递增。依次执行:入队1、2、3、4,rear移至4;两次出队,front移至2;再入队5,rear变为(4+1)%5=0;入队6,rear变为(0+1)%5=1。队列中当前元素数量由(front, rear)相对位置决定,判断是否满的条件是(rear + 1) % MAX == front。最终rear值为1,此时需根据front与rear关系判断队列状态。
5. 单选题

在以下计算机系统应用场景中,最适合使用循环队列的是()。

  • A 函数调用过程中,保存局部变量和返回地址
  • B 表达式求值中的运算符优先级处理
  • C 操作系统中的进程优先级调度(高优先级先执行)
  • D 生产者和消费者问题中的共享缓冲区
查看答案与解析
答案:D
解析: 分析各场景的数据访问模式与存储需求。函数调用依赖后进先出的执行上下文保存,需使用栈结构管理调用帧。表达式求值中运算符的处理顺序由优先级和结合性决定,需借助栈实现延迟操作。进程调度按优先级选取下一个执行进程,高优先级任务需优先获取处理权,适合采用优先队列而非循环结构。生产者和消费者问题涉及固定大小缓冲区的并发访问,数据按到达顺序存取,前端入队、后端出队,且要求空间复用,循环队列通过模运算实现首尾相连的存储利用,满足连续存取与边界回绕的需求。
6. 单选题

在二叉搜索树(BST)中,若中序遍历的序列为{1, 2, 3, 4, 5},且先序遍历的第一个序列元素为3,则下列说法正确的是()。

  • A 该树一定是一棵完全二叉树。
  • B 元素4和5不可能是兄弟节点。
  • C 元素1所在节点的深度可能大于3(根节点深度为1)。
  • D 元素2一定是元素1的父节点。
查看答案与解析
答案:B
解析: 中序遍历序列{1, 2, 3, 4, 5}表明二叉搜索树的节点按升序排列,根节点为3时,左子树包含{1, 2},右子树包含{4, 5}。先序遍历首元素为3,确认根节点是3。左子树中,2可为1的父节点或1为2的左子节点;右子树中,4与5可构成不同父子关系。完全二叉树要求除最后一层外满填充,但当前结构无法确定层级填充情况。节点深度由路径长度决定,1的深度取决于其在左子树中的位置。兄弟关系取决于共同父节点,4和5可能同属一个父节点也可能不是。各节点具体位置存在多种合法构造方式,需依据BST性质和遍历顺序推导可能结构。
7. 单选题

某二叉树共有10个结点,记为A~J,已知它的先序遍历序列为:<strong>AB D H I E C F J G</strong>,中序遍历序列为:<strong>H DI B E A FJ C G</strong>,则该二叉树的后序遍历序列是()。

  • A H I D E B J F G C A
  • B H I D B E J F G C A
  • C I H D E B J F G C A
  • D H I D E B F J G C A
查看答案与解析
答案:A
解析: 根据先序遍历序列确定根节点,结合中序遍历序列划分左右子树。先序序列首元素为当前子树根节点,在中序序列中找到该根节点位置,其左侧为左子树结点,右侧为右子树结点。递归应用此过程,重建各子树结构。每层递归均按先序定位根、中序分左右的方式推进,直至所有结点位置确定。后序遍历顺序为左子树、右子树、根节点,依据重建的树结构进行访问即可得到后序序列。
8. 单选题

下列关于树的遍历的说法中,正确的一项是()。

  • A 对任意一棵树进行深度优先遍历,所得序列一定唯一。
  • B 已知一棵二叉树的先序遍历和后序遍历序列,可以唯一确定这棵二叉树。
  • C 若一棵二叉树的先序遍历序列与中序遍历序列相同,则该二叉树一定为只有右子树的链式结构。
  • D 已知一棵二叉树的先序遍历序列,即可唯一地确定该二叉树的结构。
查看答案与解析
答案:C
解析: 深度优先遍历的序列唯一性取决于访问子节点的顺序是否固定,若无明确次序则结果不唯一。仅凭先序和后序遍历无法唯一确定二叉树结构,因缺乏中序提供的根节点分割信息。先序与中序序列相同时,表明每个节点均无左子树,遍历过程中始终优先访问右子树。仅知先序遍历时,无法区分各节点在树中的具体位置,缺失分支结构信息,不能重建唯一二叉树。
9. 单选题

有6 个字符,它们出现的次数分别为:{2 , 3 , 3 , 4 , 6 , 8 },现在用哈夫曼编码为这些字符编码,最小加权路径长度WPL(每个字符的出现次数X它的编码长度,再把每个字符结果加起来)的值为()。

  • A 58
  • B 60
  • C 62
  • D 64
查看答案与解析
答案:D
解析: 将给定的6个字符出现次数作为叶节点权重,构建哈夫曼树。每次选择当前权值最小的两个节点合并为新节点,新节点的权值为两者之和,重复此过程直至只剩一个根节点。每个字符的编码长度等于其在哈夫曼树中的路径长度(从根到该叶节点的边数)。计算每个字符的权值与其路径长度的乘积,再求所有字符的乘积之和,即得最小加权路径长度WPL。
10. 单选题

对n个不同符号的符号进行哈夫曼编码。若生成的哈夫曼树共有115个结点,则n的值是()。

  • A 60
  • B 58
  • C 57
  • D 56
查看答案与解析
答案:B
解析: 哈夫曼树由n个叶子结点构成,每个非叶子结点由两个子结点合并生成。设非叶子结点数为k,则树中总共有n + k个结点。每次合并减少一个符号,从n个符号合并到1个根结点需进行n - 1次合并,故非叶子结点数为n - 1。因此,总结点数为n + (n - 1) = 2n - 1。给定总结点数为115,代入公式得2n - 1 = 115,解此方程可求n的值。
11. 单选题

关于格雷编码(Gray Code),下列说法正确的是()。

  • A 格雷编码中,编码位数越多,相邻编码之间变化的位数也越多
  • B 格雷编码中,相邻两个编码的二进制位恰好有一位不同
  • C 格雷编码就是把普通二进制编码按位取反后得到的结果
  • D 格雷编码不能用于数字电路和状态转换的设计中
查看答案与解析
答案:B
解析: 格雷编码是一种二进制编码方式,其特点是任意两个相邻编码之间仅有一位二进制位不同。该特性由编码的构造规则决定,与编码位数无关。生成格雷码可通过反射法或通过二进制码转换:将二进制码的每一位与其高位进行异或运算得到对应格雷码位。相邻编码间单一比特变化的性质使其在状态机设计中可减少误触发,适用于数字电路中的状态编码。按位取反操作不产生格雷码,也不改变其相邻性特征。编码位数增加不影响相邻编码间变化位数,始终保持一位差异。
12. 单选题

给定一棵二叉树,采用广度优先搜索(BFS) 算法,返回右视图所有节点的值。其中右视图定义为:二叉树的右视图是从树的右侧看过去时可见的节点集合,即右视图中的每个节点都是某一层中最右侧的节点。

class TreeNode:
    def __init__(self, x):
        self.val = x
        self.left = None
        self.right = None

def rightSideView(root):
    rightmost_value_at_depth = {}
    max_depth = -1

    node_queue = []
    depth_queue = []
    node_queue.append(root)
    depth_queue.append(0)

    while node_queue:
        node = node_queue.pop(0)
        depth = depth_queue.pop(0)

        if node is not None:
            max_depth = max(max_depth, depth)
            rightmost_value_at_depth[depth] = node.val

            node_queue.append(node.left)
            node_queue.append(node.right)

            # (1) 填空处
            depth_queue.append(depth + 1)
            depth_queue.append(depth + 1)

    right_view = []
    # (2) 填空处
    for depth in range(max_depth + 1):
        right_view.append(rightmost_value_at_depth[depth])

    return right_view

if __name__ == "__main__":
    root = TreeNode(1)
    root.left = TreeNode(2)
    root.right = TreeNode(3)
    root.left.right = TreeNode(5)
    root.right.right = TreeNode(4)

    print(rightSideView(root))


  • A (1)depth , depth ;(2)0 , max_depth
  • B (1)depth + 1 , depth + 1 ;(2)0 , max_depth + 1
  • C (1)depth + 1 , depth + 1 ;(2)1 , max_depth + 1
  • D (1)depth , depth ;(2)1 , max_depth
查看答案与解析
答案:B
解析: 使用BFS遍历二叉树,按层处理节点。每层维护一个映射记录该层最后访问的节点值,因队列中同一层节点按从左到右入队,同层后续节点会覆盖前序节点值,最终保留最右侧节点。节点入队时将其左右子节点依次加入队列,对应深度加1。初始化根节点深度为0,故遍历所有层需从0开始到max_depth(含)。遍历完成后,按深度从小到大收集每层最右节点值形成右视图结果序列。
13. 单选题

下列关于树的深度优先搜索(DFS)的说法中,正确的是()。

  • A 对树进行DFS 时,一定是按层从上到下依次访问结点
  • B 对任意一棵树进行DFS,得到的遍历序列唯一
  • C 对一棵树进行DFS 时,常借助递归或栈实现
  • D DFS 只能用于二叉树,不能用于普通树
查看答案与解析
答案:C
解析: 深度优先搜索通过访问起始节点后递归探索每个子树,直到无法深入为止。该过程可利用函数调用栈通过递归实现,也可显式使用栈结构模拟访问顺序。遍历过程中访问节点的次序取决于访问子节点的顺序,不同顺序会导致不同的遍历路径。树的结构不限于二叉树,DFS适用于任何树形结构。层序访问是广度优先搜索的特征,而非深度优先搜索。遍历序列是否唯一由树的结构和子节点访问顺序共同决定。
14. 单选题

小朋友们去邻里拜年,每个家里有不同数量的糖果。规则是:不能连续进入两个相邻的房子(即不能同时取相邻两家的糖果)。目标是拿到最多糖果。以下是代码实现,请补全横线。

def visit(nums):
    if not nums:
        return 0

    size = len(nums)
    if size == 1:
        return nums[0]

    dp = [0] * size
    dp[0] = nums[0]
    dp[1] = max(nums[0], nums[1])

    for i in range(2, size):
        dp[i] = max(dp[i-1], dp[i-2] + nums[i])  # 填空处

    return dp[size - 1]

if __name__ == "__main__":
    nums1 = [1, 2, 3, 1]
    print(visit(nums1))

    nums2 = [2, 7, 9, 3, 1]
    print(visit(nums2))

    nums3 = [5]
    print(visit(nums3))

    nums4 = []
    print(visit(nums4))


  • A dp [i] = dp [i - 1] + nums [i]
  • B dp [i] = max (dp [i - 1], dp [i - 2] * nums [i])
  • C dp [i] = max (dp [i - 1], dp [i - 2] + nums [i])
  • D dp [i] = dp [i - 2] + nums [i]
查看答案与解析
答案:C
解析: 定义状态 dp[i] 表示前 i+1 间房子可获得的最大糖果数。初始化处理空数组和单个元素情况。dp[0] 为第一间房子的糖果数,dp[1] 为前两间中较大值。从第三间开始,每间房子有两种选择:不进入则继承 dp[i-1];进入则加上当前糖果数 nums[i] 并加上 dp[i-2]。状态转移需取两者最大值。遍历完成后,最后位置的 dp 值即为全局最优解。
15. 单选题

元宵节晚上,小朋友沿着一条发光石板路前进,每次可以向前走1 块或2 块石板。若dp[i] = dp[i - 1]+ dp[i - 2],下面关于dp[i] 的含义最合适的是()。

  • A 走到第i 块石板的不同走法数量
  • B 走到第i 块石板时,已经走过的石板总数
  • C 从第i 块石板走回起点的最少步数
  • D 从第i 块石板走回起点的最大步数
查看答案与解析
答案:A
解析: 分析递推关系 dp[i] = dp[i-1] + dp[i-2] 的构成机制。当前状态的值由前两个状态的值相加得到,表明每一步的结果依赖于前两步结果的累积。考虑行走过程中的选择:到达第 i 块石板的方式可以从第 i-1 块走1步,或从第 i-2 块走2步。因此,到达第 i 块的路径数等于到达前两块石板路径数之和。该递推形式与路径计数问题中的状态转移一致,反映的是不同决策路径的叠加方式。

二、判断题

16. 判断题

下面定义了一个表示二维坐标点的类Point,并提供了一个带参数的构造函数,但第②行Point b ; 会调用编译器自动生成的默认构造函数,将b .x 和b .y 被初始化为0.0,程序可以正常编译运行。

class Point:
    def __init__(self, px, py):
        self.x = px
        self.y = py

    def print(self):
        print(f"({self.x}, {self.y})")

if __name__ == "__main__":
    a = Point(3.0, 4.0)  # ①
    # ②
    b = Point(0, 0)
    a.print()


  • A对
  • B错
查看答案与解析
答案:错
解析: 分析类定义中构造函数的参数要求;检查实例化时传入的参数数量与构造函数签名是否匹配;确认是否存在显式定义的无参构造函数或默认参数;判断未提供参数时是否依赖编译器自动生成的默认构造函数;追踪每个对象创建时实际调用的构造函数形式。
17. 判断题

Python 中的继承支持单继承和多继承,但子类无法直接访问父类的私有成员。

  • A对
  • B错
查看答案与解析
答案:错
解析: 分析继承机制中子类对父类成员的访问规则,重点考察私有成员的命名约定及其在类外部和子类中的可见性。识别Python通过名称改写实现私有成员的机制,明确私有成员在子类中不可直接访问的语言特性。
18. 判断题

若所有字符出现频率相同,则哈夫曼编码一定会得到完全二叉树。

  • A对
  • B错
查看答案与解析
答案:错
解析: 分析字符频率分布对哈夫曼树结构的影响;考察哈夫曼算法在频率相同情况下的构建机制;观察每次合并过程中的节点选择逻辑;追踪左右子树生成顺序与队列中节点优先级的关系;检查最终二叉树的层深度一致性与分支完整性;确认是否存在某层节点未完全填充的情况。
19. 判断题

哈夫曼编码是一种变长的前缀编码,在解码时不需要额外的分隔符就能唯一还原,这是因为在哈夫曼树中,任何一个字符的叶子结点都不会成为另一个字符结点的祖先。

  • A对
  • B错
查看答案与解析
答案:对
解析: 哈夫曼编码基于字符出现频率构建二叉树,频率越低的字符位于更深的叶子节点。编码过程中,从根节点到每个叶子节点的路径对应一个字符的二进制编码,向左分支记为0,向右分支记为1。由于所有字符均存储于叶子节点,内部节点不表示字符,因此任意字符的编码路径不会是另一字符编码路径的前缀。这种结构确保了编码序列在解析时可唯一分解,无需分隔符即可逐位还原原始字符序列。解码时从根节点开始,依比特流逐位移动,到达叶子节点后输出对应字符并返回根节点继续后续解码。
20. 判断题

在Python 中使用列表存储按层序遍历的完全二叉树时,若根节点存储在tree[0],则对于任意非空节点 tree[i],其右孩子(如果存在)必然位于tree[2 * i + 2]。

  • A对
  • B错
查看答案与解析
答案:对
解析: 在完全二叉树的层序遍历中,若根节点位于索引0,则任意非空节点i的左孩子位于2*i+1,右孩子位于2*i+2。该存储规则由数组下标与二叉树结构间的映射关系决定。当tree[i]存在右孩子时,其在数组中的位置必为2*i+2。此位置的有效性取决于2*i+2是否小于数组长度且对应节点非空。数组存储方式固定了父子节点间的数学关系,不因树的实际形态改变而改变。
21. 判断题

在Python 中使用列表模拟栈来非递归地实现二叉树的前序遍历,为了保证遍历顺序正确,在处理完当前结点后,应该先将该结点的左孩子压入栈中,然后再将右孩子压入栈中。()

  • A对
  • B错
查看答案与解析
答案:错
解析: 使用列表模拟栈进行二叉树前序遍历,需将根结点先压入栈。每次从栈顶弹出一个结点并访问,随后判断该结点是否存在右孩子和左孩子。若存在右孩子,则将其压入栈;若存在左孩子,则将其压入栈。由于栈具有后进先出特性,为确保左孩子在右孩子之前被处理,必须先压入右孩子,再压入左孩子。因此,在处理完当前结点后,应先将右孩子入栈,再将左孩子入栈,以保证遍历顺序符合前序要求。
22. 判断题

设二叉树共有n个结点,函数 preorderTraversal 的时间复杂度为O(n),空间复杂度为O(n)。

class TreeNode:
    def __init__(self, x):
        self.val = x
        self.left = None
        self.right = None

def preorder(root, res):
    if root is None:
        return
    res.append(root.val)
    preorder(root.left, res)
    preorder(root.right, res)

def preorderTraversal(root):
    res = []
    preorder(root, res)
    return res

if __name__ == "__main__":
    root = TreeNode(1)
    root.right = TreeNode(2)
    root.right.left = TreeNode(3)
    result = preorderTraversal(root)
    print("前序遍历结果: ", result)
  • A对
  • B错
查看答案与解析
答案:对
这道题暂未补解析。
23. 判断题

以下代码实现了0 -1背包问题的一维动态规划解法,内层循环采用经典的逆序遍历方式。若将内层循环改为正序遍历(即for j in range(w[i], W + 1):),仍能得到正确答案。

def knapsack_01():
    W = 5
    w = [2, 3, 4]
    v = [10, 1, 1]
    n = 3
    dp = [0] * (W + 1)

    for i in range(n):
        for j in range(W, w[i] - 1, -1):
            dp[j] = max(dp[j], dp[j - w[i]] + v[i])

    print(dp[W])

knapsack_01()


  • A对
  • B错
查看答案与解析
答案:错
解析: 分析二维状态转移方程在压缩为一维时的状态更新顺序。逆序遍历确保每次更新依赖的是上一轮的状态值,避免同一物品被重复选择。正序遍历会使用本轮已更新的状态值,导致状态依赖发生改变。当物品重量与价值关系满足特定条件时,正序可能恰好得到相同结果。需验证每轮状态更新过程中对dp[j]的访问是否覆盖了所有必要情况。比较两种遍历方式下每个j位置的来源状态是否等价。检查物品不可拆分的前提下,容量递增或递减更新对状态覆盖的影响。
24. 判断题

在动态规划问题中,状态空间相同且没有重复计算的情况下,“状态转移方程+递推”与“递归+记忆化搜索”的时间复杂度通常相同。

  • A对
  • B错
查看答案与解析
答案:对
解析: 比较两种实现方式的时间复杂度需分析其基本机制。状态转移方程配合递推按确定顺序遍历状态空间,每个状态仅计算一次。递归结合记忆化搜索在访问某状态时若未计算则求值并存储,后续直接查表。两者均保证每个状态被处理且仅被处理一次。时间消耗主要来自状态数量及单个状态的转移开销。只要状态空间一致且无冗余计算,执行的操作总量由状态数和转移关系决定,与实现形式无关。算法结构差异不影响总操作次数的理论下限。
25. 判断题

对如下结构的树,执行travel 函数,输出结果是1 2 3 4 5。

class Node:
    def __init__(self, v):
        self.val = v
        self.left = None
        self.right = None

def travel(root):
    if not root:
        return
    stack = []
    stack.append(root)
    while stack:
        cur = stack.pop()
        print(cur.val, end=" ")
        if cur.right:
            stack.append(cur.right)
        if cur.left:
            stack.append(cur.left)

if __name__ == "__main__":
    root = Node(1)
    root.left = Node(2)
    root.right = Node(3)
    root.left.left = Node(4)
    root.left.right = Node(5)
    travel(root)
  • A对
  • B错
查看答案与解析
答案:错
这道题暂未补解析。

三、简答题

26. 简答题

选数


查看答案与解析
答案:<pre class="brush:python;toolbar:false;"># 接受输入 # n n = int(input()) # 接受a和b的输入 a = [0] + list(map(int, input().split())) b = [0] + list(map(int, input().split())) # 准备动态规划的数组f # f[i]的含义如题解所述 f = [0] * (n + 5) # ans表示目前找到的最大的答案 ans = 0 for i in range(1, n + 1):     # 比较一下,如果将i加入到下标序列中,那么可能得到的最大序列和为f[i]+a[i],比较这个值和最大的已发现的答案     ans = max(ans, f[i] + a[i])     # f[i+b[i]]表示最后一个被选中的下标&lt;=i的情况下能够找到的最大序列和。如果加入a[i]能够让这个值更大,则更新     if i + b[i] &lt;= n:         f[i + b[i]] = max(f[i + b[i]], f[i] + a[i])     # 因为f[i]表示的是i及i以后的下标都能被选中情况下的最大序列和,所以利用f[i]来更新f[i+1]     f[i + 1] = max(f[i + 1], f[i]) print(ans)</pre>
这道题暂未补解析。
27. 简答题

完全二叉树

查看答案与解析
答案:<pre class="brush:python;toolbar:false;">n = int(input()) # l[i]:i的左孩子;r[i]:i的右孩子,0为空 l = [0] * (n + 1) r = [0] * (n + 1) # mn[u]:u子树中,叶子节点的最小深度 mn = [0] * (n + 1) # mx[u]:u子树中,叶子节点的最大深度 mx = [0] * (n + 1) # chk[u]:布尔标记,1代表以u为根的子树是完全二叉树,0不是 chk = [0] * (n + 1) ans = 0 for i in range(1, n + 1):     li, ri = map(int, input().split())     l[i] = li     r[i] = ri def dfs(u):     global ans     chk[u] = 1     if u == 0:         return     # 后序:先递归左右子树     dfs(l[u])     dfs(r[u])     # 条件1:左右子树本身都必须是完全二叉树     chk[u] &amp;= chk[l[u]] &amp; chk[r[u]]     # mn[u]:当前子树叶子最小深度     mn[u] = 1 + min(mn[l[u]], mn[r[u]])     # mx[u]:当前子树叶子最大深度     mx[u] = 1 + max(mx[l[u]], mx[r[u]])     # 条件2:左子树叶子最小深度 &gt;= 右子树叶子最大深度     chk[u] &amp;= mn[l[u]] &gt;= mx[r[u]]     # 条件3:整棵子树叶子最小深度 &gt;= 最大深度 - 1     chk[u] &amp;= mn[u] &gt;= mx[u] - 1     # 如果u是完全二叉树,答案+1     ans += chk[u] dfs(1) print(ans)</pre>
这道题暂未补解析。