首页 › 试卷 › 信息学奥赛 › 信息学奥赛-入门级 › 全国信息学奥林匹克联赛(NOIP2011)复赛 普及组

全国信息学奥林匹克联赛(NOIP2011)复赛 普及组 VIP

信息学奥赛-入门级 共 4 题 含标准答案与解析
返回试卷列表
本页为整卷浏览:先自己做一遍,再展开「查看答案与解析」核对。

一、简答题

1. 简答题

数字反转

【问题描述】

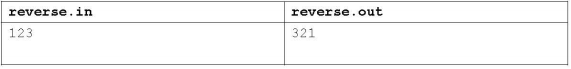
给定一个整数,请将该数各个位上数字反转得到一个新数。新数也应满足整数的常见形 式,即除非给定的原数为零,否则反转后得到的新数的最高位数字不应为零(参见样例2)。

【输入】

输入文件名为reverse.in。

输入共1行, 一个整数N。

【输出】

输出文件名为reverse.out。

输出共1行, 一个整数,表示反转后的新数。

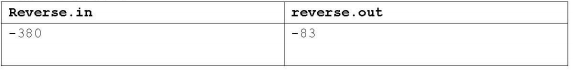
【输入输出样例1】

【输入输出样例2】

【数据范围】

-1,000,000,000≤  N≤1,000,000,000。

查看答案与解析
答案:<p>#include&lt;stdio.h&gt;</p><p>int main(){</p><p><span style="white-space:pre"> </span>int m,i;</p><p><span style="white-space:pre"> </span>scanf("%d",&amp;m);</p><p><span style="white-space:pre"> </span>if(m==0) printf("0");</p><p><span style="white-space:pre"> </span>if(m&lt;0) {</p><p><span style="white-space:pre"> </span>m=-m;</p><p><span style="white-space:pre"> </span>printf("-");</p><p><span style="white-space:pre"> </span>}</p><p><span style="white-space:pre"> </span>do{</p><p><span style="white-space:pre"> </span>  i=m%10;</p><p><span style="white-space:pre"> </span>  m=m/10;</p><p><span style="white-space:pre"> </span>  if(i!=0)printf("%d",i);</p><p><span style="white-space:pre"> </span>}while(i==0);</p><p><span style="white-space:pre"> </span>while(m!=0){</p><p><span style="white-space:pre"> </span>i=m%10;</p><p><span style="white-space:pre"> </span>    m=m/10;</p><p><span style="white-space:pre"> </span>printf("%d",i);</p><p><span style="white-space:pre"> </span>}</p><p><span style="white-space:pre"> </span>return 0;</p><p>}</p>
这道题暂未补解析。
2. 简答题

统计单词数

【问题描述】

一般的文本编辑器都有查找单词的功能,该功能可以快速定位特定单词在文章中的位 置,有的还能统计出特定单词在文章中出现的次数。

现在,请你编程实现这一功能,具体要求是:给定一个单词,请你输出它在给定的文章 中出现的次数和第一次出现的位置。 注意:匹配单词时,不区分大小写,但要求完全匹配, 即给定单词必须与文章中的某一独立单词在不区分大小写的情况下完全相同(参见样例1),  如果给定单词仅是文章中某一单词的一部分则不算匹配(参见样例2)。

【输入】

输入文件名为stat.in,2行。

第1行为一个字符串,其中只含字母,表示给定单词;

第2行为一个字符串,其中只可能包含字母和空格,表示给定的文章。

【输出】

输出文件名为stat .out。

只有一行,如果在文章中找到给定单词则输出两个整数,两个整数之间用一个空格隔开, 分别是单词在文章中出现的次数和第一次出现的位置(即在文章中第一次出现时,单词首字 母在文章中的位置,位置从0开始);如果单词在文章中没有出现,则直接输出一个整数- 1。

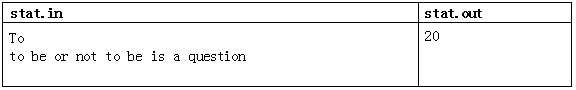
【输入输出样例1】

【输入输出样例1说明】

输出结果表示给定的单词To在文章中出现两次,第一 次出现的位置为0。

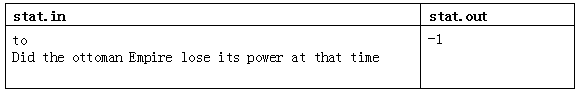
 【输入输出样例2】

【输入输出样例2说明】

表示给定的单词to在文章中没有出现,输出整数- 1。

【 数据范围】

1≤单词长度≤10。

1≤文章长度≤1,000,000。

查看答案与解析
答案:<p style="text-align: left;">#include&lt;cstdio&gt;</p><p style="text-align: left;">#include&lt;cstring&gt;</p><p style="text-align: left;">#include&lt;iostream&gt;</p><p style="text-align: left;">using namespace std;</p><p style="text-align: left;">int main()</p><p style="text-align: left;">{</p><p style="text-align: left;">    char w[11],s[1000001];      //w为输入的单词,s为输入的文章</p><p style="text-align: left;">    int j=0,x=0;    //j用来遍历单词,x是表示状态的变量</p><p style="text-align: left;">//x为-1时,表示目前检测道德单词不是要输入的单词</p><p style="text-align: left;">//x为0时,表示遇到文章中的空格,准备开始下一个单词的检测</p><p style="text-align: left;">//x为1时,就是找到啦!</p><p style="text-align: left;">    int oc,count=0,h=0;     //oc用来储存第一个找到的位置</p><p style="text-align: left;">//count记录出现的次数,h用来确保oc只存储第一次找到的位置</p><p style="text-align: left;">    gets(w);</p><p style="text-align: left;">    gets(s);    //最适合新手的输入方式</p><p style="text-align: left;">    int a1,a2;</p><p style="text-align: left;">    a1=strlen(w);</p><p style="text-align: left;">    a2=strlen(s);   //a1,a2分别是w,s的长度,strlen是系统自带函数</p><p style="text-align: left;">//注意,strlen函数很慢,务必事先把值存储到a1,a2中</p><p style="text-align: left;">//否则后几个测试点会出现TLE错误</p><p style="text-align: left;">    for(int i=0;i&lt;a1;i++)    //遍历单词和文章,将其统一转换为小写</p><p style="text-align: left;">        w[i]=tolower(w[i]);</p><p style="text-align: left;">    for(int i=0;i&lt;a2;i++)     //tolower是系统自带函数</p><p style="text-align: left;">        s[i]=tolower(s[i]);  //相应变成大写的函数是toupper</p><p style="text-align: left;">    for(int i=0;i&lt;a2;i++)   //遍历文章</p><p style="text-align: left;">    {</p><p style="text-align: left;">        j=0;   //确保每次检测单词从第一个字母开始</p><p style="text-align: left;">        if(w[j]==s[i]&amp;&amp;x==0)  //x=0表示为空格状态,开始新单词的检测</p><p style="text-align: left;">//若第一个字母相同则进入下述判断流程</p><p style="text-align: left;">        {</p><p style="text-align: left;">            for(;j&lt;a1;j++)   //遍历单词</p><p style="text-align: left;">            {</p><p style="text-align: left;">                if(w[j]!=s[i+j])  //如果出现不同,x赋值为-1,退出循环</p><p style="text-align: left;">                {   </p><p style="text-align: left;">                    x=-1;</p><p style="text-align: left;">                    break;</p><p style="text-align: left;">                }</p><p style="text-align: left;">                x=-1;   //如果一直一样,但后面还有单词,x赋值为-1</p><p style="text-align: left;">                if(s[i+j+1]==' '||i+j+1==a2) //如果下一个是空格或者文章结束,则找到啦!</p><p style="text-align: left;">                    x=1;</p><p style="text-align: left;">            }</p><p style="text-align: left;">            if(x==1)  //找到了后,要简单的储存一下</p><p style="text-align: left;">            {</p><p style="text-align: left;">                count++;</p><p style="text-align: left;">                if(h==0)</p><p style="text-align: left;">                    oc=i;</p><p style="text-align: left;">                h=1;</p><p style="text-align: left;">                i=i+a1-1;  //因为遍历的是单词,i没有变化,因此给i加上单词的长度</p><p style="text-align: left;">//注意,for循环有i++,因此要事先-1!</p><p style="text-align: left;">            }</p><p style="text-align: left;">        }</p><p style="text-align: left;">        else if(s[i]==' ') //空格情况</p><p style="text-align: left;">            x=0;</p><p style="text-align: left;">        else        //其他情况则为非相同的单词</p><p style="text-align: left;">            x=-1;</p><p style="text-align: left;">    }</p><p style="text-align: left;">    if(count!=0)    //如果找到了,按要求输出</p><p style="text-align: left;">        cout &lt;&lt; count &lt;&lt; " " &lt;&lt; oc;</p><p style="text-align: left;">    else         //没找到就输出-1</p><p style="text-align: left;">        cout &lt;&lt; "-1";</p><p style="text-align: left;">    return 0;</p><p style="text-align: left;">}</p>
这道题暂未补解析。
3. 简答题

瑞士轮

【背景】

在双人对决的竞技性比赛,如乒乓球、羽毛球、国际象棋中,最常见的赛制是淘汰赛和 循环赛。前者的特点是比赛场数少,每场都紧张刺激,但偶然性较高。后者的特点是较为公 平,偶然性较低,但比赛过程往往十分冗长。

本题中介绍的瑞士轮赛制,因最早使用于1895年在瑞士举办的国际象棋比赛而得名。 它可以看作是淘汰赛与循环赛的折衷,既保证了比赛的稳定性,又能使赛程不至于过长。

【问题描述】

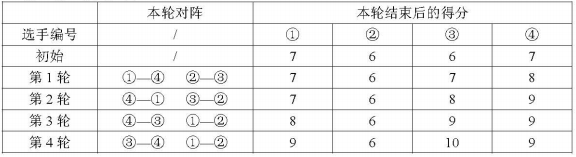
2*N名编号为1~2N的选手共进行R轮比赛。每轮比赛开始前,以及所有比赛结束后, 都会按照总分从高到低对选手进行一次排名。选手的总分为第一轮开始前的初始分数加上已 参加过的所有比赛的得分和。总分相同的,约定编号较小的选手排名靠前。

每轮比赛的对阵安排与该轮比赛开始前的排名有关:第1 名 和 第 2 名 、 第 3 名 和 第 4 名、 … … 、第2K - 1名和第2K名、 … …  、第2N - 1名和第2N名,各进行 一 场比赛。每 场比赛胜者得1分,负者得0分。也就是说除了首轮以外,其它轮比赛的安排均不能事先确 定,而是要取决于选手在之前比赛中的表现。

现给定每个选手的初始分数及其实力值,试计算在R轮比赛过后,排名第Q的选手编号是多少。我们假设选手的实力值两两不同,且每场比赛中实力值较高的总能获胜。

【输入】

输入文件名为swiss .in。

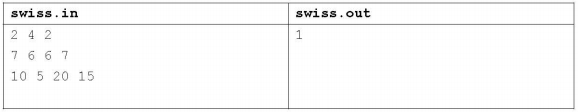
输入的第一行是三个正整数N、R、Q,每两个数之间用一个空格隔开,表示有2*N名 选手、R轮比赛,以及我们关心的名次Q。

第二行是2*N个非负整数s1,s2,…,S2N,每两个数之间用一个空格隔开,其中si表示编 号为i的选手的初始分数。

第三行是2*N个正整数w1,w2,…,w2N,每两个数之间用一个空格隔开,其中wi表示编 号为i的选手的实力值。

【输出】

输出文件名为swiss . out。

输出只有一行,包含一个整数,即R轮比赛结束后,排名第Q的选手的编号。

【输入输出样例】
【输入输出样例说明】
【数据范围】

对于30%的数据,1≤N≤100;

对于50%的数据,1≤N≤10,000;

对于100% 的数据,1≤N≤100,000,1≤R≤50,1≤Q≤2N,0≤S1,S2, … ,S2N≤10⁸,l≤wi, w2, …,w2N≤10⁸。


查看答案与解析
答案:<p style="text-align: left;">#include&lt;stdio.h&gt;</p><p style="text-align: left;">#include&lt;string.h&gt;</p><p style="text-align: left;">#include&lt;algorithm&gt; </p><p style="text-align: left;">using namespace std;</p><p style="text-align: left;">const int maxm = 2e5 + 10;</p><p style="text-align: left;">struct node</p><p style="text-align: left;">{</p><p style="text-align: left;"><span style="white-space:pre"> </span>int id;</p><p style="text-align: left;"><span style="white-space:pre"> </span>int score;</p><p style="text-align: left;"><span style="white-space:pre"> </span>int power;</p><p style="text-align: left;">}stu[maxm],w[maxm],l[maxm];</p><p style="text-align: left;">bool cmp(node a,node b)</p><p style="text-align: left;">{</p><p style="text-align: left;"><span style="white-space:pre"> </span>if (a.score==b.score)</p><p style="text-align: left;"><span style="white-space:pre"> </span>return a.id &lt; b.id;</p><p style="text-align: left;"><span style="white-space:pre"> </span>return a.score &gt; b.score;</p><p style="text-align: left;">}</p><p style="text-align: left;">bool cmp2(int s1,int s2,int id1,int id2)</p><p style="text-align: left;">{</p><p style="text-align: left;"><span style="white-space:pre"> </span>if (s1==s2)</p><p style="text-align: left;"><span style="white-space:pre"> </span>return id1 &lt; id2;</p><p style="text-align: left;"><span style="white-space:pre"> </span>return s1 &gt; s2;</p><p style="text-align: left;">}</p><p style="text-align: left;">void merge(int ll,int rr)</p><p style="text-align: left;">{</p><p style="text-align: left;"><span style="white-space:pre"> </span>int l1 = ll,l2 = ll,k = ll;</p><p style="text-align: left;"><span style="white-space:pre"> </span>while (l1&lt;=rr &amp;&amp; l2&lt;=rr)</p><p style="text-align: left;"><span style="white-space:pre"> </span>if (cmp2(w[l1].score,l[l2].score,w[l1].id,l[l2].id))</p><p style="text-align: left;"><span style="white-space:pre"> </span>stu[k++] = w[l1++];</p><p style="text-align: left;"><span style="white-space:pre"> </span>else stu[k++] = l[l2++];</p><p style="text-align: left;"><span style="white-space:pre"> </span>while (l1&lt;=rr) stu[k++] = w[l1++];</p><p style="text-align: left;"><span style="white-space:pre"> </span>while (l2&lt;=rr) stu[k++] = l[l2++];</p><p style="text-align: left;">}</p><p style="text-align: left;">int main()</p><p style="text-align: left;">{</p><p style="text-align: left;"><span style="white-space:pre"> </span>int n,r,q,i;</p><p style="text-align: left;"><span style="white-space:pre"> </span>scanf("%d %d %d",&amp;n,&amp;r,&amp;q);</p><p style="text-align: left;"><span style="white-space:pre"> </span>for (i=1;i&lt;=2*n;i++)</p><p style="text-align: left;"><span style="white-space:pre"> </span>{</p><p style="text-align: left;"><span style="white-space:pre"> </span>scanf("%d",&amp;stu[i].score);</p><p style="text-align: left;"><span style="white-space:pre"> </span>stu[i].id = i;</p><p style="text-align: left;"><span style="white-space:pre"> </span>}</p><p style="text-align: left;"><span style="white-space:pre"> </span>for (i=1;i&lt;=2*n;i++)</p><p style="text-align: left;"><span style="white-space:pre"> </span>scanf("%d",&amp;stu[i].power);</p><p style="text-align: left;"><span style="white-space:pre"> </span>sort(stu+1,stu+2*n+1,cmp);</p><p style="text-align: left;"><span style="white-space:pre"> </span>while (r--)</p><p style="text-align: left;"><span style="white-space:pre"> </span>{</p><p style="text-align: left;"><span style="white-space:pre"> </span>int lo = 0,wi = 0;</p><p style="text-align: left;"><span style="white-space:pre"> </span>for (i=1;i&lt;=2*n;i+=2)</p><p style="text-align: left;"><span style="white-space:pre"> </span>{</p><p style="text-align: left;"><span style="white-space:pre"> </span>if (stu[i].power&gt;stu[i+1].power)</p><p style="text-align: left;"><span style="white-space:pre"> </span>{</p><p style="text-align: left;"><span style="white-space:pre"> </span>w[++wi] = stu[i];</p><p style="text-align: left;"><span style="white-space:pre"> </span>l[++lo] = stu[i+1];</p><p style="text-align: left;"><span style="white-space:pre"> </span>w[wi].score++;</p><p><span style="white-space:pre"> </span></p><p style="text-align: left;"><span style="white-space:pre"> </span>}</p><p style="text-align: left;"><span style="white-space:pre"> </span>else</p><p style="text-align: left;"><span style="white-space:pre"> </span>{</p><p style="text-align: left;"><span style="white-space:pre"> </span>l[++lo] = stu[i];</p><p style="text-align: left;"><span style="white-space:pre"> </span>w[++wi] = stu[i+1];</p><p style="text-align: left;"><span style="white-space:pre"> </span>w[wi].score++;</p><p style="text-align: left;"><span style="white-space:pre"> </span>}</p><p style="text-align: left;"><span style="white-space:pre"> </span>}</p><p style="text-align: left;"><span style="white-space:pre"> </span>merge(1,n);</p><p style="text-align: left;"><span style="white-space:pre"> </span>}<span style="white-space:pre"> </span></p><p style="text-align: left;"><span style="white-space:pre"> </span>printf("%d\n",stu[q].id);</p><p style="text-align: left;"><span style="white-space:pre"> </span>return 0;</p><p style="text-align: left;">}</p>
这道题暂未补解析。
4. 简答题

表达式的值

【问题描述】

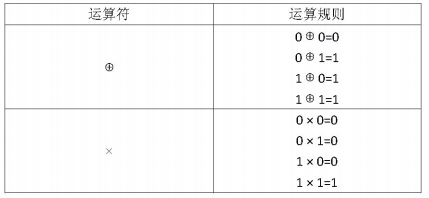
对于1位二进制变量定义两种运算:

运算的优先级是:

1. 先计算括号内的,再计算括号外的。

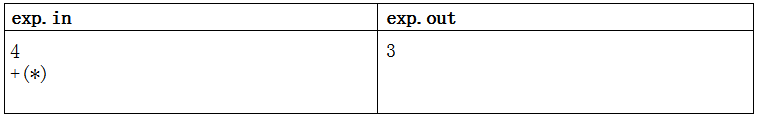
现给定一个未完成的表达式,例如 +( * ),请你在横线处填入数字0或者1,请问有多少种填法可以使得表达式的值为0。

【输入】

输入文件名为exp.in,共2行。

第1行为一个整数L,表示给定的表达式中除去横线外{的运算符和括号的个数。

第2行为一个字符串包含L个字符,其中只包含’(’、’)’、²+’、”*这4种字符,其中’ (’、’)’是左右括号,’+’、’*’分别表示前面定义的运算符“田”和“×”。这行字符按顺序  给出了给定表达式中除去变量外的运算符和括号。

【输出】

输出文件exp.out共1行。包含一个整数,即所有的方案数。 注意:这个数可能会很大, 请输出方案数对10007取模后的结果。

【输入输出样例1】

【输入输出样例说明】

给定的表达式包括横线字符之后为:   +( * )

在横线位置填入(0、0、0)、(0、1、0)、(0、0、1)时,表达式的值均为0,所以共有3 种填法。

【数据范围】

对于20%的数据有O≤L≤10。

对于50%的数据有O≤L≤1,000。

对于70%的数据有O≤L≤10,000。

对于100%的数据有O≤L≤100,000。

对于50%的数据输入表达式中不含括号。

查看答案与解析
答案:<p style="text-align: left;">#include &lt;bits/stdc++.h&gt;</p><p style="text-align: left;">using namespace std;</p><p style="text-align: left;">const int MOD=10007;</p><p style="text-align: left;">int f[2][100005];  //每一位是0的可能性和是1的可能性 </p><p style="text-align: left;">int main()</p><p style="text-align: left;">{</p><p style="text-align: left;">    int len;</p><p style="text-align: left;">    string c,pol=".";</p><p style="text-align: left;">    cin&gt;&gt;len&gt;&gt;c;</p><p style="text-align: left;">    stack&lt;char&gt; sta;</p><p style="text-align: left;">    for(int i=0;i&lt;len;i++)</p><p style="text-align: left;">    {</p><p style="text-align: left;">        if(c[i]=='(' || c[i]=='*')</p><p style="text-align: left;">            sta.push(c[i]);</p><p style="text-align: left;">        if(c[i]=='+')</p><p style="text-align: left;">        {</p><p style="text-align: left;">            while(!sta.empty() &amp;&amp; sta.top()=='*')</p><p style="text-align: left;">            {</p><p style="text-align: left;">                pol+=sta.top();</p><p style="text-align: left;">                sta.pop();</p><p style="text-align: left;">            }</p><p style="text-align: left;">            sta.push('+');</p><p style="text-align: left;">        }</p><p style="text-align: left;">        if(c[i]==')')</p><p style="text-align: left;">        {</p><p style="text-align: left;">            while(sta.top()!='(')</p><p style="text-align: left;">            {</p><p style="text-align: left;">                pol+=sta.top();</p><p style="text-align: left;">                sta.pop();</p><p style="text-align: left;">            }</p><p style="text-align: left;">            sta.pop();</p><p style="text-align: left;">        }</p><p style="text-align: left;">        if(c[i]!='(' &amp;&amp; c[i]!=')')</p><p style="text-align: left;">            pol+='.';</p><p style="text-align: left;">    }</p><p style="text-align: left;">    while(!sta.empty())</p><p style="text-align: left;">    {</p><p style="text-align: left;">        pol+=sta.top();</p><p style="text-align: left;">        sta.pop();</p><p style="text-align: left;">    }</p><p style="text-align: left;">    int j=0;</p><p style="text-align: left;">    for(int i=0;i&lt;(int)pol.length();i++)</p><p style="text-align: left;">    {</p><p style="text-align: left;">        if(pol[i]=='.')</p><p style="text-align: left;">        {</p><p style="text-align: left;">            j++;</p><p style="text-align: left;">            f[0][j]=1;</p><p style="text-align: left;">            f[1][j]=1;</p><p style="text-align: left;">        }</p><p style="text-align: left;">        if(pol[i]=='*')</p><p style="text-align: left;">        {</p><p style="text-align: left;">            j--;</p><p style="text-align: left;">            f[0][j]=(f[0][j+1]*f[1][j]+f[0][j]*f[1][j+1]+f[0][j]*f[0][j+1])%MOD;</p><p style="text-align: left;">            f[1][j]=(f[1][j]*f[1][j+1])%MOD;</p><p style="text-align: left;">        }</p><p style="text-align: left;">        if(pol[i]=='+')</p><p style="text-align: left;">        {</p><p style="text-align: left;">            j--;</p><p style="text-align: left;">            f[1][j]=(f[0][j]*f[1][j+1]+f[0][j+1]*f[1][j]+f[1][j]*f[1][j+1])%MOD;</p><p style="text-align: left;">            f[0][j]=(f[0][j]*f[0][j+1])%MOD;</p><p style="text-align: left;">        }</p><p style="text-align: left;">    }</p><p style="text-align: left;">    cout&lt;&lt;f[0][j]&lt;&lt;endl;  //f[0][1]</p><p style="text-align: left;">    return 0;</p><p style="text-align: left;">}</p>
这道题暂未补解析。