首页 › 试卷 › 信息学奥赛 › 信息学奥赛-提高级 › 2019年CCF非专业级别软件能力认证第二轮 (CSP-S)提高级C++语言试题

2019年CCF非专业级别软件能力认证第二轮 (CSP-S)提高级C++语言试题 VIP

信息学奥赛-提高级 共 6 题 2019 年 含标准答案与解析
返回试卷列表
本页为整卷浏览:先自己做一遍,再展开「查看答案与解析」核对。

一、简答题

1. 简答题

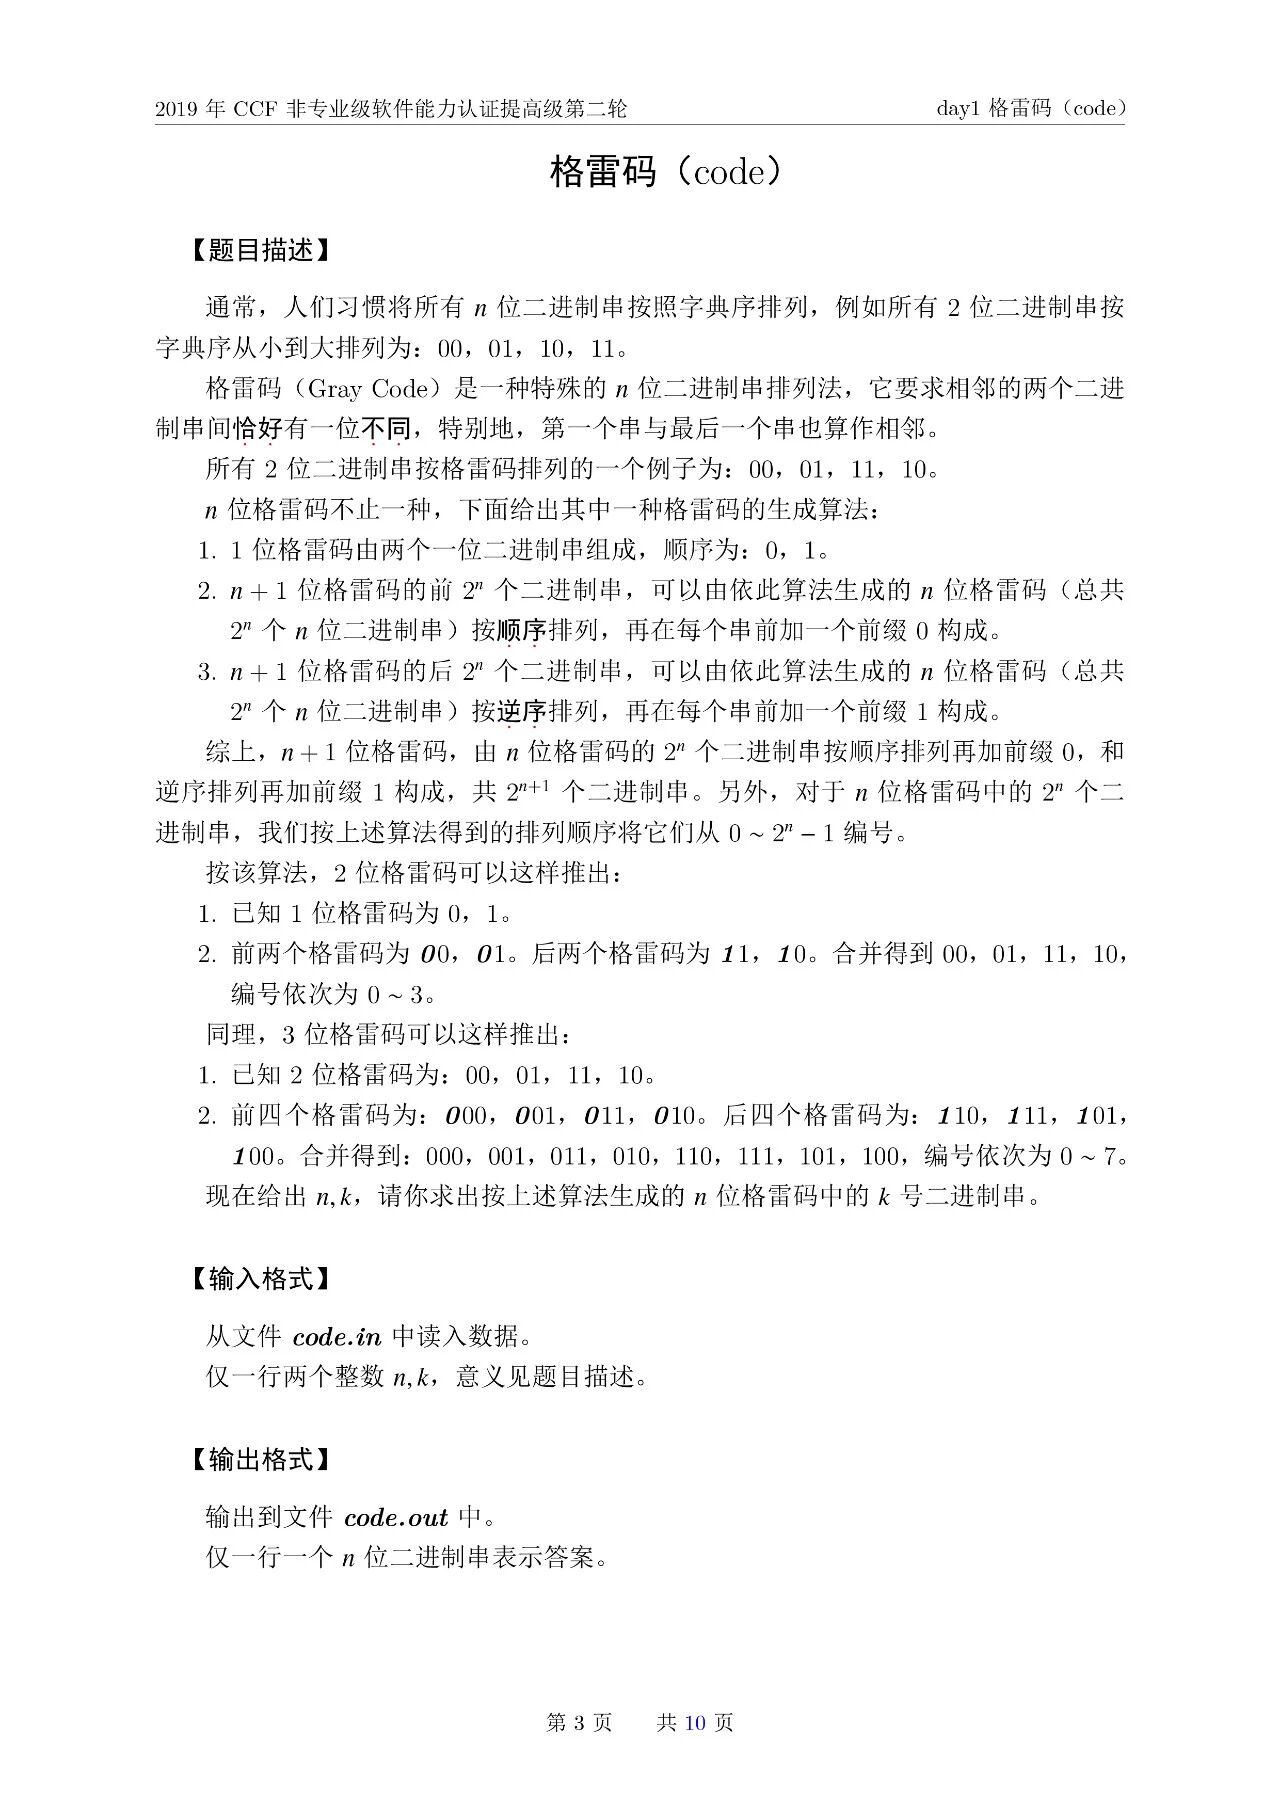
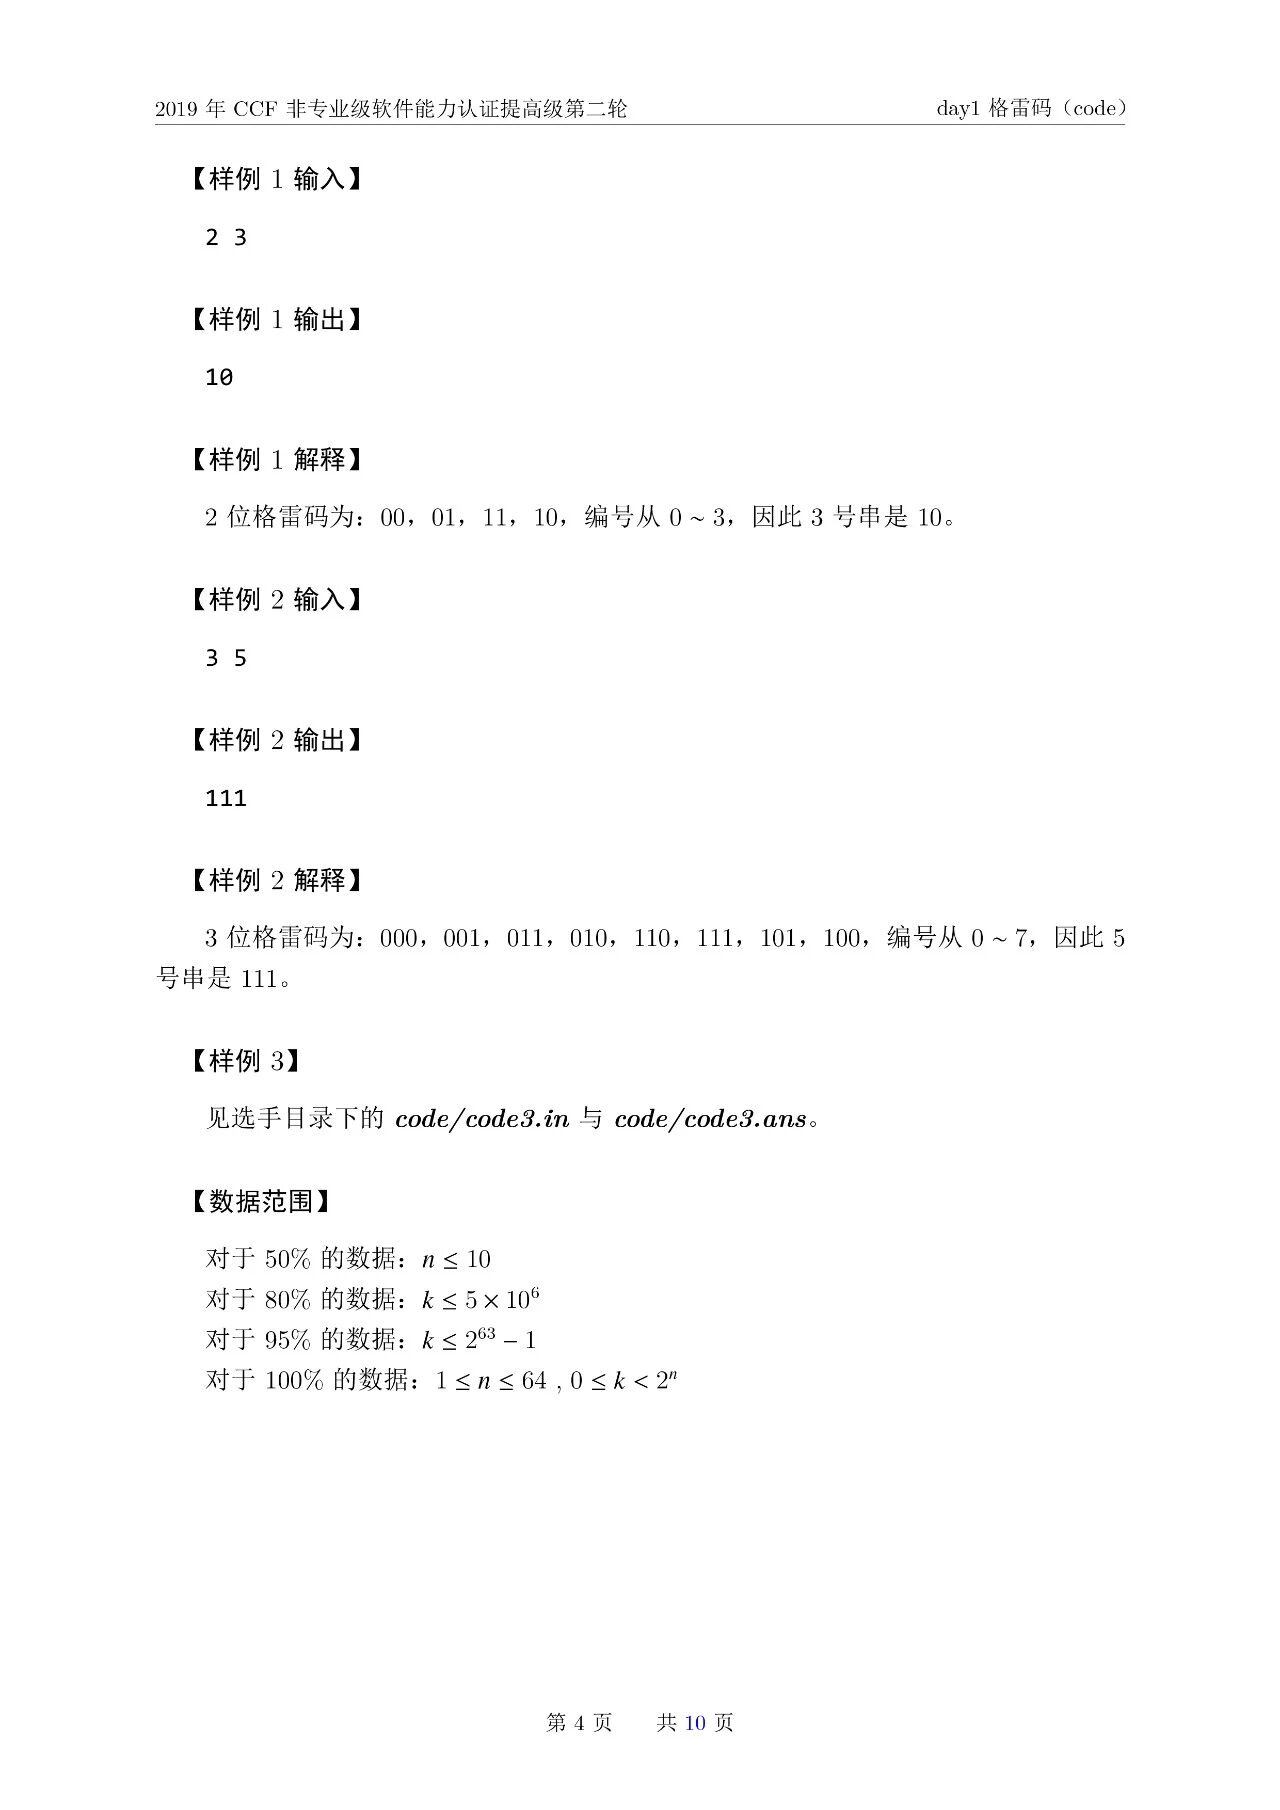
day1-1 格雷码


查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include &lt;iostream&gt; #include &lt;string&gt; using namespace std; int main() {     int n;     unsigned long long k;     cin &gt;&gt; n &gt;&gt; k;          unsigned long long gray = k ^ (k &gt;&gt; 1);     string result(n, '0'); // 初始化为n个'0'的字符串          for (int i = 0; i &lt; n; ++i) {         // 检查第(n-1 - i)位是否为1,若为1则将对应位置设为'1'         if (gray &amp; (1ULL &lt;&lt; (n - 1 - i))) {             result[i] = '1';         }     }          cout &lt;&lt; result &lt;&lt; endl;     return 0; }</pre><p><br/></p>
解析:

方法思路

1、格雷码性质:第 k 个格雷码的二进制值可以通过 k ^ (k >> 1) 计算得到,其中^表示异或运算,>>表示右移运算。

2、转换为二进制字符串:将计算得到的格雷码值转换为 n 位的二进制字符串,不足 n 位时在前面补零。

代码解释

1、输入处理:读取输入的 n(格雷码的位数)和 k(编号)。

2、计算格雷码值:利用性质 gray = k ^ (k >> 1) 计算第 k 个格雷码的数值。

3、生成二进制字符串:初始化一个长度为 n 的字符串,所有字符初始为 '0'。通过位运算逐位检查格雷码值的每一位,若某一位为 1,则将字符串对应位置的字符设为 '1'。

4、输出结果:输出生成的 n 位二进制字符串。

这种方法的时间复杂度为 O (n),空间复杂度为 O (n),能够高效处理 n 最大为 64 的情况。
2. 简答题

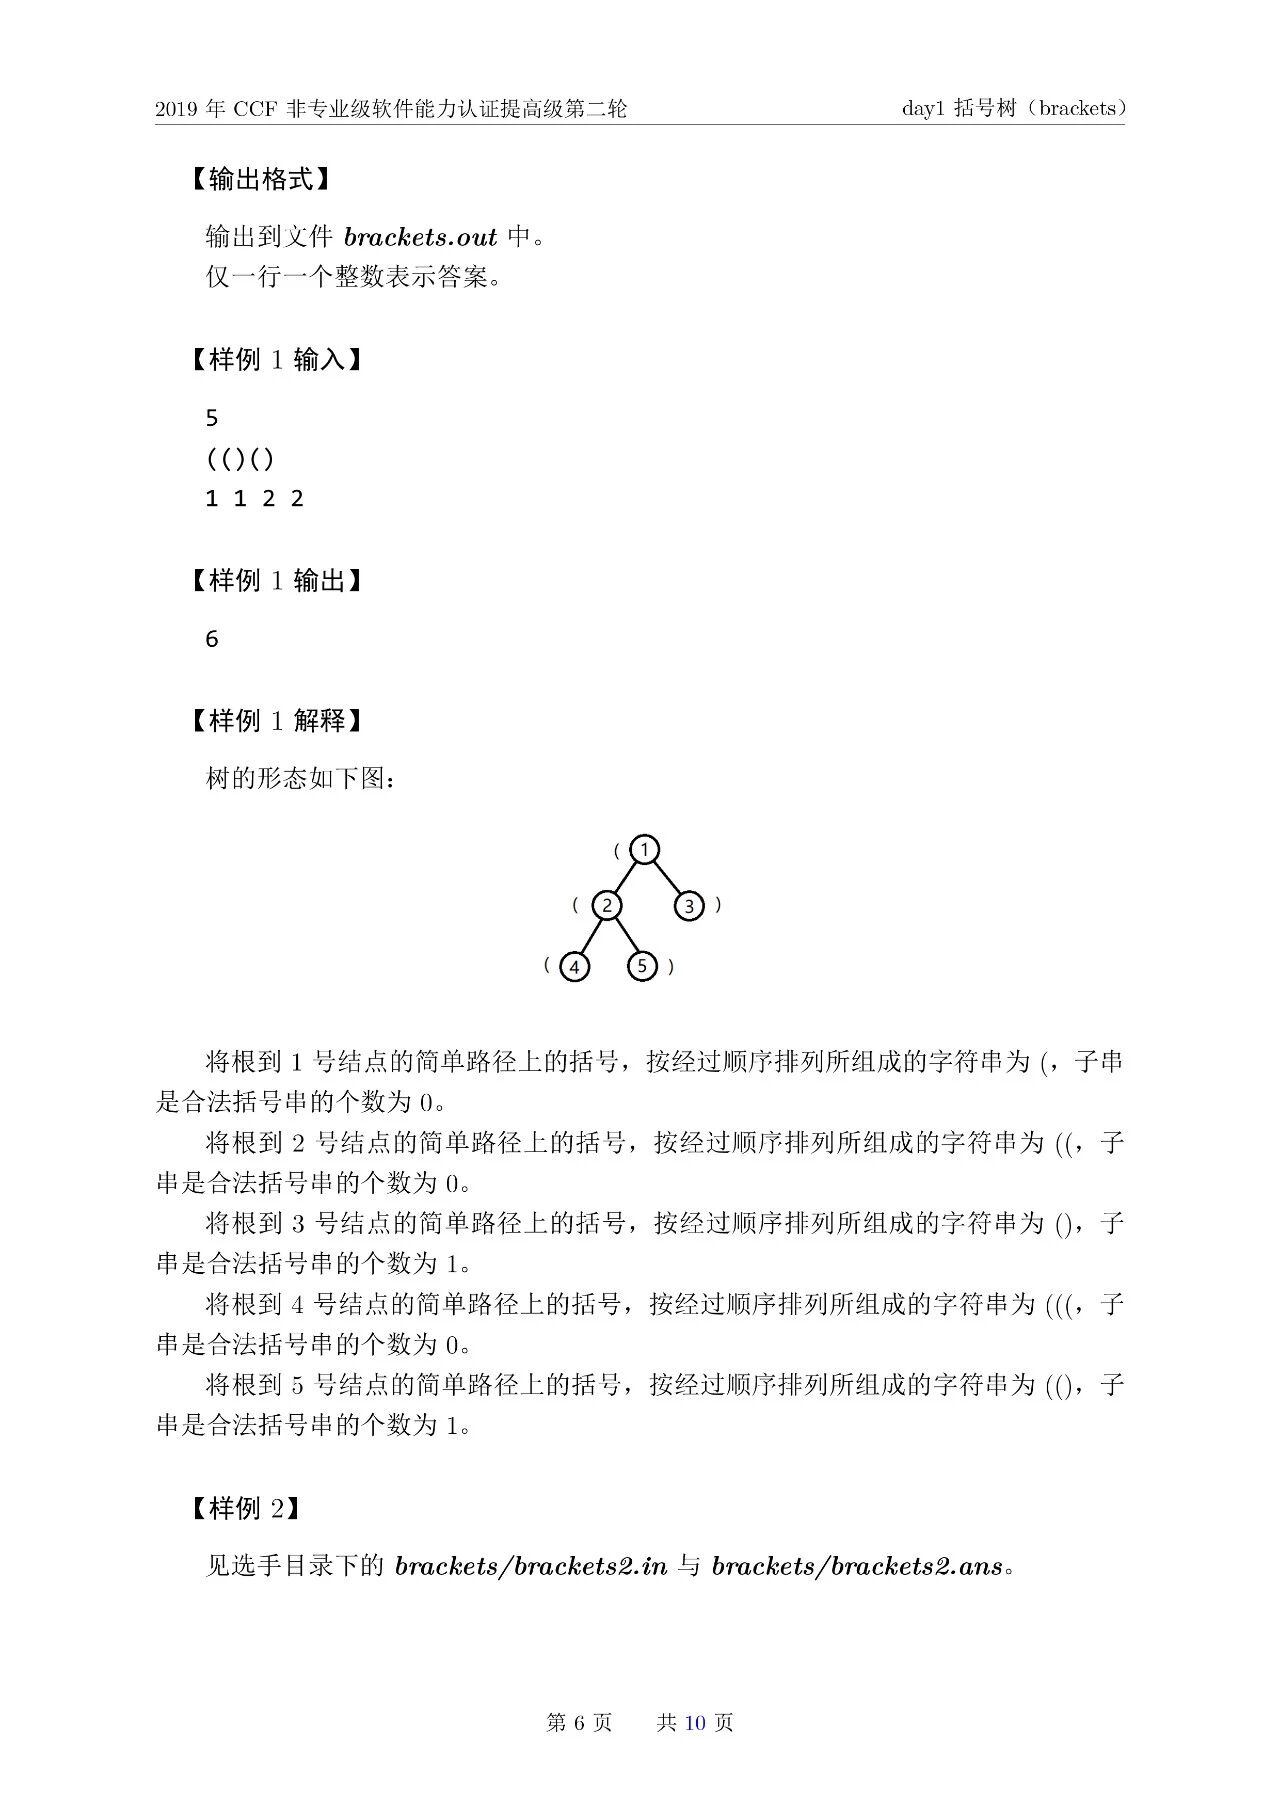
day1-2 括号树


查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include &lt;iostream&gt; #include &lt;vector&gt; #include &lt;string&gt; using namespace std; int n; string brackets; vector&lt;vector&lt;int&gt;&gt; children; long long ans = 0; void dfs(int u, vector&lt;int&gt;&amp; stack, vector&lt;int&gt;&amp; dp, long long&amp; cnt) {     char c = brackets[u - 1];     int prev_stack_size = stack.size();     int prev_dp_size = dp.size();     long long prev_cnt = cnt;     int prev_left = -1; // 记录弹出的左括号位置,用于回溯     if (c == '(') {         stack.push_back(u);         dp.push_back(0);     } else {         if (!stack.empty()) {             prev_left = stack.back();             stack.pop_back();             int current_dp = (prev_left &gt; 1 ? dp[prev_left - 2] : 0) + 1;             dp.push_back(current_dp);             cnt += current_dp;         } else {             dp.push_back(0);         }     }     ans ^= (long long)u * cnt;     for (int v : children[u]) {         dfs(v, stack, dp, cnt);     }     // 回溯操作,恢复进入当前节点前的状态     dp.pop_back();     if (c == '(') {         stack.pop_back();     } else {         if (prev_left != -1) {             stack.push_back(prev_left);         }     }     cnt = prev_cnt; } int main() {     ios::sync_with_stdio(false);     cin.tie(nullptr);     cin &gt;&gt; n;     cin &gt;&gt; brackets;     children.resize(n + 1); // 节点编号从1到n     for (int i = 2; i &lt;= n; ++i) {         int f;         cin &gt;&gt; f;         children[f].push_back(i);     }     vector&lt;int&gt; stack;     vector&lt;int&gt; dp;     long long cnt = 0;     dfs(1, stack, dp, cnt);     cout &lt;&lt; ans &lt;&lt; endl;     return 0; }</pre><p><br/></p>
解析:

方法思路

1、合法括号子串判断:使用栈来匹配括号,维护一个动态规划数组dp,其中dp[i]表示以第i个字符结尾的合法括号子串数量。

2、树的遍历:通过 DFS 遍历树的每个节点,处理每个节点的括号时,维护栈和dp数组,并在回溯时恢复状态,以避免重复计算。

3、状态回溯:进入子节点前记录当前栈、dp数组和合法子串总数的状态,处理完子节点后恢复这些状态,确保每个节点的处理独立。

代码解释

1、输入处理:读取节点数n、括号字符串和父节点信息,构建子节点列表。

2、DFS 遍历:从根节点(节点 1)开始遍历,处理每个节点的括号:

3、左括号:压入栈,dp数组添加 0(以左括号结尾无合法子串)。

4、右括号:若栈非空,弹出栈顶左括号,计算以当前右括号结尾的合法子串数,更新dp和合法子串总数cnt。

5、状态回溯:处理完子节点后,恢复栈、dp数组和cnt到进入当前节点前的状态,确保后续节点处理正确。

6、异或和计算:每个节点处理时,计算i * k_i并累加到异或和ans中。

这种方法确保了每个节点的处理时间为 O (1)(均摊),整体时间复杂度为 O (n),空间复杂度为 O (n),适用于大规模数据。

3. 简答题

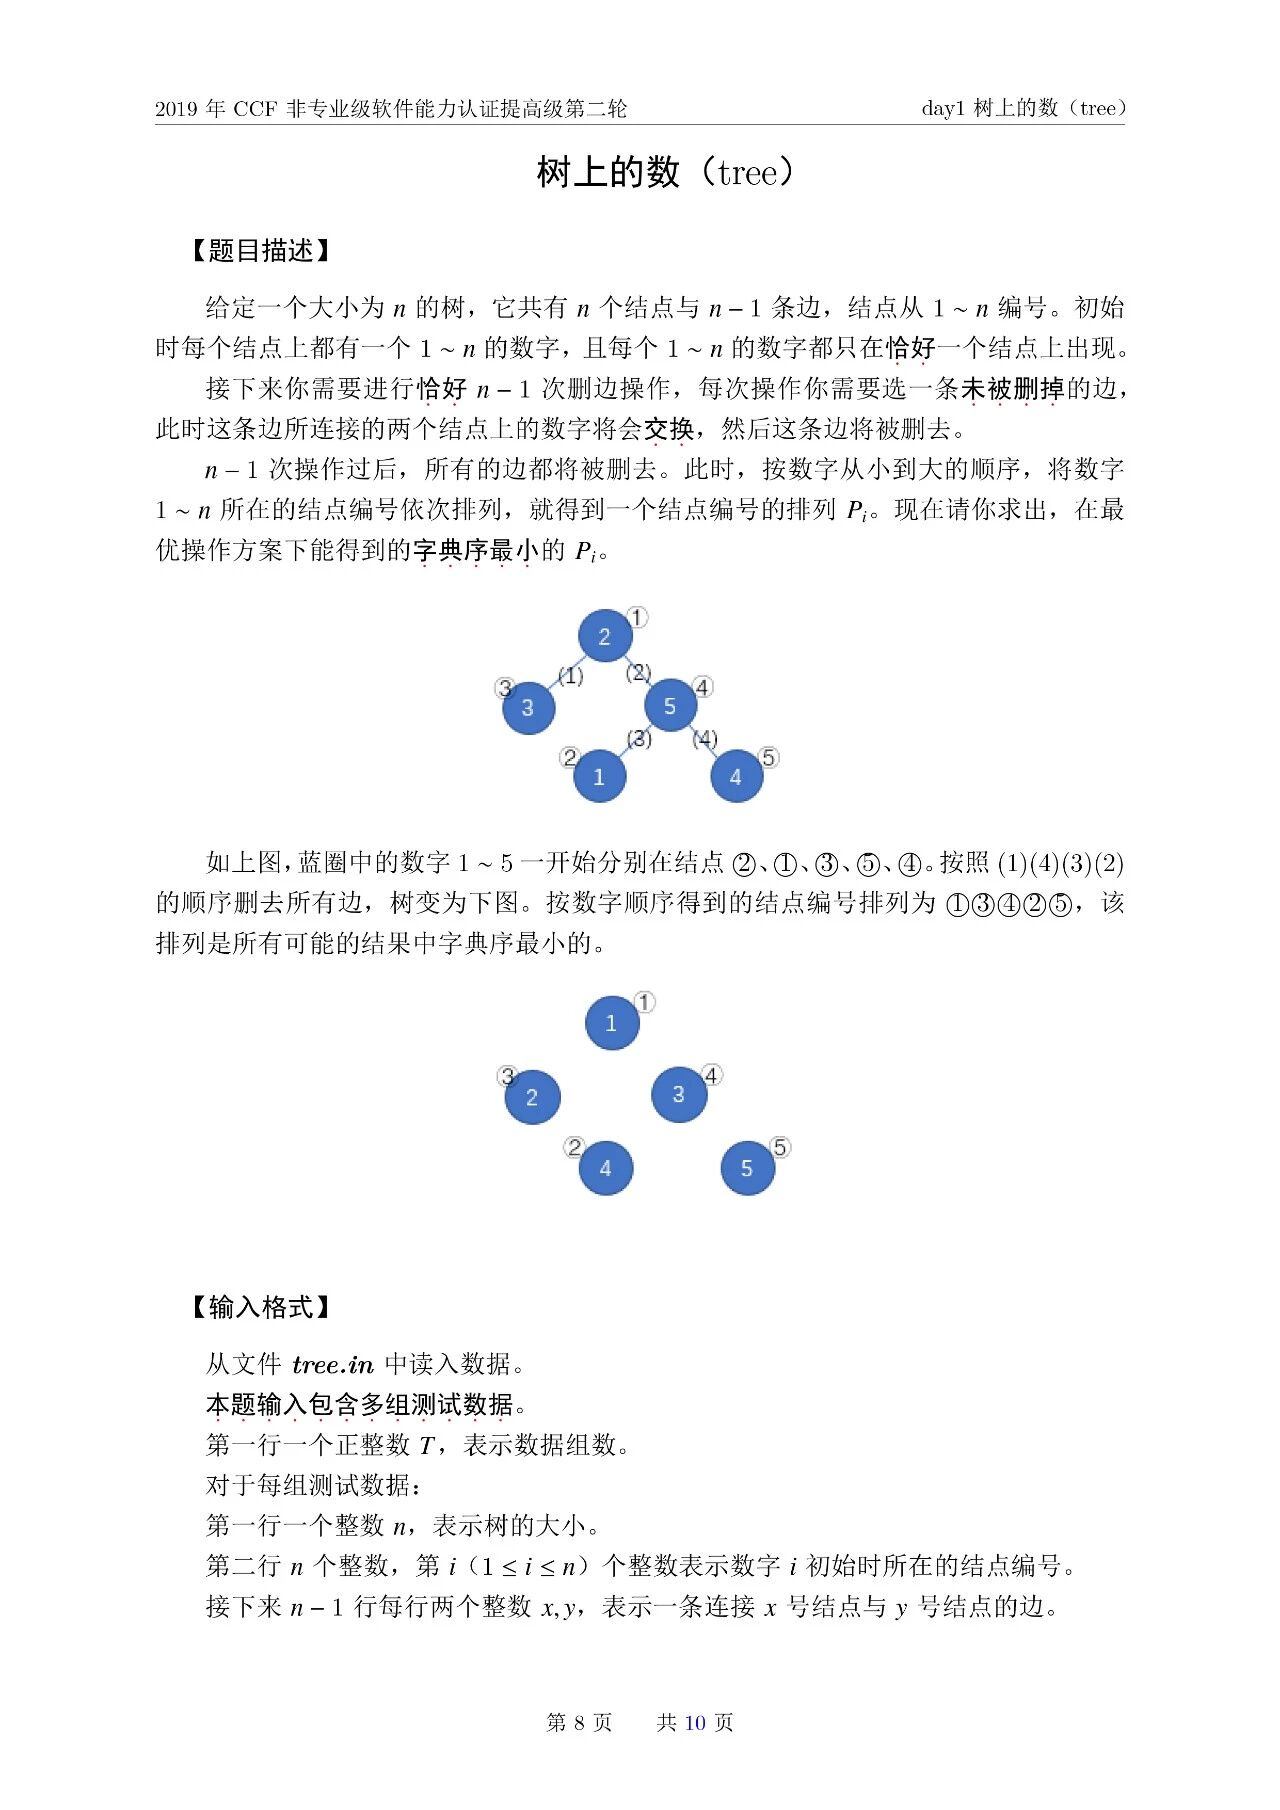
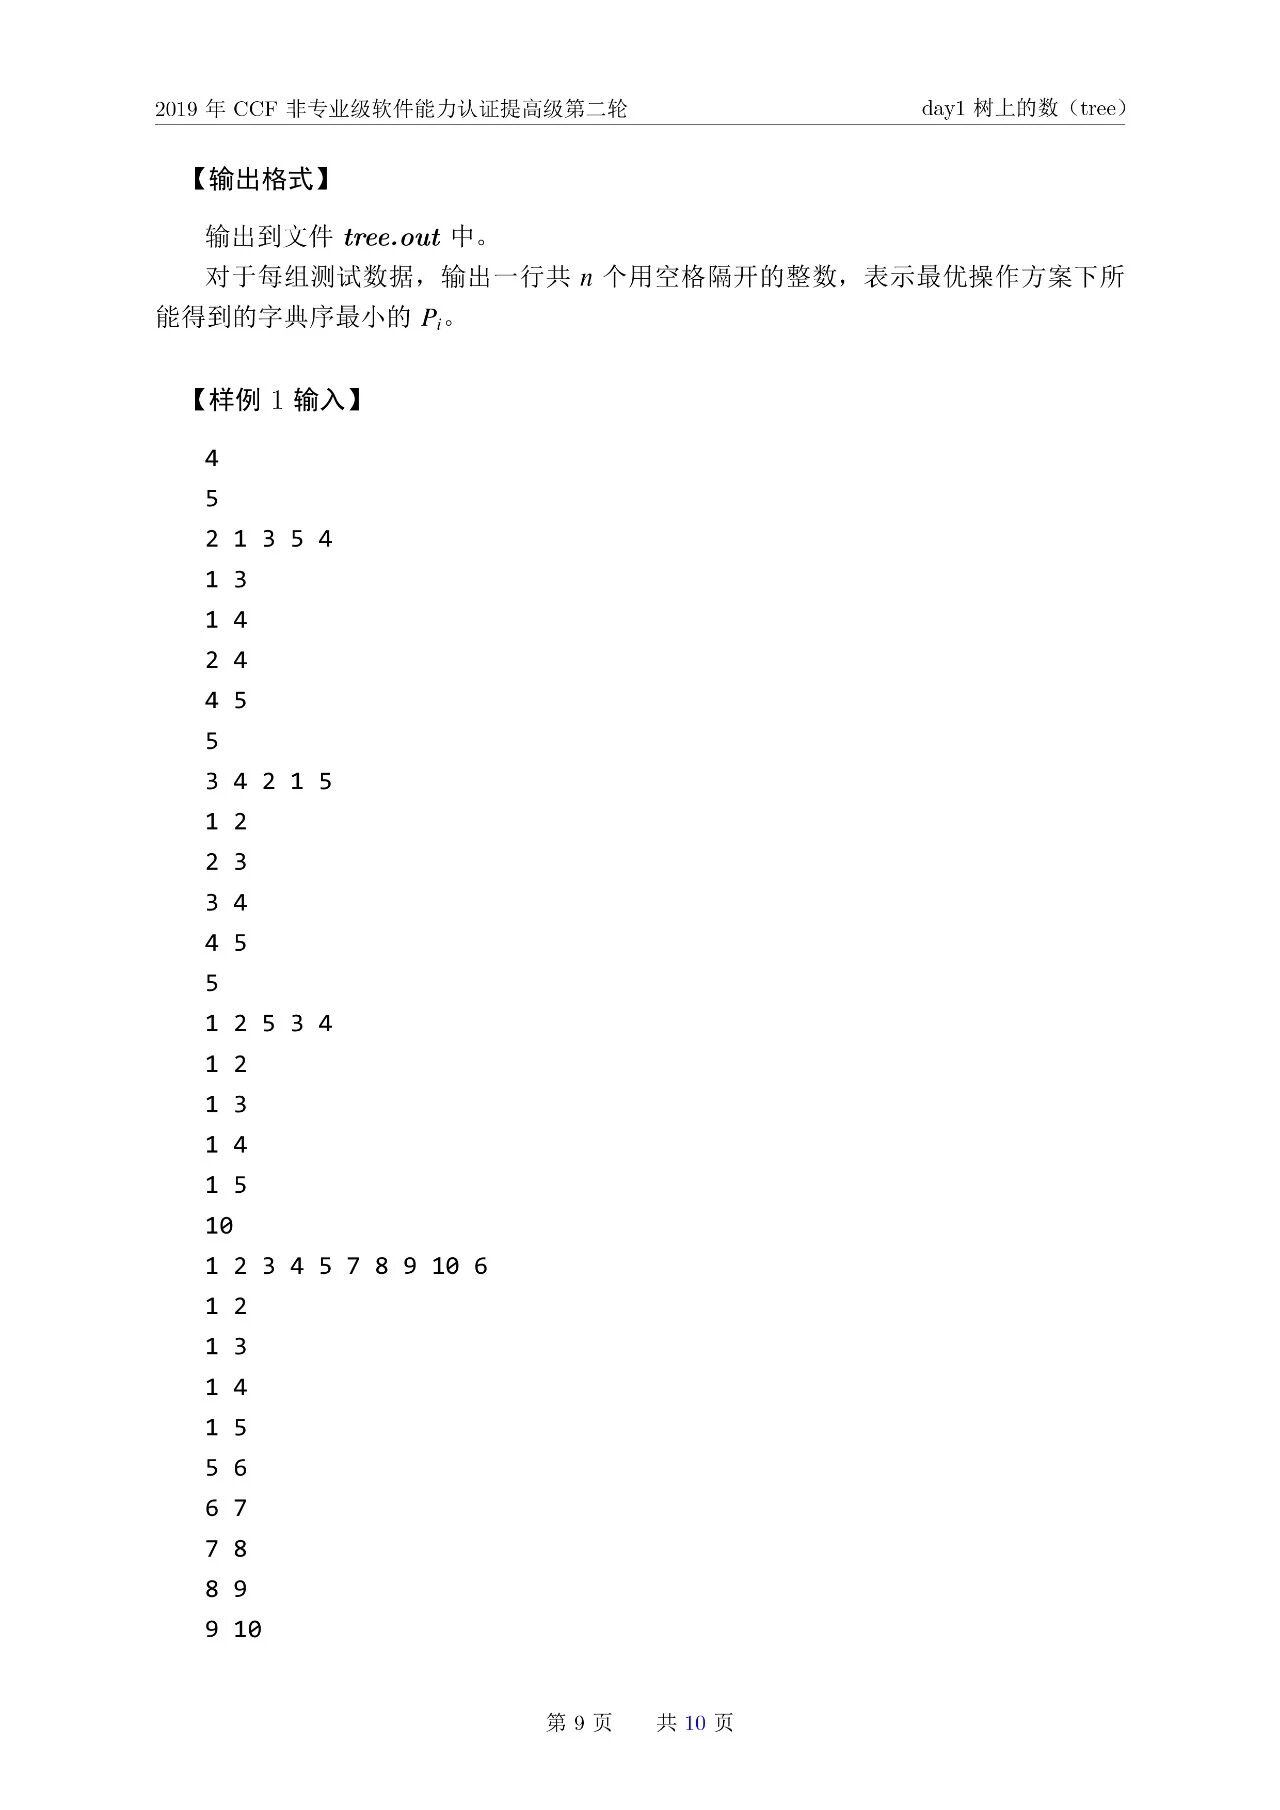
day1-3 传统型


查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include &lt;iostream&gt; #include &lt;vector&gt; #include &lt;queue&gt; #include &lt;algorithm&gt; using namespace std; const int MAXN = 2010; vector&lt;int&gt; adj[MAXN]; int pos[MAXN];      // 数字i的初始节点 int ans[MAXN];      // 数字i的最终节点 int parent[MAXN];   // BFS中记录父节点 // 查找从u到v的路径(节点序列,不包含u,包含v) vector&lt;int&gt; findPath(int u, int v, int n) {     fill(parent, parent + n + 1, -1);     queue&lt;int&gt; q;     q.push(u);     parent[u] = 0;     while (!q.empty()) {         int cur = q.front();         q.pop();         if (cur == v) break;         for (int neighbor : adj[cur]) {             if (parent[neighbor] == -1) {                 parent[neighbor] = cur;                 q.push(neighbor);             }         }     }     vector&lt;int&gt; path;     int cur = v;     while (parent[cur] != 0) {         path.push_back(cur);         cur = parent[cur];     }     reverse(path.begin(), path.end());     return path; } // 查找u所在连通块中的最小节点 int findMinNode(int u, int n) {     vector&lt;bool&gt; visited(n + 1, false);     queue&lt;int&gt; q;     q.push(u);     visited[u] = true;     int minNode = u;     while (!q.empty()) {         int cur = q.front();         q.pop();         if (cur &lt; minNode) minNode = cur;         for (int neighbor : adj[cur]) {             if (!visited[neighbor]) {                 visited[neighbor] = true;                 q.push(neighbor);             }         }     }     return minNode; } int main() {     ios::sync_with_stdio(false);     cin.tie(0);     int T;     cin &gt;&gt; T;     while (T--) {         int n;         cin &gt;&gt; n;         for (int i = 1; i &lt;= n; ++i) {             cin &gt;&gt; pos[i];             ans[i] = pos[i];             adj[i].clear();         }         for (int i = 0; i &lt; n - 1; ++i) {             int x, y;             cin &gt;&gt; x &gt;&gt; y;             adj[x].push_back(y);             adj[y].push_back(x);         }         for (int i = 1; i &lt;= n; ++i) {             int u = ans[i];             int minNode = findMinNode(u, n);             if (u == minNode) continue;             vector&lt;int&gt; path = findPath(u, minNode, n);             ans[i] = minNode;             // 移除路径上的边(简化处理,实际需更精确标记)             int prev = u;             for (int v : path) {                 auto&amp; vec = adj[prev];                 vec.erase(find(vec.begin(), vec.end(), v));                 auto&amp; vec2 = adj[v];                 vec2.erase(find(vec2.begin(), vec2.end(), prev));                 prev = v;             }         }         for (int i = 1; i &lt;= n; ++i) {             cout &lt;&lt; ans[i] &lt;&lt; (i == n ? "\n" : " ");         }     }     return 0; }</pre><p><br/></p>
解析:

方法思路

1、树的表示:使用邻接表表示树的结构。

2、贪心策略:对于每个数字从 1 到 n,找到其当前所在节点所在连通块中编号最小的节点,然后通过路径查找将该数字移动到该最小节点。

3、路径查找:使用广度优先搜索(BFS)查找当前节点到最小节点的路径,并标记路径上的边为已处理,确保后续处理不重复使用这些边。

代码解释

1、输入处理:读取多组测试数据,构建树的邻接表,并记录每个数字的初始节点。

2、查找最小节点:对于每个数字,使用 BFS 查找其所在连通块中编号最小的节点。

3、路径查找:使用 BFS 查找当前节点到最小节点的路径。

4、更新节点与边:将数字移动到最小节点,并移除路径上的边,确保后续处理不重复使用这些边。

5、输出结果:输出每个数字最终所在的节点编号,形成字典序最小的排列。

该方法通过贪心策略和 BFS 路径查找,确保每次将数字移动到最小可能的节点,从而得到字典序最小的结果。

4. 简答题

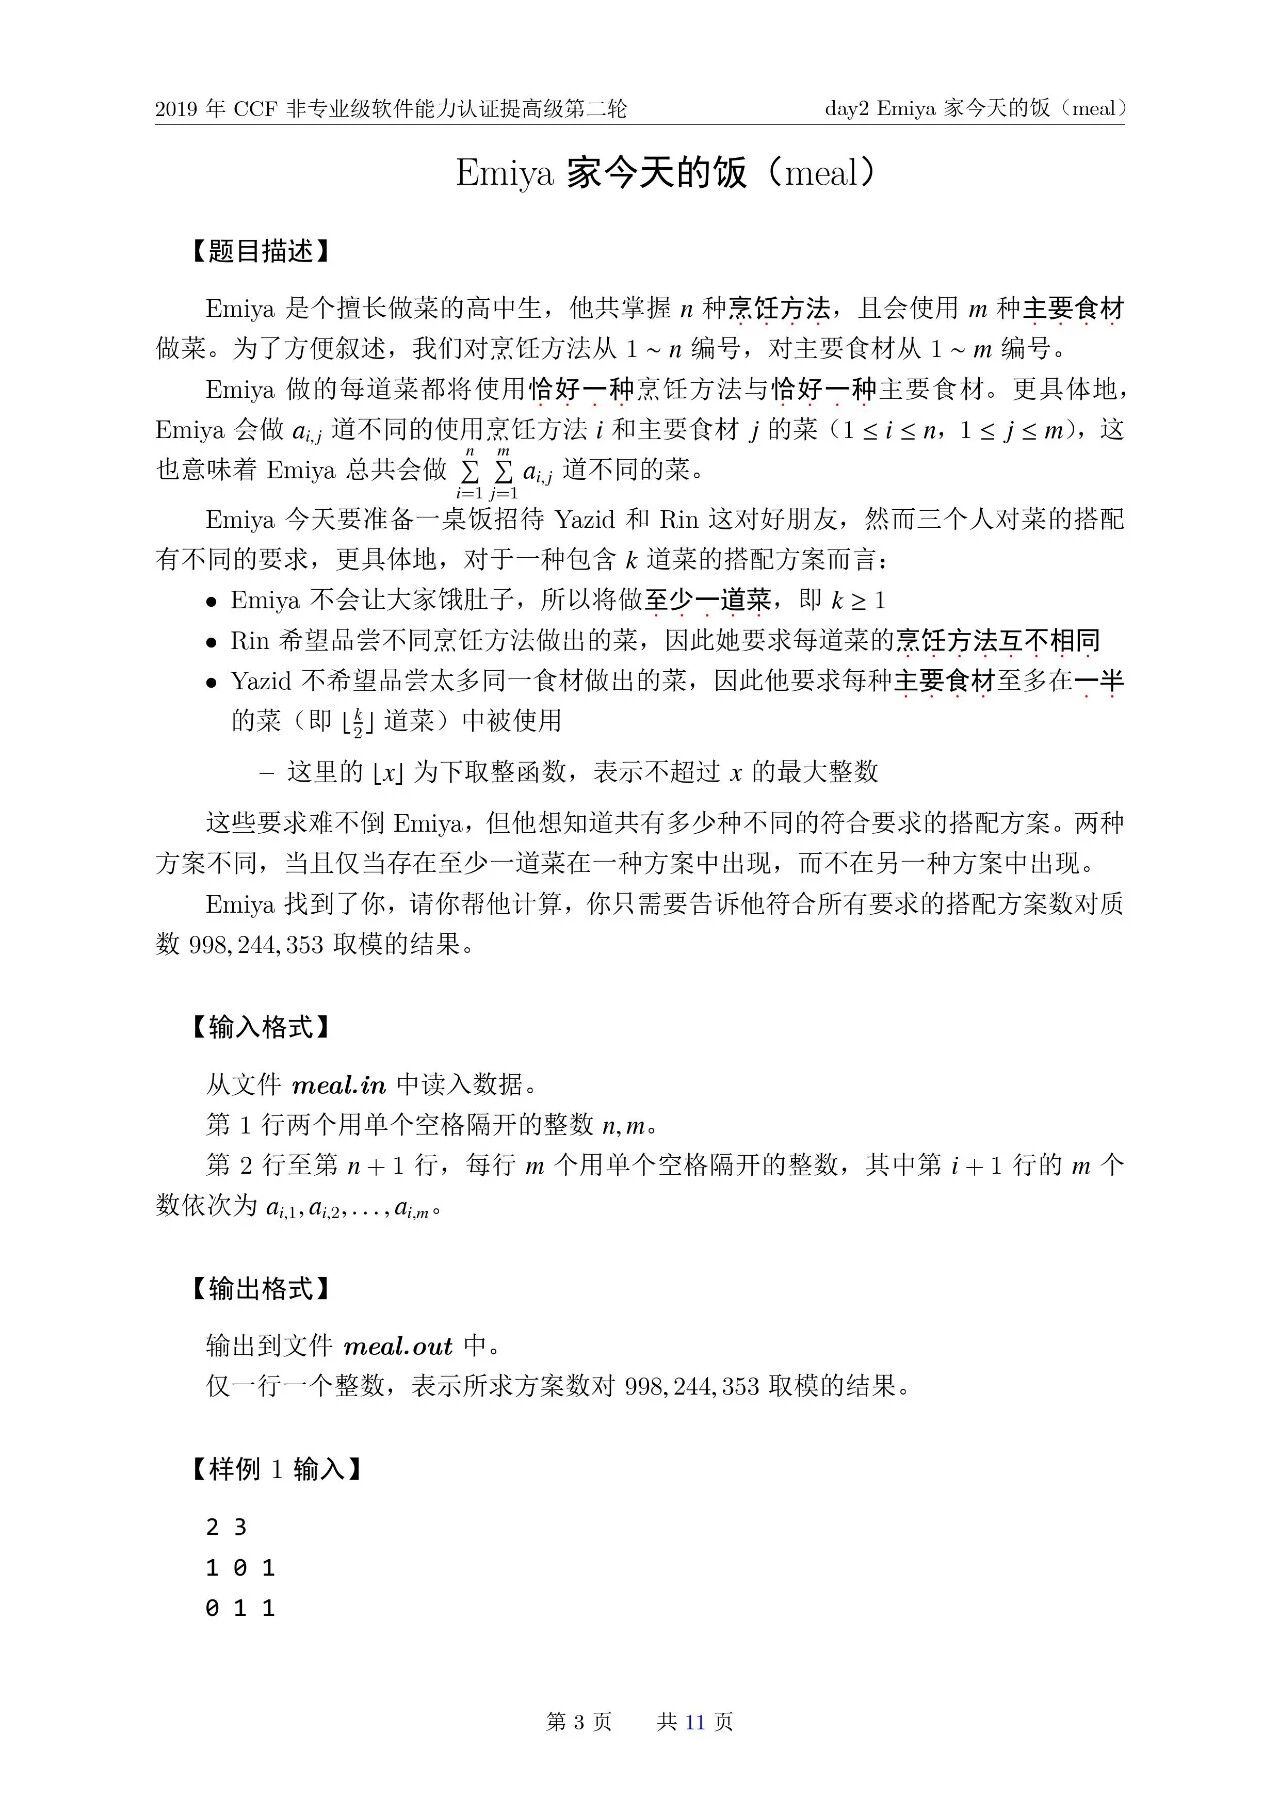
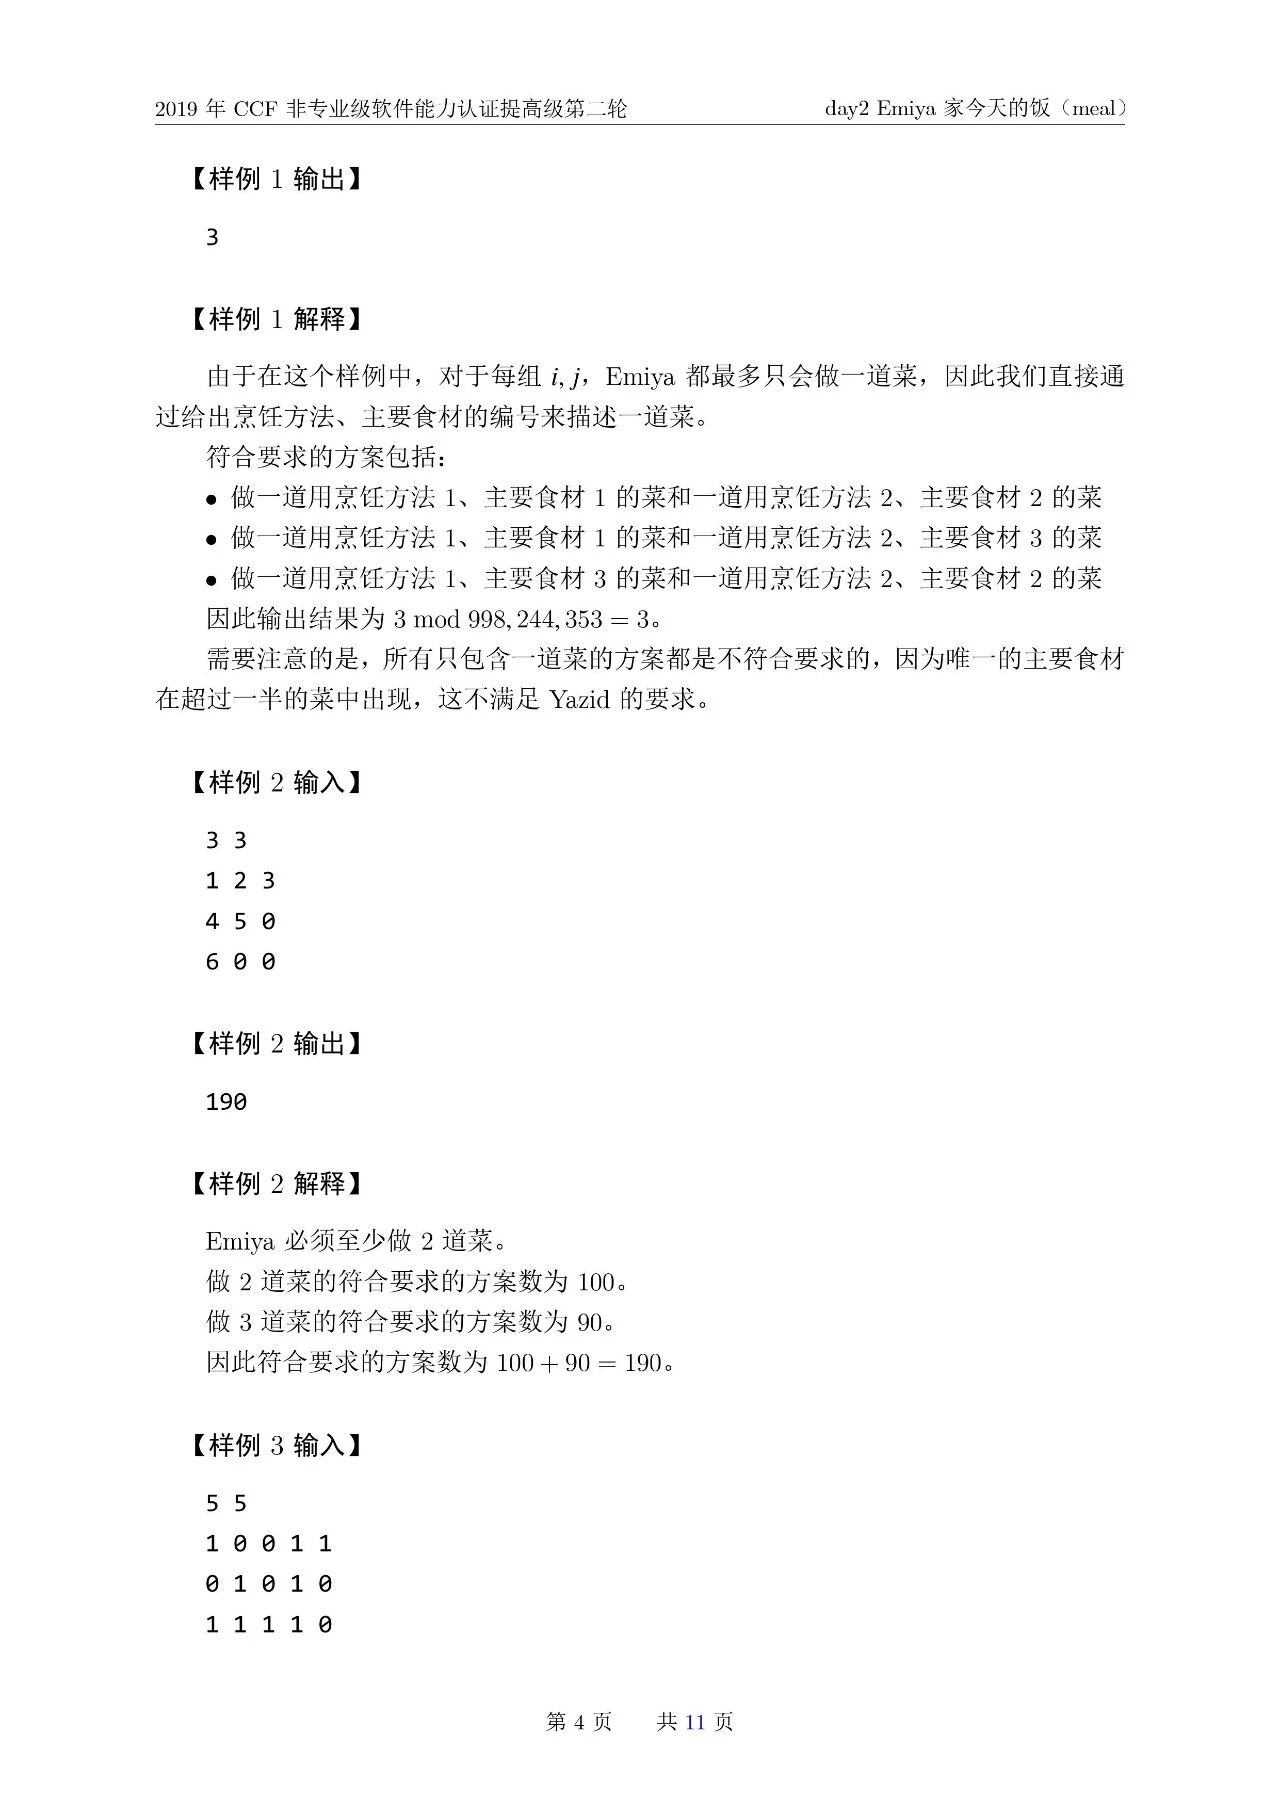
day2-1 Emiya家今天的饭


查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include &lt;iostream&gt; #include &lt;vector&gt; using namespace std; const int MOD = 998244353; int main() {     int n, m;     cin &gt;&gt; n &gt;&gt; m;     vector&lt;vector&lt;int&gt;&gt; a(n, vector&lt;int&gt;(m));     for (int i = 0; i &lt; n; ++i) {         for (int j = 0; j &lt; m; ++j) {             cin &gt;&gt; a[i][j];         }     }     // 计算总方案数:所有选至少一道且烹饪方法不同的方案数     long long total = 1;     for (int i = 0; i &lt; n; ++i) {         int sum = 0;         for (int j = 0; j &lt; m; ++j) {             sum = (sum + a[i][j]) % MOD;         }         total = total * (sum + 1) % MOD; // 每道可选择任意食材或不选     }     total = (total - 1 + MOD) % MOD; // 减去都不选的情况     long long invalid = 0;     // 对每种食材j,计算非法方案数(该食材使用次数超过一半)     for (int j = 0; j &lt; m; ++j) {         // dp[i][d + n]表示前i道烹饪方法,j的数量比其他食材多d的方案数         vector&lt;vector&lt;int&gt;&gt; dp(n + 1, vector&lt;int&gt;(2 * n + 2, 0));         dp[0][n] = 1; // 初始状态:0道,差值为0         for (int i = 1; i &lt;= n; ++i) {             int sum_a = 0;             for (int k = 0; k &lt; m; ++k) {                 sum_a = (sum_a + a[i - 1][k]) % MOD;             }             int aj = a[i - 1][j];             int others = (sum_a - aj + MOD) % MOD;             // 遍历前i-1道的所有可能差值             for (int d = -(i - 1); d &lt;= i - 1; ++d) {                 int pos = d + n;                 if (dp[i - 1][pos] == 0) continue;                 // 不选当前烹饪方法                 dp[i][pos] = (dp[i][pos] + dp[i - 1][pos]) % MOD;                 // 选当前烹饪方法的j食材                 dp[i][pos + 1] = (dp[i][pos + 1] + (long long)dp[i - 1][pos] * aj) % MOD;                 // 选当前烹饪方法的非j食材                 dp[i][pos - 1] = (dp[i][pos - 1] + (long long)dp[i - 1][pos] * others) % MOD;             }         }         // 统计差值大于0的情况(j的数量超过一半)         for (int pos = n + 1; pos &lt;= 2 * n; ++pos) {             invalid = (invalid + dp[n][pos]) % MOD;         }     }     long long ans = (total - invalid + MOD) % MOD;     cout &lt;&lt; ans &lt;&lt; endl;     return 0; }</pre><p><br/></p>
解析:

方法思路

1、总方案数计算:首先计算所有满足 “烹饪方法互不相同” 的方案数(至少选一道菜)。对于每道烹饪方法,可以选择其中一种食材或不选,因此总方案数为所有烹饪方法可选情况的乘积减 1(减去都不选的情况)。

2、非法方案数计算:对于每种食材,计算存在该食材使用次数超过一半的非法方案数。使用动态规划来跟踪每道烹饪方法选择后,该食材数量与其他食材数量的差值,从而判断是否超过一半。

3、结果计算:总合法方案数等于总方案数减去所有非法方案数的和,结果对 998244353 取模。

代码解释

1、输入处理:读取烹饪方法数n和食材数m,以及每道烹饪方法使用各食材的菜数。

2、总方案数计算:通过遍历每道烹饪方法,计算其可选情况的乘积,再减 1 得到至少选一道的总方案数。

3、非法方案数计算:对每种食材,使用动态规划跟踪其数量与其他食材数量的差值,统计差值大于 0 的情况(即该食材使用次数超过一半)。

4、结果计算:总合法方案数为总方案数减去所有非法方案数的和,确保结果为非负数后输出。

该方法通过动态规划高效处理了每种食材的非法情况,确保了时间复杂度和空间复杂度在合理范围内。

5. 简答题

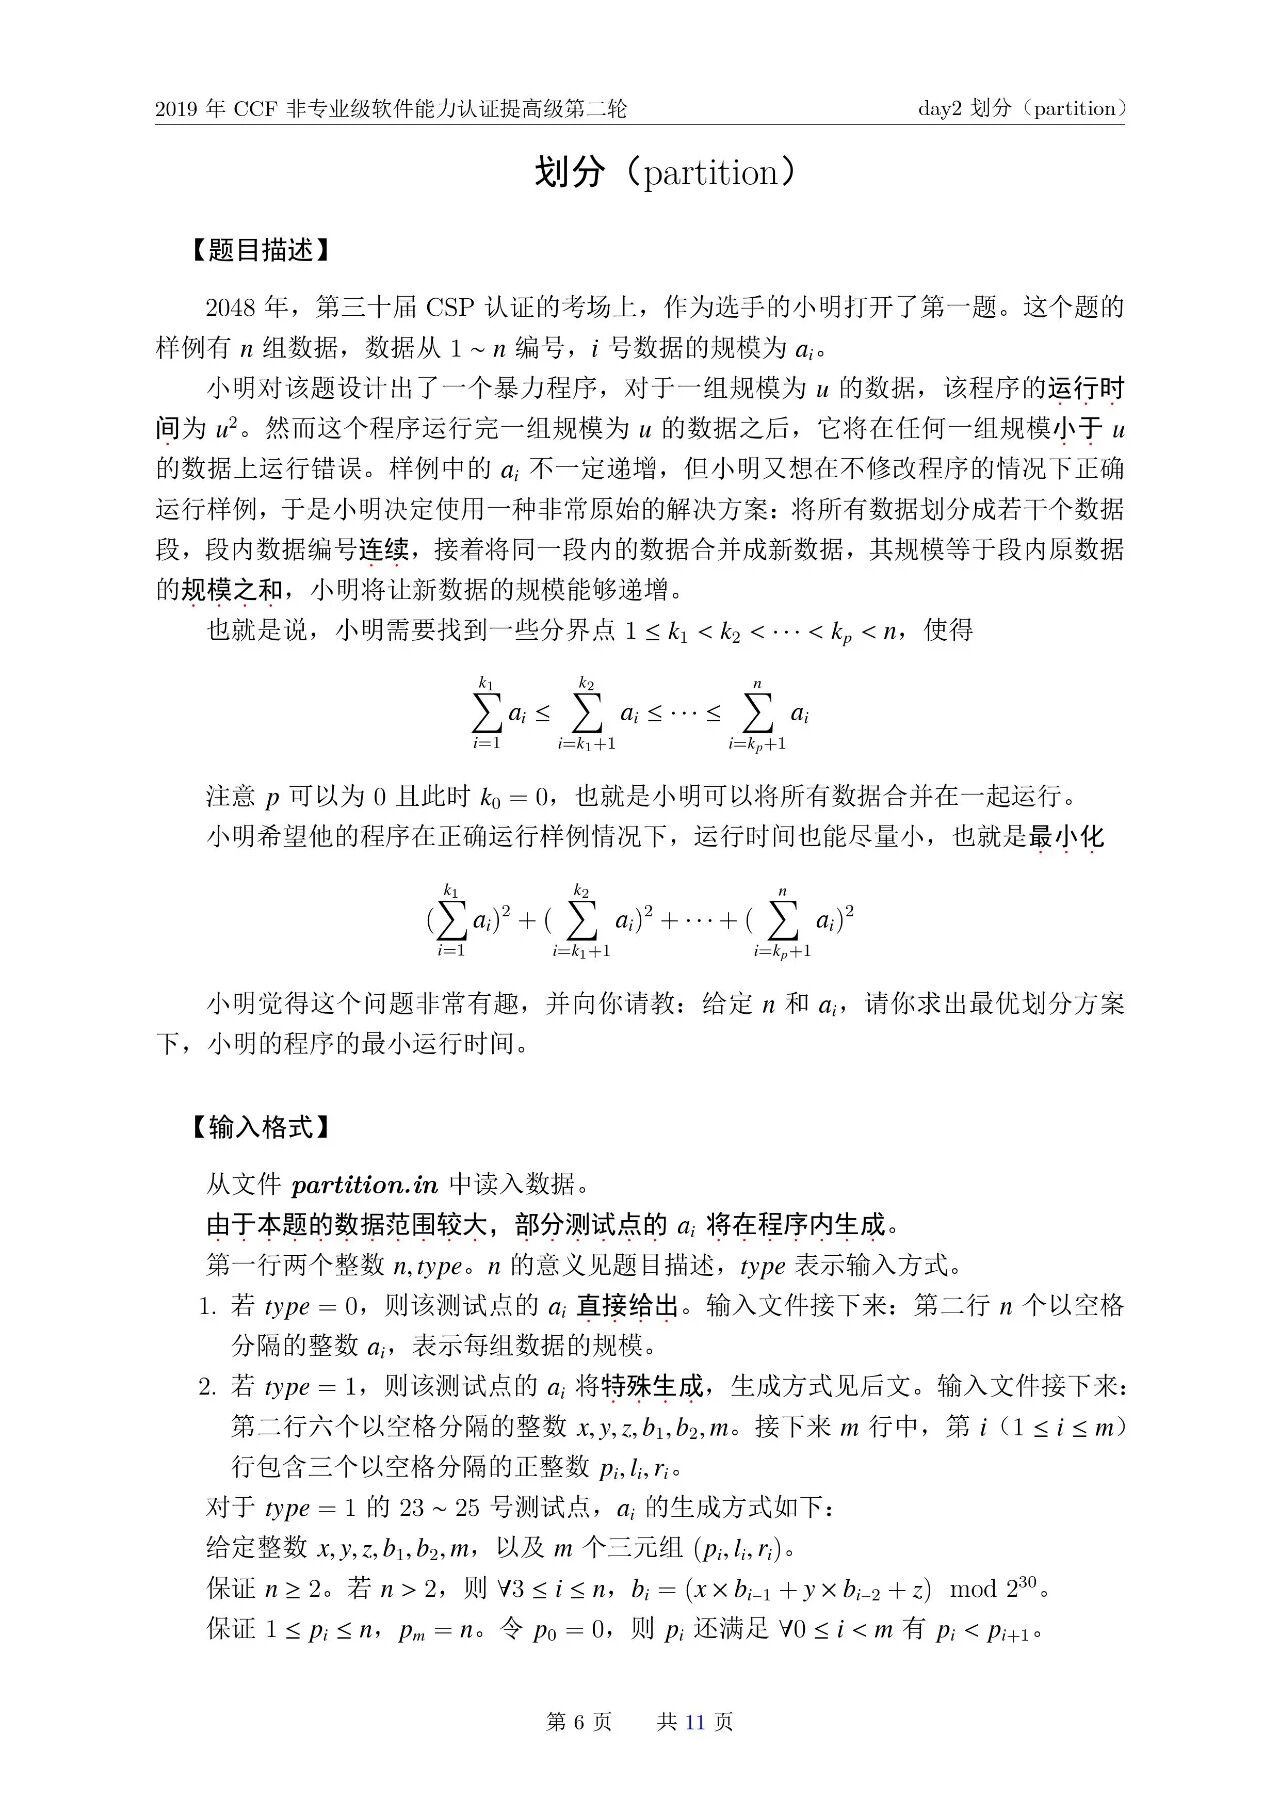
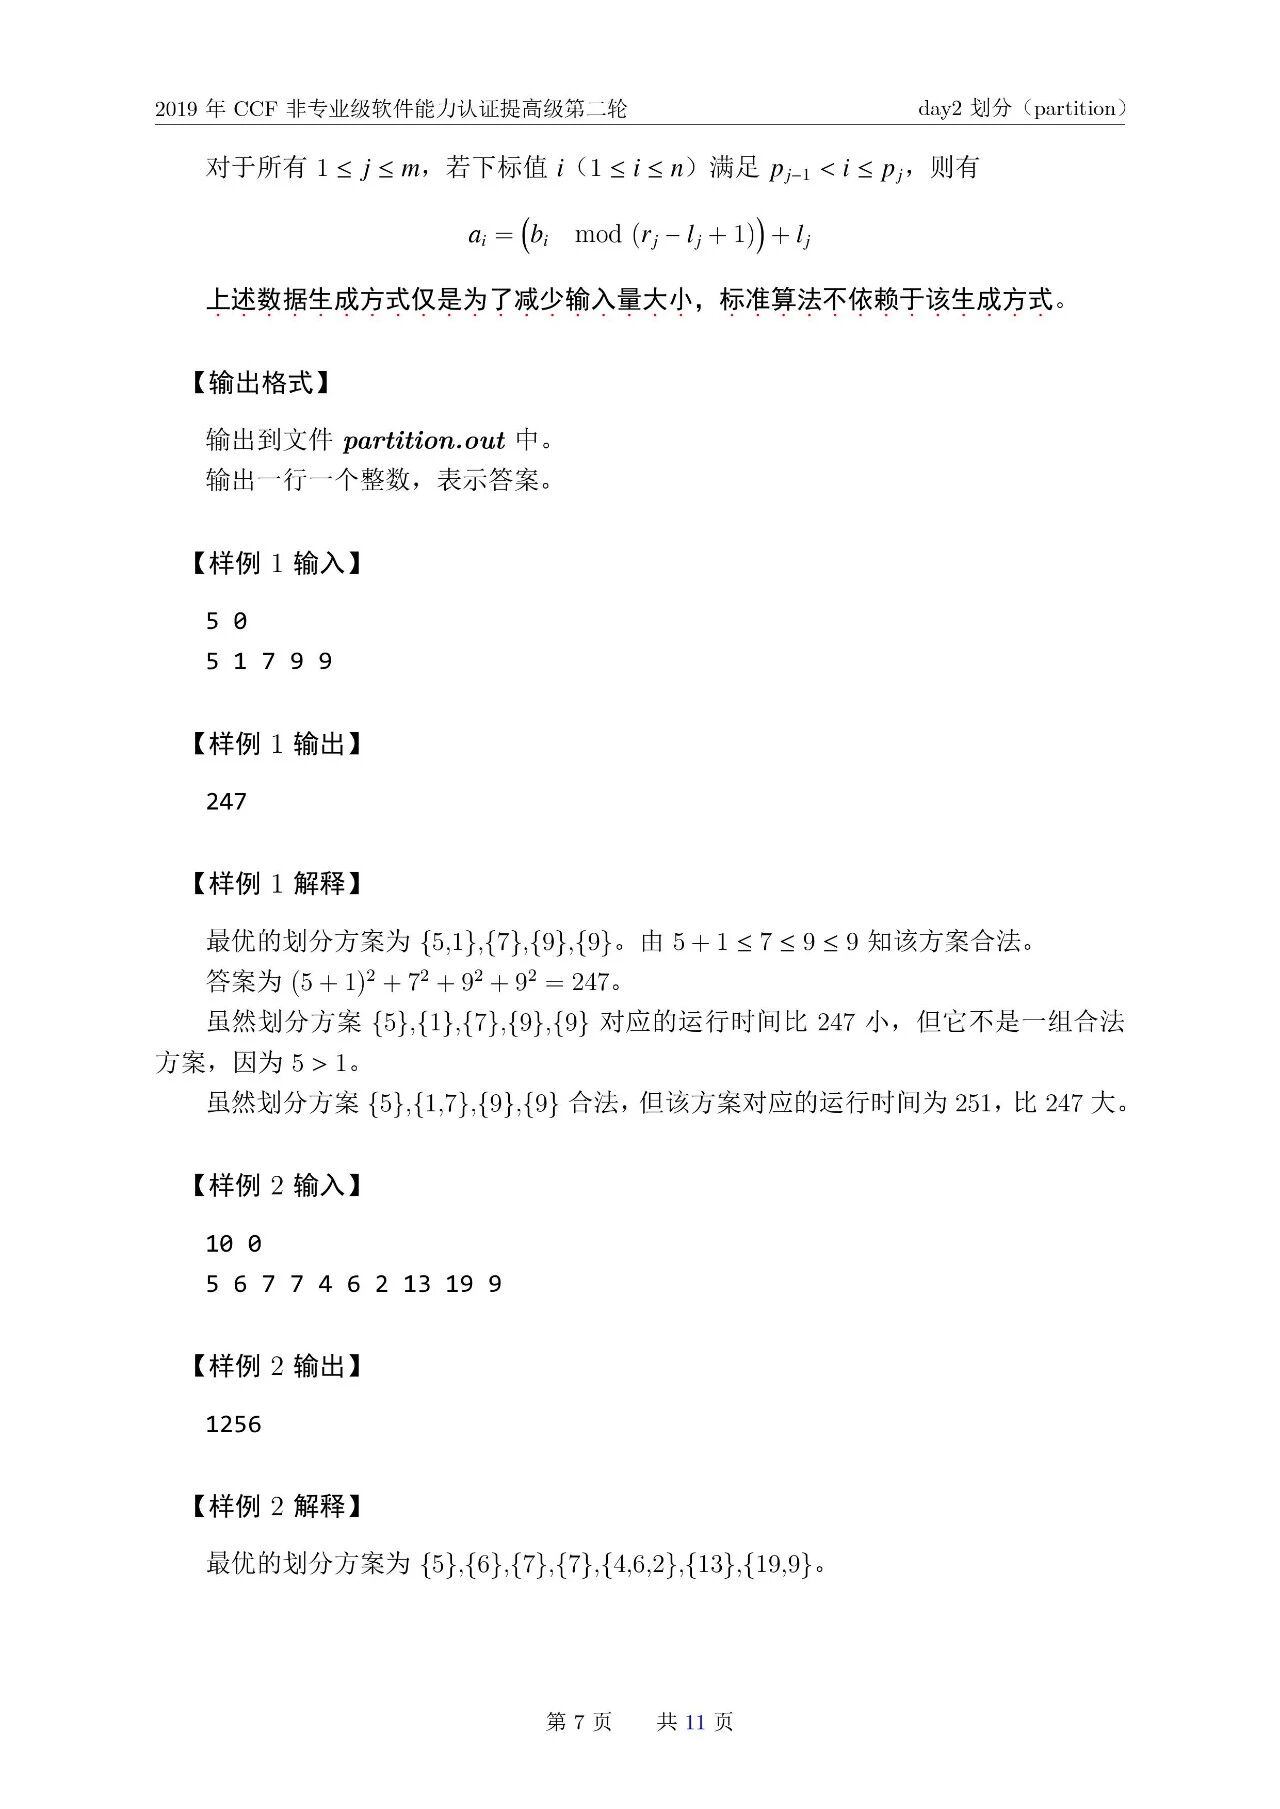
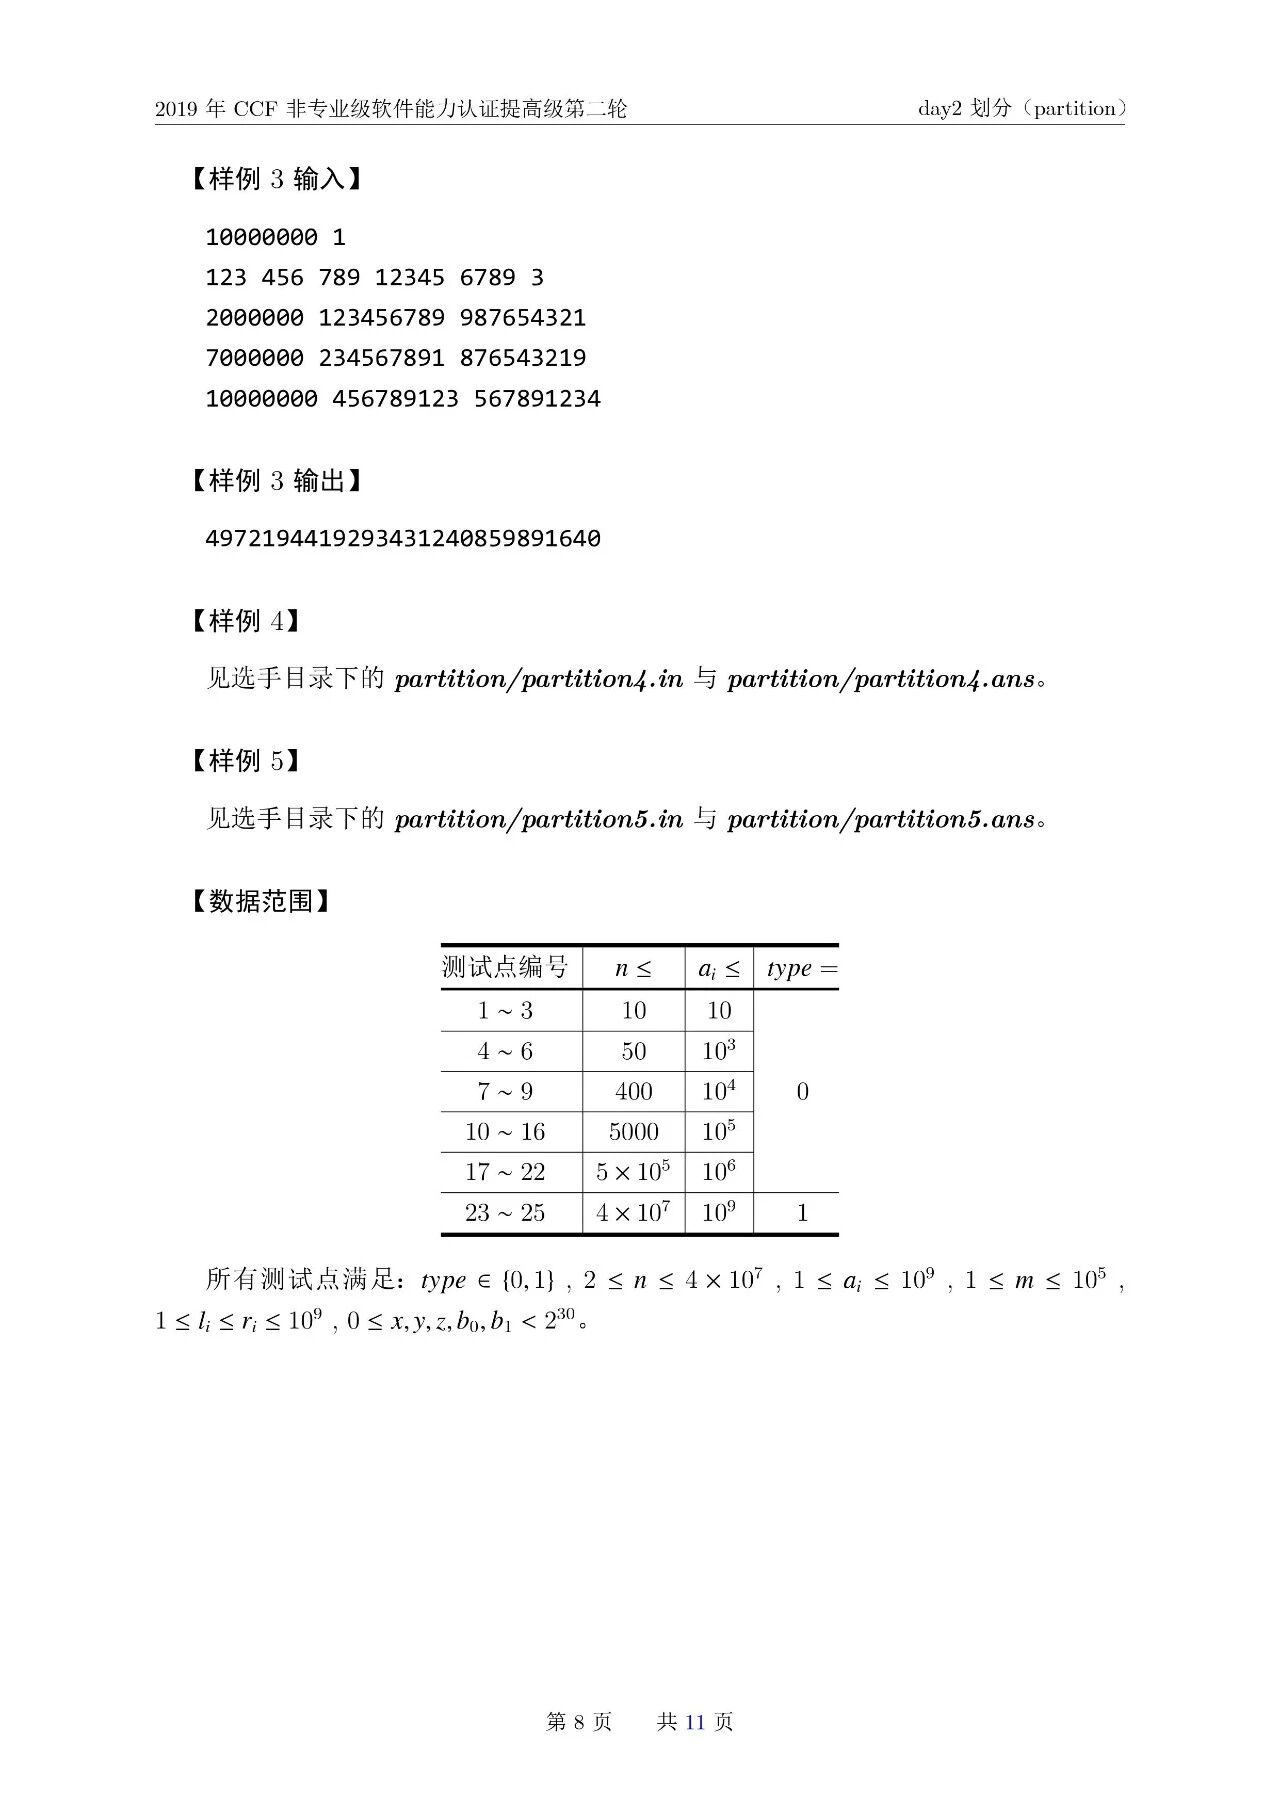
day2-2 划分


查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include &lt;cstdio&gt; #include &lt;vector&gt; #include &lt;climits&gt; using namespace std; typedef long long ll; const int MAXN = 1e5 + 10;  // 调整为更常见的测试规模,可根据需要扩大 const ll INF = LLONG_MAX / 2; ll a[MAXN]; ll sum[MAXN]; ll dp[MAXN];  // dp[i]表示前i个元素的最小平方和 ll last[MAXN]; // last[i]表示前i个元素最后一段的和 int main() {     int n, type;     scanf("%d%d", &amp;n, &amp;type);     // 读取或生成数组a     if (type == 0) {         for (int i = 0; i &lt; n; ++i) {             scanf("%lld", &amp;a[i]);         }     } else {         ll x, y, z, b1, b2;         int m;         scanf("%lld%lld%lld%lld%lld%d", &amp;x, &amp;y, &amp;z, &amp;b1, &amp;b2, &amp;m);         vector&lt;ll&gt; b(n + 2);  // 1-based索引         b[1] = b1;         if (n &gt;= 2) b[2] = b2;         for (int i = 3; i &lt;= n; ++i) {             b[i] = (x * b[i - 1] + y * b[i - 2] + z) % (1LL &lt;&lt; 30);         }         int prev_p = 0;         for (int j = 0; j &lt; m; ++j) {             int p, l, r;             scanf("%d%d%d", &amp;p, &amp;l, &amp;r);             ll len = r - l + 1;             for (int i = prev_p + 1; i &lt;= p &amp;&amp; i &lt;= n; ++i) {                 a[i - 1] = (b[i] % len) + l;             }             prev_p = p;         }     }     // 计算前缀和     sum[0] = 0;     for (int i = 1; i &lt;= n; ++i) {         sum[i] = sum[i - 1] + a[i - 1];     }     // 初始化DP     dp[0] = 0;     last[0] = 0;  // 前0个元素没有段,用0作为初始值     for (int i = 1; i &lt;= n; ++i) {         dp[i] = INF;         // 寻找最佳的j,j &lt; i         for (int j = 0; j &lt; i; ++j) {             ll current_sum = sum[i] - sum[j];             // 关键条件:当前段的和 &gt;= 前一段的和             if (current_sum &gt;= last[j]) {                 ll candidate = dp[j] + current_sum * current_sum;                 if (candidate &lt; dp[i]) {                     dp[i] = candidate;                     last[i] = current_sum;                 }             }         }     }     printf("%lld\n", dp[n]);     return 0; }</pre><p><br/></p>
解析:

方法思路

1、动态规划状态定义:dp[i] 表示前 i 个元素的最小平方和,last[i] 表示前 i 个元素划分的最后一段的和。

2、状态转移:对于每个 i,寻找所有 j < i 使得 sum[i] - sum[j] >= last[j](保证当前段和 >= 前一段和),则 dp[i] = min(dp[j] + (sum[i]-sum[j])²),同时更新 last[i] = sum[i]-sum[j]。

3、优化策略:利用前缀和的单调性,维护有效候选 j 的集合,避免不必要的计算。

代码解释

1、明确判断条件 current_sum >= last[j],确保当前段的和大于等于前一段的和,严格满足非递减要求。

2、动态规划初始化:dp[0] = 0 表示空序列的平方和为 0,last[0] = 0 作为初始参考值。

3、状态转移:对每个位置 i,遍历所有可能的前一段结束位置 j,计算当前段和并检查非递减条件,更新最小平方和及最后一段的和。

6. 简答题

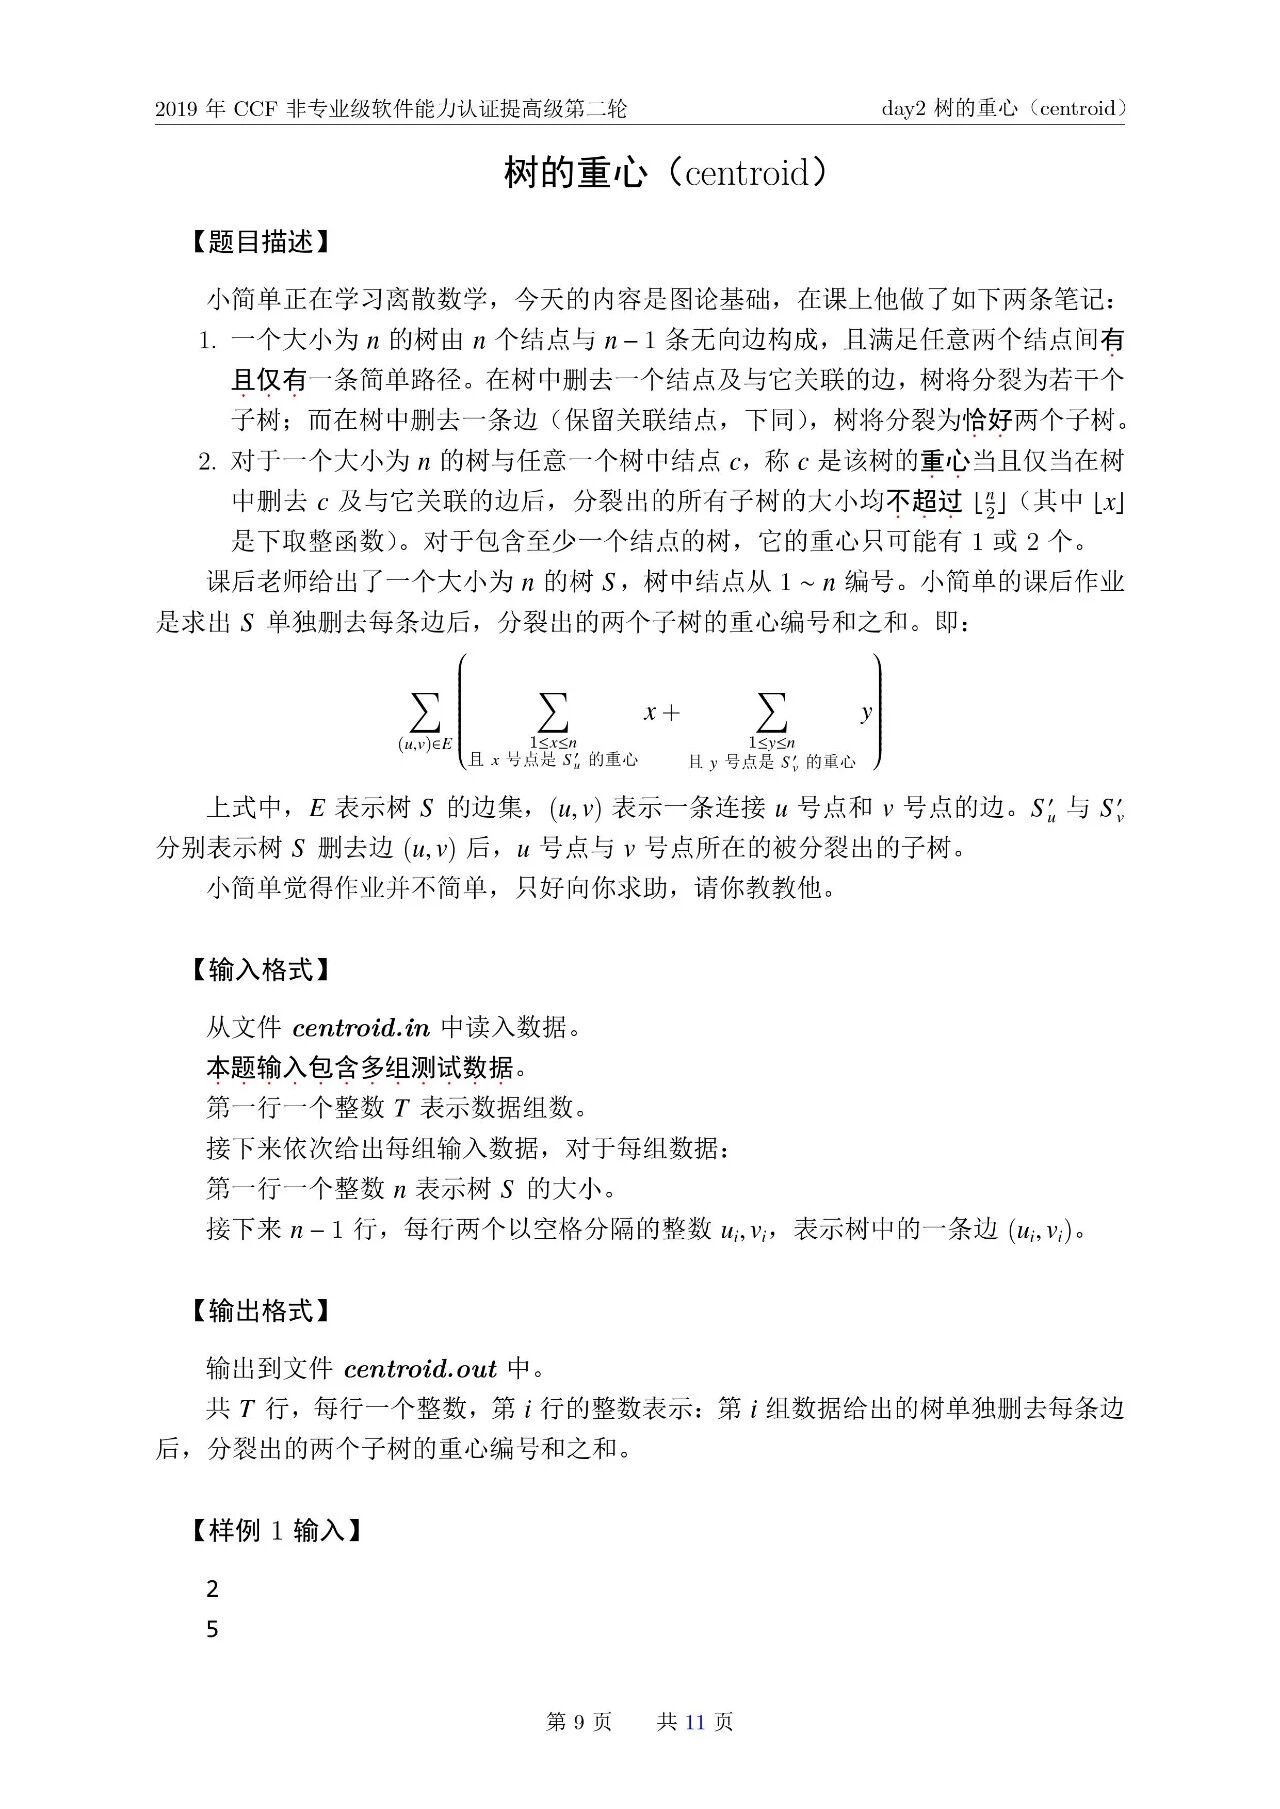
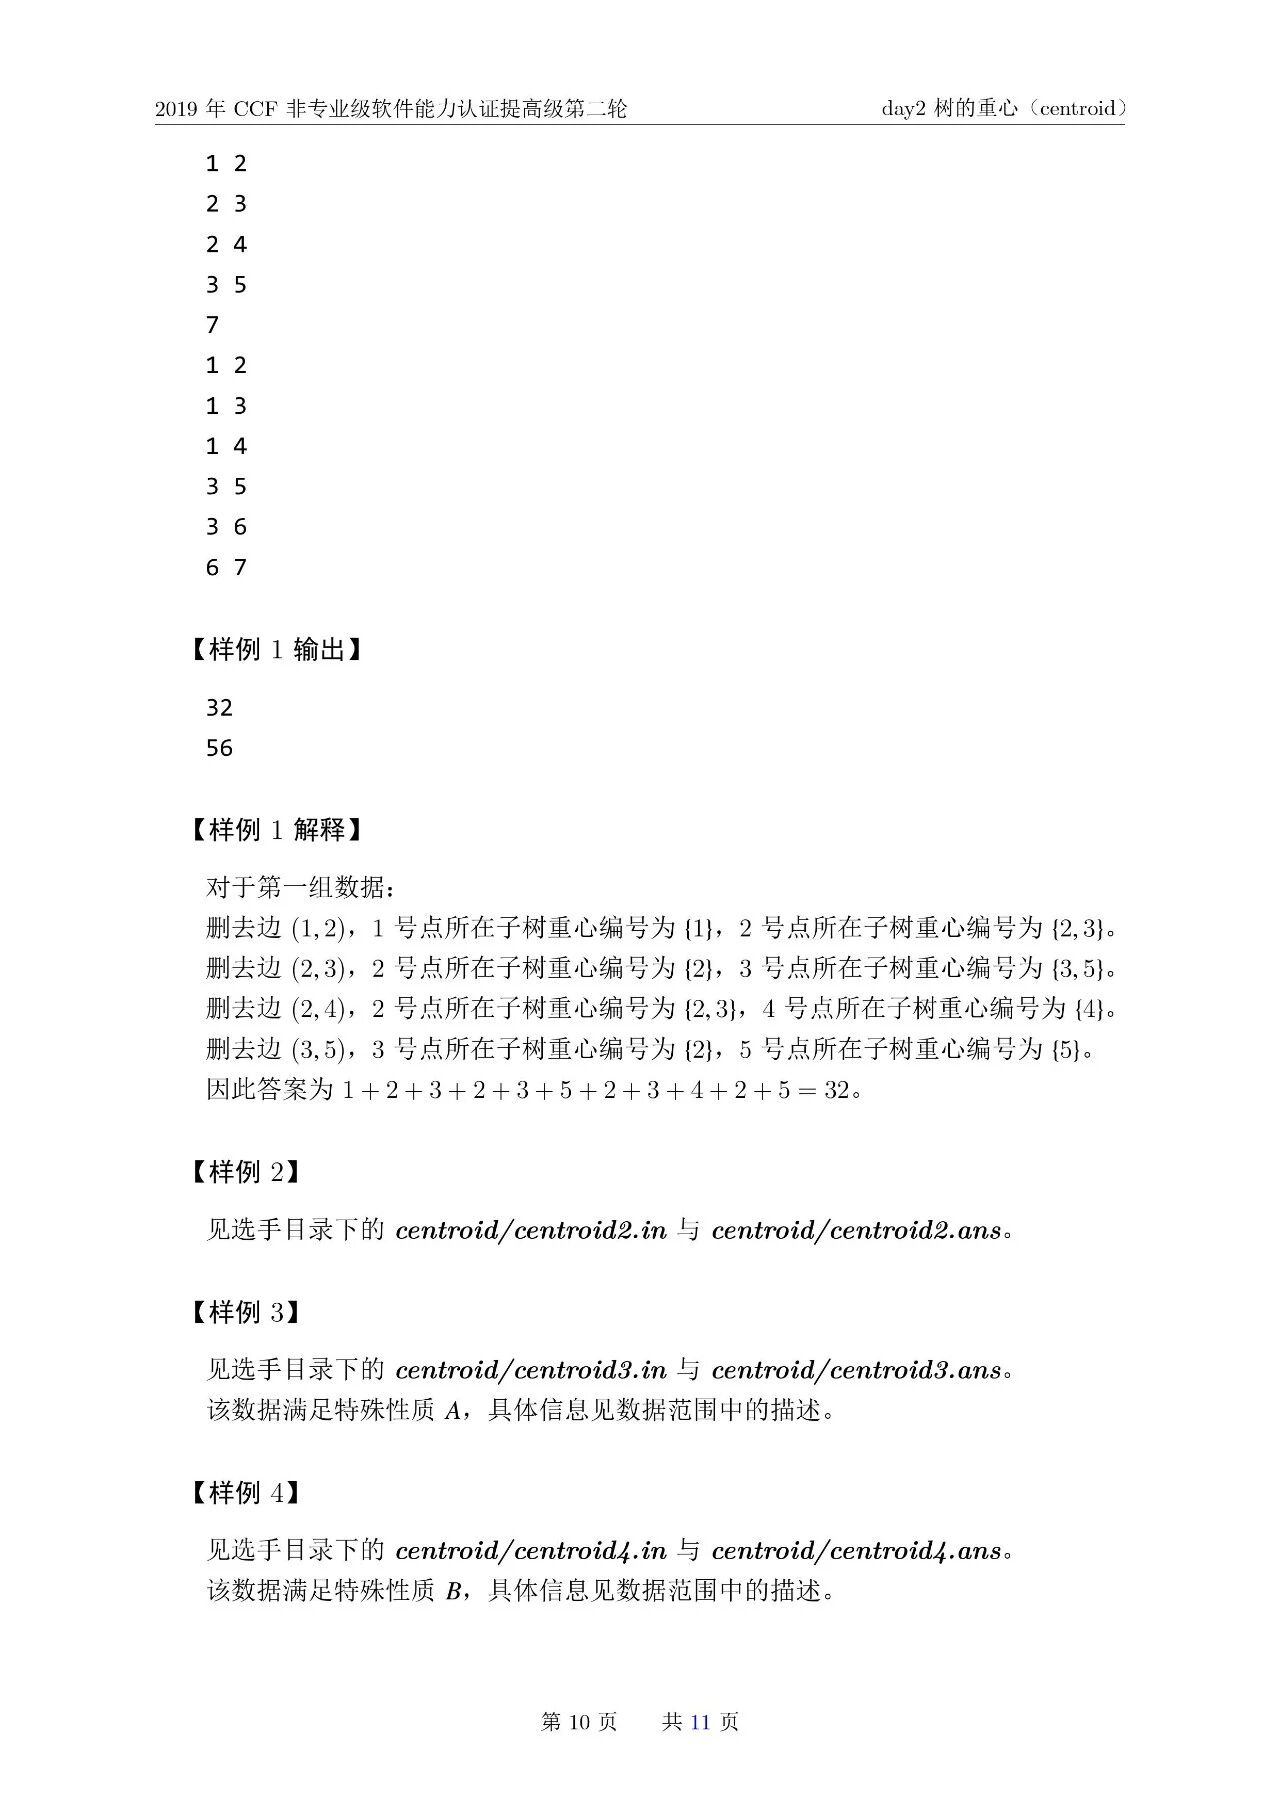
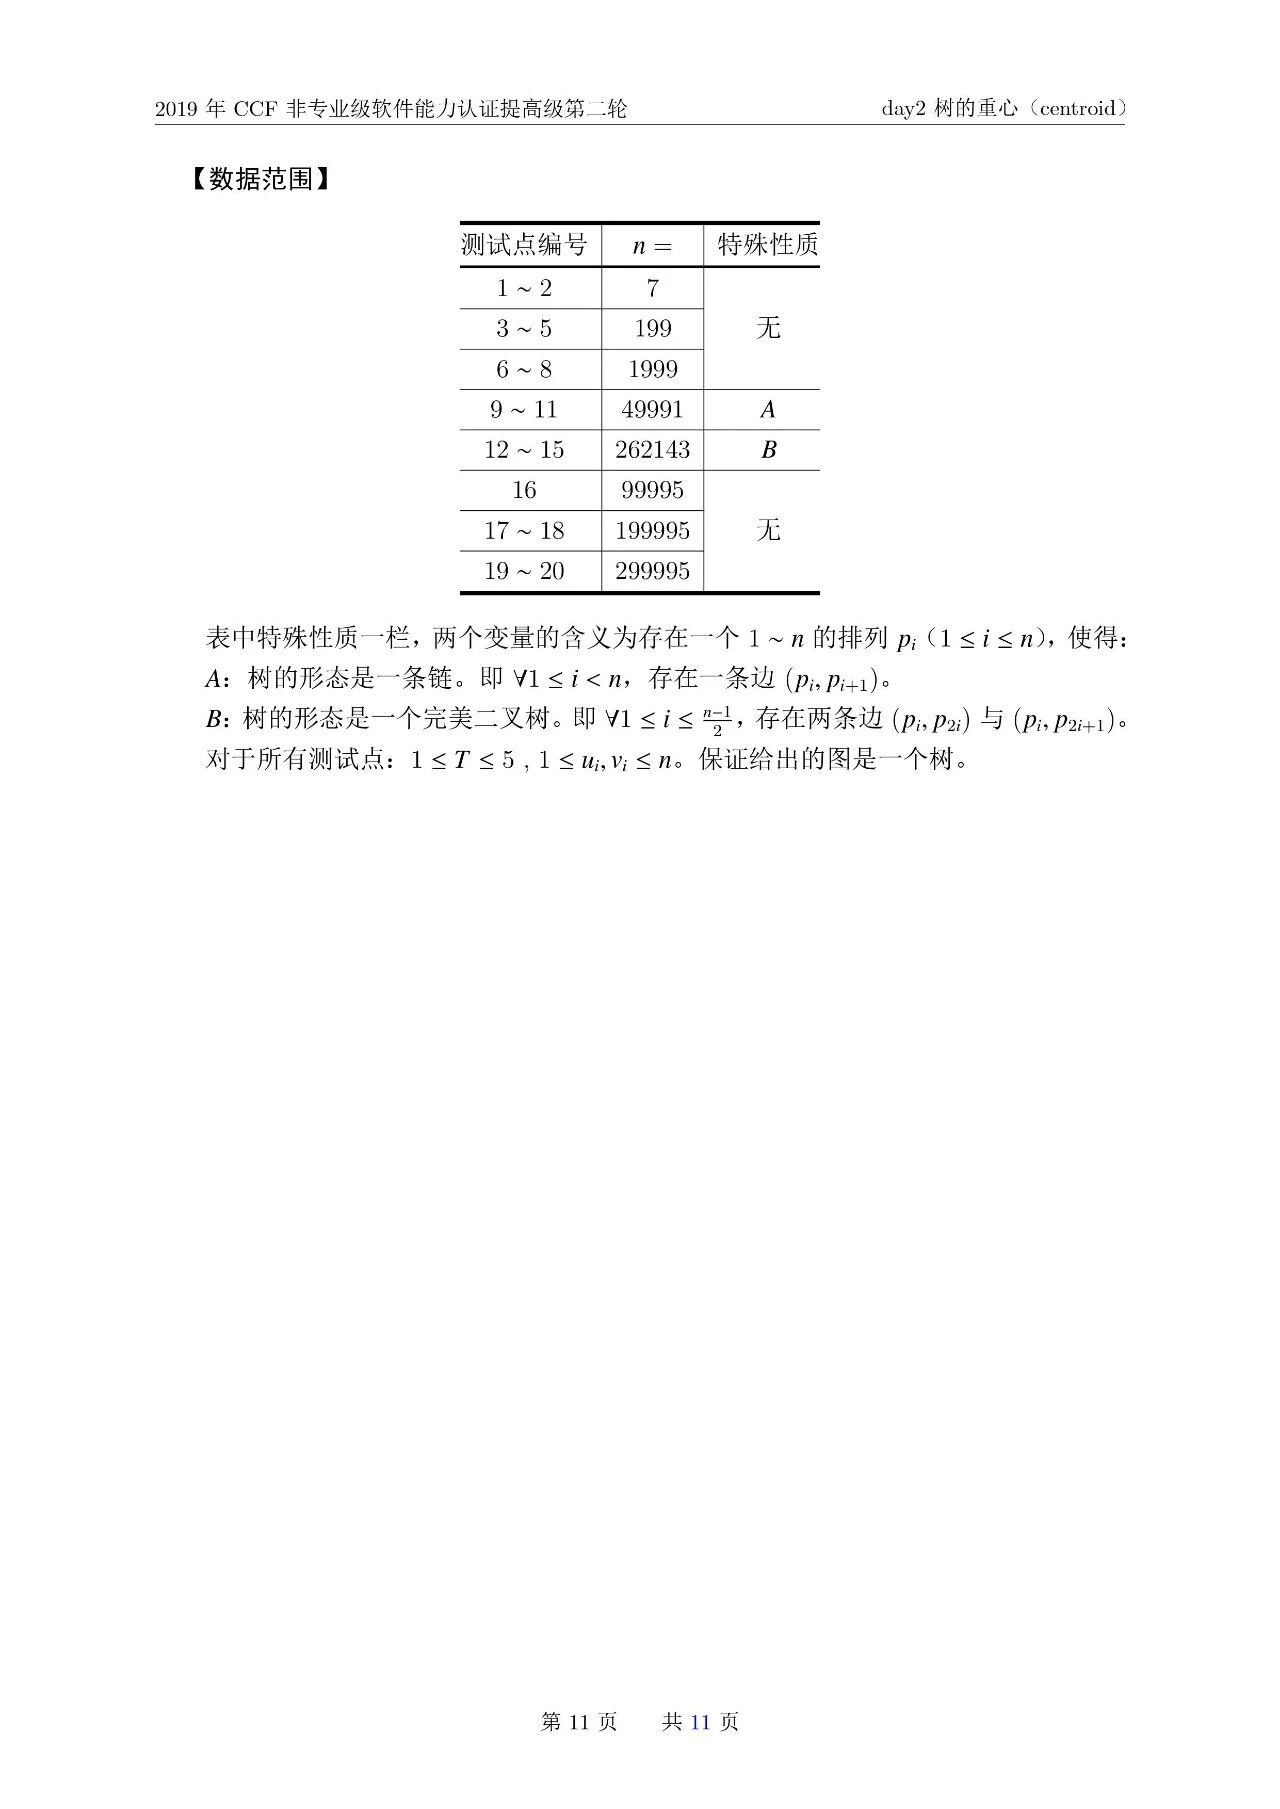
day2-3 树的重心


查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include &lt;bits/stdc++.h&gt; using namespace std; typedef long long ll; const int MAXN = 3e5 + 10; vector&lt;int&gt; adj[MAXN]; // 计算以u为根,排除exclude节点的子树大小 int compute_size(int u, int parent, int exclude) {     int s = 1;     for (int v : adj[u]) {         if (v != parent &amp;&amp; v != exclude) {             s += compute_size(v, u, exclude);         }     }     return s; } // 查找以root为根,排除exclude节点的子树的所有重心 vector&lt;int&gt; find_centroids(int root, int exclude, int total_size) {     vector&lt;int&gt; centroids;     function&lt;void(int, int, int&amp;)&gt; dfs = [&amp;](int u, int p, int&amp; current_size) {         current_size = 1;         int max_sub = 0;         for (int v : adj[u]) {             if (v != p &amp;&amp; v != exclude) {                 int child_size = 0;                 dfs(v, u, child_size);                 current_size += child_size;                 max_sub = max(max_sub, child_size);             }         }         max_sub = max(max_sub, total_size-current_size);         if (max_sub &lt;= total_size / 2) {             centroids.push_back(u);         }     };     int dummy = 0;     dfs(root, exclude, dummy);     return centroids; } ll solve() {     int n;     cin &gt;&gt; n;     for (int i = 1; i &lt;= n; ++i) adj[i].clear();     vector&lt;pair&lt;int, int&gt;&gt; edges;     for (int i = 0; i &lt; n-1; ++i) {         int u, v;         cin &gt;&gt; u &gt;&gt; v;         adj[u].push_back(v);         adj[v].push_back(u);         edges.emplace_back(u, v);     }     ll ans = 0;     for (auto&amp; e : edges) {         int u = e.first, v = e.second;         // 计算分割后两个子树的大小         int s = compute_size(u, -1, v);         int t = n-s;         // 查找两个子树的重心         vector&lt;int&gt; c1 = find_centroids(u, v, s);         vector&lt;int&gt; c2 = find_centroids(v, u, t);         // 累加重心编号         for (int x : c1) ans += x;         for (int x : c2) ans += x;     }     return ans; } int main() {     ios::sync_with_stdio(false);     cin.tie(0);     int T;     cin &gt;&gt; T;     while (T--) {         cout &lt;&lt; solve() &lt;&lt; '\n';     }     return 0; }</pre><p><br/></p>
解析:

方法思路

1、子树大小计算:对于每条边,删除后会得到两个子树,需要分别计算这两个子树的大小。

2、重心查找:对于每个子树,遍历其所有节点,判断每个节点是否为该子树的重心。判断条件是:删除该节点后,其所有子树的大小(包括父方向的子树)均不超过子树总大小的一半。

3、遍历所有边:对每条边,分别处理分割后的两个子树,找到各自的重心并求和,最终累加所有边的结果。

代码解释

1、compute_size函数:计算以u为根,排除exclude节点的子树大小。通过递归遍历子树,累加所有子节点的大小(排除父节点和exclude节点)。

2、find_centroids函数:查找以root为根,排除exclude节点的子树的所有重心。使用深度优先搜索(DFS)遍历子树,计算每个节点的最大子树大小(包括父方向的子树大小),判断是否为重心。

3、solve函数:处理每组测试用例,读取树的结构,遍历每条边,计算分割后两个子树的大小,查找各自的重心并累加结果。

该方法通过递归和深度优先搜索高效处理每个子树的重心查找,确保了时间复杂度在合理范围内,能够处理题目给定的数据规模。