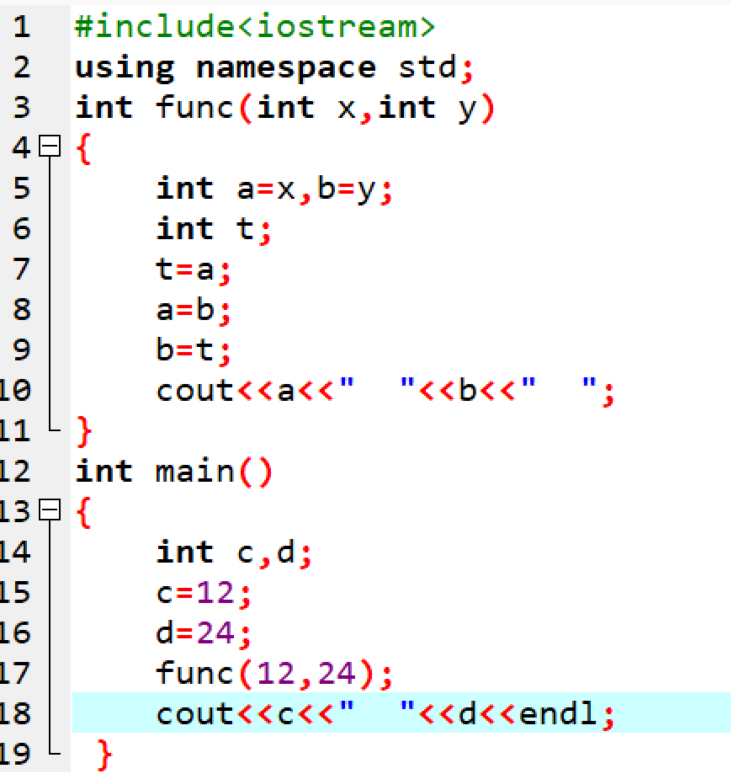
下列代码中,输出结果是( )

查看答案与解析
模拟一下func()函数的过程,可以发现它将变量x和y的值进行了交换,而传入的x、y的分别是12和24,交换之后便是24和12,因此前两个数输出24和12,后两个数字就是顺序输出的c、d的值,也就是12和24。
下列代码中,输出结果是( )

模拟一下func()函数的过程,可以发现它将变量x和y的值进行了交换,而传入的x、y的分别是12和24,交换之后便是24和12,因此前两个数输出24和12,后两个数字就是顺序输出的c、d的值,也就是12和24。
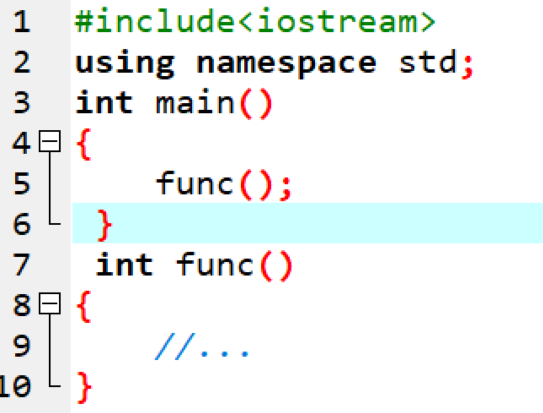
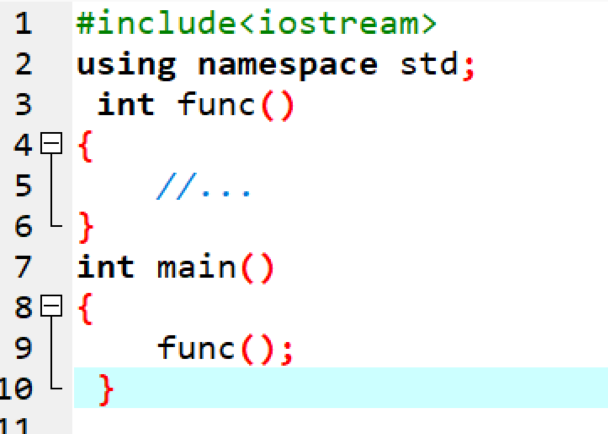
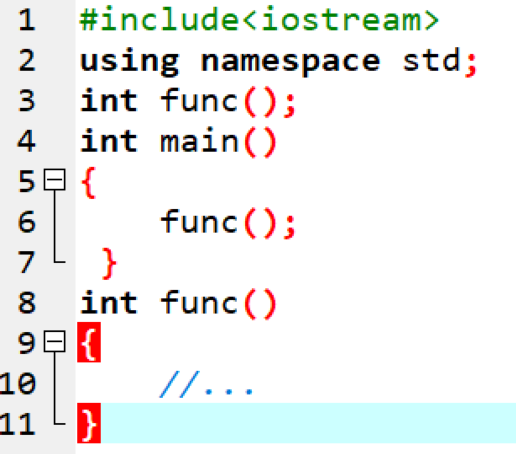
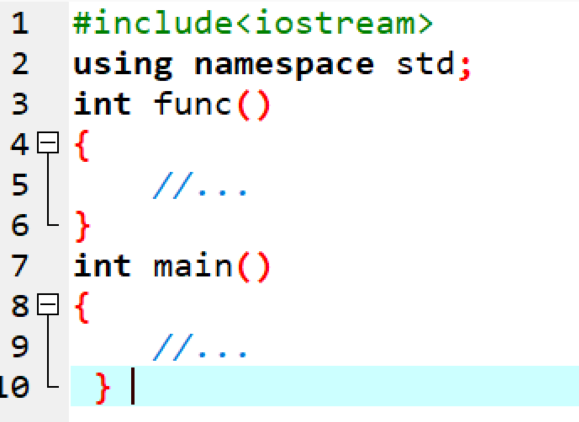
下面函数不能正常执行的是()
在调用函数之前,应该先定义函数。
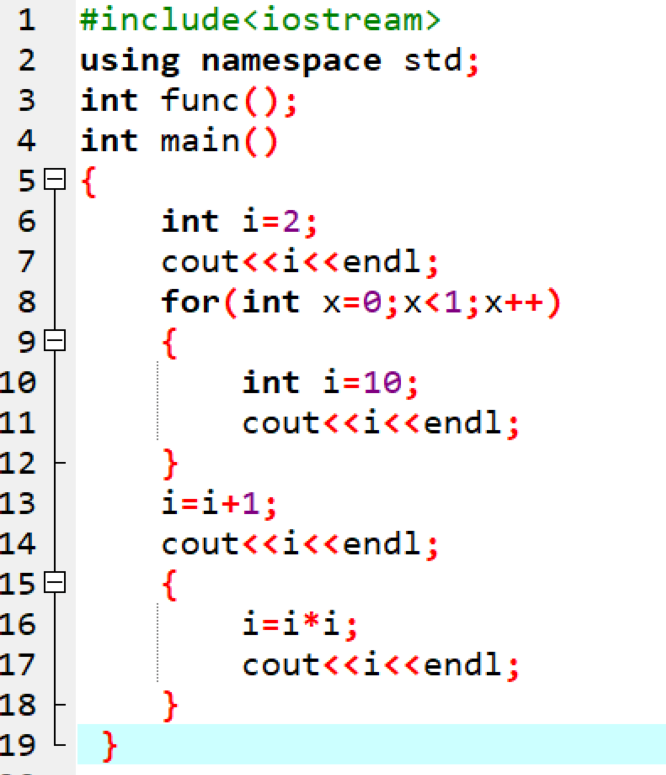
下面程序输出的是()

注意for循环内部的变量i只作用于for循环内部,因此第二个输出的数应该是10;而第6行的变量i的作用域则不包含for循环内部的部分,因此第3、4个数的值取决于第6行变量i的初始值,模拟计算一下即可。
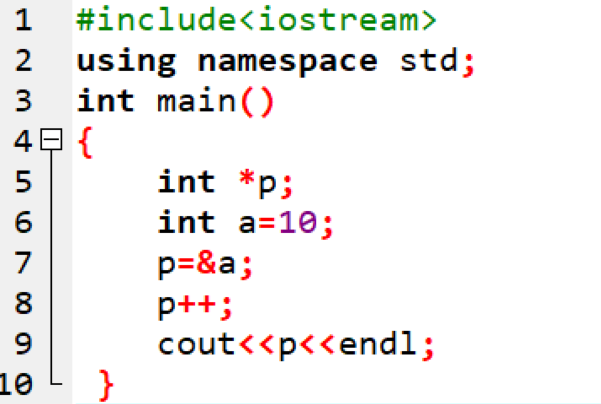
假设变量 a 的地址是0x6ffe14,下面程序的输出是( )。

一个int变量占4字节,因此当指针p移动到下一个地址时,应当加上对应的字节数4。
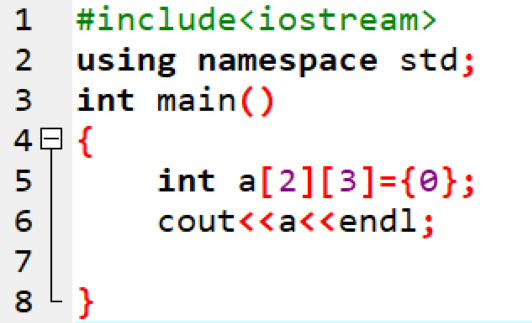
如果下列程序输出的地址是 0x6ffe00 ,则 cout<<a+1<<endl; 输出的是()

一个int变量占4字节,而a是一个2*3规模的二维数组,相当于是2个3长度的一维数组;a的地址是第0个数组的第0个元素的地址,而a+1的地址是第1个数组的第0个元素的地址;中间间隔了3个int变量,因此应当加上对应的总字节数12。
C++中,关于文件路径说法错误的是()
当“GESP.txt”文件前面没有其他前置路径的时候,其表示的意思就是与当前⼯作⽬录中的程序⽂件相同⽬录中的GESP.txt⽂件
关于直接插入排序,下列说法错误的是()
就地排序只需要O(1)的额外空间。
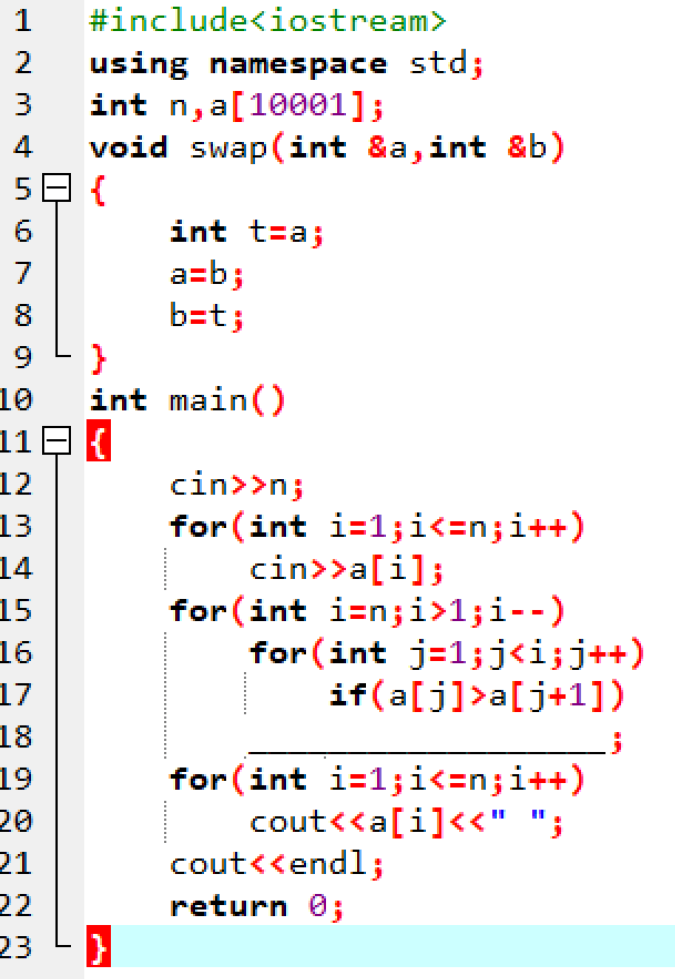
下列程序横线处,应该输入的是 ( )。

考察冒泡排序的过程,不断地把较大的值往后放,因此,如果a[j]>a[j+1]成立,说明a[j]是较大的值,应当通过交换操作来将a[j]换到后面去。
下面关于递推的说法不正确的是( )。
自己调用自己是递归的表现,而不是递推,注意区分。
关于几种排序算法的说法,下面说法错误的是( )。
在冒泡排序中,两个元素交换的条件是a[j]>a[j+1],如果两个元素的值相等,他们并不会发生交换,因此是一种稳定的排序算法。
数组{45,66,23,1,10,97,52,88,5,33}进行从小到大冒泡排序过程中,第一遍冒泡过后的序列是( )。
按照冒泡排序的过程模拟一遍即可,66会被一直交换到97的前面的位置,97会被一直交换到数组末尾的位置。
下面的排序算法程序中,横线处应该填入的是( )。
考察插入排序的过程,不断地将a[i]与前面的数字比较,以便找到合适的位置插入进去;因此,在已排好序的部分中,所有比a[i]大的数字都要整体往右移动一个单位;若a[j]比a[i]大,那么它往右移动一个单位之后的位置是j+1,所以应该将a[j]赋值给a[j+1]。
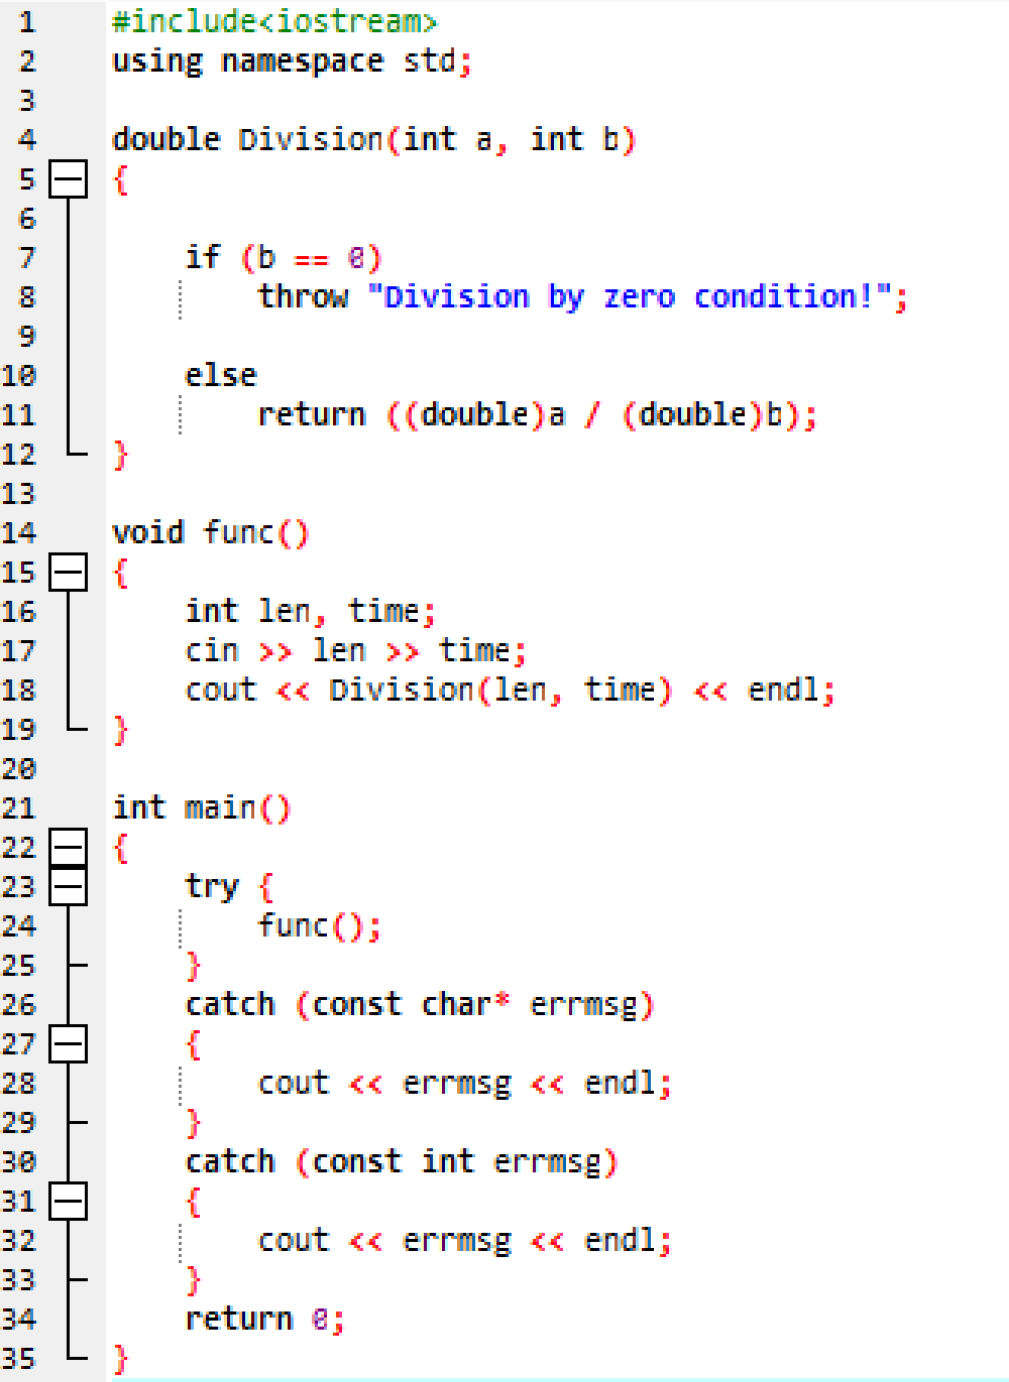
下面的程序中,如果输入 10 0 ,会输出( )。

输入len=10与time=0,分别传入Division()函数中的a、b,于是有a=10、b=0,条件b==0成立。
10条直线,最多可以把平面分为多少个区域( )。
当第x条直线加入进来的时候,我们总有一种贪心的方法,让这条直线与前面的所有x-1条直线相交,每发生一次相交都会额外产生一个区域,因此会产生x-1个区域,再加上整个平面本身会被分割一次,所以会产生x个区域,于是10条直线能够分割出来的区域数量就是1+2+3+4+5+6+7+8+9+10=55,最后不要忘记整个平面本身最初也有一个区域,所以还要加1,答案是55+1=56。
下面程序中,如果语句 cout<<p<<endl; 输出的是 0x6ffe00 ,则 cout<<++p<<endl; 输出的是()
一个int变量占4字节,p指针指向了x数组的首地址,因此,在++p之后,p指针移动到了下一个元素的地址,需要加上对应的int变量的字节数。
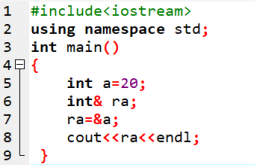
int& a 和 &a 是一样的,都是取 a 的地址。
&a是取a的地址,而int& a 是引用变量,作用是获取某个变量的“引用”,即给某一个变量起一个别名。
以下代码不能够正确执行。

同上一题,int& ra 是引用变量,需要在定义时设置一个初始值。
引用是一个指针常量。
指针常量指向的内存地址无法修改,而指向的内存地址对应的值可以修改。
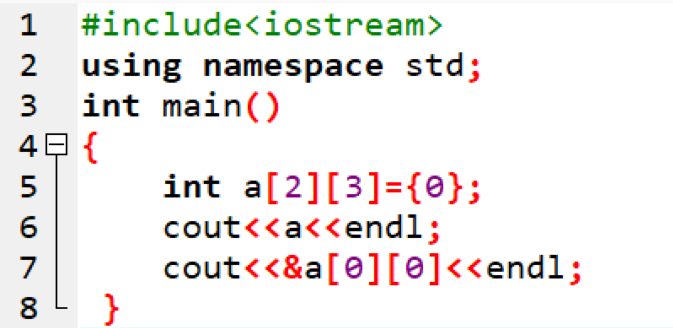
下面程序两个输出结果是一样的。

输出a即直接输出数组a的首地址,而a[0][0]是数组a的第0个元素,因此&a[0][0]相当于就是取了第0个元素的地址,即首地址。
函数不可以调用自己。
递归算法的实现就是“函数调用自己”。
函数参数传递过程中,如果传常量值、常量引用和常量指针都是不能被修改的,它们可以防止函数对实参的值或地址进行修改。
常量无法被修改,因此若想要实参的值不被修改,传入常量即可。
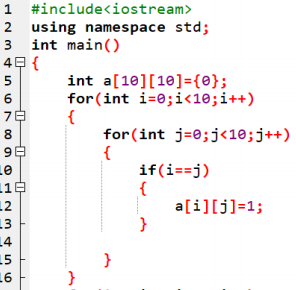
下面代码输出的值等于0。

在下面这个程序里, a[i][j] 和一个普通的整型变量一样使用。

一个一维数组,至少含有一个自然数N,是一个合法的数列。可以在一维数组末尾加入一个自然数M,M不能超过一维数组末尾元素的一半,形成一个新的合法的一维数组,如果N=6,那么可以有6个不同的合法数组。
合法的6个数组分别是{6}、{6,1}、{6,2}、{6,3}、{6,3,1}、{6,2,1}
插入排序算法中,平均时间复杂度是 ,最坏的情况逆序情况下,达到最大时间复杂度。
在最坏的逆序情况下,每一个元素都会被插入到已排好序部分的最前面。
黑白方块
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨有一个n行m列的网格图,其中每个格子要么是白色,要么是黑色。
对于网格图中的一个子矩形,小杨认为它是平衡的当且仅当其中黑色格子与白色格子数量相同。
小杨想知道最大的平衡子矩形包含了多少个格子。
输入格式
第一行包含两个正整数n,m,含义如题面所示。
之后n行,每行一个长度为m的01串,代表网格图第i行格子的颜色,如果为0,则对应格子为白色,否则为黑色。
输出格式
输出一个整数,代表最大的平衡子矩形包含格子的数量,如果不存在则输出0。
输入样例
输出样例
样例解释
对于样例1,假设(i,j) 代表第i行第j列,最大的平衡子矩形的四个顶点分别为(1,2),(1,5),(4,2),(4,5)。
数据范围
对于全部数据,保证有 1≤n,m≤10。
首先解决 “如何判断一个矩阵 a是一个平衡矩阵”这个问题:枚举矩阵中的每一个元素,用两个计数器a[0]、a[1]分别记录0和1的数量,如果最终a[0]==a[1],那么就是平衡矩阵,复杂度是O(n^2)。
然后解决“如何枚举一个矩阵中的所有子矩阵”这个问题:对于任意一个子矩阵,它都有一个起始行、一个终止行、一个起始列和一个终止列,我们可以用4个for循环来分别枚举它们,这样就应该把每个子矩阵确定下来,复杂度是O(n^4)。
如此一来,我们便可以用O(n4)的复杂度枚举每一个子矩阵,然后再花O(n2)的复杂度判断是否是平衡矩阵,总体时间复杂度为O(n^6)。
宝箱
时间限制:1.0 s
内存限制:512.0 MB
题面描述
小杨发现了n个宝箱,其中第i个宝箱的价值是ai。
小杨可以选择一些宝箱放入背包并带走,但是小杨的背包比较特殊,假设小杨选择的宝箱中最大价值为x,最小价值为y,小杨需要保证x−y≤k,否则小杨的背包会损坏。
小杨想知道背包不损坏的情况下,自己能够带走宝箱的总价值最大是多少。
输入格式
第一行包含两个正整数n,k,含义如题面所示。
第二行包含n个正整数a1,a2,...,an,代表宝箱的价值。
输出格式
输出一个整数,代表带走宝箱的最大总价值。
输入样例
输出样例
样例解释
在背包不损坏的情况下,小杨可以拿走两个价值为2的宝箱和一个价值为3的宝箱。
数据范围
对于全部数据,保证有1≤n≤1000,0≤k≤1000,1≤ai≤1000。
比较容易想到的做法是用O(n)的复杂度枚举一个a[i]作为最大值x,然后用O(n)的复杂度枚举另一个值a[j]作为最小值y,最后用O(n)的复杂度枚举数组,计算一下值处于[x,y]的元素总和sum,算出来的总和与ans取最大值即可,但是这样的做法是O(n^3)的,没有办法拿到满分;
我们发现,之所以我们最后需要O(n)的复杂度枚举数组的元素计算总和,是因为我们不知道数值处在[x,y]范围内的元素总和是多少,所以需要枚举计算。
为了解决这个问题,我们可以先将数组从小到大排序,这样一来,数组中的每个子区间[j,i]的左右端点的值a[j]、a[i]分别就对应了我们枚举的最小值x,和最大值y,又因为数组是有序的,因此,数值处于[x,y]范围内的元素正好就是区间[j,i]内的所有元素,这样一来,我们就可以在向前枚举a[j](也就是最小值y)的同时,顺便计算区间[j,i]内的元素总和sum,时间复杂度降为了O(n^2)。