首页 › 试卷 › GESP编程能力等级认证 › GESP-C++五级 › 2024年6月CCF-GESP编程能力等级认证C++编程五级真题

2024年6月CCF-GESP编程能力等级认证C++编程五级真题 VIP

GESP-C++五级 共 27 题 2024 年 含标准答案与解析
返回试卷列表
本页为整卷浏览:先自己做一遍,再展开「查看答案与解析」核对。

一、单选题

1. 单选题

下面C++代码用于求斐波那契数列,该数列第1、2项为1,以后各项均是前两项之和。函数fibo()属于( )。

int fibo(int n) {
	if (n <= 0)
		return 0;
	if (n == 1 || n == 2)
		return 1;
		
	int a = 1,b = 1, next;
	for (int i = 3; i <= n; i++) {
		next = a + b;
		a = b;
		b = next;
	}
	return next;
}
  • A 枚举算法
  • B 贪心算法
  • C 迭代算法
  • D 递归算法
查看答案与解析
答案:C
解析:

迭代算法:迭代算法是通过循环实现的,每次迭代利用前面计算的结果来推导出下一个结果。在给定的C++代码中,使用了一个循环for (int i = 3; i <= n; i++) 来计算斐波那契数列第n 项的值,通过迭代更新a 和b的值,直到计算出第n 项的值并返回。
2. 单选题

下面C++代码用于将输入金额换成最少币种组合方案,其实现算法是( )。

#include <iostream>
using namespace std;

#define N_COINS 7
int coins[N_COINS] = {100, 50, 20, 10, 5, 2, 1}; //货币面值,单位相同
int coins_used[N_COINS];

void find_coins(int money) {
	for (int i = 0; i < N_COINS; i++) {
		coins_used[i] = money / coins[i];
		money = money % coins[i];
	}
	return;
}
int main() {
	int money;
	cin >> money; //输入要换算的金额
	
	find_coins(money);
	for (int i = 0; i < N_COINS; i++)
		cout << coins_used[i] << endl;
		
	return 0;
}
  • A 枚举算法
  • B 贪心算法
  • C 迭代算法
  • D 递归算法
查看答案与解析
答案:B
解析:

贪心算法:贪心算法是一种在每一步选择中都采取当前状态下最优(最有利)的选择,以期望最终能够达到全局最优解。在这段代码中,每次循环都选择当前面值最大的硬币进行尽可能多的使用,从而达到最少硬币数量的组合方案。

算法实现分析:

数组coins 存储了面值从大到小的硬币面额{100, 50, 20, 10, 5, 2, 1}。

函数find_coins() 中使用了一个循环遍历所有硬币面额。在每次循环中,计算当前金额money 可以使用的当前面额硬币数量,并更新剩余金额money。

循环结束后,coins_used 数组存储了每种面额硬币的使用数量,以达到组合最少硬币数量的目的。

选择最优:由于每次都选择当前最大面额的硬币,贪心算法能够在保证每次选择最优的情况下,快速得到全局最优解,即使用最少数量的硬币来组合金额。

根据代码实现方式和贪心算法的特性,这段C++代码确实属于贪心算法。

3. 单选题

小杨采用如下双链表结构保存他喜欢的歌曲列表:

struct dl_node {
	string song;
	dl_node* next;
	dl_node* prev;
};

小杨想在头指针为 head 的双链表中查找他喜欢的某首歌曲,采用如下查询函数,该操作的时间复杂度为( )。

dl_node* search(dl_node* head, string my_song) {
	dl_node* temp = head;
	while (temp != nullptr) {
		if (temp->song == my_song)
			return temp;
		temp = temp->next;
	}
	return nullptr;
}
  • A O(1)
  • B O(n)
  • C O(logn)
  • D O(n2)
查看答案与解析
答案:B
解析:

该查询函数的时间复杂度为O(n),其中n是双链表中节点的数量。

函数使用一个指针temp从头指针head开始,沿着双链表向后遍历。

在每个节点处,它检查节点中的歌曲名称是否与目标歌曲my_song匹配。

最坏情况下,如果目标歌曲不在双链表中或者在最后一个节点才找到,那么需要遍历整个双链表,因此时间复杂度为O(n)

这是因为在最坏情况下,需要遍历所有n个节点才能确定目标歌曲是否存在。

4. 单选题

小杨想在如上题所述的双向链表中加入一首新歌曲。为了能快速找到该歌曲,他将其作为链表的第一首歌曲,则下面横线上应填入的代码为( )。

void insert(dl_node *head, string my_song) {
	p = new dl_node;
	p->song = my_song;
	p->prev = nullptr;
	p->next = head;
	
	if (head != nullptr) {
		________________________________ // 在此处填入代码
	}
	head = p;
}
  • A head->next->prev = p;
  • B head->next = p;
  • C head->prev = p;
  • D 触发异常,不能对空指针进行操作。
查看答案与解析
答案:C
解析:

在将p 插入后,先前的头节点(head)必须更新其prev 指针,指向新的头节点p,以保持双向链表的结构:

p->next 指向先前的头节点head。head->prev 指向新的头节点p。

5. 单选题

下面是根据欧几里得算法编写的函数,它计算的是 与 的( )。

int gcd(int a, int b) {
	while (b != 0) {
		int temp = b;
		b = a % b;
		a = temp;
	}
	return a;
}
  • A 最小公倍数
  • B 最大公共质因子
  • C 最大公约数
  • D 最小公共质因子
查看答案与解析
答案:C
解析:

欧几里得算法,也称为辗转相除法,用于计算两个非负整数的最大公约数。

在函数中,通过循环不断将b 更新为a 除以b 的余数,直到b 变为0。此时a 的值就是最大公约数。

函数最终返回的是变量a 的值,即为输入的两个整数a 和b 的最大公约数。

因此,根据给出的函数实现和算法特性,函数gcd(int a, int b) 计算的是两个整数的最大公约数。

所以,答案是C.最大公约数。

6. 单选题

欧几里得算法还可以写成如下形式:

int gcd(int a, int b) {
	return b == 0 ? a : gcd(b, a % b);
}

下面有关说法,错误的是( )。

  • A 本题的 gcd() 实现为递归方式。
  • B 本题的 gcd() 代码量少,更容易理解其辗转相除的思想。
  • C 当a较大时,本题的 gcd() 实现会多次调用自身,需要较多额外的辅助空间。
  • D 当a较大时,相比上题中的 gcd() 的实现,本题的 gcd() 执行效率更高。
查看答案与解析
答案:D
解析:

递归实现的gcd()函数并不比非递归实现的效率更高。两者的时间复杂度是相同的,选择使用哪种实现通常更依赖于个人或特定环境下的偏好或要求。

7. 单选题

下述代码实现素数表的线性筛法,筛选出所有小于等于 的素数,则横线上应填的代码是( )。

vector<int> linear_sieve(int n) {
	vector<bool> is_prime(n + 1, true);
	vector<int> primes;
	is_prime[0] = is_prime[1] = 0; //0和1两个数特殊处理
	for (int i = 2; i <= n; ++i) {
		if (is_prime[i]) {
			primes.push_back(i);
		}
		________________________________ { // 在此处填入代码
			is_prime[i * primes[j]] = 0;
			if (i % primes[j] == 0)
				break;
		}
	}
	return primes;
}
  • A or (int j = 0; j < primes.size() && i * primes[j] <= n; j++)
  • B for (int j = 0; j <= sqrt(n) && i * primes[j] <= n; j++)
  • C for (int j = 0; j <= n; j++)
  • D for (int j = 1; j <= sqrt(n); j++)
查看答案与解析
答案:A
解析:

使用for (int j = 0; j < primes.size() && i * primes[j] <= n; j++) 这个循环来遍历当前已知的素数列表primes,确保了我们使用当前素数i 来乘以已知素数primes[j],并且正确地筛选掉不超过n 的合数。

8. 单选题

上题代码的时间复杂度是( )。

  • A O(n2)
  • B O(nlogn)
  • C O(nloglogn)
  • D O(n)
查看答案与解析
答案:D
解析:

linear_sieve 函数的主要执行部分是主循环,(for (int i = 2; i <= n; ++i)):主循环从2到n进行遍历,因此有O(n)次迭代

9. 单选题

为了正确实现快速排序,下面横线上的代码应为( )。

void qsort(vector<int>& arr, int left, int right) {
	int i, j, mid;
	int pivot;
	
	i = left;
	j = right;
	mid = (left + right) / 2; // 计算中间元素的索引
	pivot = arr[mid]; // 选择中间元素作为基准值
	
	do {
		while (arr[i] < pivot) i++;
		while (arr[j] > pivot) j--;
		if (i <= j) {
			swap(arr[i], arr[j]); // 交换两个元素
			i++; j--;
		}
	} ________________________________; // 在此处填入代码
	if (left < j) qsort(arr, left, j); // 对左子数组进行快速排序
	if (i < right) qsort(arr, i, right); // 对右子数组进行快速排序
}
  • A while (i <= mid)
  • B while (i < mid)
  • C while (i < j)
  • D while (i <= j)
查看答案与解析
答案:D
解析:

快速排序的分区过程中,我们使用两个指针i和j分别从左到右和从右到左遍历数组,将小于基准值的元素放到基准值的左边,大于基准值的元素放到右边。

具体的分区过程如下:

首先选择一个基准值pivot,通常选择中间元素arr[mid]。

使用两个指针i和j,分别从数组的左右两端开始向中间移动。

i从左向右移动,直到找到一个大于或等于pivot的元素。

j从右向左移动,直到找到一个小于或等于pivot的元素。

如果i <= j,则交换arr[i]和arr[j],然后i向后移动一位,j向前移动一位。

重复步骤2和3,直到i大于j,此时所有小于等于pivot的元素都在pivot的左边,所有大于等于pivot的元素都在pivot的右边。

在填写横线上的代码时,应该使用while (i <= j),因为分区过程应该持续进行直到i超过j,这样保证了整个分区过程的完成。

10. 单选题

关于分治算法,以下哪个说法正确?

  • A 分治算法将问题分成子问题,然后分别解决子问题,最后合并结果。
  • B 归并排序不是分治算法的应用。
  • C 分治算法通常用于解决小规模问题。
  • D 分治算法的时间复杂度总是优于 O(nlog(n))。
查看答案与解析
答案:A
解析:

分治算法的基本思想是将原问题分解成若干个规模较小但结构与原问题相似的子问题,递归地求解这些子问题,然后再合并其结果,得到原问题的解。

11. 单选题

根据下述二分查找法,在排好序的数组 1,3,6,9,17,31,39,52,61,79,81,90,96 中查找数值82,和82比较的数组元素分别是( )。

int binary_search(vector<int>& nums, int target) {
	int left = 0;
	int right = nums.size() - 1;
	while (left <= right) {
		int mid = (left + right) / 2;
		if (nums[mid] == target) {
			return mid;
		} else if (nums[mid] < target) {
			left = mid + 1;
		} else {
			right = mid - 1;
		}
	}
	return -1; // 如果找不到目标元素,返回-1
}
  • A 52, 61, 81, 90
  • B 52, 79, 90, 81
  • C 39, 79, 90, 81
  • D 39, 79, 90
查看答案与解析
答案:C
解析:

第一次迭代:

left = 0, right = 12,数组范围是整个数组。

mid = (0 + 12) / 2 = 6,即中间元素是39。

nums[mid] = 39,小于目标值82,所以更新 left = mid + 1 = 7。

第二次迭代:

left = 7, right = 12,数组范围缩小到[52, 61, 79, 81, 90, 96]。

mid = (7 + 12) / 2 = 9,即中间元素是79。

nums[mid] = 79,小于目标值82,所以更新 left = mid + 1 = 10。

第三次迭代:

left = 10, right = 12,数组范围缩小到[81, 90, 96]。

mid = (10 + 12) / 2 = 11,即中间元素是90。

nums[mid] = 90,大于目标值82,所以更新 right = mid - 1 = 10。

第四次迭代:

left = 10, right = 10,即只剩下一个元素81。

mid = (10 + 10) / 2 = 10,即中间元素是81。

nums[mid] = 81,小于目标值82,所以更新 left = mid + 1 = 11。

根据上述分析,与目标值82进行比较的数组元素依次是:39, 79, 90, 81

12. 单选题

要实现一个高精度减法函数,则下面代码中加划线应该填写的代码为( )。

//假设a和b均为正数,且a表示的数比b大
vector<int> minus(vector<int> a, vector<int> b) {
	vector<int> c;
	int len1 = a.size();
	int len2 = b.size();
	int i, t;
	
	for (i = 0; i < len2; i++) {
		if (a[i] < b[i]) { //借位
			_____________ // 在此处填入代码
			a[i] += 10;
		}
		t = a[i] - b[i];
		c.push_back(t);
	}
	for (; i < len1; i++)
		c.push_back(a[i]);
		
	len3 = c.size();
	while (c[len3 - 1] == 0) {//去除前导0
		c.pop_back();
		len3--;
	}
	return c;
}
  • A a[i + 1]–;
  • B a[i]–;
  • C b[i + 1]–;
  • D b[i]–;
查看答案与解析
答案:A
解析:

当a[i] < b[i] 时,表示当前位需要借位。a[i + 1]-- 将下一位a[i + 1] 的值减一,以便在当前位进行借位操作。

13. 单选题

设A和B是两个长度为n的有序数组,现将A和B合并成一个有序数组,归并排序算法在最坏情况下至少要做( )次比较。

  • A n2
  • B nlogn
  • C 2n−1
  • D n
查看答案与解析
答案:C
解析:

在最坏情况下,两个数组的元素需要逐个比较,直到其中一个数组的所有元素都放入新数组中。当一个数组的所有元素都被放入新数组后,剩下的数组中的元素不需要再与新数组中的元素比较,因此剩余的比较操作可以省略。因此,总的比较次数是n+(n−1),即2n−1

14. 单选题

给定如下函数:

int fun(int n) {
	if (n == 1) return 1;
	if (n == 2) return 2;
	return fun(n - 2) - fun(n - 1);
}

则当 n = 7 n=7n=7 时,函数返回值为( )。

  • A 0
  • B 1
  • C 21
  • D -11
查看答案与解析
答案:D
解析:

函数的计算过程:

fun(1) 的返回值是 1。

fun(2) 的返回值是 2。

对于其他 n >= 3 的情况,函数递归地计算 fun(n):

fun(3) = fun(1) - fun(2) = 1 - 2 = -1

fun(4) = fun(2) - fun(3) = 2 - (-1) = 3

fun(5) = fun(3) - fun(4) = (-1) - 3 = -4

fun(6) = fun(4) - fun(5) = 3 - (-4) = 7

fun(7) = fun(5) - fun(6) = -4 - 7 = -11

根据递归定义,我们可以看出 fun(n) 的计算是基于前两个值的递归差值。

现在来解决问题,当 n = 7 时,函数 fun(7) 返回的值是 -11。

因此,正确答案是 -11。

15. 单选题

给定如下函数(函数功能同上题,增加输出打印):

int fun(int n) {
	cout << n << " ";
	if (n == 1) return 1;
	if (n == 2) return 2;
	return fun(n - 2) - fun(n - 1);
}

则当 n = 4 n=4n=4 时,屏幕上输出序列为( )。

  • A 4 3 2 1
  • B 1 2 3 4
  • C 4 2 3 1 2
  • D 4 2 3 2 1
查看答案与解析
答案:C
解析:

分析函数调用过程:

当n = 4 时,函数调用fun(4):

fun(4) 输出4,然后计算fun(2) - fun(3)。输出顺序为4。

fun(2) 输出2,然后返回2。输出顺序为4 2。

fun(3) 输出3,然后计算fun(1) - fun(2)。输出顺序为4 2 3.

fun(1) 输出1,然后返回1。输出顺序为4 2 3 1.

fun(2) 返回2,因为已经计算过,不再输出。输出顺序为4 2 3 1 2.

计算fun(3) = 1 - 2 = -1,返回-1。输出顺序为4 2 3 1 2.

计算fun(4) = 2 - (-1) = 3,返回3。输出顺序为4 2 3 1 2 4.

结论:

因此,当n = 4 时,屏幕上输出的序列是 4 2 3 1 2。

二、判断题

16. 判断题

如果将双向链表的最后一个结点的下一项指针指向第一个结点,第一个结点的前一项指针指向最后一个结点,则该双向链表构成循环链表。

  • A对
  • B错
查看答案与解析
答案:对
解析:

如果将双向链表的最后一个节点的next 指针指向第一个节点,同时第一个节点的prev 指针指向最后一个节点,那么这个双向链表就形成了一个循环链表

17. 判断题

数组和链表都是线性表,链表的优点是插入删除不需要移动元素,并且能随机查找。

  • A对
  • B错
查看答案与解析
答案:错
解析:

链表只能顺序访问。为了找到某个节点,需要从头节点开始遍历直到找到目标节点

18. 判断题

链表的存储空间物理上可以连续,也可以不连续。

  • A对
  • B错
查看答案与解析
答案:对
解析:

链表中的每个节点包含两部分信息:数据域(存储数据的部分)和指针域(指向下一个节点的指针)。这种指针连接方式使得链表的节点可以在内存中分布不连续,链表的节点可以根据内存管理系统的分配方式,分布在内存中的任何位置。每个节点的指针用于指向下一个节点,这种指针关系决定了链表的逻辑结构。因此,链表在物理存储上可以是连续的,也可以是不连续的,这取决于节点之间的指针关系,而不是在内存中的实际布局方式。

19. 判断题

找出自然数n以内的所有质数,常用算法有埃拉托斯特尼(埃氏)筛法和线性筛法,其中埃氏筛法效率更高。

  • A对
  • B错
查看答案与解析
答案:错
解析:

埃氏筛法是一种简单直观的质数筛选算法,适用于较小范围内的质数查找,随着 n 的增大,其效率会下降,因为需要标记的倍数越多。线性筛法是在埃氏筛法基础上的改进,效率更高。

20. 判断题

唯一分解定理表明任何一个大于1的整数都可以唯一地表示为一系列质数的乘积,即质因数分解是唯一的。

  • A对
  • B错
查看答案与解析
答案:对
解析:

一个整数可以有多种因数分解的方式(比如顺序不同),但其包含的质数因子及其指数是唯一确定的。

21. 判断题

贪心算法通过每一步选择局部最优解来获得全局最优解,但并不一定能找到最优解。

  • A对
  • B错
查看答案与解析
答案:对
解析:

它通常在每一步做出局部最优选择,并希望通过这种方式最终达到全局最优解。然而,并不是所有问题都适合使用贪心算法,并且即使某些问题可以使用贪心算法,它也不能保证一定能找到全局最优解。

22. 判断题

归并排序和快速排序都采用递归实现,也都是不稳定排序。( )(2024.6-5)

  • A对
  • B错
查看答案与解析
答案:错
解析:

归并排序是一种稳定的排序算法,快速排序是一种不稳定的排序算法

23. 判断题

插入排序有时比快速排序时间复杂度更低。

  • A对
  • B错
查看答案与解析
答案:对
解析:

插入排序在处理少量元素或部分有序数组时,由于其较低的时间复杂度可能比快速排序效率更高,而快速排序通常在处理大规模随机数据时表现更佳

24. 判断题

在进行全国人口普查时,将其分解为对每个省市县乡来进行普查和统计。这是典型的分治策略。

  • A对
  • B错
查看答案与解析
答案:对
解析:

分治策略的基本思想是将一个大问题分解为若干个小问题,然后分别解决这些小问题,最后将它们的解合并起来得到整体的解。在人口普查中,各个地区的普查可以看作是对小问题的解决,最后将各地的数据统计合并,得到全国的人口统计数据

25. 判断题

在下面C++代码中,由于删除了变量 ptr ,因此 ptr 所对应的数据也随之删除,故执行下述代码时,将报错。

int* ptr = new int(10);
cout << *ptr << endl;
delete ptr;
cout << ptr << endl;
  • A对
  • B错
查看答案与解析
答案:错
解析:

删除指针ptr并不会删除数据本身,只是释放了指针指向的动态内存

三、简答题

26. 简答题

黑白格

时间限制:1.0 s

内存限制:512.0 MB

题面描述

小杨有一个n行m列的网格图,其中每个格子要么是白色,要么是黑色。

小杨想知道至少包含k个黑色格子的最小子矩形包含了多少个格子。

输入格式

第一行包含三个正整数n,m,k,含义如题面所示。

之后n行,每行一个长度为m的01串,代表网格图第i行格子的颜色,如果为0,则对应格子为白色,否则为黑色。

输出格式

输出一个整数,代表至少包含k个黑色格子的最小子矩形包含格子的数量,如果不存在则输出0。


输入样例

4 5 5
00000
01111
00011
00011

输出样例

6

样例解释

对于样例1,假设(i,j) 代表第i 行第j列,至少包含5个黑色格子的最小子矩形的四个顶点为(2,4),(2,5),(4,4),(4,5),共包含6个格子。

数据范围

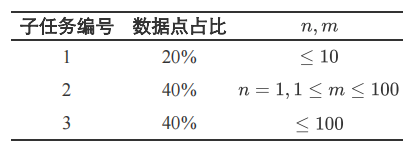
对于全部数据,保证有1≤n,m≤100,1≤k≤n×m。

查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include&lt;bits/stdc++.h&gt; using namespace std; const int N = 110; int w[N][N]; int sum[N][N]; int n,m; int main(){ int k; cin&gt;&gt;n&gt;&gt;m&gt;&gt;k; for(int i=1;i&lt;=n;i++){ string s; cin&gt;&gt;s; for(int j=1;j&lt;=m;j++){ w[i][j]=s[j-1]-'0'; sum[i][j]=sum[i][j-1]+w[i][j]; } } int ans = 0; for(int i=1;i&lt;=m;i++){ for(int j=i;j&lt;=m;j++){ vector&lt;int&gt; num; int now = 0; for(int l=1;l&lt;=n;l++){ int tmp = sum[l][j]-sum[l][i-1]; now+=tmp; num.push_back(now); if(now&gt;=k){ if(ans ==0)ans=(j-i+1)*l; else ans=min(ans,(j-i+1)*l); int L=1,R=l; while (L &lt; R){ int mid = L + R + 1 &gt;&gt; 1; if (now-num[mid-1]&gt;=k) L = mid; else R = mid - 1; } if(now-num[L-1]&gt;=k){ if(ans ==0)ans=(j-i+1)*(l-L); else ans=min(ans,(j-i+1)*(l-L)); } } } } } cout&lt;&lt;ans&lt;&lt;"\n"; }</pre>
解析:

1.二维数组存储对应格子颜色的值

2.使用前缀和的技巧来快速计算任意子矩形内的格子数量。这样一来,不需要重复遍历每个可能的子矩形来计算其中的黑色格子数,从而节省时间

3.通过检查每个可能的子矩形,计算其中的黑色格子数量。找到一个最小的子矩形,使得其中至少有 k 个黑色格子。

4.使用二分查找的技巧,在内部循环中快速定位满足条件的子矩形大小

5.最后,我们输出这个最小子矩形的面积。如果不存在满足条件的子矩形,则输出0

27. 简答题

小杨的幸运数字

时间限制:1.0 s

内存限制:512.0 MB

题面描述

小杨认为他的幸运数字应该恰好有两种不同的质因子,例如,12=2×2×3 的质因子有2,3,恰好为两种不同的质因子,因此12是幸运数字,而30=2×3×5 的质因子有2,3,5,不符合要求,不为幸运数字。

小杨现在有n个正整数,他想知道每个正整数是否是他的幸运数字。

输入格式

第一行包含一个正整数n,代表正整数个数。

之后n行,每行一个正整数。

输出格式

输出n行,对于每个正整数,如果是幸运数字,输出1,否则输出0。


输入样例

3
7
12
30

输出样例

0
1
0

样例解释

7的质因子有7,只有一种。

12的质因子有2,3,恰好有两种。 

30的质因子有2,3,5,有三种。

数据范围

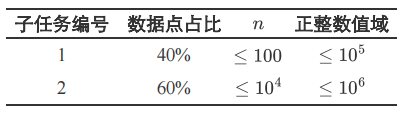
对于全部数据,保证有1≤n≤104,每个正整数ai满足2≤ai≤106。

查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include&lt;bits/stdc++.h&gt; using namespace std; map&lt;int,int&gt; mp; const int N = 1e5+10; int calc(int x) { int res = 0; set&lt;int&gt; s; for (int i = 2; i * i &lt;= x; i++) { if (x % i == 0) { s.insert(i); while (x% i == 0){ x/= i; } } } if (x != 1) { s.insert(x); } return (int)s.size(); } int a[N]; int main(){ int n; cin&gt;&gt;n; long long ans = 0; int pre = 0; for(int i=1;i&lt;=n;i++){ cin&gt;&gt;a[i]; int x = calc(a[i]); if(x==2)cout&lt;&lt;"1\n"; else cout&lt;&lt;"0\n"; } }</pre>
解析:

1.计算输入数据的质因子的个数。具体实现中,可以从最小的质数开始试除,统计不重复的质因子个数。

2.当质因子个数为2时,返回1表示是幸运数字,否则返回0。