首页 › 试卷 › GESP编程能力等级认证 › GESP-C++六级 › 2024年9月CCF-GESP编程能力等级认证C++编程六级真题

2024年9月CCF-GESP编程能力等级认证C++编程六级真题 VIP

GESP-C++六级 共 27 题 2024 年 含标准答案与解析
返回试卷列表
本页为整卷浏览:先自己做一遍,再展开「查看答案与解析」核对。

一、单选题

1. 单选题

以下( )没有涉及 C++ 语言的面向对象特性支持。

  • A C++ 中构造一个 class 或 struct
  • B C++ 中调用 printf 函数
  • C C++ 中调用用户定义的类成员函数
  • D C++ 中构造来源于同一基类的多个派生类
查看答案与解析
答案:B
解析:

C++的面向对象特性主要包括类(class)与结构体(struct)的定义、继承(inheritance)、封装(encapsulation)以及多态(polymorphism)等。

A.构造一个class或struct,这是面向对象编程的基本组成部分之一,它允许开发者定义自己的数据类型,这些类型可以包含数据成员和成员函数。因此,这显然涉及到C++的面向对象特性。

B.调用printf函数,并不是面向对象特性的体现。printf是一个标准库函数,用于格式化输出到标准输出设备(如屏幕)。它并不属于任何类的一部分,也不涉及到类、继承或多态的概念。

C.调用用户定义的类成员函数,这与面向对象编程密切相关,因为成员函数是类的一部分,用于操作类的数据成员或者实现类的行为。

D.构造来源于同一基类的多个派生类,这是继承的一个典型例子,是面向对象编程中的一个重要特性,允许创建新的类来重用现有类的代码。

因此,选项C++ 中调用printf函数 没有涉及C++语言的面向对象特性支持。
2. 单选题

关于以下C++代码,( )行代码会引起编译错误。

#include <iostream>
using namespace std;

class Base {
private:
	int a;
protected:
	int b;
public:
	int c;
	Base() : a(1), b(2), c(3) {}
};

class Derived : public Base {
public:
	void show() {
		cout << a << endl; // Line 1
		cout << b << endl; // Line 2
		cout << c << endl; // Line 3
	}
};


  • A Line 1
  • B Line 2
  • C Line 3
  • D 没有编译错误
查看答案与解析
答案:A
解析:

这段代码中定义了两个类,Base和从Base继承的Derived。在Derived类中有一个show()成员函数,试图输出基类中定义的a, b, 和c的值。

根据C++的访问规则:

私有(private)成员只能由声明它的类的成员函数访问。

保护(protected)成员可以被该类及其派生类的成员函数访问。

公有(public)成员可以被任何地方访问。

具体来看:

a是Base类中的私有成员,所以不能在派生类Derived中直接访问。

b是Base类中的保护成员,所以在派生类Derived中是可以访问的。

c是Base类中的公有成员,自然也是可以被派生类Derived访问的。

根据上述分析,Line 1 会尝试访问Base类中的私有成员a,这会导致编译错误。因此,正确答案是Line 1。

3. 单选题

有6个元素,按照 6,5,4,3,2,1 的顺序进入栈S,下列( )的出栈序列是不能出现的( )。(2024.9-6)

  • A 5,4,3,6,1,2
  • B 4,5,3,1,2,6
  • C 3,4,6,5,2,1
  • D 2,3,4,1,5,6
查看答案与解析
答案:C
解析:

模拟C:6,5,4,3进,3出,4出,5没出6是不能出的。选C

4. 单选题

采用如下代码实现检查输入的字符串括号是否匹配,横线上应填入的代码为( )。

#include <iostream>
#include <stack>
#include <string>

using namespace std;

bool is_valid(string s) {
	stack<char> st;
	char top;
	
	for (char& ch : s) {
		if (ch == '(' || ch == '{' || ch == '[') {
			st.push(ch); // 左括号入栈
		}
		else
		{
			if (st.empty())
				return false;
			———————————————————————— // 在此处填入代码
			if ((ch == ')' && top != '(') ||
				(ch == '}' && top != '{') ||
				(ch == ']' && top != '[')) {
				return false;
			}
		}
	}
	
	return st.empty(); // 栈为空则说明所有括号匹配成功
}
  • A top = st.top(); st.pop();
  • B st.pop(); top = st.top();
  • C st.pop(); top = st.front();
  • D top = st.front(); st.pop();
查看答案与解析
答案:A
解析:

括号匹配问题,若是碰到左括号则入栈,碰到右括号要拿出左括号与之对比,若栈中没有左括号则配对失败,若左括号与之不匹配则配对失败,否则 继续配对,最终返回栈是否为空,为空则匹配成功,否则匹配失败,这里询问的是拿出栈中首元素后删除的操作,选A是top = st.top; st.pop; front 一般是队列中取出队头的操作。

5. 单选题

下面代码判断队列的第一个元素是否等于a,并删除该元素,横向上应填写( )。

  • A is_equal = (q.front() == a);
  • B is_equal = (q.front() == a); q.pop();
  • C q.pop(); is_equal = (q.front() == a);
  • D q.pop(); is_equal = (q.top() == a);
查看答案与解析
答案:B
解析:

完美衔接上一题,取出队头是q.front(),去掉队头上q.pop(),所以选B

6. 单选题

假设字母表 {a,b,c,d,e} 在字符串出现的频率分别为 10%,15%,30%,16%,29%。若使用哈夫曼编码方式对字母进行二进制编码,则字符 abcdef 分别对应的一组哈夫曼编码的长度分别为( )。(2024.9-6)

  • A 4, 4, 1, 3, 2
  • B 3, 3, 2, 2, 2
  • C 3, 3, 1, 2, 1
  • D 4, 4, 1, 2, 2
查看答案与解析
答案:B
这道题暂未补解析。
7. 单选题

以下C++代码实现 n nn 位的格雷码,则横线上应填写( )。

#include <iostream>
#include <vector>
#include <string>
using namespace std;
// 生成 n 位的格雷码
vector<string> generate_graycode(int n) {
	vector<string> graycode_list;
	if (n <= 0) {
		return graycode_list;
	}
	
	// 初始1位格雷码
	graycode_list.push_back("0");
	graycode_list.push_back("1");
	
	// 迭代生成 n 位的格雷码
	for (int i = 2; i <= n; i++) {
		int current_size = graycode_list.size();
		
		for (int j = current_size - 1; j >= 0; j--) {
			graycode_list.push_back("1" + graycode_list[j]);
		}
		
		for (int j = 0; j < current_size; j++) {
			———————————————————————— // 在此处填入代码
		}
	}
	return graycode_list;
}


  • A graycode_list.push_back(“0” + graycode_list[j]);
  • B graycode_list[j] = “0” + graycode_list[j];
  • C graycode_list.push_back(“1” + graycode_list[j]);
  • D graycode_list[j] = “1” + graycode_list[j];
查看答案与解析
答案:B
解析:

格雷码(Gray code)是一种相邻两个代码之间只有单个比特不同的二进制数字系统。要生成n位的格雷码,可以通过迭代的方式生成更长的格雷码序列。在这段代码中,首先生成了1位的格雷码,即"0"和"1"。然后通过迭代,每次都将现有的格雷码列表翻倍,并且在新加入的格雷码前加上不同的前缀来保证相邻格雷码之间的差异性。在每一轮迭代中,首先将现有的格雷码序列反转并加上前缀"1",然后原有的格雷码序列加上前缀"0"。

仔细观察,可以看到第一个循环是从末尾向前遍历,将’1’添加到现有元素的前面。这意味着,对于第二个循环,我们应该从头部开始遍历,同样将’0’添加到现有元素的前面,所以选B而不是选A。

8. 单选题

给定一棵二叉树,其前序遍历结果为:ABDECFG,中序遍历结果为:DEBACFG,则这棵树的正确后序遍历结果是( )。(2024.9-6)

  • A EDBGFCA
  • B EDGBFCA
  • C DEBGFCA
  • D DBEGFCA
查看答案与解析
答案:A
解析:

在前序遍历中找根,在中序遍历中找根的左右子树,建好树后进行后序遍历。

9. 单选题

一棵有 n 个结点的完全二叉树用数组进行存储与表示,已知根结点存储在数组的第 1 个位置。若存储在数组第 9 个位置的结点存在兄弟结点和两个子结点,则它的兄弟结点和右子结点的位置分别是( )。(2024.9-6)

  • A 8, 18
  • B 10, 18
  • C 8, 19
  • D 10, 19
查看答案与解析
答案:C
解析:

完全二叉树兄弟结点一般是左偶右奇,9号结点的兄弟结点只能是8号,而右子结点即9*2+1 = 19,选C

10. 单选题

二叉树的深度定义为从根结点到叶结点的最长路径上的结点数,则以下基于二叉树的深度优先搜索实现的深度计算函数中横线上应填写( )。

// 定义二叉树的结点结构
struct tree_node {
	int val;
	tree_node* left;
	tree_node* right;
	
	tree_node(int x) : val(x), left(nullptr), right(nullptr) {}
};

// 计算二叉树的深度
int max_depth(tree_node* root) {
	if (root == nullptr) {
		return 0; // 如果根结点为空,则深度为 0
	}
	
	int left_depth = max_depth(root->left);
	int right_depth = max_depth(root->right);
	
	———————————————————————— // 在此处填入代码
}
  • A return left_depth + right_depth;
  • B return max(left_depth, right_depth);
  • C return max(left_depth, right_depth) + 1;
  • D return left_depth + right_depth + 1;
查看答案与解析
答案:C
解析:

代码的思路是计算出当前根结点左子树的深度,右子树的深度,那么以根结点为子树的深度即max(左子树,右子树)+1,+1即将根结点的深度也计算在内,所以选C。

11. 单选题

上一题的二叉树深度计算还可以采用二叉树的广度优先搜索来实现。以下基于二叉树的广度优先搜索实现的深度计算函数中横线上应填写( )。

#include <queue>
int max_depth_bfs(tree_node* root) {
	if (root == nullptr) {
		return 0; // 如果树为空,深度为 0
	}
	
	queue <tree_node*> q;
	q.push(root);
	int depth = 0;
	
	// 使用队列进行层序遍历
	while (!q.empty()) {
		———————————————————————— // 在此处填入代码
		for (int i = 0; i < level_size; ++i) {
			tree_node* node = q.front();
			q.pop();
			
			if (node->left) {
				q.push(node->left);
			}
			if (node->right) {
				q.push(node->right);
			}
		}
	}
	
	return depth;
}
  • A int level_size = q.size(); depth++;
  • B int level_size = 2; depth++;
  • C int level_size = q.size(); depth += level_size;
  • D int level_size = 2; depth += level_size;
查看答案与解析
答案:A
这道题暂未补解析。
12. 单选题

二叉搜索树中的每个结点,其左子树的所有结点值都小于该结点值,右子树的所有结点值都大于该结点值。以下代码对给定的整数数组(假设数组中没有数值相等的元素),构造一个对应的二叉搜索树,横线上应填写():

// 定义二叉树的结点结构
struct tree_node {
	int val;
	tree_node* left;
	tree_node* right;
	
	tree_node(int x) : val(x), left(nullptr), right(nullptr) {}
};

// 插入结点到二叉搜索树中
tree_node* insert(tree_node* root, int val) {
	if (root == nullptr) {
		return new tree_node(val);
	}
	
	———————————————————————— // 在此处填入代码
	
	return root;
}

// 根据给定数组构造二叉搜索树
tree_node* constructBST(const int arr[], int size) {
	tree_node* root = nullptr;
	
	for (int i = 0; i < size; ++i) {
		root = insert(root, arr[i]);
	}
	return root;
}
  • A
    if (val < root->val)
    	root->left = insert(root->left, val);
    else
    	root->right = insert(root->right, val);
  • B
    if (val > root->val)
    	root->left = insert(root->left, val);
    else
    	root->right = insert(root->right, val);
  • C
    if (val < root->val)
    	root->left = insert(root, val);
    else
    	root->right = insert(root, val);
  • D
    if (val > root->val)
    	root->left = insert(root, val);
    else
    	root->right = insert(root, val);
查看答案与解析
答案:A
这道题暂未补解析。
13. 单选题

对上题中的二叉搜素树,当输入数组为[5,3,7,2,4,6,8] 时,构建二叉搜索树,并采用如下代码实现的遍历方式,得到的输出是( )。

#include <iostream>
using namespace std;

// 遍历二叉搜索树,输出结点值
void traversal(tree_node* root) {
	if (root == nullptr) {
		return;
	}
	
	traversal(root->left);
	cout << root->val << " ";
	traversal(root->right);
}


  • A 5 3 7 2 4 6 8
  • B 2 3 4 5 6 7 8
  • C 2 4 3 6 8 7 5
  • D 2 4 3 5 6 7 8
查看答案与解析
答案:B
解析:

根据输入数组建BST,然后根据 “左根右”的遍历规则输出为: 2 3 4 5 6 7 8,选B

14. 单选题

动态规划通常用于解决( )。(2024.9-6)

  • A 无法分解的问题
  • B 可以分解成相互依赖的子问题的问题
  • C 可以通过贪心算法解决的问题
  • D 只能通过递归解决的问题
查看答案与解析
答案:B
解析:

一个问题是否能用DP来解决我们的考虑一般有两点:① 最优子结构,②无后效性

最优子结构即 选项中B的可分解成相互依赖的子问题的问题,因此选B。

15. 单选题

阅读以下用动态规划解决的0-1背包问题的函数,假设背包的容量 W 是10kg,假设输入4个物品的重量weights 分别为1,3,4,6(单位为kg),每个物品对应的价值values 分别为20,30,50,60,则函数的输出为( )。

#include <iostream>
#include <vector>
using namespace std;

// 0/1背包问题
int knapsack(int W, const vector<int>& weights, const vector<int>& values, int n) {
	vector<vector<int>> dp(n + 1, vector<int>(W + 1, 0));
	
	for (int i = 1; i <= n; ++i) {
		for (int w = 0; w <= W; ++w) {
			if (weights[i - 1] <= w) {
				dp[i][w] = max(dp[i - 1][w], dp[i - 1][w - weights[i - 1]] + values[i - 1]);
			}
			else
			{
				dp[i][w] = dp[i - 1][w];
			}
		}
	}
	
	return dp[n][W];
}


  • A 90
  • B 100
  • C 110
  • D 140
查看答案与解析
答案:C
解析:

01背包问题,dp[n][w]表示将前n个物品放入容量为w的背包中得到的最大价值,4个物品的重量为1 3 4 6,价值为20 30 50 60,背包容量为10,最大价值是1 3 6 对应的110。

二、判断题

16. 判断题

C++、Python和JAVA等都是面向对象的编程语言。(2024.9-6)

  • A对
  • B错
查看答案与解析
答案:对
解析:

这三个语言都支持面向对象编程的关键特性,但是它们的使用场景和编程风格有所不同。C++更适合需要高性能和底层控制的应用,Python则因其易学性和代码的简洁性而在数据分析、科学计算等领域广泛应用,而Java因为其平台无关性和安全性,在企业级应用开发中有广泛的应用。

17. 判断题

在C++中,类的静态成员变量只能被该类对象的成员函数访问。

  • A对
  • B错
查看答案与解析
答案:错
解析:

静态成员变量的特点

共享性:所有的类实例共享同一个静态成员变量的副本。这意味着无论创建多少个类的对象,静态成员变量只会有一个实例存在。

访问性:静态成员变量可以在类的成员函数中访问,也可以通过类名直接访问,而不必创建类的对象。

如何访问静态成员变量

通过类名直接访问、通过成员函数访问,通过友元函数访问

18. 判断题

栈是一种线性结构,可通过数组或链表来实现。二者相比,数组实现占用的内存较少,链表实现的入队和出队操作的时间复杂度较低。

  • A对
  • B错
查看答案与解析
答案:错
解析:

数组实现的栈在不需要频繁调整大小的情况下,占用的内存通常较少。如果数组实现的栈需要频繁调整大小,可能会导致额外的空间开销,链表实现的栈由于每个节点需要存储额外的指针,总体内存开销可能高于数组实现,但在入队和出队操作上效率较高。所以认为数组实现占用内存较少是不正确,且栈只有入栈和出栈操作,没有入队出队一说。

19. 判断题

运行以下C++代码,屏幕将输出“derived class”。

#include <iostream>
using namespace std;

class base {
public:
	virtual void show() {
		cout << "base class" << endl;
	}
};

class derived : public base {
public:
	void show() override {
		cout << "derived class" << endl;
	}
};

int main() {
	base* b;
	derived d;
	b = &d;
	b->show();
	return 0;
}


  • A对
  • B错
查看答案与解析
答案:对
解析:

这段代码演示了C++中的多态性。base类中定义了一个虚函数show(),而derived类继承自base类,并且覆盖(override)了show()函数。在主函数中,b是一个指向base类的指针,但它实际上指向的是一个derived类的对象。由于show()是虚函数,当通过基类指针b调用show()时,实际上调用的是派生类derived中覆盖的版本。因此,当执行b->show();时,输出将是derived类中定义的内容,即:”derived clas”,所以说正确的

20. 判断题

如下列代码所示的基类(base)及其派生类(derived),则生成一个派生类的对象时,只调用派生类的构造函数。

#include <iostream>
using namespace std;

class base {
public:
	base() {
		cout << "base constructor" << endl;
	}
	~base() {
		cout << "base destructor" << endl;
	}
};

class derived : public base {
public:
	derived() {
		cout << "derived constructor" << endl;
	}
	~derived() {
		cout << "derived destructor" << endl;
	}
};
  • A对
  • B错
查看答案与解析
答案:错
解析:

创建一个派生类的对象时,会先调用基类的构造函数,再调用派生类的构造函数。因此,题目中的描述是不正确的。

正确的构造顺序是:

调用基类 base 的构造函数,输出"base constructor"。

调用派生类 derived 的构造函数,输出"derived constructor"。

因此,题目描述 “生成一个派生类的对象时,只调用派生类的构造函数” 是错误的。

21. 判断题

哈夫曼编码本质上是一种贪心策略。(2024.9-6)

  • A对
  • B错
查看答案与解析
答案:对
解析:

哈夫曼编码是一种用于无损数据压缩的算法,它通过构建一棵特殊的二叉树——哈夫曼树(Huffman tree)来为字符分配编码。哈夫曼编码的目标是最小化加权路径长度(weighted path length),即编码后的总长度最短。在构建哈弗曼树时,每次选择局部最优解(即频率最小的两个节点进行合并),最终构建出全局最优的哈夫曼树。因此,题目描述是正确的。

22. 判断题

如果根结点的深度记为1,则一棵恰有2024 个叶结点的二叉树的深度最少是12。

  • A对
  • B错
查看答案与解析
答案:对
解析:

考虑二叉树中第i层的叶结点数目最多为2i-1, ,那10 < i-1 < 11 , 11< i <12,因此 深度为 12是正确的。

23. 判断题

在非递归实现的树的广度优先搜索中,通常使用栈来辅助实现。(2024.9-6)

  • A对
  • B错
查看答案与解析
答案:错
解析:

通常使用队列来实现,而使用队列的本质是要区分结点遍历的先后顺序。

24. 判断题

状态转移方程是动态规划的核心,可以通过递推方式表示问题状态的变化。(2024.9-6)

  • A对
  • B错
查看答案与解析
答案:对
解析:

正确的。状态转移方程是动态规划中用来描述状态变化的重要工具。

25. 判断题

应用动态规划算法时,识别并存储重叠子问题的解是必须的。(2024.9-6)

  • A对
  • B错
查看答案与解析
答案:对
解析:

正确,在应用动态规划算法时,识别并存储重叠子问题的解是动态规划的核心要素之一。动态规划通过将问题分解为更小的子问题,并存储这些子问题的解,避免了重复计算相同的子问题,从而提高了算法的效率。

三、简答题

26. 简答题

小杨和整数拆分

时间限制:1.0 s

内存限制:512.0 MB

题面描述

小杨有一个正整数n,小杨想将它拆分成若干完全平方数的和,同时小杨希望拆分的数量越少越好。

小杨请你编写程序计算出总和为n 的完全平方数的最少数量。

输入格式

第一行包含一个正整数n,含义如题面所示。

输出格式

输出一个整数,代表总和为n 的完全平方数的最少数量。

输入样例

18

输出样例

2

18=9+9=16+1+1,其中最少需要2 个完全平方数。

对于全部数据,保证有1≤n≤105。


查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include&lt;bits/stdc++.h&gt; using namespace std; const int N = 1e5+10; int n; int dp[N]; int main(){ cin&gt;&gt;n; for(int i=1;i&lt;=n;i++){ dp[i]=i; for(int j=1;j&lt;=sqrt(i);j++){ dp[i] =min(dp[i-j*j]+1,dp[i]); } } cout&lt;&lt;dp[n]&lt;&lt;"\n"; }</pre><p><br/></p>
解析:

题目大意:给定一个正整数n,将其拆分成若干个完全平方数的和,要求拆分的数量越少越好。求最少需要多少个完全平方数才能构成n。

用DP进行求解

状态定义

设dp[i]表示构成整数i的最少完全平方数的数量。

状态转移方程

考虑如何通过已知的dp[j](其中j < i)来推导出dp[i]。

对于任意一个整数i,我们可以考虑将它拆分成一个完全平方数j2加上剩余部分i - j2 的和。因此,

dp[i]可以通过dp[i - j2] 来推导出来,即:

dp[i] =min 1≤ k ≤ i (dp[ i−j 2 ]+1)

解释:

dp[i - j2] 表示剩余部分 i - j2 的最少完全平方数数量。+ 1 表示当前添加了一个完全平方数 j2。

我们需要取所有可能的 j 的最小值,以确保 dp[i] 最小。

27. 简答题

算法学习

时间限制:1.0 s

内存限制:512.0 MB

题面描述

小杨计划学习 m 种算法,为此他找了 n 道题目来帮助自己学习,每道题目至多学习一次。

小杨对于 m 种算法的初始掌握程度均为 0 。第 i 道题目有对应的知识点ai,即学习第 i 道题目可以令小杨对第ai种算法的掌握程度提高bi。小杨的学习目标是对 m 种算法的掌握程度均至少为 k 。

小杨认为连续学习两道相同知识点的题目是不好的,小杨想请你编写程序帮他计算出他最少需要学习多少道题目才能使得他在完成学习目标的同时避免连续学习两道相同知识点的题目。

输入格式

第一行三个正整数m,n,k,代表算法种类数,题目数和目标掌握程度。

第二行n个正整数a1,a2,a3,...,an,代表每道题目的知识点。

第二行n个正整数b1,b2,b3,...,bn,代表每道题目提升的掌握程度。

输出格式

输出一个整数,代表小杨最少需要学习题目的数量,如果不存在满足条件的方案,输出 -1。

输入样例1

3 5 10
1 1 2 3 3
9 1 10 10 1

输出样例1

1

输入样例2

2 4 10
1 1 1 2
1 2 7 10

输出样例2

-1

对于样例1,一种最优学习顺序为第一道题,第三道题,第四道题,第二道题。

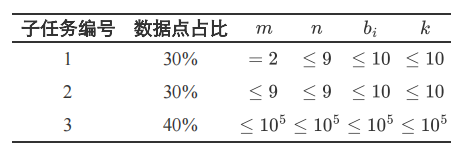
对于全部数据,保证有1≤m,n≤105,1≤bi,k≤105,1≤ai≤m。

查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include &lt;bits/stdc++.h&gt; using namespace std; const int N = 1e5 + 5; const int inf = 0x3f3f3f3f; int f[N]; vector&lt;int&gt; score[N + 2], a, b; bool cmp(int i, int j) { return i &gt; j; } int main() { int n, m, k; cin &gt;&gt; m &gt;&gt; n &gt;&gt; k; a.resize(n), b.resize(n); for (int i = 0; i &lt; n; i ++) cin &gt;&gt; a[i]; for (int i = 0; i &lt; n; i ++) { cin &gt;&gt; b[i]; score[a[i]].emplace_back(b[i]); } vector&lt;int&gt; need(m + 2); int ans = 0, mx_meed = 0, mx_need_i = -1; for (int i = 1; i &lt;= m; i ++) { sort(score[i].begin(), score[i].end(), cmp); int sum = 0; for (int j = 0; j &lt; (int) score[i].size(); j ++) { sum += score[i][j]; if (sum &gt;= k) { need[i] = j + 1; break ; } } if (sum &lt; k) { puts("-1"); return 0; } ans += need[i]; if (need[i] &gt; mx_meed) mx_meed = need[i], mx_need_i = i; } if (mx_meed - 1 &lt;= ans - mx_meed) { cout &lt;&lt; ans &lt;&lt; endl; return 0; } int last = 0; for (int i = 1; i &lt;= m; i ++) if (i != mx_need_i) last += score[i].size() - need[i]; cout &lt;&lt; (mx_meed - 1 &lt;= ans - mx_meed + last ? 2 * mx_meed - 1 : -1) &lt;&lt; endl; return 0; }</pre><p><br/></p>
解析:

1.数据准备

读入数据,并将每道题目按知识点分类,记录每种算法通过题目提升掌握程度的列表score。

2.计算每种算法所需的题目数量

对于每种算法,我们需要计算达到目标掌握程度k所需的题目数量。为了最大化利用高分题目,我们需要按分数降序排序。

3.确定最少题目数量

我们需要找到一种安排,使得小杨学习的题目数量最少,并且避免连续学习相同知识点的题目。为此,我们找出需要题目最多的算法,并尝试调整学习顺序。

4.调整学习顺序

如果最多需要的题目数量mx_need减去1之后仍然不超过总需要的题目数量减去mx_need,那么可以通过调整顺序来满足要求;否则,输出-1。