首页 › 试卷 › GESP编程能力等级认证 › GESP-C++五级 › 2025年12月CCF-GESP编程能力等级认证C++编程五级真题

2025年12月CCF-GESP编程能力等级认证C++编程五级真题 VIP

GESP-C++五级 共 27 题 2025 年 含标准答案与解析
返回试卷列表
本页为整卷浏览:先自己做一遍,再展开「查看答案与解析」核对。

一、单选题

1. 单选题

对如下定义的循环单链表,横线处填写( )。

// 循环单链表的结点 
struct Node { 
    int data; // 数据域 
    Node* next; // 指针域 
    Node(int d) : data(d), next(nullptr) {} 
}; 
// 创建一个只有一个结点的循环单链表 
Node* createList(int value) { 
    Node* head = new Node(value); 
    head->next = head; 
    return head; 
} 
// 在循环单链表尾部插入新结点 
void insertTail(Node* head, int value) { 
    Node* p = head; 
    while (p->next != head) { 
        p = p->next; 
    } 
    Node* node = new Node(value); 
    node->next = head; 
    p->next = node; 
} 
// 遍历并输出循环单链表 
void printList(Node* head) { 
    if (head == nullptr) return; 
    Node* p = head; 
    _______________________ //在此处填入代码 
    cout << endl; 
}
  • A
    while (p != nullptr){
    	cout << p->data << " ";
    	p = p->next;
    }
  • B
    while (p->next != nullptr){
    	cout << p->data << " ";
    	p = p->next;
    }
  • C
    do {
    	cout << p->data << " ";
    	p = p->next;
    } while (p != head);
  • D
    for(; p; p=p->next){
    	cout << p->data << " ";
    }
查看答案与解析
答案:C
解析: 遍历循环单链表需从头结点开始,逐个访问每个结点的数据域并移动指针至下一个结点。由于链表为循环结构,终止条件不能依赖指针为空。应以回到头结点作为结束标志。首次访问时头结点必须被处理,因此需先执行输出语句再判断是否回到起点。使用do-while结构可确保至少访问一次头结点,并在每次迭代后更新指针,直到p的下一个结点为头结点时停止。
2. 单选题

区块链技术是比特币的基础。在区块链中,每个区块指向前一个区块,构成链式列表,新区块只能接在链尾,不允许在中间插入或删除。下面代码实现插入区块添加函数,则横线处填写( )。

//区块(节点) 
struct Block { 
    int index; // 区块编号(高度) 
    string data; // 区块里保存的数据 
    Block* prev; // 指向前一个区块 
    Block(int idx, const string& d, Block* p) : index(idx), data(d), prev(p) {} 
}; 
// 区块链 
struct Blockchain { 
    Block* tail; 
    // 初始化 
    void init() { 
        tail = new Block(0, "Genesis Block", nullptr); 
    } 
    // 插入新区块 
    void addBlock(const string& data) { 
        _______________________ //在此处填入代码 
    } 
    // 释放内存 
    void clear() { 
        Block* cur = tail; 
        while (cur != nullptr) { 
            Block* p = cur->prev; 
            delete cur; 
            cur = p; 
        } 
        tail = nullptr; 
    } 
};
  • A
    Block* newBlock = new Block(tail->index + 1, data, tail);
    tail = newBlock->prev;
  • B
    Block* newBlock = new Block(tail->index + 1, data, tail);
    tail = newBlock;
  • C
    Block* newBlock = new Block(tail->index + 1, data, tail->prev);
    tail = newBlock;
  • D
    Block* newBlock = new Block(tail->index + 1, data, tail->prev);
    tail = newBlock->prev;
查看答案与解析
答案:B
解析: 确定链尾当前区块,获取其编号与指针;创建新区块,编号为原尾部编号加一,数据为输入内容,前驱指针指向原尾部区块;更新区块链的尾指针,使其指向新创建的区块;确保链式结构连续,且新区块成为新的末端节点。
3. 单选题

下面关于单链表和双链表的描述中,正确的是( )。

struct DNode { 
    int data; 
    DNode* prev; 
    DNode* next; 
}; 
// 在双链表中删除指定节点 
void deleteNode(DNode* node) { 
    if (node->prev) { 
        node->prev->next = node->next; 
    } 
    if (node->next) { 
        node->next->prev = node->prev; 
    } 
    delete node; 
} 
struct SNode { 
    int data; 
    SNode* next; 
}; 
// 在单链表中删除指定节点 
void deleteSNode(SNode* head, SNode* node) { 
    SNode* prev = head; 
    while (prev->next != node) { 
        prev = prev->next; 
    } 
    prev->next = node->next; 
    delete node; 
}
  • A 双链表删除指定节点是O(1),单链表是O(1)
  • B 双链表删除指定节点是O(n),单链表是O(1)
  • C 双链表删除指定节点是 O(1),单链表是O(n)
  • D 双链表删除指定节点是O(n),单链表是O(n)
查看答案与解析
答案:C
解析: 分析双链表删除操作:已知待删节点地址,通过其prev和next指针直接修改前后节点的链接关系,无需遍历,操作步骤数恒定。分析单链表删除操作:已知待删节点地址,但无法直接获取前驱节点,必须从头节点开始逐个遍历直至找到前驱节点,链接修改依赖遍历过程,操作步骤数与节点位置相关。两种结构的删除操作均涉及指针重连和内存释放,但查找前驱的方式导致时间复杂度机制不同。
4. 单选题

假设我们有两个数 a=38和b=14,它们对模 同余,即 a=b(mod m)。以下哪个值不可能是 m?

  • A 3
  • B 4
  • C 6
  • D 9
查看答案与解析
答案:D
解析: 根据同余定义,若 a ≡ b (mod m),则 m 必须整除 |a - b|。计算 |a - b| 的值,得到一个正整数差。所有可能的 m 值必须是该差值的正因数。列出该差值的所有正因数,构成可能模数的集合。任何不属于该集合的正整数,均不可能作为满足同余关系的模。通过判断各候选值是否为该差值的因数,可确定其是否可能为 m。
5. 单选题

下面代码实现了欧几里得算法。下面有关说法,错误的是( )。

int gcd1(int a, int b) { 
    return b == 0 ? a : gcd1(b, a % b); 
} 
int gcd2(int a, int b) { 
    while (b != 0) { 
        int temp = b; 
        b = a % b; 
        a = temp; 
    } 
    return a; 
}
  • A gcd1() 实现为递归方式。
  • B gcd2() 实现为迭代方式。
  • C 当 a较大时, gcd1() 实现会多次调用自身,需要较多额外的辅助空间。
  • D 当 a较大时, gcd1() 的实现比 gcd2() 执行效率更高。
查看答案与解析
答案:D
解析: 分析两个函数的实现结构:gcd1使用函数调用自身的方式,每次传入参数b和a对b取模的结果,直到b为0时返回a;递归过程中每层调用均需保存执行上下文。gcd2通过循环更新变量a和b的值,其中b被赋为a % b,a被赋为原b的值,循环持续到b为0为止;整个过程仅使用固定数量的局部变量。比较两者在控制流机制上的差异,递归版本依赖调用栈传递状态,迭代版本通过变量重用维护状态。
6. 单选题

唯一分解定理描述的内容是( )。

  • A 任何正整数都可以表示为两个素数的和。
  • B 任何大于1的合数都可以唯一分解为有限个质数的乘积。
  • C 两个正整数的最大公约数总是等于它们的最小公倍数除以它们的乘积。
  • D 所有素数都是奇数。
查看答案与解析
答案:B
解析: 分析一个正整数的因数分解结构,考虑其能否表示为质数的乘积,并关注该表示形式是否在不计顺序的情况下具有唯一性。考察分解过程中质因数的存在性和个数确定性,以及不同分解路径是否导向相同结果。
7. 单选题

下述代码实现素数表的线性筛法,筛选出所有小于等于 的素数,则横线上应填的代码是( )。

vector<int> linear_sieve(int n) { 
    vector<bool> is_prime(n +1, true); 
    vector<int> primes; 
    is_prime[0] = is_prime[1] = 0; //0和1两个数特殊处理 
    for (int i = 2; i <= n; ++i) { 
        if (is_prime[i]) { 
            primes.push_back(i); 
    } 
    ________________________________ { // 在此处填入代码 
        is_prime[ i * primes[j] ] = 0; 
        if (i % primes[j] == 0) 
            break; 
        } 
    } 
    return primes; 
}


  • A
    for (int j = 0; j < primes.size() && i * primes[j] <= n; j++)

  • B
    for(int j = sqrt(n); j <= n && i * primes[j] <= n; j++)

  • C
    for (int j = 1; j <= sqrt(n); j++)

  • D
    for(int j = 1; j < n && i * primes[j] <= n; j++)

查看答案与解析
答案:A
解析: 线性筛法通过标记合数的方式筛选素数,确保每个合数仅被其最小质因子筛除一次。外层循环遍历从2到n的整数i,若i未被标记,则将其加入素数表。内层循环需枚举已记录的素数j,用i与j的乘积标记合数,且当j能整除i时应终止以保证线性时间复杂度。内层循环的上限为当前已知素数个数,循环变量j作为素数列表的索引使用。
8. 单选题

下面代码实现了归并排序。下述关于归并排序的说法中,不正确的是( )。

void merge(vector<int>& arr, vector<int>& temp, int l, int mid, int r) { 
    int i = l, j = mid + 1, k = l; 
    while (i <= mid && j <= r) { 
        if (arr[i] <= arr[j]) temp[k++] = arr[i++]; 
        else temp[k++] = arr[j++]; 
    } 
    while (i <= mid) temp[k++] = arr[i++]; 
    while (j <= r) temp[k++] = arr[j++]; 
    for (int p = l; p <= r; p++) arr[p] = temp[p]; 
} 
void mergeSort(vector<int>& arr, vector<int>& temp, int l, int r) { 
    if (l >= r) return; 
    int mid = l + (r - l) / 2; 
    mergeSort(arr, temp, l, mid); 
    mergeSort(arr, temp, mid + 1, r); 
    merge(arr, temp, l, mid, r); 
}


  • A 归并排序的平均复杂度是O(nlogn)。
  • B 归并排序需要O(n)的额外空间。
  • C 归并排序在最坏情况的时间复杂度是O(n^2)。
  • D 归并排序适合大规模数据。
查看答案与解析
答案:C
解析: 归并排序通过分治法将数组递归分割至单个元素,再逐层合并有序子序列。每次合并操作比较两个已排序子区间元素,按序放入临时数组,最终复制回原数组。递归深度为logn量级,每层合并总耗时O(n),整体时间复杂度由递归树结构决定。算法执行过程中需辅助数组存储中间结果,空间开销与输入规模成正比。无论数据初始分布如何,拆分与合并过程的行为保持一致,其时间复杂度在最坏、平均和最好情况下均相同。大规模数据处理中,该算法表现出稳定的性能特征。
9. 单选题

下述C++代码实现了快速排序算法,最坏情况的时间复杂度是( )。

int partition(vector<int>& arr, int low, int high) { 
    int i = low, j = high; 
    int pivot = arr[low]; // 以首元素为基准 
    while (i < j) { 
        while (i < j && arr[j] >= pivot) j--; 
        while (i < j && arr[i] <= pivot) i++; 
        if (i < j) swap(arr[i], arr[j]); 
    } 
    swap(arr[i], arr[low]); 
    return i; 
} 
void quickSort(vector<int>& arr, int low, int high) { 
    if (low >= high) return; 
    int p = partition(arr, low, high); 
    quickSort(arr, low, p - 1); 
    quickSort(arr, p + 1, high); 
}
  • A O(n)
  • B O(logn)
  • C O(n^2)
  • D O(nlogn)
查看答案与解析
答案:C
解析: 分析分区函数的划分逻辑,观察基准元素的选择方式及其在序列中的位置变化。考察每次划分时左右子区间的规模分布,特别是当输入序列已有序或逆序时,基准元素是否总位于子区间一端。根据递归调用的深度与每层处理的数据量,推导出总的比较和移动操作次数的增长趋势。结合划分过程的循环执行次数与递归树的层数,确定时间复杂度的上界表达式。
10. 单选题

下面代码尝试在有序数组中查找第一个大于等于 x 的元素位置。如果没有大于等于 x 的元素,返回arr.size() 。以下说法正确的是( )。

int lower_bound(vector<int>& arr, int x) { 
    int l = 0, r = arr.size(); 
    while(l < r) { 
        int mid = l + (r - l) / 2; 
        if(arr[mid] >= x) r = mid; 
        else l = mid + 1; 
    } 
    return l; 
}
  • A 上述代码逻辑正确
  • B 上述代码逻辑错误, while 循环条件应该用 l <= r
  • C 上述代码逻辑错误, mid 计算错误
  • D 上述代码逻辑错误,边界条件不对
查看答案与解析
答案:A
解析: 使用双指针维护搜索区间[l, r),循环条件为l < r。每次取中点mid = l + (r - l) / 2,避免整数溢出。若arr[mid] >= x,则第一个满足条件的位置在左半部分(含mid),更新r = mid;否则在右半部分,更新l = mid + 1。循环结束时l等于r,返回l。初始r设为数组长度可覆盖无解情况。
11. 单选题

小杨要把一根长度为 L 的木头切成 K 段,使得每段长度小于等于 x 。已知每切一刀只能把一段木头分成两段,他用二分法找到满足条件的最小 x ( x 为正整数),则横线处应填写( )。

// 判断:在不超过 K 次切割内,是否能让每段长度 <= x 
bool check(int L, int K, int x) { 
    int cuts = (L - 1) / x; 
    return cuts <= K; 
} 
// 二分查找最小可行的 x 
int binary_cut(int L, int K) { 
    int l = 1, r = L; 
    while (l < r) { 
        int mid = l + (r - l) / 2; 
        ________________________________ // 在此处填入代码 
    } 
    return l; 
} 
int main() { 
    int L = 10; // 木头长度 
    int K = 2; // 最多切 K 刀 
    cout << binary_cut(L, K) << endl; 
    return 0; 
}
  • A
    if (check(L, K, mid)) 
        r = mid; 
    else 
        l = mid + 1;
  • B
    if (check(L, K, mid)) 
        r = mid+1; 
    else 
        l = mid + 1;
  • C
    if (check(L, K, mid)) 
        r = mid + 1; 
    else 
        l = mid - 1;
  • D
    if (check(L, K, mid)) 
        r = mid + 1; 
    else 
        l = mid;
查看答案与解析
答案:A
解析: 确定最小的正整数 x,使得将长度为 L 的木头切分为 K 段后,每段长度不超过 x。使用二分法在合理范围内查找 x,每次取中点 mid 作为候选值,通过 check 函数判断在最多 K 次切割下是否能保证所有段长度 ≤ mid。若判断成立,则说明 mid 可行,搜索更小的值;否则搜索更大的值。更新边界时需保持搜索区间的有效性,确保最终收敛到最小可行解。
12. 单选题

下面给出了阶乘计算的两种方式。以下说法正确的是( )。

int factorial1(int n) { 
    if (n <= 1) return 1; 
    return n * factorial1(n - 1); 
} 
int factorial2(int n) { 
    int acc = 1; 
    while (n > 1) { 
        acc = n * acc; 
        n = n - 1; 
    } 
    return acc; 
}
  • A 上面两种实现方式的时间复杂度相同,都为O(n)
  • B 上面两种实现方式的空间复杂度相同,都为O(n)
  • C 上面两种实现方式的空间复杂度相同,都为O(1)
  • D 函数 factorial1() 的时间复杂度为O(2^n),函数 factorial2() 的时间复杂度为O(n)
查看答案与解析
答案:A
解析: 分析两个函数的执行机制。factorial1为递归实现,每次调用将当前n与factorial1(n-1)的结果相乘,递归深度随n线性增长,每层调用占用栈空间。factorial2为迭代实现,使用循环变量acc累积乘积,n递减至1时结束循环,仅使用固定数量的局部变量。时间复杂度由基本操作次数决定,两者均执行约n次乘法操作。空间复杂度由额外内存使用量决定,递归调用产生n层栈帧,迭代过程仅使用常数空间。
13. 单选题

给定有 个任务,每个任务有截止时间和利润,每个任务耗时 1 个时间单位、必须在截止时间前完成,且每个时间槽最多做 1 个任务。为了在规定时间内获得最大利润,可以采用贪心策略,即按利润从高到低排序,尽量安排,则横线处应填写( )。

struct Task { 
    int deadline; //截止时间 
    int profit; //利润 
}; 
void sortByProfit(vector<Task>& tasks) { 
    sort(tasks.begin(), tasks.end(), 
        [](const Task& a, const Task& b) { 
            return a.profit > b.profit; 
        }); 
} 
int maxProfit(vector<Task>& tasks) { 
    sortByProfit(tasks); 
    int maxTime = 0; 
    for (auto& t : tasks) { 
        maxTime = max(maxTime, t.deadline); 
    } 
    vector<bool> slot(maxTime + 1, false); 
    int totalProfit = 0; 
    for (auto& task : tasks) { 
        for (int t = task.deadline; t >= 1; t--) { 
            if (!slot[t]) { 
                _______________________ //在此处填入代码 
                break; 
            } 
        } 
    } 
    return totalProfit; 
}
  • A
    slot[t] = true; 
    totalProfit += task.profit;
  • B
    slot[t] = false; 
    totalProfit += task.profit;
  • C
    slot[t] = true; 
    totalProfit = task.profit;
  • D
    lot[t] = false; 
    totalProfit = task.profit;
查看答案与解析
答案:A
解析: 首先按利润降序排列任务。确定最大截止时间以初始化时间槽数组,每个槽位标记是否被占用。遍历已排序的任务,对每个任务从其截止时间向前查找第一个空闲时间槽。若找到空闲槽位,则将其标记为占用,并将该任务的利润累加到总利润中。遍历所有任务后,返回累计的总利润。
14. 单选题

下面代码实现了对两个数组表示的正整数的高精度加法(数组低位在前),则横线上应填写( )。

vector<int> add(vector<int> a, vector<int> b) { 
    vector<int> c; 
    int carry = 0; 
    for (int i = 0; i < a.size() || i < b.size(); i++) { 
        if (i < a.size()) carry += a[i]; 
        if (i < b.size()) carry += b[i]; 
        _______________________ //在此处填入代码 
    } 
    if (carry) c.push_back(carry); 
    return c; 
}
  • A
    c.push_back(carry / 10); 
    carry %= 10;
  • B
    c.push_back(carry % 10); 
    carry /= 10;
  • C
    c.push_back(carry % 10);

  • D
    c.push_back(carry); 
    carry /= 10
查看答案与解析
答案:B
解析: 遍历两个数组对应位置的元素,逐位相加并加上进位值,将当前位的结果存入新数组,进位值更新为和除以10的商。若遍历结束后仍有进位,则需继续处理进位,将其按位分解并依次存入结果数组,直到进位为零。
15. 单选题

下列关于排序的说法,正确的是( )。2025.12-5

  • A 快速排序是稳定排序
  • B 归并排序通常是稳定的
  • C 插入排序是不稳定排序
  • D 冒泡排序不是原地排序
查看答案与解析
答案:B
解析: 分析排序算法的稳定性时,需考察相等元素在排序前后相对位置是否保持不变。快速排序通过基准划分元素,交换过程可能导致相等元素顺序改变。归并排序在合并有序子序列时,若遵守左子序列优先原则,则相等元素的相对位置得以保留。插入排序将元素逐个插入已排序部分,若插入位置选择包含等于比较元素的情况,则可维持相对顺序。冒泡排序通过相邻元素交换实现,每轮将最小(或最大)元素移动到边界位置,仅使用常量级额外空间完成排序操作。原地排序指辅助空间复杂度为O(1)。

二、判断题

16. 判断题

数组和链表都是线性表。链表的优点是插入删除不需要移动元素,并且能随机查找。

  • A对
  • B错
查看答案与解析
答案:错
解析: 分析线性表的存储结构特性,比较数组与链表在元素插入、删除操作中的数据移动机制,考察链表通过指针关联元素的方式是否支持随机访问,明确随机查找的定义与实现条件。
17. 判断题

假设函数 gcd() 函数能正确求两个正整数的最大公约数,则下面的 lcm(a,b) 函数能正确找到两个正整数 a 和 b 的最小公倍数。

int lcm(int a, int b) { 
    return a / gcd(a, b) * b; 
}


  • A对
  • B错
查看答案与解析
答案:对
解析: 分析函数 lcm(a, b) 的表达式结构,观察其运算顺序与数学关系。确认 a 和 b 是否通过 gcd(a, b) 进行整除操作,并判断该操作是否在整数除法下保持精度。检查表达式 a / gcd(a, b) * b 是否等价于 (a * b) / gcd(a, b) 的数学变换形式。验证该计算过程是否符合最小公倍数的定义,即能被 a 和 b 整除的最小正整数。考虑整数溢出与除法截断对结果的影响,分析运算顺序对中间结果的影响。
18. 判断题

在单链表中,已知指针 p 指向要删除的结点(非尾结点),想在删除 p ,可行做法是用 p->next 覆盖 p 的值与 next ,然后删除 p->next 。

  • A对
  • B错
查看答案与解析
答案:对
解析: 将 p->next 所指向结点的数据复制到 p 指向的结点;更新 p 的 next 指针,使其指向 p->next->next;释放原 p->next 结点所占用的内存;通过修改当前结点内容与指针实现逻辑删除目标结点的效果。
19. 判断题

在求解所有不大于 n 的素数时,线性筛法(欧拉筛)都应当优先于埃氏筛法使用,因为线性筛法的时间复杂度为O(n),低于埃氏筛法的O(n log log n)。

  • A对
  • B错
查看答案与解析
答案:错
解析: 分析两种筛法的执行机制:线性筛法通过每个合数仅被其最小质因子标记一次,确保每个数被访问的次数为常数级;埃氏筛法对每个质数的倍数进行标记,存在重复标记同一合数的情况。比较两者操作步骤的数量增长趋势,观察内层循环的触发条件及执行频率,推导各自的时间复杂度表达式。注意算法实现中是否包含冗余操作,以及标记过程的范围和终止条件如何影响总体运算量。
20. 判断题

二分查找仅适用于有序数据。若输入数据无序,当仅进行一次查找时,为了使用二分而排序通常不划算。

  • A对
  • B错
查看答案与解析
答案:对
解析: 二分查找的前提是数据有序,因其每次比较后可排除一半元素,依赖序列的单调性实现对数时间定位。若数据无序,无法直接应用二分查找。排序操作的时间复杂度通常为O(n log n),而单次线性查找的时间复杂度为O(n)。在仅需查找一次的情况下,执行排序的成本高于直接遍历。因此,为单次查找引入排序会改变整体操作的时间开销结构。是否执行排序取决于原始数据状态与后续操作需求,但排序本身不是二分查找的必要前置步骤,而是条件满足手段。
21. 判断题

通过在数组的第一个、最中间和最后一个这3个数据中选择中间值作为枢轴(比较基准),快速排序算法可降低落入最坏情况的概率。

  • A对
  • B错
查看答案与解析
答案:对
解析: 确定数组的第一个、最中间和最后一个元素的值;比较这三个元素的大小;选取其中数值上处于中间位置的元素作为枢轴;将该枢轴用于划分操作,使小于枢轴的元素置于其左,大于枢轴的元素置于其右;完成一次划分后递归处理左右子数组。
22. 判断题

贪心算法在每一步都做出当前看来最优的局部选择,并且一旦做出选择就不再回溯;而分治算法将问题分解为若干子问题分别求解,再将子问题的解合并得到原问题的解。

  • A对
  • B错
查看答案与解析
答案:对
解析: 分析贪心算法每一步选择的局部最优性及其不可回溯特性;考察分治算法将原问题划分成独立子问题的过程;明确子问题求解的独立性与后续合并操作的关系;对比两种算法在决策过程与结构处理上的差异;区分局部最优策略与递归分解再合并的解决机制。
23. 判断题

以下 fib 函数计算第 n 项斐波那契数( fib(0)=0 , fib(1)=1 ),其时间复杂度为为O(n)。

int fib(int n) { 
    if (n <= 1) return n; 
    return fib(n-1) + fib(n-2); 
}
  • A对
  • B错
查看答案与解析
答案:错
解析: 分析函数的递归调用结构,识别是否存在重复计算。若函数使用循环或递归但未优化,需统计每层递归或每次迭代的执行次数。考察输入n与基本操作执行频次的关系,确定时间复杂度是否随n线性增长。检查是否有记忆化机制或动态规划思想减少冗余计算。对比标准O(n)实现方式,确认其状态转移是否仅依赖前两项且每个状态仅计算一次。
24. 判断题

递归函数一定要有终止条件,否则可能会造成栈溢出。

  • A对
  • B错
查看答案与解析
答案:对
解析: 递归函数每次调用自身时,都会在调用栈中新增一个栈帧,用于保存当前调用的上下文信息。若未设置终止条件,递归调用将无法结束,持续向调用栈压入新的栈帧。调用栈的容量受限于系统或运行环境,当栈帧数量超过最大限制时,栈空间被耗尽,导致栈溢出。终止条件的作用是使递归在特定情况下停止调用自身,从而允许栈帧逐层回退并释放内存。
25. 判断题

使用贪心算法解决问题时,通过对每一步求局部最优解,最终一定能找到全局最优解。

  • A对
  • B错
查看答案与解析
答案:错
解析: 分析贪心算法的决策机制:每一步选择当前状态下的局部最优解,依据问题是否具有贪心选择性质和最优子结构性质,决定局部最优解的累积是否构成全局最优解。验证该机制需考察问题特性与选择策略之间的匹配关系,不保证所有问题通过局部最优能达到全局最优。

三、简答题

26. 简答题

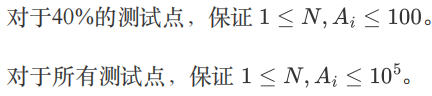
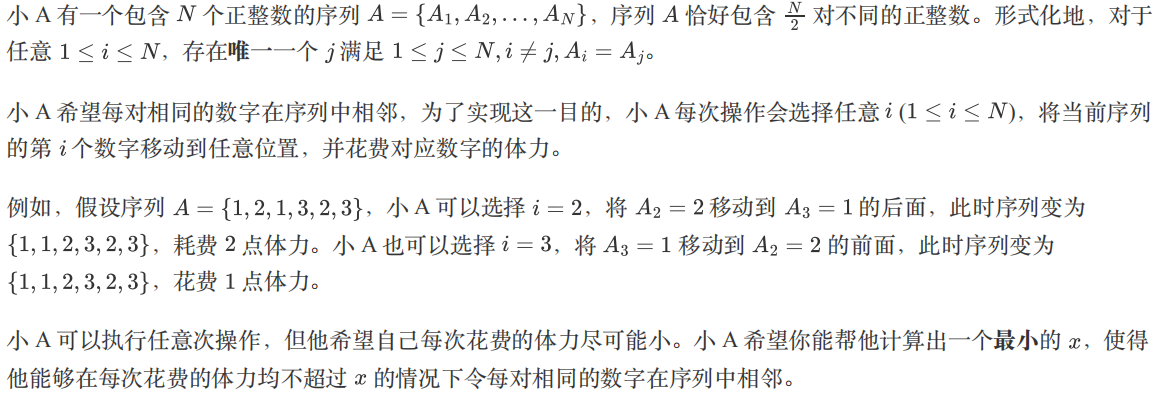
数字移动

时间限制:1.0 s

内存限制:512.0 MB

题目描述

输入格式

输出格式

输出一行,代表满足要求的 的最小值。

输入样例

6
1 2 1 3 2 3

输出样例

2

数据范围

查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include &lt;iostream&gt; using namespace std; const int N = 100010; int a[N]; int b[N]; int pos; int main() {     int n;     cin &gt;&gt; n;     for (int i = 0; i &lt; n; i++) {         cin &gt;&gt; a[i];     }     int left = 1, right = 1e6, ans = 1e6;     while (left &lt;= right) {         int mid = (left + right) / 2;         bool possible = true;         pos = 0;         for (int i = 0; i &lt; n; i++) {             if (a[i] &gt; mid) {                 b[pos++] = a[i];             }         }         for (int i = 0; i &lt; pos; i += 2) {             if (b[i] != b[i + 1]) {                 possible = false;                 break;             }         }         if (possible) {             ans = mid;             right = mid - 1;         } else {             left = mid + 1;         }     }     cout &lt;&lt; ans &lt;&lt; endl;     return 0; }</pre>
这道题暂未补解析。
27. 简答题

相等序列

时间限制: 1.0 s

内存限制:512.0 MB

题目描述

小 A 有一个包含 N 个正整数的序列A = {A1 , A2 , · ·  ,AN} 。小 A 每次可以花费 1 个金币执行以下任意一种操作:

 选择序列中一个正整数 Ai ( 1 ≤ i ≤ N) ,将 Ai 变为 Ai * P ,P 为任意质数;

 选择序列中一个正整数 Ai ( 1 ≤ i ≤ N) ,将 Ai 变为 Ai /P ,P 为任意质数,要求Ai能被p整除。

小 A 想请你帮他计算出令序列中所有整数都相同 ,最少需要花费多少金币。

输入格式

第一行一个正整数N ,含义如题面所⽰ 。

第二行包含 N 个正整数 A1 , A2 , ·  … ,AN ,代表序列 A。

输出格式

输出一行 ,代表最少需要花费的金币数量。

输入样例

5
10  6  35  105  42

输出样例

8

数据范围

对于60%的测试点 ,保证 1 ≤ N, Ai ≤ 100 。

对于所有测试点 ,保证 1 ≤ N, Ai ≤ 105 。

查看答案与解析
答案:<pre class="brush:cpp;toolbar:false">#include &lt;iostream&gt; using namespace std; const int N = 100010; int num[N][20]; int n, a[N]; void calc_prime_factor(int x) {     for (int i = 2; i * i &lt;= x; i++)     {         if (x % i == 0)         {             int cnt = 0;             while (x % i == 0)             {                 x /= i;                 cnt++;             }             num[i][cnt]++;         }     }     if (x &gt; 1)     {         num[x][1]++;     } } int main() {     scanf("%d", &amp;n);     for (int i = 1; i &lt;= n; i++)     {         scanf("%d", &amp;a[i]);         calc_prime_factor(a[i]);     }     long long ans = 0;     for (int i = 2; i &lt; 100001; i++)     {         int pos = 0;         for (int j = 0; j &lt; 20; j++)         {             pos += num[i][j];         }         num[i][0] = n - pos;         int median_exponent = 0;         pos = 0;         for (int j = 0; j &lt; 20; j++)         {             pos += num[i][j];             if (pos * 2 &gt;= n)             {                 median_exponent = j;                 break;             }         }         for (int j = 0; j &lt; 20; j++)         {             ans += num[i][j] * abs(j - median_exponent);         }     }     printf("%lld\n", ans);     return 0; }</pre>
这道题暂未补解析。